Wan 2.2 vs MiniMax H3:8G 显存笔记本本地跑开源视频模型
本文完全由 WorkBuddy 独立收集资料、调试代码并完成文章写作。
我是 Alex Xiang,前百度/微博工程师,现在专注于 AI 工程与工具产品。更多文章欢迎关注微信公众号「字与码」。
同样一台笔记本,同样的提示词,两个开源视频模型,差距能有多大?
一个 5B 参数,一个 33B,差了六倍多。参数大的那个是不是就该慢很多、要求高很多?
我在自己的笔记本上把这两个模型都装上了,从零开始搭环境,各自跑了几条片子,然后把每一条的耗时、画面质量、音频能力都量了一遍。结论有点反直觉:参数大六倍的那个,折算到每秒视频,反而更快。
这篇文章把整个过程写下来,包括:
- 这台 8G 显存的笔记本到底能跑什么、不能跑什么,怎么判断;
- 两个模型的完整安装步骤,以及我踩过的坑(有些坑相当隐蔽);
- 怎么用代码而不是鼠标把视频跑出来;
- 实测数据,以及 WorkBuddy 在这套流程里具体做了什么;
- 生成的两条视频在哪能看。
先说清楚范围:以下所有步骤和数字,都来自这一台机器、这一次实测。硬件不同、驱动不同、模型版本不同,结论都会变。
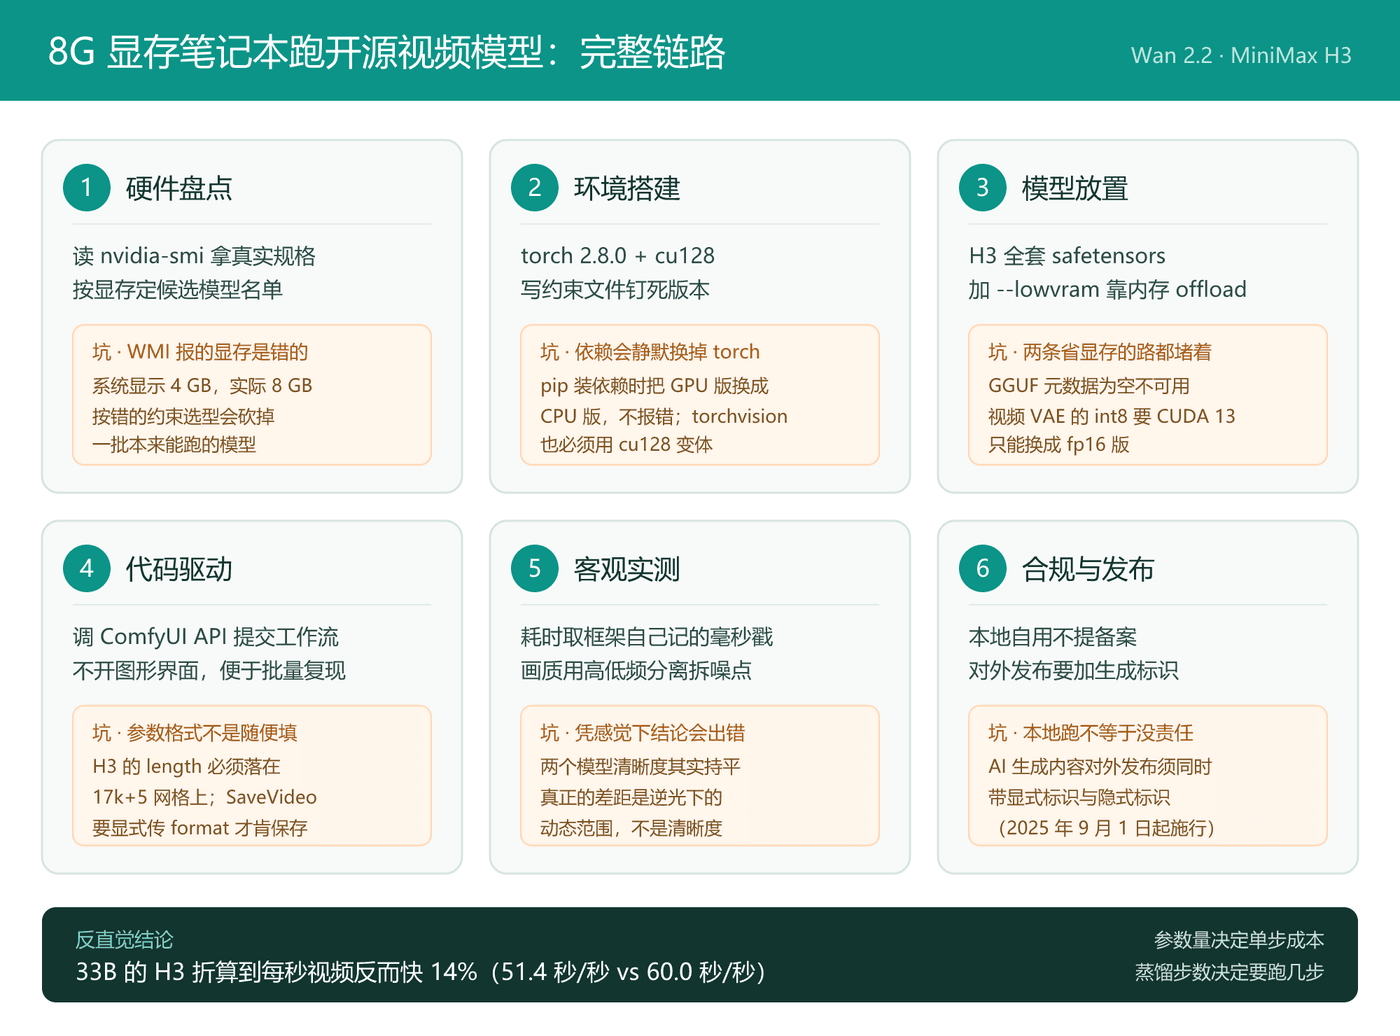
整条链路和每一步最容易踩到的坑,先给一张总览:
先看清这台笔记本的真实家底
判断能不能本地跑视频模型,第一件事不是选模型,是看硬件。这台机器的情况:
| 项目 | 配置 |
|---|---|
| CPU | Intel Core i9-14900HX,24 核 32 线程 |
| 内存 | 64 GB |
| GPU | NVIDIA GeForce RTX 4060 Laptop |
| 显存 | 8 GB(8188 MiB) |
| 驱动 / CUDA | 572.83 / CUDA 12.8 |
| 系统 | Windows 11 家庭版 |
| 磁盘 | C 盘可用 433 GB,D 盘可用 748 GB |
这里有个必须先纠正的坑:Windows 报出来的显存数字是错的。
如果你用 WMI 去读显卡信息,Win32_VideoController.AdapterRAM 会告诉你这块卡有 4 GB 显存。但实际是 8 GB。这个字段在 32 位整型上会溢出,超过 4 GB 的显卡一律显示错误值。正确做法是读 nvidia-smi:
nvidia-smi --query-gpu=name,memory.total,driver_version --format=csv这一步很关键,因为显存是唯一真正的约束。4 GB 和 8 GB 能跑的模型完全不是一个名单——如果按 4 GB 去做选型,会把一堆其实跑得动的模型提前排除掉。
顺带说一个容易忽略的点:跑这类模型时,瓶颈往往不是显存,而是内存。8 GB 显存装不下 33B 的模型,靠的是把权重放在 64 GB 内存里、按需换入显存(offload)。所以内存和显存要一起看。
8G 显存能跑什么,不能跑什么
显存定下来之后,选型范围就很清楚了。我把当时调研过的模型分成两类。
8 GB 显存可以跑的:
| 模型 | 说明 |
|---|---|
| Wan 2.2 TI2V-5B | 5B 参数,有 GGUF 量化版,Apache 2.0 许可,本次主力 |
| Wan 2.1 T2V-1.3B | 官方标注 8.19 GB,入门级 |
| FramePack | 6 GB 起,13B,主打长视频 |
| CogVideoX-2B | 5 GB(BF16) |
| MiniMax H3 | 33B,靠量化 + offload,本次另一个主角 |
跑不动或不划算的:
| 模型 | 为什么不行 |
|---|---|
| LTX-2.x | 官方要求 32 GB 以上显存(22B 版本) |
| HunyuanVideo 原版 | 13B,官方 45–80 GB |
| Wan 2.2 A14B 官方版 | 80 GB |
| Mochi 1 | 60 GB |
排除逻辑很直接:官方要求的显存是 8 GB 的四到十倍,量化也补不回来。这里不需要靠感觉,看官方标注就能筛掉大半。
真正值得说的是 MiniMax H3。它是一个 33B 的稠密 DiT 模型,文本编码器是 Qwen3-VL-32B,权重差不多 498 GB(ComfyUI 重新打包版约 343 GB)。看起来完全不该出现在 8 GB 显存的名单里,但社区已经把它压到了 NF4 和 Q2_K 这类量级,配合 offload 就能跑起来——代价是速度,5 秒的视频要 20–30 分钟,属于“能验证、不能出片”的档位。
不过这是社区共识的档位,和这次实测出来的结果不太一样。后面会给具体数字。
安装第一步:搭一个干净的 Python 环境
环境这块我踩的坑最多,先把最容易出问题的几步写清楚。
装 ComfyUI
ComfyUI 是跑这些模型的前端框架。安装方式有讲究:
# 不要下 Release 压缩包,实测速度只有 40 KB/s
# 用 git clone,并且强制 HTTP/1.1,速度能到 ~800 KB/s
GIT_HTTP_VERSION=1.1 git clone --depth 1 https://github.com/comfyanonymous/ComfyUI.git D:/AI/ComfyUI
--depth 1 只拉最新一次提交,能省掉大部分下载量。GIT_HTTP_VERSION=1.1 这个环境变量是从实测里摸出来的——默认走 HTTP/2 在这条线路上反而不稳定。
建虚拟环境并装 torch
python -m venv D:/AI/venv
D:/AI/venv/Scripts/python.exe -m pip install --upgrade pip
装 PyTorch 这一步是第一个大坑。版本必须是 CUDA 12.8 编译版,文件都在这个镜像的根目录下(不是子目录):
# 从上海交大镜像下 cu128 的 wheel,实测 19 MB/s
# 注意:文件直接挂在 cu128/ 目录下,没有 torch/ 这层子目录
D:/AI/venv/Scripts/pip.exe install --no-deps \
  "https://mirror.sjtu.edu.cn/pytorch-wheels/cu128/torch-2.8.0%2Bcu128-cp313-cp313-win_amd64.whl"
然后写一个约束文件,把版本钉死:
# D:\AI\constraints.txt
torch==2.8.0+cu128
torchvision==0.23.0+cu128
这个约束文件不是可选项。 我遇到的第一个真正棘手的坑就在这里:装完 torch 之后,后续补依赖时 pip 会静默地把 GPU 版 torch 换成 CPU 版(2.14.0+cpu)。装的过程没有任何报错,只有等到启动 ComfyUI 时才炸:
Torch not compiled with CUDA enabled那句话的意思是“你这个 torch 根本不知道什么是 CUDA”。排查方向很容易跑偏到驱动、到 CUDA Toolkit,实际上只是 pip 把包换掉了。
补依赖
ComfyUI 的依赖要一个一个补,而且必须加 --no-deps,否则每次都会动 torch:
PIP="D:/AI/venv/Scripts/pip.exe"
PIP install --no-deps -i https://mirrors.tencent.com/pypi/simple alembic
PIP install --no-deps -i https://mirrors.tencent.com/pypi/simple sqlalchemy
PIP install --no-deps -i https://mirrors.tencent.com/pypi/simple blake3
PIP install --no-deps -i https://mirrors.tencent.com/pypi/simple pydantic
PIP install --no-deps -i https://mirrors.tencent.com/pypi/simple comfy_aimdo
PIP install --no-deps -i https://mirrors.tencent.com/pypi/simple comfy_kitchen
PIP install --no-deps -i https://mirrors.tencent.com/pypi/simple torchsde
torchvision 必须单独从同一个 cu128 镜像装,这一条我单独强调:
D:/AI/venv/Scripts/pip.exe install --no-deps --force-reinstall \
  "https://mirror.sjtu.edu.cn/pytorch-wheels/cu128/torchvision-0.23.0%2Bcu128-cp313-cp313-win_amd64.whl"
如果从 PyPI 装普通的 torchvision(非 +cu128 变体),它的 C 扩展会加载失败,Windows 上直接抛一个致命异常(0xc0000139),ComfyUI 的表现是根本起不来,报错信息是:
RuntimeError: operator torchvision::nms does not exist这句话看起来像“少了某个算子”,实际是“torchvision 和 torch 的 CUDA 版本对不上”。同样的坑我踩过两次,第二次是在跑视频的时候才复现——所以别以为环境装完就没事了。
一个有 Windows 特色的坑:代理拦本地请求
装完之后启动服务、用代码去调它,会莫名报 502 或者连接失败。原因很反直觉:系统代理会拦截 127.0.0.1 的请求。
本地服务本来不该走代理,但 Windows 的系统代理设置在某些情况下会把 localhost 也一起收进去。解决办法是在调用的地方显式绕开:
export NO_PROXY='*'或者在 Python 里显式构造一个不走代理的 opener:
import urllib.request
opener = urllib.request.build_opener(urllib.request.ProxyHandler({}))
用 curl 验证的时候加 --noproxy '*'。这个问题不解决,你会以为是 ComfyUI 没起来,实际上服务好好的,只是请求没送出去。
另外,启动服务的方式也有讲究:要用前台持有进程的后台任务来跑。用 nohup 或者 Start-Process 起的服务在 Windows 上表现异常——日志是空的,进程几秒就退。这个现象浪费了我不少时间。
装模型:两个模型的文件清单
环境好了,接下来下模型。模型一律走 hf-mirror.com(HuggingFace 官方站在国内不可达)。
先说一个能省几十 GB 流量的结论:H3 不能用 GGUF 量化。
我一开始按最低显存的思路去找了 unsloth 的 GGUF 版本,下了两个文件:
qwen3vl_32b_minimax_h3-Q2_K_M.gguf(约 12.5 GB,文本编码器)minimax_h3_fl2va_pruned-Q2_K.gguf(约 6.4 GB,DiT)
结果是两个都不能用,原因是它们的 GGUF 元数据区是空的(n_kv=0),连 general.architecture 这个最基本的字段都没有。具体表现:
- 文本编码器:ComfyUI-GGUF 的 loader 直接抛异常,说这个文件“incompatible with llama.cpp”;
- DiT:走架构探测的兼容回退也失败(Unknown model architecture),因为
IMG_ARCH_LIST里压根没有minimax_h3这个架构名。
查下来根因是版本时间线对不上:ComfyUI-GGUF 的主分支停在 2026 年 1 月,而 H3 是 7 月底发布的。也就是说这类量化工具链还没来得及支持 H3,不是配置问题,是能力问题。git pull 拉不到更新的东西。
所以 H3 必须全套用 safetensors。这条路省显存走不通,只能靠 offload。
Wan 2.2 的模型文件
放到 ComfyUI/models/ 下对应的子目录:
| 文件 | 放置位置 |
|---|---|
Wan2.2-TI2V-5B-Q4_K_M.gguf | models/diffusion_models/ |
umt5-xxl-encoder-fp8.safetensors | models/text_encoders/ |
Wan2.2_VAE.safetensors | models/vae/ |
需要配合 ComfyUI-GGUF 自定义节点来加载量化后的 DiT。
MiniMax H3 的模型文件
H3 的文件多一个 VAE(视频和音频各一个),容易漏:
| 文件 | 大小 | 放置位置 |
|---|---|---|
qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors | 14.6 GB | models/text_encoders/ |
minimax_h3_fl2va_pruned_int8_convrot.safetensors | 20 GB | models/diffusion_models/ |
minimax_h3_video_vae_fp16.safetensors | 5.2 GB | models/vae/ |
minimax_h3_audio_vae_fp32.safetensors | 605 MB | models/vae/ |
| turbo LoRA(4 步蒸馏) | 1.96 GB | models/loras/ |
文本编码器为什么选 nvfp4 版?因为原始 bf16 是 49 GB、int8 是 25.9 GB,在 64 GB 内存里和 20 GB 的 DiT 同时驻留太挤,会频繁换页。
这里有个坑要单独说:视频 VAE 不能用 int8_convrot 版。
我原本按“省内存”的思路选了 minimax_h3_video_vae_int8_convrot.safetensors(2.7 GB,比 fp16 的 5.2 GB 省一半),结果报错:
CUDA driver version is insufficient for CUDA runtime versionint8_convrot 走的是 comfy_kitchen 里的 detect_k_anchor 内核,这个内核需要 CUDA 13.0,而这台机器是 12.8。有意思的是 ComfyUI 启动时其实已经给过预告,日志里有一句 “You need pytorch with cu130 or higher to use optimized CUDA operations”,只是当时没在意。
换成 fp16 版就正常了。DiT 的 int8 反量化不受影响(能正常采样),只有 VAE 这条路径必须用 fp16。这个区别值得记住,因为很容易一刀切地认为“int8 全都不行”。
H3 显存不够还要加 --lowvram 启动参数。跑之前重启一次 ComfyUI 释放缓存内存也有帮助。
使用:用代码把视频跑出来
环境装好之后,不需要打开图形界面。整套流程我用代码驱动,原因是批量和复现都方便——跑十次、改一个参数,命令行比鼠标点十遍可靠得多。
先验证 Wan 能出片
import json, urllib.request

# ComfyUI 的 API 入口:把工作流 JSON POST 过去,拿 prompt_id
payload = {"prompt": workflow}          # workflow 就是导出的节点图 JSON
req = urllib.request.Request(
    "http://127.0.0.1:8188/prompt",
    data=json.dumps(payload).encode(),
    headers={"Content-Type": "application/json"},
)
print(json.loads(urllib.request.urlopen(req).read()))
第一次跑用最小参数,512×512、41 帧、20 步,75 秒出片。先确认整条链路通,再去调质量和长度。
ComfyUI 0.37 版本有个小坑:SaveVideo 节点必须显式传 format 参数(用 "auto"),否则报缺参数。另外这个版本的 blueprint JSON 里,节点藏在 definitions.subgraphs[].nodes,不在顶层 nodes——如果你解析工作流时找不到节点,通常就是这个原因。
H3 的工作流长什么样
H3 的节点链比 Wan 长,因为它要同时生成视频和音频。核心链路是:
CLIPLoader (type=minimax)
  → MiniMaxH3ImageToVideo (clip, vae, prompt, w, h, length)
      输出 CONDITIONING + LATENT
  → MiniMaxH3SigmaShift (shift_video=12, shift_audio=3)
  → BasicScheduler → KSamplerSelect (res_multistep) → RandomNoise
  → BasicGuider
  → SamplerCustomAdvanced
  → VAEDecode  +  VAEDecodeAudio        ← 两条解码路径,一个出画面一个出声音
  → CreateVideo (fps=24, audio=...)
  → SaveVideo
两个容易踩的点:
第一,length 必须落在 17k+5 的网格上。 不是任意帧数都能用,默认值 124(约 5 秒)是合法的。喂一个不在网格里的数字,会得到莫名其妙的报错或者异常时长的输出。
第二,MiniMaxH3SigmaShift 有两个独立参数。 shift_video 和 shift_audio 分开控制画面和音频的调度偏移,别只调一个。默认值 12 和 3 是社区调好的,先不要动。
让两个模型说同一句话
为了保证对比公平,我做了两件事:
一是用完全相同的提示词。 两个模型都跑“黄昏逆光花园、着装情侣接吻”这种描述,画幅也统一到同一个尺寸。
二是角色一致的处理。 做带剧情的片子时,先让模型生成一张三视图(同一只泰迪犬的正面、侧面、背面),然后把这张三视图作为参考图喂给每一个分镜,并且在每一镜的提示词里重复同样的特征描述:
焦糖奶油卷毛、泰迪圆头、圆垂耳、胸前白斑、红项圈配黄铜铃铛这样六个分镜里的狗才是同一只。不做这一步,每一镜都会换一只狗。
实测数据
下面是这次的实测结果。所有耗时都取自 ComfyUI /history 接口里的 execution_start 和 execution_success 时间戳——这是框架自己记录的毫秒级数据,比在外部掐表准确,也不会把排队时间算进去。
耗时:参数大六倍的反而更快
先看竖屏(448×800)的分镜数据,这是做剧集时最常用的尺寸:
| 模型 | 分镜规格 | 单条耗时 | 折算每秒视频 |
|---|---|---|---|
| Wan 2.2 TI2V-5B | 448×800 / 81 帧 | 202.6 秒 | 60.0 秒 |
| MiniMax H3 | 448×800 / 124 帧 | 265.6 秒 | 51.4 秒 |
这里是整篇文章最反直觉的一个数:H3 折算到每秒视频,比 Wan 快 14%。
单条耗时 H3 确实更长(265.6 秒 vs 202.6 秒),但 H3 那一条是 124 帧、Wan 是 81 帧。按每秒视频算,H3 是 51.4 秒/秒视频,Wan 是 60.0 秒/秒视频。
为什么?因为 H3 用了 4 步的 turbo 蒸馏 LoRA。扩散模型的推理步数从常规的几十步压到 4 步,参数量的劣势就被步数的优势抵掉了。33B 跑 4 步,比 5B 跑 20 步还划算。
这个结论不能外推成“参数大就更快”。正确的说法是:参数量决定单步成本,蒸馏步数决定要跑几步,两者要一起算。
再看另一组数据(首次验证时的参数):
| 模型 | 规格 | 步数 | 耗时 |
|---|---|---|---|
| Wan 2.2 TI2V-5B | 512×512 / 41 帧 | 20 步 | 75 秒 |
| MiniMax H3 | 640×384 / 124 帧 | 4 步(turbo) | 180 秒 |
H3 在 512×320 / 22 帧的冒烟测试里只要 60 秒,说明它的时间基本随分辨率线性增长。
画质:不能笼统说“谁更清楚”
“画质好不好”是这类评测最容易翻车的地方。我一开始也想简单地打个分,但量化之后发现清晰度其实持平,真正的差距在别处。
方法是这样:把相邻帧的差异做高斯高低频分离,拆成两部分——高频部分是纯噪点(像素随机跳动),低频部分是真实运动(画面内容在动)。两者的比值能说明“画面在动”和“画面在抖”各占多少。
同一只狗的镜头,两个模型的结果:
| 指标 | Wan 2.2 | MiniMax H3 |
|---|---|---|
| 噪点 : 真实运动 | 62% : 38% | 37% : 63% |
| 去噪后清晰度(Laplacian 方差) | 75.1 | 80.2 |
| 亮度分布(狗镜头) | 110.6 | 108.0 |
三个结论:
一、清晰度基本持平。 75.1 和 80.2 这个差距在视觉上几乎看不出来。所以不能说 Wan “糊”——这是很多评测会犯的错。
二、Wan 的帧间变化里有六成是噪点。 62% 的帧间差异是高频噪点,而 H3 只有 37%。Wan 的噪点量是 H3 的 1.76 倍。全局位移的抖动(位移的二阶差)Wan 是 H3 的 2.3 倍。这解释了为什么 Wan 的狗看起来“在抖”——不是运动不自然,是每一帧上都叠了一层随机噪点。
三、亮度分布上,两个模型在正常光线下几乎一样。 110.6 对 108.0,差异可以忽略。
真正的差距在逆光
上面第三条说的是“正常光线”。换成黄昏逆光的接吻镜头,差距一下就出来了:
| 指标 | Wan 2.2 | MiniMax H3 |
|---|---|---|
| 画面平均亮度 | 40.2 | 98.8 |
| 灰阶低于 32 的像素占比 | 76.3% | 18.9% |
Wan 这条片子里有 76.3% 的像素几乎是全黑的,平均亮度只有 40.2。H3 同样提示词下平均亮度 98.8,暗部像素只有 18.9%。
这里必须把话说准:这不是“画质差”,是逆光场景下的动态范围崩塌。 两件事要分开讲。因为同一个模型在正常光线下的清晰度和亮度都是正常的(前面那组数据可以证明),它的问题集中在不能同时保住高光和暗部。如果只说“Wan 画质差”,遇到懂行的人会被一句话问住:那狗镜头怎么解释?
音频:一个更硬的差距
这一条不是画质问题,是能力问题。
Wan 2.2 的输出完全没有音轨。 生成的文件里只有视频流,静音。
H3 原生同时生成视频和音频,输出是 32 kHz 立体声的 AAC 音轨,和画面同一帧生成。上面工作流里那两条独立解码路径(VAEDecode + VAEDecodeAudio)就是为了这个。
这个差距意味着什么:做一条带声音的片子,用 Wan 你得另外配音、对轴、混音,整条后期链路都得自己搭;用 H3 出来就带着声音。对做短视频的人来说,这是流程级别的差别,不是画质级别的差别。
不过要说明,H3 的原生音频是“环境音和氛围音”,不是“准确念出你要的台词”。要念台词还是得走 TTS。但它至少能给出和画面同步的氛围音底子。
WorkBuddy 在这套流程里做了什么
上面那些步骤,从硬件盘点到最后剪出视频,WorkBuddy 全程参与。它不是“帮你点下一步”的角色,价值主要体现在每一步都给出可验证的判断和依据。具体做了这些事:
一、硬件盘点时抓住了关键误报。 Windows 报的显存是 4 GB,实际是 8 GB。这个错误如果没被纠正,整个选型会建立在一个错误的约束上,直接砍掉一批本来能跑的模型。纠正的办法是去读 nvidia-smi 而不是 WMI。
二、调研阶段给出的是能落地的名单,不是罗列。 把模型分成“8 GB 能跑”和“跑不动”两类,每一条都给出官方要求的显存作为依据。像 LTX-2.x 要 32 GB、HunyuanVideo 要 45–80 GB、Mochi 1 要 60 GB,这些看官方标注就能排除,不需要试错——省下的是几十 GB 的下载量和几个小时。
三、环境排错。 这部分是纯经验,也是最省时间的地方:
- pip 静默把 GPU 版 torch 换成 CPU 版,表现是
Torch not compiled with CUDA enabled; - torchvision 必须用 cu128 变体,否则 Windows 上抛
0xc0000139致命异常; - Windows 系统代理会拦 127.0.0.1 的请求,表现为莫名其妙的 502;
nohup起的服务在 Windows 上日志为空、进程秒退;- H3 的视频 VAE 不能用 int8_convrot(要 CUDA 13.0),但 DiT 的 int8 反量化不受影响。
这几条里,只有第一条和第三条有比较明确的报错信息,其余都表现得很像别的问题。比如 operator torchvision::nms does not exist 看起来像少了算子,CUDA driver version is insufficient 看起来像驱动版本不对(实际是内核要求)。
四、纠正了一个方向的错误。 我原本打算用 GGUF 量化版跑 H3 来省显存,下了 19 GB 的文件。检查后发现这些文件连 general.architecture 字段都没有,量化工具链根本没支持 H3。如果不去查,会在这条路上反复试,而正确的做法是全套换 safetensors。
五、把流程写成了代码和脚本。 包括调用 ComfyUI API 的客户端、两个模型的生成脚本、从 /history 里提取权威耗时的工具,以及做画质量化对比的脚本。有了这些,重跑一次实验只需要改几个参数。
六、做客观核验,而不是肉眼判断。 有几个例子:
- 耗时数据取自 ComfyUI 自己记录的执行时间戳,不是外部掐表;
- 画质对比用高低频分离,把“抖”拆成噪点和真实运动,避免用“感觉”下结论;
- 双人配音的成片里,为了确认男女声真的交替了,从混音里按句子切段估算基频(男声中位 135.6 Hz、女声中位 285.7 Hz,两组清晰分离);
- 视频里要给接吻镜头做遮挡,遮挡框的位置是逐帧量出来的——叠加原始像素坐标网格、按行算亮度与梯度,最后把接触点定位到 5 帧内稳定在 319–328 的区间。第一次凭感觉定的框,实际盖住的是鼻子和眼睛,嘴唇还露在外面。
七、把整条管线沉淀成了可复用的技能。 环境搭建、模型放置、常见坑、视频生成、字幕配音、口播成片,这些步骤都固化了下来,下次换一台机器或者换一个模型,不需要从零开始。
一句话总结这个角色:它承担的是“查证 + 排错 + 量化”这三件事。模型本身的能力是固定的,能不能把它用好,差别往往就在这三件事上——尤其当报错信息和真实原因不一致的时候。
合规:本地部署不等于没有责任
这一节值得单独说,因为很容易被误解成“本地跑就没人管”。
我查了四层,结论是这样:
第一,云端请求审核:没有。 本地推理不发 API,提示词和素材不出本机,不存在请求级别的拦截。
第二,权重里内置的审核分类器:没有。 ComfyUI 没有任何审核节点,Wan 和 H3 的推理管线里都不带 safety_checker。顺便辟个谣:网上流传的“Wan2.2 内置 safety_classifier_v3 节点”是编造的,实际不存在这个文件。
第三,模型自身的能力边界:有,但是弱的。 训练数据清洗和人类对齐会留下一些“画不出来”的题材,但表现形式是画面崩坏或者被替换成近似的东西,不是弹一个“拒绝”提示。是模型不会,不是模型不肯。
第四,法律义务:有,而且在使用者身上。 两条要紧的:
- 《生成式人工智能服务管理暂行办法》第二条提到,研发和应用生成式 AI 但未向境内公众提供服务的,不适用本办法。也就是说个人本地自用不触发备案;但一旦对外提供服务(包括给同事用、做成网页),角色就变成了“提供者”,需要备案并建立内容审核机制。
- 《人工智能生成合成内容标识办法》(2025 年 9 月 1 日施行)要求 AI 生成的视频对外发布时必须加显式标识(画面上可见的“AI 生成”字样)和隐式标识(文件元数据里含生成方信息、内容编号、数字签名或哈希)。
这一条对做自媒体的人是硬要求:AI 生成的视频发出去,必须加标识。我这条片子对外发布的时候,画面里也会把生成方式明确标出来。
另外 H3 的许可是社区许可,不是 Apache 或 MIT,里面有几条额外要求:商用界面要显著展示“MiniMax H3”、公开发布要披露是 AI 生成、托管服务要有防护措施和举报渠道。它的适用区域排除了欧盟、英国、韩国和美国,中国大陆在适用区域内,可以合法自部署。
还有一个实务上的提醒:真人肖像、明星脸、受版权保护的知名角色(尤其是迪士尼系的),不要碰。输出的权利风险由使用者承担,这一条没有技术手段能规避。
这两条视频在哪看
上面说的那些数字,看视频会更直观——尤其是“Wan 噪点占六成”和“Wan 逆光 76% 像素全黑”这两条,看画面比看表格清楚得多。
完整过程我剪成了一条 3 分半的口播视频,里面包含:
- 两个模型各自生成的泰迪犬短片(同一只狗、同一段剧情,可以直接对比画面);
- 同一个接吻镜头的对比(Wan 那条几乎全黑,H3 那条有电影感);
- 每条片子的实测耗时和画质数据,边播边解说。
这条口播视频发布在我的视频号上,视频号与公众号同名,搜索「字与码」就能看到。 建议配合本文一起看:文章给数据和步骤,视频给直观感受。
参考资料
- ComfyUI 官方仓库与文档:https://github.com/comfyanonymous/ComfyUI
- ComfyUI-GGUF 量化节点:https://github.com/city96/ComfyUI-GGUF
- Wan 2.2 模型发布页:https://huggingface.co/Wan-AI
- MiniMax H3 模型页(ComfyUI 重打包版):https://huggingface.co/Comfy-Org/MiniMax-H3
- MiniMax H3 量化版:https://huggingface.co/unsloth/MiniMax-H3-GGUF
- PyTorch cu128 wheel 镜像(上海交大):https://mirror.sjtu.edu.cn/pytorch-wheels/cu128/
- 国内模型镜像:https://hf-mirror.com
- 《生成式人工智能服务管理暂行办法》(2023 年 8 月 15 日施行)
- 《人工智能生成合成内容标识办法》(2025 年 9 月 1 日施行)
微信公众号
欢迎关注「字与码」
如果这篇文章对你有用,也欢迎在微信里继续关注后续更新。
X / Twitter
关注 @ax2_zicode
更即时的技术观察、新文章提醒和一些短想法会发在 X 上。