
Agent面试详解(中):记忆、工具与多用户并发
继续设计企业级 Agent 的数据和执行层:长期记忆怎样分层与遗忘,工具怎样契约化,多租户状态怎样用乐观锁、租约和幂等机制保持一致。
共 148 篇文章
继续设计企业级 Agent 的数据和执行层:长期记忆怎样分层与遗忘,工具怎样契约化,多租户状态怎样用乐观锁、租约和幂等机制保持一致。

从 DeepSeek Agent 岗位讨论出发,拆解 Harness、企业级运行时、状态机、事务边界和上下文窗口,回答一个 Agent 怎样从演示程序变成可恢复的系统。

以一套虚构统一授权系统从设计、开发到测试跑通的完整演练为主线,拆解 Codex 如何借助 Goal、状态外置、检查点、模型档位切换和分层验收完成长任务。

从一份完整 Prompt 出发,用 Codex Sites 生成城市气象观察站,并设计 QVeris 动态工具发现、服务端调用、统一数据模型和凭证保护链路。文中包含在线地址、真实页面截图、访问限制和后续接入方案。

我用 Codex 实测 GPT-5.6 Sol、Terra、Luna,并对 Sol 的 low、medium、high、xhigh 四档做了同题测试。本文记录真实耗时、token、API 等价成本,以及 Sites 插件当前能走到哪一步。

Codex 用久以后,最想知道的不是还能不能用,而是额度什么时候恢复、reset credits 还有几次。本文记录一个本地安全查询方法,也顺手整理这个通道还能看到哪些使用率信息。
现在技术圈真正热的,不是又出了一个模型,而是 AI Coding Agent 开始进入真实开发流程:接任务、改仓库、跑测试、提 PR,也把上下文、安全和 review 这些老问题重新推到台前。
NVIDIA DGX Spark 是一台很容易被标题党误解的机器:它不是给普通人买来跑聊天机器人的玩具,也不是缩小版数据中心训练集群。它真正卖的是 128GB 统一内存、Grace Blackwell、NVIDIA 软件栈和桌面形态。
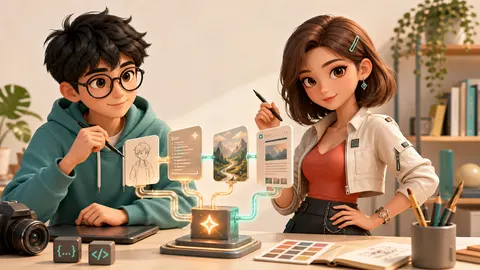
从已有封面里的小Zi开始,拆一下一个稳定博客角色是怎么靠提示词、约束和迭代做出来的;再用同一套方法设计女性角色 Coda,让两个角色合在一起成为 ZiCode 的视觉搭档。

在 Ubuntu 26.04 LTS + RTX 4060 Laptop GPU 的 WSL 环境里,不改系统目录,用 micromamba 准备 CUDA 12.4、GCC 13 和 cuBLAS,编译 llama.cpp CUDA 后端,并用 Qwen3 4B 做 CPU 与 CUDA 的速度对比。

在一台 RTX 4060 Laptop 8GB 显存、WSL 分配 32GB 内存的本地开发机上,实测 Qwen3 4B、Qwen3 8B、Gemma 4 E4B、Gemma 4 12B 的加载时间、生成速度、显存占用、多模态能力和使用取舍。

本地开源模型真正有价值的地方,不是跑分,而是能否进入每天都会发生的任务。本文把 Qwen3 4B、Qwen3 8B、Gemma 4 E4B、Gemma 4 12B 放进开发辅助、图像理解、写作整理三个工作流里,整理一套能长期演进的本地模型用法。

这是一篇持续更新的本地开源模型安装记录。从一台 64GB 内存、WSL 分配 32GB、RTX 4060 Laptop 8GB 显存的 Windows + Ubuntu 26.04 LTS 开发机出发,先判断 Ollama 应该跑在 Windows 还是 WSL,再比较 llama.cpp、LM Studio、vLLM 等方案,最后整理适合本机长期使用的模型清单。
从吴恩达关于小团队和高上下文工程师的判断说起,聊聊为什么 AI 会把资深开发者推向真正的产品全栈:需求、原型、代码、文案、合规、上线和运营都要能先跑一遍。

一次在测试机上对 gemma4:12b 音频输入能力的实测记录:模型元数据声明支持 audio,但 Ollama 原生 /api/chat 不能可靠接收音频;真正可用的是 OpenAI 兼容接口里的 input_audio。

一次从官方资料到本地实测的记录:Gemma 4 12B 具备帧序列视频理解能力,但 Ollama 当前不能直接接收 MP4,稳定做法是先抽帧再多图输入。

世界杯预测不是让大模型猜一个冠军。更靠谱的做法,是把历史赛果、球队强弱、进球分布、赛程模拟和临场信息放进同一套概率框架里,再诚实地展示不确定性。

浏览器 Agent 从能看网页走到能点按钮、填表单、提交操作,产品价值变大了,误操作和越权风险也同步变大。守护栏要比自动化能力先成熟。