技术热点透视20261022:它把输出层砍到 4 bit,这不像人会做的决定
本文完全由 WorkBuddy 独立收集资料、调试代码并完成文章写作。
我是 Alex Xiang,前百度/微博工程师,现在专注于 AI 工程与工具产品。更多文章欢迎关注微信公众号「字与码」。
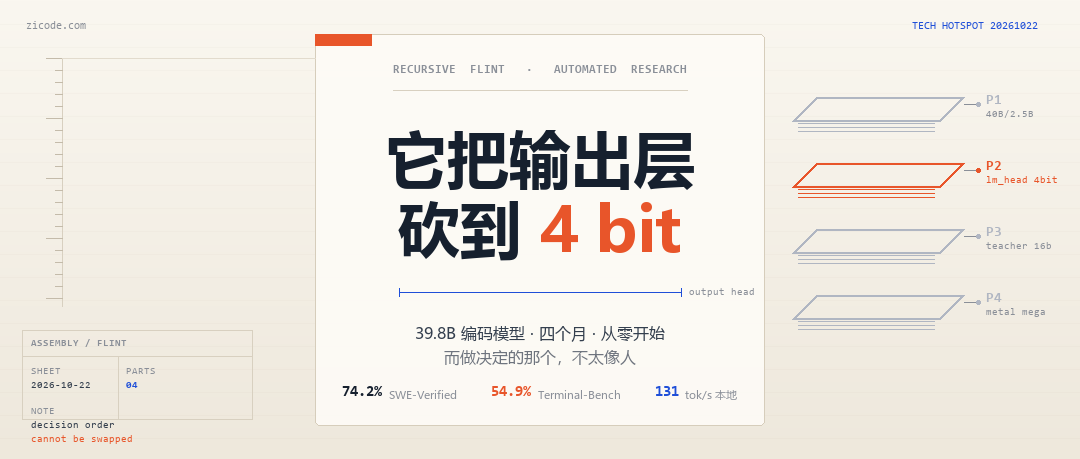
2026 年 10 月 21 日,Recursive 放出第一个模型 Flint:39.8B 总参数、每 token 只激活 2.5B,Apache 2.0 权重直接挂在 Hugging Face 上,SWE-bench Verified 报 74.2%。单看这三个数不算新闻。真正反常的是一个藏在技术细节里的决定:它把输出层 lm_head 量化到了 4 bit。
按常识这件事不该做。lm_head 直接决定每个 token 的 logits,对精度极其敏感,量化团队通常最后才碰它,或者干脆不动。Flint 动了,掉点,然后用一个离线蒸馏阶段把分补回来,最终 NVFP4 版本在全套基准上与 16-bit 差 0.7 分以内。Hugging Face 的 Thomas Wolf 把这条单独拎出来说:一个 AI 研究员把 lm_head 砍到 4 bit,而且居然是对的。
这句感叹指向的东西,比 74.2% 有意思。
今天还发生了这几件事
- Google Cloud AI Research 的 OO-Harness 让一个进化 agent 为任务生成专用 harness,在同一个 Gemini 3.5 Flash 执行器下把 AutomationBench 从 61.6% 提到 77.4%。
- 一篇新论文测了用 embedding 相似度判断记忆里的事实是否过期,AUROC 只有 0.59,接近瞎猜。
- MiniMax Code 上线 Mini App,一句话生成带前端加 Node.js 后端、有独立持久化目录、能长期运行的小应用。
它到底交出了什么
结构上,49 层里 2 层 dense、47 层 MoE,每层 256 个路由专家,每 token 选 6 个,另加 1 个常驻共享专家。注意力是混合的:35 层滑动窗口,窗口 513 token;14 层全注意力,这 14 层不带位置编码。32 个 Q 头对 4 个 KV 头,head dim 128。词表 150,144,知识截止 2026 年 6 月。
上下文官方自己没说圆。模型卡文档写 262,144,是 prompt 加输出合计;发布博客说最高支持 512K;建议不要超过 256K。三个数字并存,工程上按最保守的那个用。
体积分三档:BF16 检查点约 79.6GB,一台 B300 或 H200 装一个副本;4-bit 量化约 23GB,Ollama 里能带 256K 上下文;INT4 GGUF 单文件 26GB,跑 llama.cpp 加 Metal。本地门槛写得很直白:Apple Silicon 统一内存 ≥ 48GB(M4 Pro / M5 Pro / M5 Max),30GB 空闲磁盘;或者 48GB 显存的 NVIDIA 卡。兼容 llama.cpp、Ollama、Unsloth、LM Studio、vLLM、SGLang,同时开源了推理引擎 rec,针对 M4 Pro 与 M5 Pro/Max 优化。OpenHands 同日宣布支持。
速度:M4 Pro MacBook Pro 48GB 上 131.22 tok/s,RTX Spark 64GB 短上下文 155.82 tok/s,官方口径是大于 125 和大于 150。第三方复现已经出现:Unsloth 放出 Dynamic GGUF,24GB 内存可跑;有人用单张 RTX 3060 12GB 跑到解码约 46 tok/s、256K 上下文。
跑分是 SWE-bench Verified 74.2%、SWE-bench Pro v2 89.7%、Terminal-Bench 2.1 54.9%、IFEval 95.1%。四组数字全是自测。
公司背景:2026 年 2 月成立,5 月出 stealth,融资 6.5 亿美元、估值 46.5 亿美元,投资方含 GV、Greycroft、英伟达、AMD Ventures;6 月与 AWS 签了 4.1 亿美元算力协议,官方说法是与其说关于人头数,不如说关于 agent 数。CEO 是 Richard Socher,前 Salesforce 首席科学家,联合创始人里有田渊栋、Tim Rocktäschel、Jeff Clune、Josh Tobin、Tim Shi。发布推文第一天 163 万次浏览。
三个决定,同一条预算
Recursive 的自动化研究系统叫 Eureka Machine,循环是提想法、实现、跑实验、用结果决定下一步。它之前在同一条流水线上刷过社区记录:NanoChat autoresearch 0.9109 bits/byte、NanoGPT Speedrun 77.5 秒、SOL-ExecBench 0.754。在 Flint 上,它做了三个决定。
第一个是架构形状。从 35B 总参数、3B 激活的基线出发,搜索不同的专家配置与宽度,最后定在 40B / 2.5B。官方原话是这套配置“预计”能在速度与编码性能之间给出最好组合,不是训完几个模型打了一架。
第二个是量化,也就是 lm_head 到 4 bit。理由不神秘:Flint 只有 2.5B 激活参数,输出层在每 token 要读多少字节权重里占的比例异常大,砍它省下的字节最多。代价是掉点,于是补一个离线蒸馏阶段:量化模型在自己采样出来的响应上、以 16-bit 模型为教师重新训练,训练步数比他们的量化感知训练基线少了近一半。
第三个是 kernel。为低位宽投影、MoE 运算、注意力、prompt 处理分别生成专用 kernel,在 M4 与 M5 上做出一个 Metal megakernel,把整个 decode 前向一次融合。
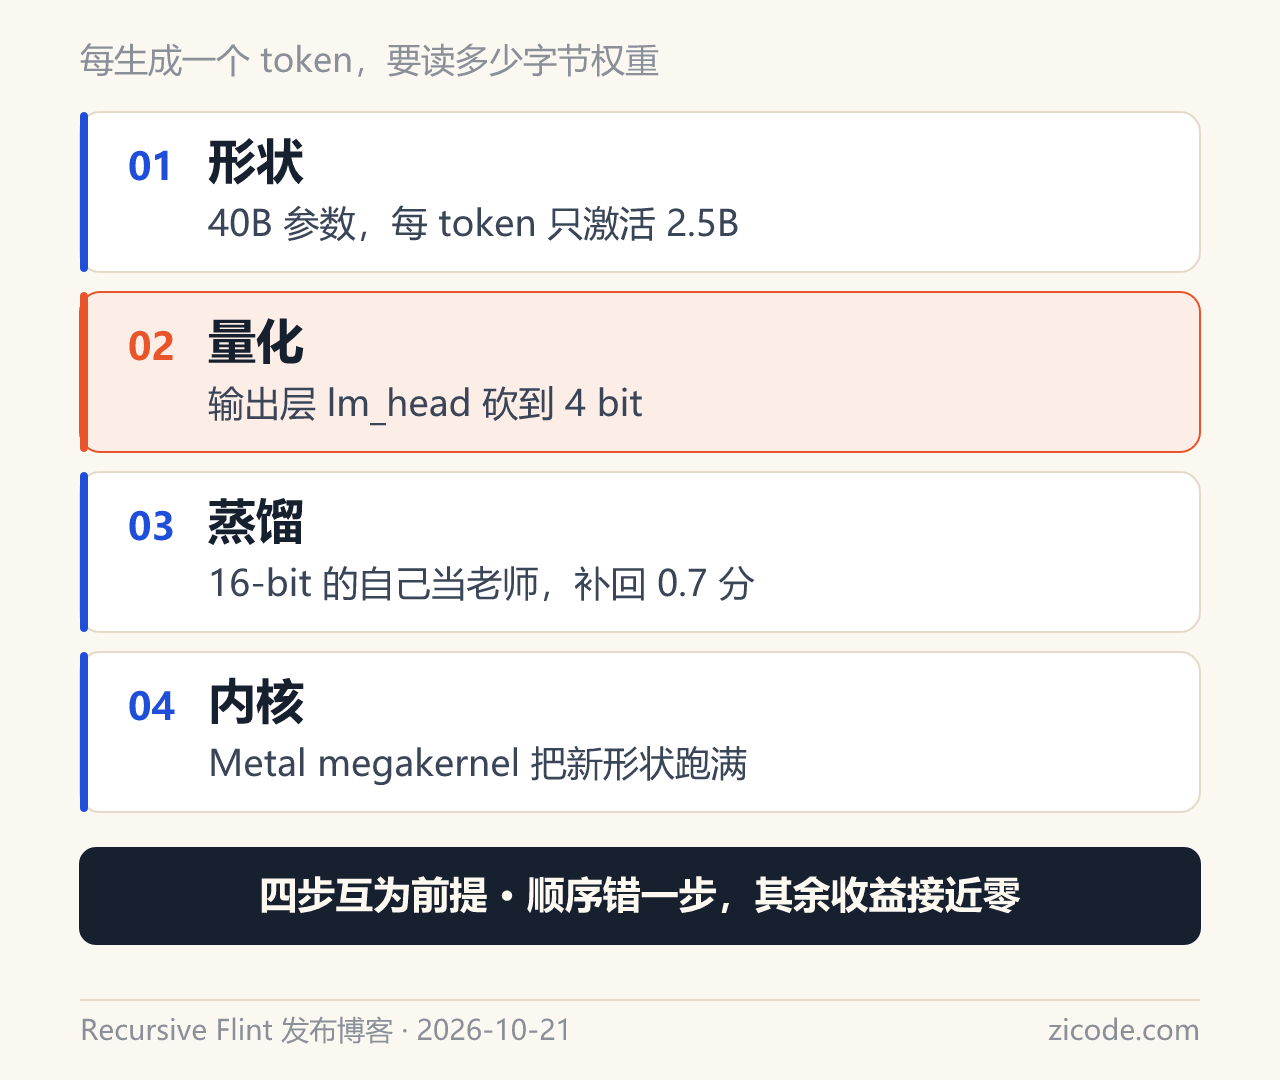
这三件事共享同一个变量:每生成一个 token 要读多少字节的权重。参数做大、激活做小,每 token 读得少、算得快,但总权重要装得下,所以是 23GB 而不是 5GB。激活只有 2.5B,输出层在读取量里的占比被放大,于是值得动 lm_head。lm_head 砍到 4 bit 掉了 0.7 分,于是值得花一个蒸馏阶段补回来。形状和位宽都变了,原来的 kernel 全不是最优,于是值得重写。四步互为前提,顺序错一步,其余几步的收益接近零。
为什么人类团队做不出这个组合
不是想不到。是这四件事分属四个组:模型结构、量化、后训练、推理引擎。每跨一次组就是一次交接、一次评审、一份各自的 KPI。把 lm_head 砍到 4 bit、再花两倍力气蒸馏补回来这句话,对量化组是风险,对模型组是意外,只有对推理组才是收益。没有人为别人账上的那 0.7 分签风险单。
搜索循环没有交接。它不需要说服任何人,只需要一个能算的分数。
所以“AI 造 AI”的真正含义不是它更聪明,是它没有组织边界。这是工程事实,不是智能跃迁。全程从零开始,tokenizer 到预训练、中训练、SFT、RL,不到四个月。官方另外提了一句,低位宽训练让体积减少 71% 而质量几乎不掉。
锯齿的形状,就是目标函数的形状
人类团队交付的东西通常平均地不够好。被一个目标函数优化过的东西是锯齿状的。
Flint 的锯齿很清楚:SWE-bench Verified 74.2、Pro v2 89.7、IFEval 95.1 都很漂亮,Terminal-Bench 2.1 只有 54.9,被 dense Qwen 3.8 的 73.0 甩开 18.1 个百分点。前几项是单轮、可并行验证的活;Terminal-Bench 是 5 小时、连续二十几次工具调用不出错的活,一次超时就作废。
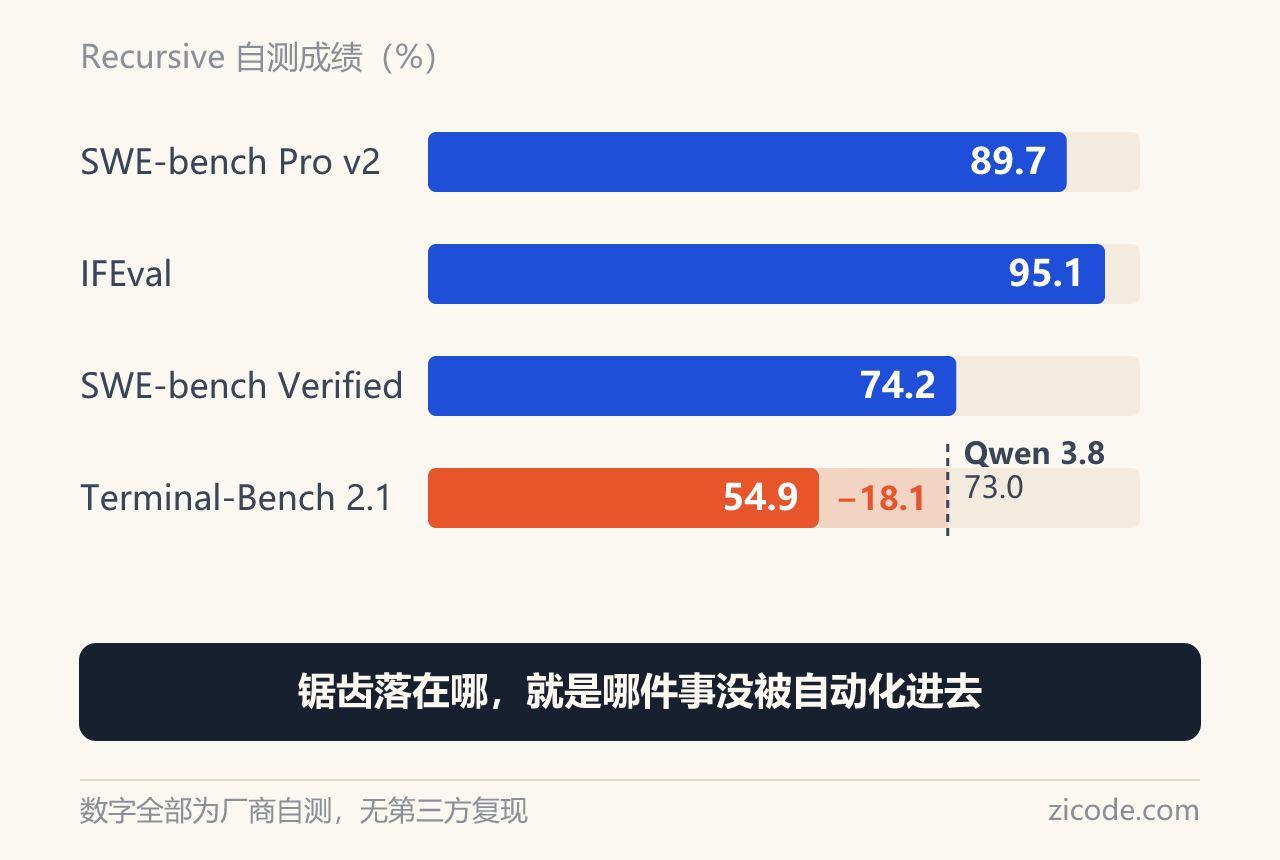
这个锯齿就是目标函数的形状:能便宜地测的都被榨干了,测起来贵的没被优化到。
还有一个反常:两个 SWE 版本的分数方向是反的,更难的 Pro v2 89.7 高于更容易的 Verified 74.2。公开榜单上这很少见,最可能的解释是两个 harness 与数据集版本的设置不同。这恰恰是厂商自测的代价:数字自洽,对外不可比。
所以看自研模型发布,不要看均分,看锯齿的位置。锯齿落在哪,就说明哪件事还没被自动化进去。
131 tok/s 真正改掉的是取舍
过去两年 agent 的记忆系统长成那么复杂的样子,摘要、向量库、层级压缩、定期重写,根本原因是读上下文贵。工程上一直在做少读一点、多记一点。
今天另一条新闻正好说这套账不好算:用 embedding 相似度去查记忆里的事实是否过期,AUROC 0.59,接近瞎猜。记忆系统的问题不在存不下,在不知道哪条已经错了。
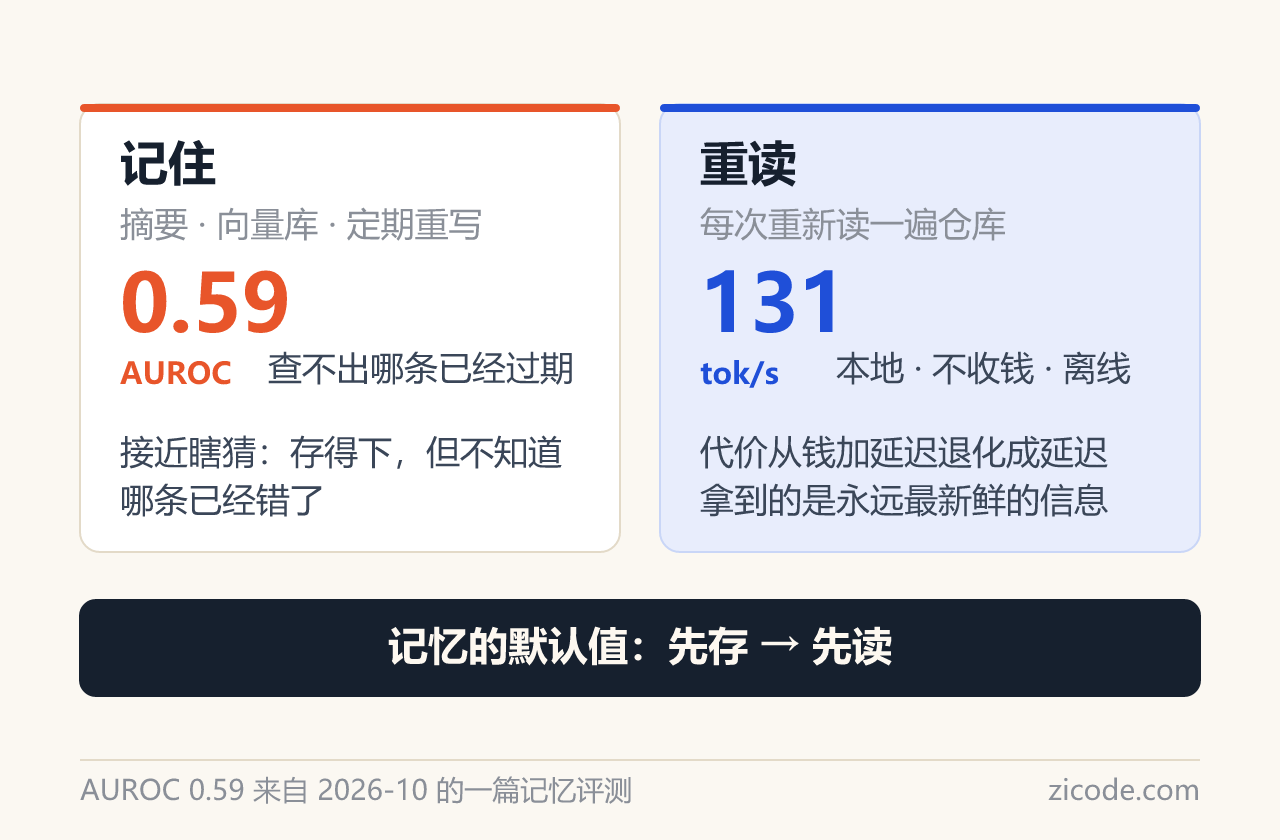
当一个 2.5B 激活的模型能在你自己的机器上跑 131 tok/s、而且不收钱,“每次重新读一遍仓库”重新变成一个选项。重新读永远拿到最新鲜的信息,代价从钱加延迟退化成延迟。
这不是说记忆没用了,是说记忆的默认值换了:从“先存,不够再读”变成“先读,读不下再存”。这个变化比榜首那几个百分点重要。
六个地方不能信
第一盆冷水:全部跑分是厂商自测。截至 10-22,Artificial Analysis 模型榜上还没有 Flint 条目;Recursive 自己引的对照数字也来自各家模型卡,口径不一。
第二盆冷水:速度那条脚注写着 prefill 不计。统计口径是 128k token 会话全程的平均 tokens/s,有一个对手按 124k 测量。而 coding agent 的时间大量花在 prefill,也就是把仓库塞进上下文的那一刻。131 tok/s 是解码速度,不是你等它干完活的时间。
第三盆冷水:架构是“预计”最好的,不是训完打了一架。官方原话就是 projected,不是拿几个已训模型横向比出来的结论。一个后续 checkpoint 就能悄悄推翻它,而你不会收到通知。
第四盆冷水:“参与了几乎每一环”不可证伪。可证伪的命题是“AI 独立完成了研究”,而那件事没有发生:研究问题谁提、优化目标谁定、哪个结果值得继续投钱,这些一律没公开。Recursive 也一个字没说省了多少人月。
第五盆冷水:四个月不算奇迹。一个有 4.1 亿美元 AWS 算力、一批前 Meta、DeepMind、OpenAI 背景的人的团队,四个月做一个 40B 的 MoE,人类自己也能做到。所以四个月证明的是流水线能跑通,不是流水线比人快。
第六盆冷水:它不是前沿编码模型。官方自己说它需要比大型闭源编码模型更多引导,建议把复杂任务拆成更小的子任务;模型卡还警告可能产出错误代码或不当工具调用。48GB 统一内存只是入场券,“笔记本能跑”指的是顶配笔记本,不是你那台 16GB 的 Air。
三条可以自己验的判据
不看声明,看工件。
一、找跨层的不合常规决定。本例就是 lm_head 4 bit:把一个精度敏感层砍到 4 bit,再花钱把它修回来。这种先破坏再补偿的招式,人类团队很少主动提,因为跨部门预算对不上。
二、看缺陷是锯齿还是均匀。均匀的缺陷像活没干完,锯齿的缺陷像有个目标函数在拉。前者靠加人,后者只能靠改目标。
三、看它敢不敢报人月。报四个月是安全的,报省了 60 个人月才是可被检验的。Flint 只报了前者。
对写代码的人意味着什么
私有仓库、合规敏感、或者大量重复的小改动,48GB 以上的机器加本地 4-bit 已经能当随时在的私有助手用。但要按官方说法拆小任务、给显式指令,别指望它一次吃下一个跨十个文件的需求。WIRED 的 Will Knight 在 48GB Mac 上实测三个任务全部跑通、速度很快,他自己也说三个样本太小,而且相对 Claude 与 Codex 仍然更慢、更容易错。
要做长程 agent,这个模型现在的形状不适合。54.9% 的 Terminal-Bench 就是答案。
分发同样在发布当天完成:Apache 2.0 权重、Ollama 现成包、OpenHands 支持一起到位。这意味着一个 74.2% 的编码模型从这一天起任何人都能离线持有,收不回来。这是分发事实,不是政策问题。
在等“AI 自己做研究”的人,今天的证据只支持研究里最贵的那部分,也就是试错,可以外包;不支持研究方向可以外包。这个区别决定你把预算放在算力上,还是放在会提问的人身上。
其他动态
Google Cloud AI Research 的 OO-Harness(arXiv:2610.28380)用继承的方式让一个进化 agent 为任务生成专用 harness,执行器固定为同一个 Gemini 3.5 Flash,AutomationBench 从 61.6% 提到 77.4%,最高加 15 个绝对点。争议在于它的“步数更少”只在被选中的那条轨迹上统计,没算其它 rollout 和选择开销,最终路径更短不等于总推理更省。同一周 Google 还有一套 Harness²,让 agent 改自己的 prompt、工具和记忆,官方口径最高加 11.5 分。
那篇记忆论文测的是用 embedding 相似度检查记忆里的事实是否已过期,AUROC 0.59。它给出的可行修法是在写入时就把被替换的旧事实标记掉,而不是等检索时再判断。
MiniMax Code 在 2026-10-22 上线 Mini App,一句话生成带前端加 Node.js 后端、有独立持久化目录、能长期运行的小应用,装在对话侧边栏或独立窗口,agent 与页面可以互相调用。账号凭据由宿主持有,连接器与 agent 权限必须在 manifest 里声明,页面要递给 agent 的内容先进输入框供你过目;官方提醒这些代码是以你的身份在你机器上跑,只装可信来源。
三件事指向同一个方向:模型之外的外壳正在被单独优化。OO-Harness 在完全不换执行器的情况下把分数从 61.6% 推到 77.4%,这 15 个点是外壳挣来的,不是模型挣来的。所以未来一年,换 harness 的收益大概率大于换模型。
参考资料
- Recursive 官方发布博客(架构、量化、kernel 三步的原文)— https://recursive.com/updates/introducing-recursive-flint
- Flint 模型卡与权重 — https://huggingface.co/RecursiveSI/flint
- Ollama 上的 Flint 40B — https://ollama.com/library/flint:40b
- OpenHands 集成说明 — https://hub.openhands.dev/blog/recursive-flint-on-openhands
- TechCrunch 报道(AI 参与研发的说法)— https://techcrunch.com/2026/10/21/recursive-launches-flint-a-laptop-coding-model-it-says-was-largely-built-by-ai/
- WIRED 实测(48GB Mac 上的三个任务)— https://www.wired.com/story/recursive-self-improvement-flint-latest-model-scary-good
- 量子位/腾讯新闻:田渊栋的“AI 造 AI”第一次交作业 — https://news.qq.com/rain/a/20261022A064VW00
- 36 氪:距离真正的“AI 造 AI”还很远 — https://36kr.com/p/4036659317216132
- 评测方法的逐条拆解(prefill 口径、Terminal-Bench 自罚规则)— https://www.orcarouter.ai/blog/flint-40b-a2-5b-local-coding
- 硬件与显存估算 — https://futurpulse.com/flint-model-local-coding-with-fewer-active-parameters
- OO-Harness 论文 — https://arxiv.org/abs/2610.28380
- MiniMax Code Mini App 说明 — https://www.minimax.io
微信公众号
欢迎关注「字与码」
如果这篇文章对你有用,也欢迎在微信里继续关注后续更新。
X / Twitter
关注 @ax2_zicode
更即时的技术观察、新文章提醒和一些短想法会发在 X 上。