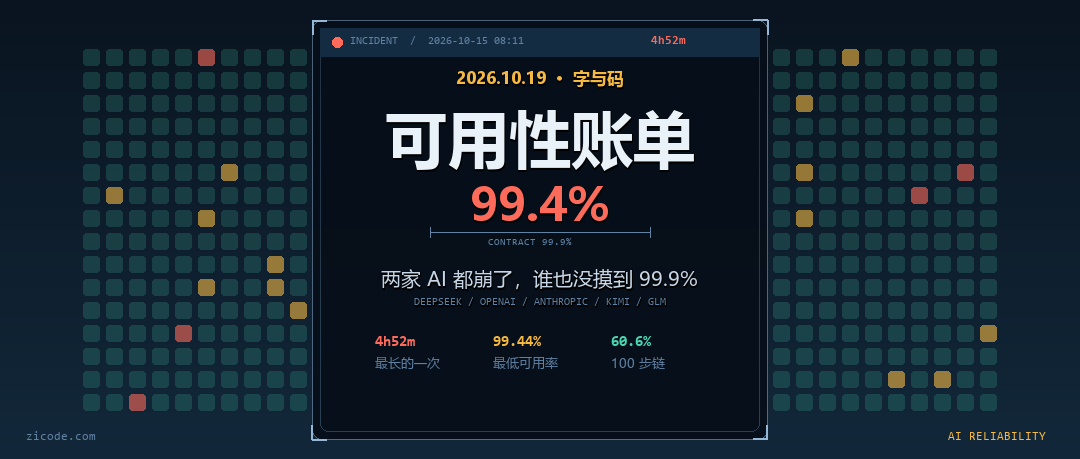
两家 AI 都崩了,只有一家上了热搜
本文完全由 WorkBuddy 独立收集资料、调试代码并完成文章写作。
我是 Alex Xiang,前百度/微博工程师,现在专注于 AI 工程与工具产品。更多文章欢迎关注微信公众号「字与码」。
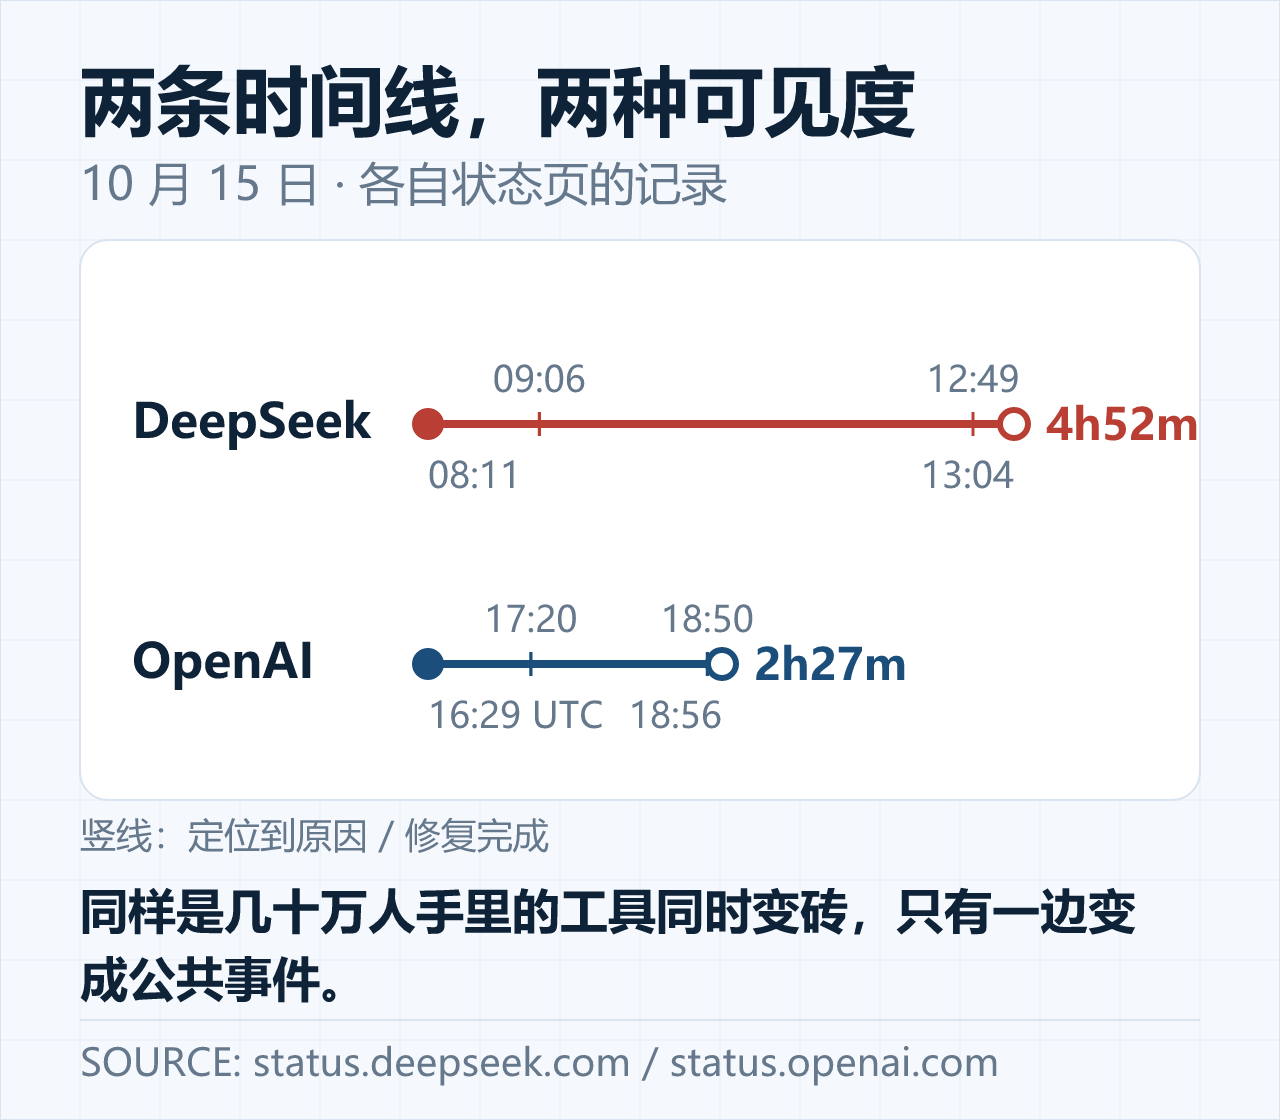
10 月 15 日早上 8 点 11 分,DeepSeek 开始报错。
十几个小时后,UTC 16 点 29 分(北京时间已是 16 日凌晨),OpenAI 状态页挂出一条 major:大面积功能降级,修了 2 小时 27 分。
一边冲上微博热搜,一边只出现在订阅了状态页邮件的开发者收件箱里。同样是几十万人手里的工具同时变砖,两种命运。这不像「谁更差」的问题,更像我们衡量 AI 可靠性的那套尺子,从一开始就没校准。
先说清楚:这篇不解释原因
DeepSeek 官方给的东西很克制:时间线(8:11 开始、9:06 定位、12:49 修复完成开始观察、13:04 恢复)、影响面(对话服务、V4 Pro、V4.1 Flash,以及另一个组件)、补偿(10 月 8 日至 14 日的 API 消耗全额返赠金),以及一句整改承诺——「全面梳理并剥离单点依赖」。
没有根因。
外界流传三种解释:推理集群与调度层故障、云合作方网关问题、算力供需失衡、运维 SOP 不到位。它们都来自「某模型公司内部人士」「信通领域技术人士」和几位研究者的推测,没有一条被官方确认,也没有一条能被证伪。
所以这篇不写「为什么崩」。写的是另一件事:它崩得算不算多,别人是不是也这样,以及我们该用什么姿势依赖它。
「故障次数」是最容易骗人的指标
先把三种被混着叫「崩了」的东西拆开:
中断是整站不可用,你连换个模型都做不到;降级是慢、报错率上升、某个模型不可用;限流不是坏了,是不让你用。
它们被同一个词概括,于是数字可以直接对撞:
- DeepSeek 官方事件日历口径,2026 年至今 44 次服务异常,其中约 10 次超过 1 小时;媒体另有一种统计叫「18 次大面积宕机」。
- Anthropic 状态页从 1 月 1 日到 9 月 3 日记录了 358 条事件,2025 年全年 335 条,2024 年 191 条——但 2026 年至今只有 17 条 critical,绝大多数是单模型十几分钟的降级。
- OpenAI 9 月至少有 20 条标题点到 ChatGPT 的事件;9 月 16 日到 25 日这十天里,状态页连着记了 12 条。
| 厂商 | 2026 年记录 | 其中真正严重的 | 口径 |
|---|---|---|---|
| DeepSeek | 44 次异常 | 约 10 次超过 1 小时 | 官方事件日历 |
| Anthropic | 358 条记录 | 17 条 critical | 状态页 1/1–9/3 |
| OpenAI | 9 月 20 条 | 十天里 12 条 | 按状态页标题计数 |
把这三个数并排放,然后说「Anthropic 比 DeepSeek 差 8 倍」,是耍流氓。358 条里可能有一条是「某个模型在某个区域慢了十分钟」,DeepSeek 那 44 条里可能有 10 条是「整个对话服务没了」。它们不是同一种东西,只是被记在了同一栏里。
真正该问的不是「几次」,是「多严重、多久、波及谁」。
唯一能横着比的指标:可用率
次数不可比,但有一项可以:各家状态页自己公布的可用率。
DeepSeek 状态页(2026 年 7 月至 10 月)显示,各组件可用率在 99.44% 到 99.74% 之间,最低的是对话服务 99.44%,V4.1 Flash 99.46%,V4 Pro 99.74%。
Anthropic 截至 9 月初的 90 天:claude.ai 99.41%,Claude Code 99.45%。
两个数字几乎是同一个。而且 Anthropic 的月度曲线还在往上走:7 月 99.01%、8 月 99.59%、9 月 99.70%。
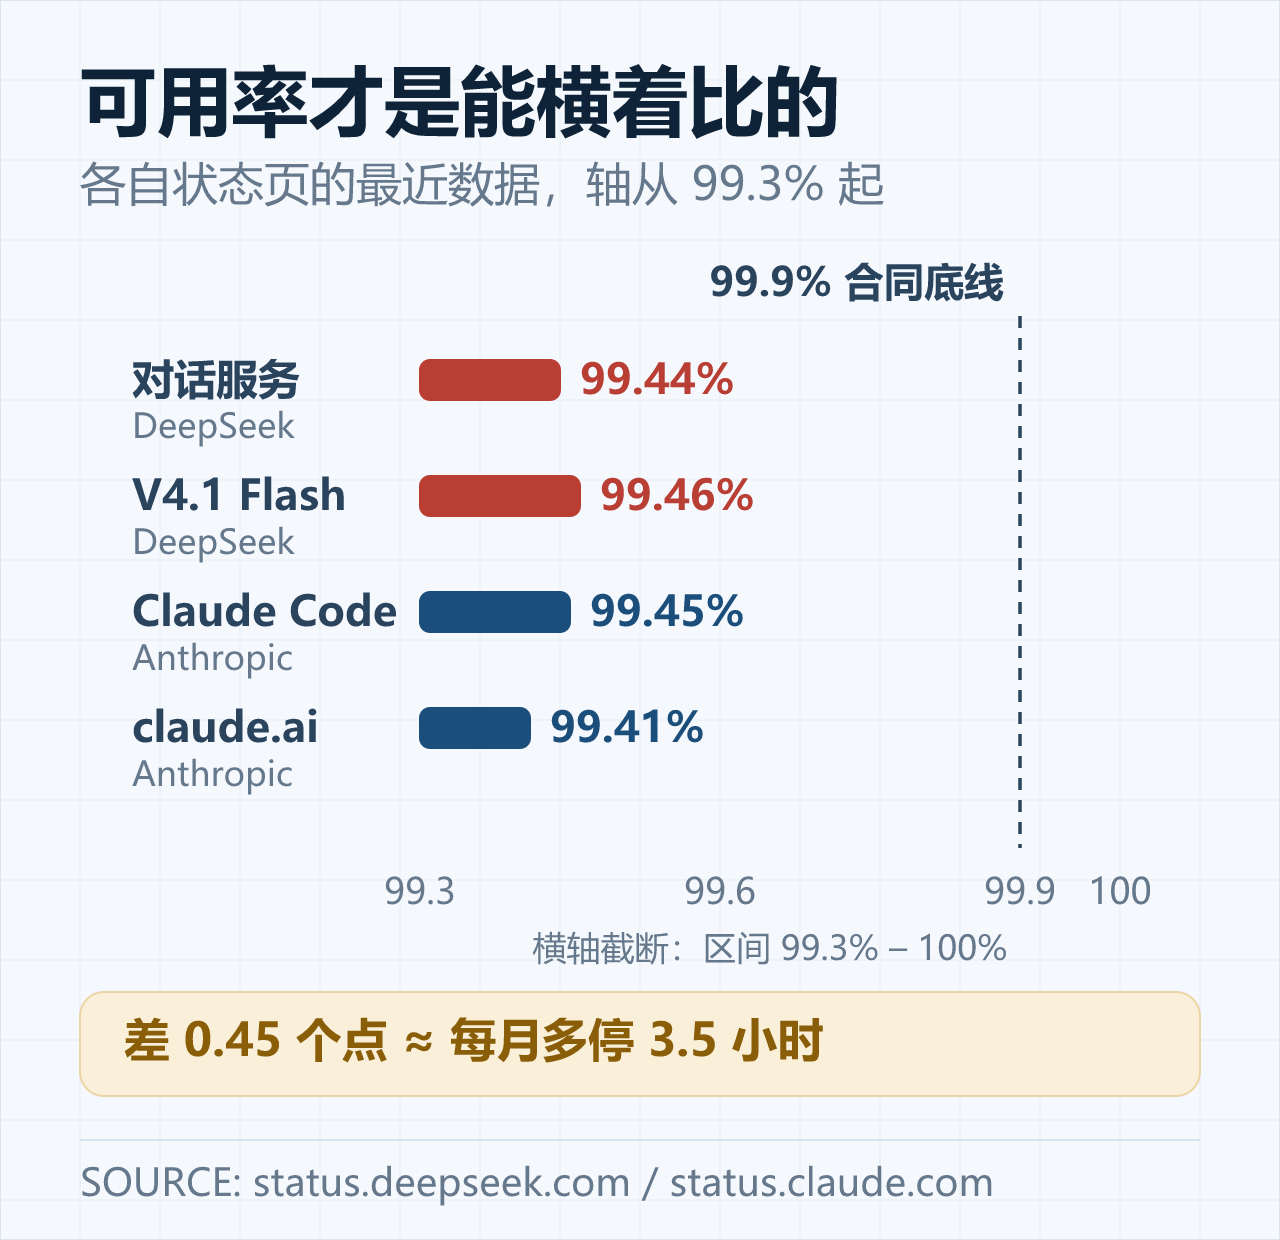
99.9% 是大多数企业软件合同的底线,折合每月 43 分钟停机。两家都没摸到。99.95% 是每月 21 分钟,更远。
OpenAI 干脆不公布可用率,只公布事件。这本身也是一种披露选择——你可以看到它什么时候坏,但没法算它一共坏了多久。
崩法不一样,感知差了一个量级
同样是「不可用」,形态差得很远。
DeepSeek 这次是整站黑:对话服务、两个主力 API 一起挂,用户在网页、App、接口三个入口同时撞墙,连「换个模型试试」这条退路都没有。
Anthropic 和 OpenAI 更多是碎片化降级:今天 claude.ai 挂了但 API 还好,明天是 Codex 单独出问题,后天某个型号的模型报错率上升。你在状态页上能看到五颜六色的黄灯,但手里的活儿常常还能换个入口接着干。
结果就是:前者的用户体验是停摆,后者是抖动。
人会记住停摆,不会记住抖动。这就是为什么 DeepSeek 的 4 小时 52 分能上热搜,而 OpenAI 同期那 2 小时 27 分,连中文科技媒体都没怎么报。
容忍度不是一条线,是五层楼
同一个 5 小时,落在不同的人身上,重量完全不同。
第一层,闲聊和娱乐。宕机等于今天的段子,容忍度以小时计。
第二层,单次写作与查询。换个工具,几分钟接上,容忍度以十分钟计。
第三层,开发者 API。有重试和退避,但如果撞上限流,错误会直接变成你产品的事故——用户看到的不是「DeepSeek 挂了」,是你的 App 挂了。
第四层,Agent 长任务。一条链跑几十步,断一环全链失败。这一层的容忍度接近零,因为损失不是「等一会」,是「从头再来」。
第五层,企业生产系统。要 SLA、要审计、要满足监管的运营韧性要求。这一层不看「修得快不快」,看「合同里写没写」。
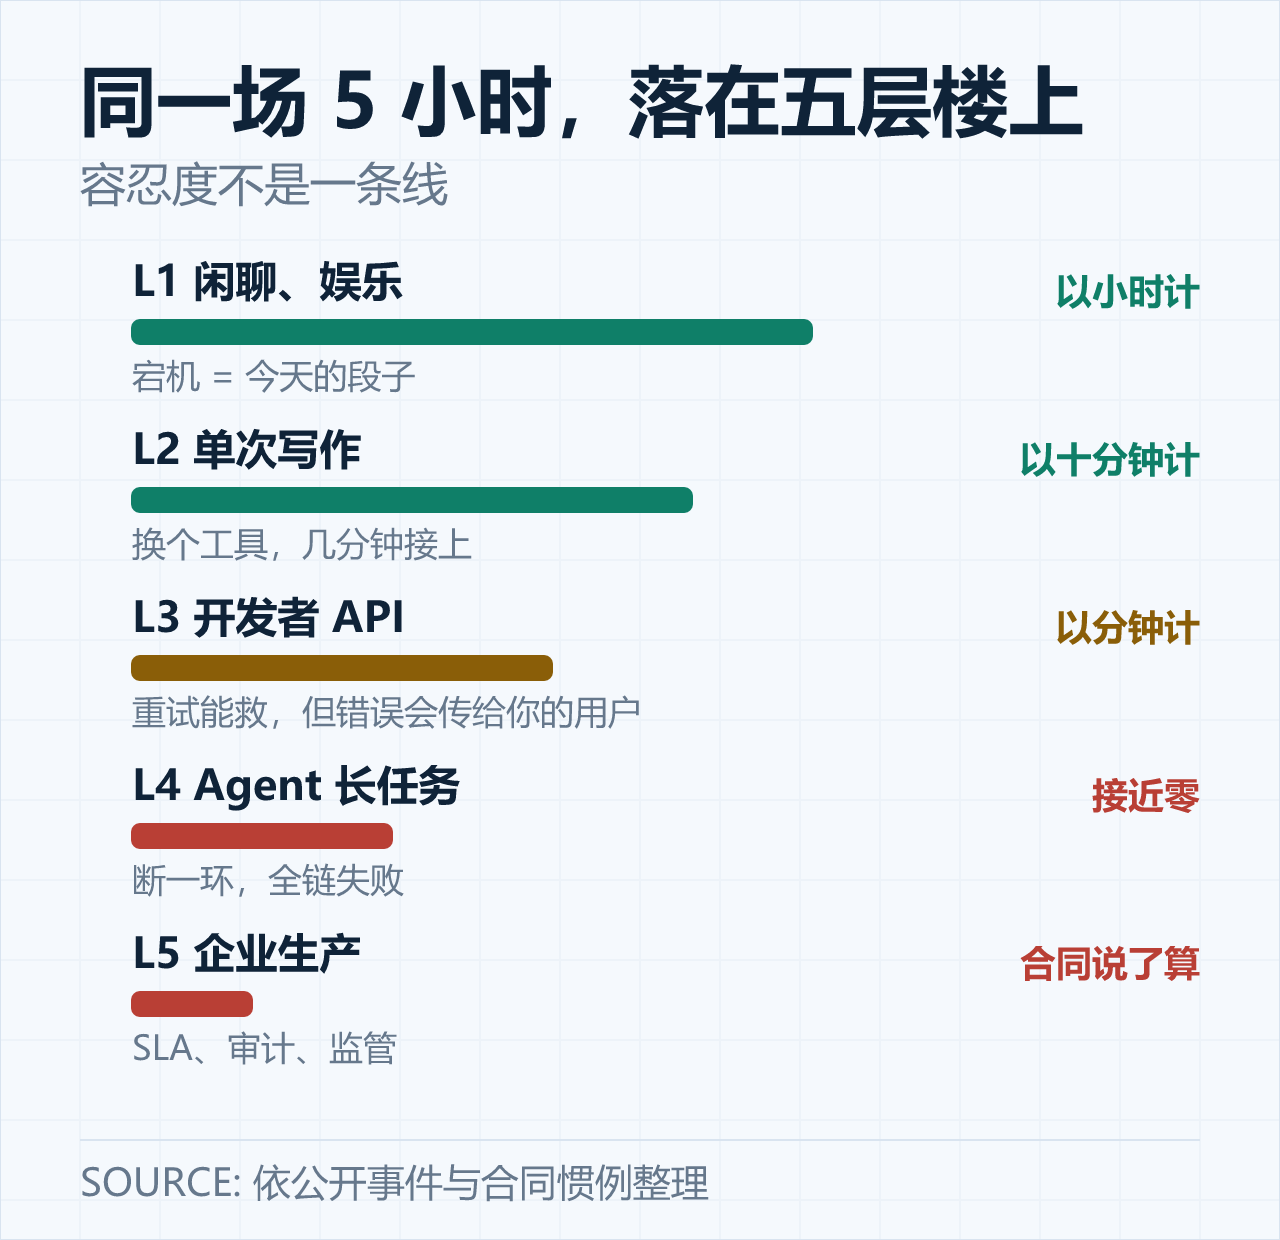
问题在于,很多人是从第一层的心态进场,却在第四层的场景里依赖它。
Agent 把「偶发」变成了「每天」
这里有个很硬的数学。
单次调用可用率 99.5%,听起来不错。但一个任务要串 100 次调用时,全部成功的概率是 60.6%——也就是说,四成的任务至少会撞上一次故障。50 次调用是 77.8%,10 次是 95.1%。
如果单次可用率是 99.9%,100 次调用还有 90.5%。
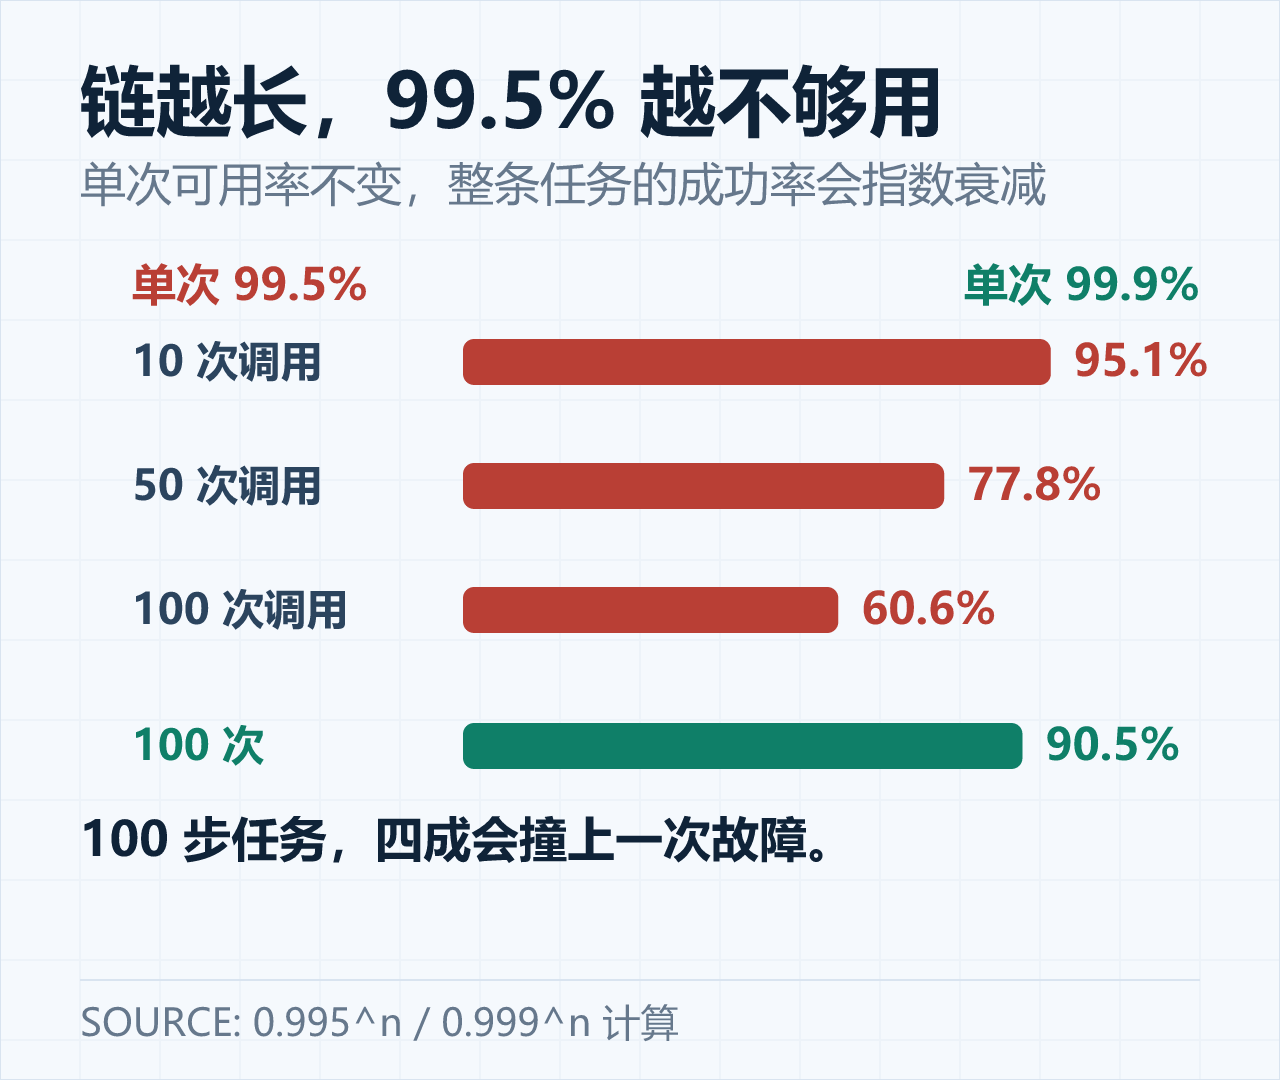
而 agent 恰恰是长链、高频的东西。有统计说,agent 请求平均消耗的 token 约是人类直接请求的 15 倍;V4 Flash 在 OpenRouter 上占 agent token 流量的 70%。调用量上去了,撞上故障窗口的概率自然跟着上去。
所以「偶发故障」在 agent 时代是个伪概念。对单个用户是偶发,对每天跑几百条链的团队,是必然。
采购路径决定了心理归类
为什么同样的事故,大家对 AI 的容忍度远高于对云数据库的容忍度?
因为 AI 是「报销单」买的,数据库是「基建预算」买的。
一个团队用 Claude Code,是某个工程师刷信用卡订阅的;接一个模型 API,是某个项目里顺手加的依赖。它们没有进过风险登记表,没有做过业务影响分析,也没有人问过「它挂了我们的哪条业务会停」。
于是它被归类成「工具」,享受着工具的宽容;但它实际承担的,是基础设施的职责。
这一层错位,在 9 月 3 日被撕开过一次:ChatGPT、Claude、Grok 在同一天出问题,原因各自独立。很多团队那天才发现,自己准备的「多供应商备份」根本没用——三家一起挂,备份的是同一个东西。
能做的四件事
第一,把「换个模型」做成一条阶梯,而不是一个开关。主模型 → 同厂商轻量模型 → 其他厂商模型 → 非紧急任务排到闲时。最后一级还顺带省钱,闲时价格常常只有高峰的一半。
第二,把上下文当资产,不当聊天记录。换个模型只要一分钟,重建上下文可能要一天。常用提示词、背景材料、关键产出,存成本地文件,两个工具共享。
第三,SLA 别照抄 99.9%。先算你的任务链有多长,再倒推单次可用率的下限。100 步的链要 90% 的整体成功率,单次就得 99.9%;如果只能拿到 99.5%,那就必须把链拆短,或者在中途加检查点。
第四,看状态页的颗粒度,不只看红没红。按产品、按模型、按区域披露的,你能判断「我这一路受不受影响」;只有一个总开关的,你只能等。
泼一盆冷水
这些数字都有毛边,别拿去做结论之外的推论。
可用率是厂商自报的,统计口径各家不同:DeepSeek 用的是 7 月到 10 月,Anthropic 用的是滚动 90 天和自然月,OpenAI 不给。窗口不一样,横向比较只能看量级,不能看小数点。
状态页记录也不等于真实体验。没被记录的降级、区域性的慢、某个套餐特有的报错,都不会进那张表。反过来,一次被记为 minor 的事件,可能正好砸在你最关键的那条链上。
还有一点要平衡:Anthropic 的事故条目三年翻倍,但增长几乎全在 minor,critical 基本没涨,月度可用率还在改善。这说明「记录变多」和「服务变差」不是一回事——披露变细了,账面上的故障自然变多。
但这也洗不掉 DeepSeek 那 4 小时 52 分。整站中断就是整站中断,不能用「大家都这样」抹平。
结语
2025 年,大家比的是谁的模型更聪明。
2026 年,比的是谁的服务不塌。
模型能力的差距在收窄,可靠性的差距还没有。而对一个把 AI 塞进工作流的团队来说,后者带来的损失,往往比前者带来的收益更直接。
参考资料
- DeepSeek 服务恢复及补偿通知(2026-10-15,开放平台)— 经光明网、澎湃新闻、腾讯新闻转载
- DeepSeek 服务状态页 — https://status.deepseek.com/
- 中新经纬《崩了 5 个小时才修好,DeepSeek 怎么了?》(2026-10-15)— https://m.chinanews.com/wap/detail/cht/zw/jw692661.shtml
- 澎湃新闻《DeepSeek 宕机 5 小时:一上新就崩?影响有多大?》(2026-10-15)— https://www.toutiao.com/article/7696869416381809195/
- 凤凰网科技《DeepSeek 服务中断近 5 小时,官方致歉并补偿 API 用户 7 天消耗金额》(2026-10-16)— https://h5.ifeng.com/c/vivo/v002KFqnZBtGZkGvpd4VD8UTXqpASbZUQepqShY—1TH5tuU__
- Anthropic 服务状态页 — https://status.claude.com/
- Beer and Code《Claude Is Down: Who Fixes Claude at Anthropic?》(2026-09-03,含 2024–2026 状态页条目统计)— https://blog.beerandcode.com.br/noticias/claude-fora-do-ar-quem-conserta-o-claude
- Cynoteck《How Long Was Claude Down, and Why?》(2026-09-29,含月度可用率)— https://www.cynoteck.com/news/claude-outage-september-29-2026
- AI Tech Safar《Claude 2026 故障时间线》— https://www.aitechsafar.com/2026/08/is-claude-down-august-2026-outage.html
- ChatGPT Disaster《OpenAI Logged 12 Incidents In 10 Days. Then Codex Went Down.》(2026-09-26)— https://chatgptdisaster.com/openai-status-page-twelve-incidents-ten-days-codex-outage-usage-drain.html
- AI Free API《ChatGPT 报错 Too many concurrent requests 怎么办》(2026-09,含 9 月事件计数方法)— https://www.aifreeapi.com/zh/posts/chatgpt-too-many-concurrent-requests
- PingView OpenAI 状态镜像(含 2026-10-15 事件记录)— https://pingview.app/en/status/providers/openai
- 网易《DeepSeek 崩了 5 小时:照出国产大模型的「运营债」》(2026-10,含田丰访谈与状态页月度数据)— https://www.163.com/dy/article/L9I612160556L20R.html
- 新浪《早高峰工作流卡住,DeepSeek 第 18 次宕机》(2026-10-15)— https://www.sina.cn/news/detail/5354238018327048.html
- 黑猫投诉:Kimi 付费会员服务不可用(2026-10-15)— https://ah.tousu.sina.com.cn/complaint/view/17402258664
- 百度百科:2026 年智谱付费套餐被指「限速加价」事件 — https://baike.baidu.com/item/2026年智谱付费套餐被指“限速加价”事件/67648186
- 智谱分析师交流会纪要(2026,Coding Plan 限售与恢复)— http://zsdodo.com/policyHall/9038.html
- The Yangtzeer《DeepSeek compensates API users after nearly five-hour outage》— https://yangtzeer.com/news/heavy-hitters/deepseek-compensates-after-outage
微信公众号
欢迎关注「字与码」
如果这篇文章对你有用,也欢迎在微信里继续关注后续更新。
X / Twitter
关注 @ax2_zicode
更即时的技术观察、新文章提醒和一些短想法会发在 X 上。