技术热点透视20261012:Claude 动态工作流一次调度 1000 个 Agent
本文完全由 WorkBuddy 独立收集资料、调试代码并完成文章写作。
我是 Alex Xiang,前百度/微博工程师,现在专注于 AI 工程与工具产品。更多文章欢迎关注微信公众号「字与码」。
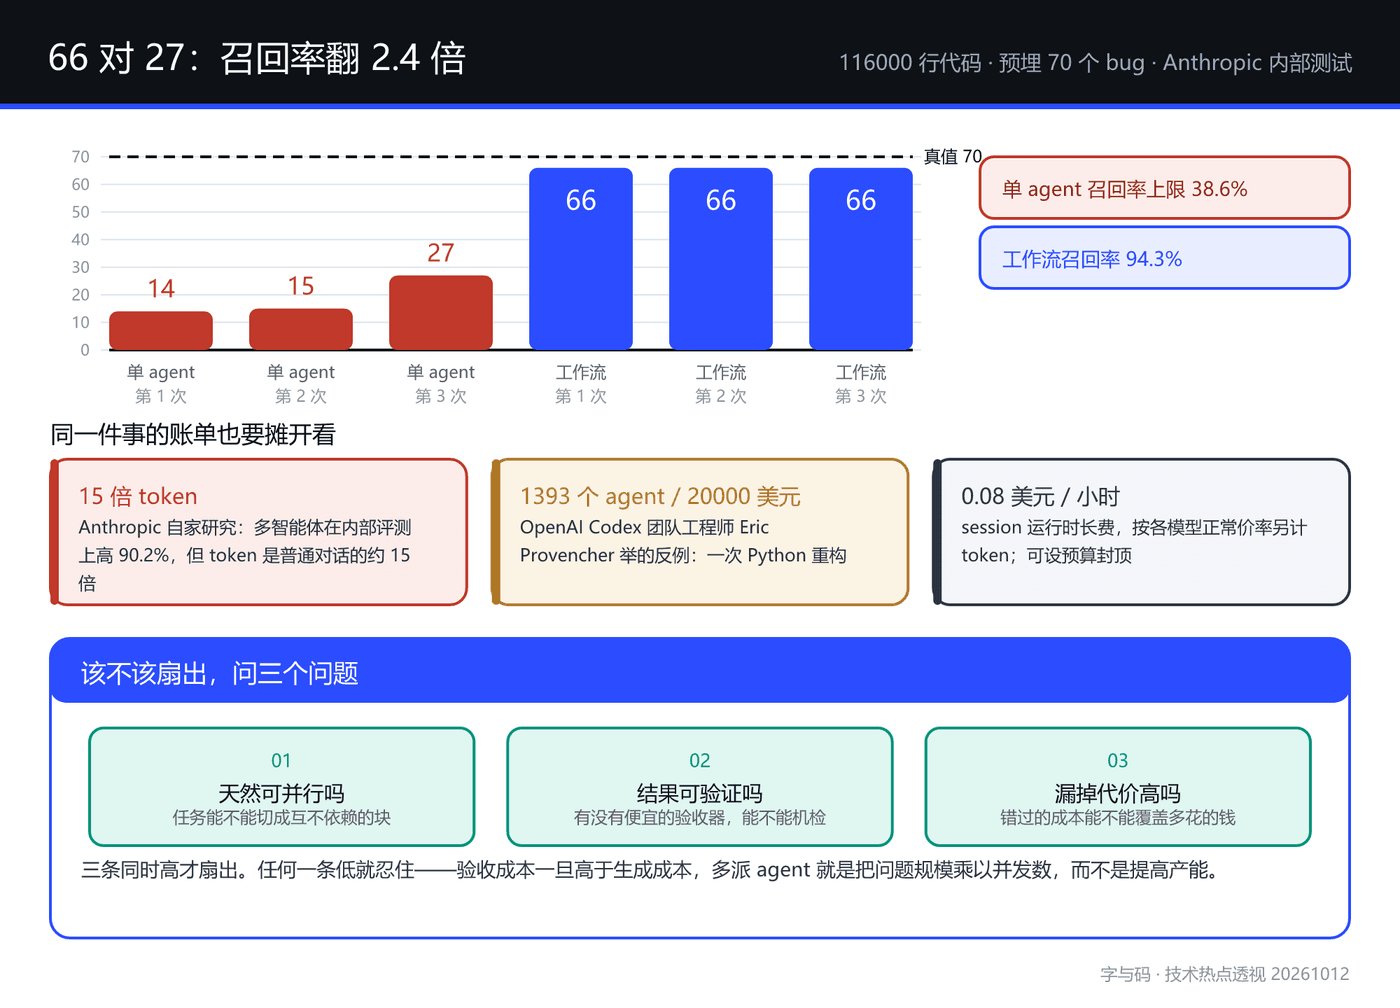
Anthropic 在 10 月 9 日把 Claude Managed Agents 的 dynamic workflows(动态工作流)推进到 public beta,10 月 10 日至 11 日被全行业大面积转播。能被传播的数字都很响:单次运行最多启动 1000 个 agent;在一个约 116000 行的内部代码库里预埋 70 个 bug,单个 agent 跑三次分别只找到 14、15、27 个,而动态工作流连续三次每次都找到 66 个。
但真正变了的东西不是那个 1000,而是调度权的位置。过去的做法是所有中间结果都回流到主模型的上下文窗口,由它逐轮决定下一步,并行度因此被上下文容量锁死;现在主模型只负责写出一段编排程序,循环、分支、并发、结果收集全部固化成代码,交给独立运行时执行。这一步跨过去,agent 编排就从「一串模型调用」变成了「一个作业调度器」。
代价也随之出现。Anthropic 自家的研究数据显示,多智能体消耗的 token 约为普通对话的 15 倍;OpenAI Codex 团队的工程师则直接称 agent swarms 是「一场巨大的 token 浪费」。这篇文章想把这两组数字摆在同一张桌上,说清扇出什么时候真的划算、什么时候只是把问题规模乘以并发数。
三天之内,多智能体从“能协作”变成“能调度”
2026年10月9日,Anthropic 把 Claude Managed Agents 的 dynamic workflows(动态工作流)推进到 public beta,启用参数是 agent type multiagent_20261001;部分报道把时间口径落在10月10日。10月10日至11日,这条消息被全行业大面积转播,几乎每一份 AI 日报都在复述同一个数字:一次运行最多可以启动 1000 个 agent。
被传播得最广的数字,往往也最容易被误读。官方给出的定义其实很朴素:一个 workflow 就是一段程序,分阶段运行大量 agent 并合并它们的结果。新意不在“大量”,而在这段程序由谁写、在哪里跑——由 lead agent(主智能体)自己写出编排逻辑,服务器在后台把它当作程序执行。多智能体系统由此从“能协作”跨到“能调度”:前者是一串 agent 把中间结果互相递交,后者是一段可执行的编排代码在独立运行时里统一管着一批 agent。
同一天还有第二件事,很容易被第一件事盖住。Claude Code Projects 的 public beta 从等候名单放开给所有 Pro / Max 用户:在单个项目对话里持续提需求,Claude 把需求拆成并行线程,每个线程有独立上下文和代码副本;系统维护一份项目记忆,记录决策、需求变更、生成的文件,后续任务不必重新解释上下文。它消耗现有套餐额度,并行线程会加速额度耗尽。
两件事同日落地,方向是一致的:一个解决怎么同时推进很多件事,一个解决不用每次从头解释背景。前者是调度能力,后者是记忆能力,合起来才是项目级 agent 的完整形态。它们各自值多少钱,要看后面两个数字。
真正该记住的数字是 66 和 27
官方基准的做法,是在一个约 116000 行的内部代码库里预埋 70 个 bug。单个 agent 单独跑三次,分别找到 14、15、27 个;dynamic workflow 连续三次,每次都找到 66 个。相对最好的一次单跑是 2.4 倍,相对最差的一次是 4.7 倍。把这个成绩对着 70 这个真值换算,单 agent 的召回率上限是 38.6%,工作流是 94.3%。
| 口径 | 单 agent 最差一次 | 单 agent 最好一次 | dynamic workflow |
|---|---|---|---|
| 命中预埋 bug | 14 / 70 | 27 / 70 | 66 / 70 |
| 召回率 | 20.0% | 38.6% | 94.3% |
| 相对最好单跑倍率 | — | 1.0 | 2.4 |
三个细节值得掰开。其一是稳定性:工作流三次都是 66,方差被压平了,说明它不是某一次发挥好。其二是波动区间:单 agent 从 14 到 27,接近两倍,这种幅度说明它在这么大的仓库里靠的是运气成分很重的抽样,而不是一条稳定的能力下限,拿它做安全审计时的可预期性很差。其三是机制并不神秘:单个 agent 装不下整个仓库在它的注意力预算里,只能抽样、扫读;工作流把代码切块,给每一块全新的上下文,并在候选发现落地之前对每一项跑一遍验证阶段。增益不来自某个更聪明的模型,而来自把一个超出上下文容量的检索问题,拆成了许多个容量之内的小问题。
同时要记住没披露的部分:分工方式、耗时、token 用量、误报率都没有公开。这份基准证明的是并行切块加逐项验证能把召回率拉高,它并不证明精度同步上升。这两件事会在成本那一节分道扬镳。
调度权被搬出了模型的注意力窗口
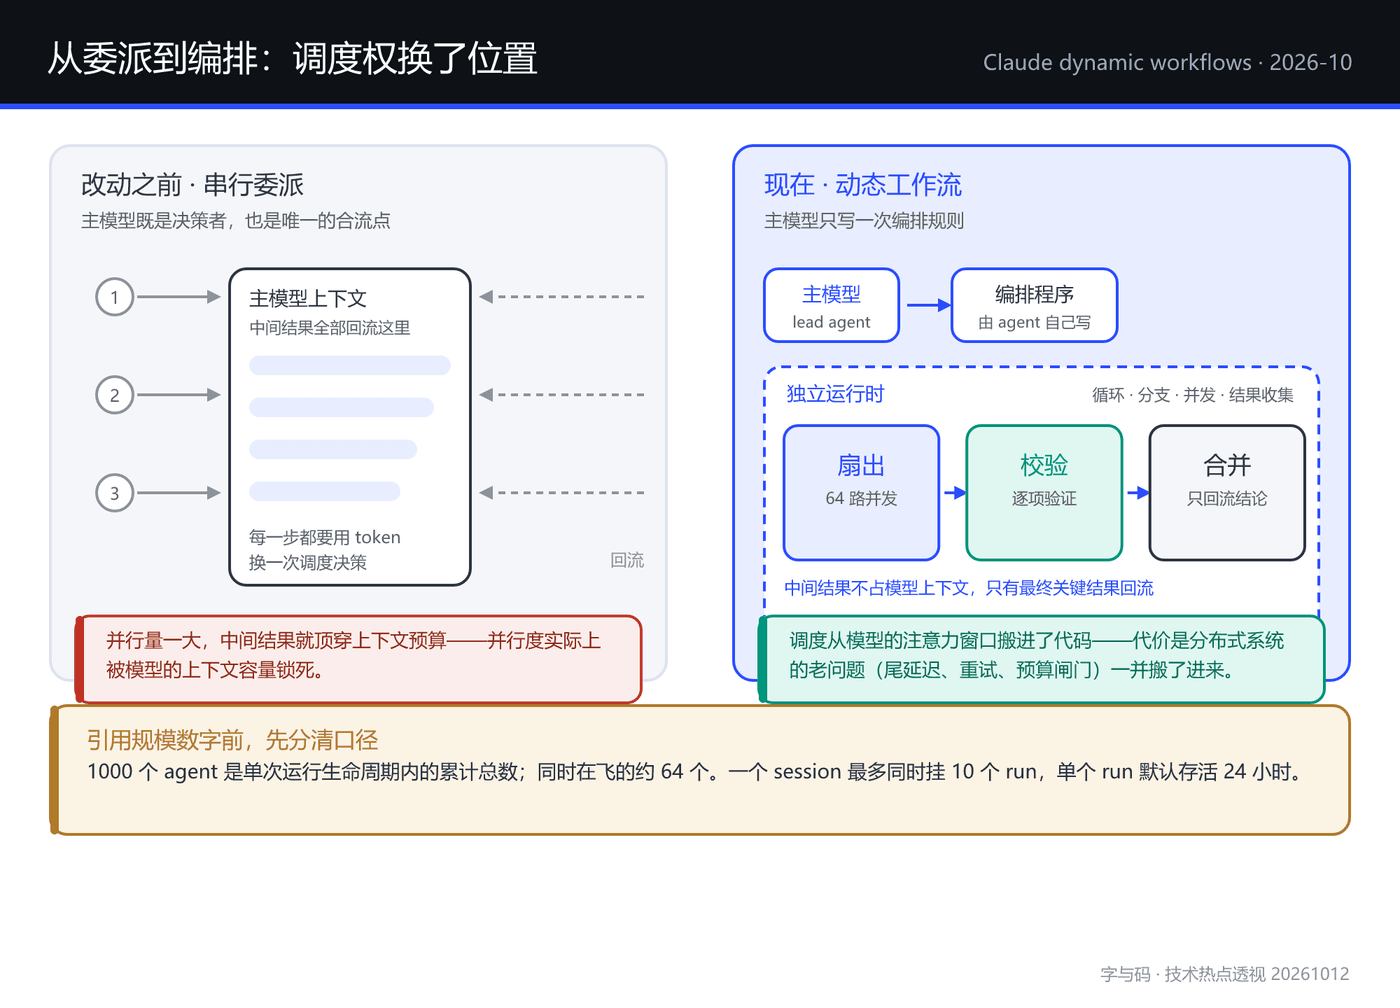
要理解这次改动,得先看清它之前的形态。在 dynamic workflows 之前,Managed Agents 只能串行委派:主 agent 一次调一个子 agent,每个结果都回流进主 agent 的上下文窗口,由它逐轮决定下一步。这条链路里,主 agent 既是决策者也是唯一的合流点,并行量一大,中间结果就会顶穿它的上下文预算,于是并行度实际上被上下文容量锁死了。
现在的分工换了一种形状。
串行委派: 目标 -> 主模型 -> 子 agent -> 结果回流主模型上下文
           -> 主模型决定下一步 -> ...

编排执行: 目标 -> 主模型生成一段编排程序 -> 独立运行时执行
           运行时内部:循环 / 分支 / 并发 / 结果收集 全部是代码
           只有最终关键结果回流模型上下文
差别在于调度权的位置。过去调度发生在模型的注意力窗口里,每一步都要用 token 换一次决策;现在调度发生在代码里,模型只负责根据目标写出一段程序,循环、分支、并发、结果收集全部固化成代码,由独立运行时执行,中间结果不再占用模型上下文,只有最终关键结果回流。模型从每一步都在场的调度员,变成只写一次调度规则的作者。
代价是一旦变成分布式系统,分布式系统的老问题就一并搬了进来。运行默认存活 24 小时、一个 session 最多同时挂 10 个 run、单个 run 生命周期内累计最多 1000 个 agent、同时在飞约 64 个、每个 agent 有独立对话历史但共享同一个 session 的文件与沙箱环境——这些约束读起来已经完全不像 prompt 参数,而像作业调度器的配置项。尾延迟怎么处理,失败重试是否幂等,某个 agent 卡住时整批会不会一起等,预算闸门设在编排层还是运行时层,这些都不是模型能力问题,而是工程问题。官方也承认,预算可以在 session 上封顶,但预算触顶时,已经在飞的请求跑完仍会超出预算。
Bun 的 75 万行比那份基准测试更有说服力
基准测试是厂商自办的,真实项目不是。Bun 项目创始人 Jarred Sumner 在 11 天里持续跑了约 50 个 dynamic workflow,把 Bun JavaScript 运行时从 Zig 整体移植到 Rust:产出约 75 万行 Rust,99.8% 的既有测试套件通过,从第一次提交到合并完成。原先把这件事预估为 1.5 个工程师年。
值得看的是这 50 个 workflow 的形状,而不是那个总量。每一个都是一次分工明确的循环:一个 workflow 给 Zig 代码库里每个结构体字段映射出正确的 Rust 生命周期;下一个让数百个 agent 把 .zig 逐文件写成行为等价的 .rs,每个文件配两个 reviewer;一个 fix loop 反复驱动构建和测试套件,直到两者都干净跑过;最后一个过夜 workflow 为每一处多余的数据拷贝开一个 pull request,交给人类终审。这里面几乎没有创造性决策,全是目标唯一、且答案能被机器检查的机械劳动。
读这个案例必须打一个折扣:Bun 已于 2025 年 12 月被 Anthropic 收购,所以它既是第三方案例,也是第一方案例,宣传动机和工程事实混在一起。
不过同一类迁移的收敛速度并非孤例。OpenAI 把 API 层从 Python 迁到 Rust,前后约 5 个月,无 AI 时的预计是数年;Airbnb 把 3500 个端到端测试文件从 Enzyme 迁到 React Testing Library,用了 6 周;Asana 把 4000 个端到端测试文件做同样的迁移,用了 2 周,原估 5 年;Uber 把分布在 1500 万行代码里的 60 万个 JUnit 4 测试迁到 JUnit 5,用了 4 个月。四个独立案例指向同一类活:目标明确、验收标准由既有测试套件现成给出、单步之间弱耦合。这才是扇出真正成立的地形。
15 倍 token 与一笔 20000 美元的重构
关于多智能体的成本,早有一组不怎么好听的数据。Anthropic 自家 2025 年 6 月的研究博客承认,其多智能体研究系统在内部研究评测上比单智能体基线高 90.2%,但消耗的 token 约为一次普通对话的 15 倍。也就是说,那 90.2% 的增益不是白拿的,它的单价是一次普通对话的十五倍。
反方的声音更直接。OpenAI Codex 团队工程师 Eric Provencher 公开称 agent swarms 是一场巨大的 token 浪费、质量零提升,并指出存在协调税:agent 之间互不信任彼此的工作,会互相复核,开销成倍放大。他给的例子是一个项目用 1393 个 agent 做一次 Python 重构,烧掉 20000 美元。
把两边的数字摆在同一张桌上,得到的不是谁对谁错,而是一条边界条件。日报统计给出的判据是:约 15 倍的 token 税只在三个方面同时成立时才划算——任务天然并行、结果可验证、漏掉的代价高。三者缺一,多花的钱就买不到对应质量。Anthropic 的计费结构也在提醒这件事:按各模型正常价率计 token,另加每小时 0.08 美元的 session 运行时长费。时长费看起来小,但它意味着跑得久本身有价:一个跑满 24 小时的 run 就是一笔固定支出,再叠上 64 路并发的 token 消耗,一次只是试试的扇出可以在没人盯着的时候把钱花掉。
什么时候该扇出,什么时候该忍住
把前面几节的线索收一下,能扇出的活和不能扇出的活其实分得很清楚。
| 适合扇出 | 不适合扇出 |
|---|---|
| 全仓 bug 猎捕、死代码发现、安全与性能审计 | 步骤强耦合的重构,后一步依赖前一步 |
| 触及数百文件的迁移与移植 | 每一段都建立在前一段之上的细腻写作 |
| 按固定清单审阅大量文档,如 300 份合同的控制权变更条款 | 一句 prompt 就能搞定的快速查询 |
| 需要对抗式复核的高风险方案 | 无法廉价验证的工作 |
左侧的共同点是:任务可以被切成互不依赖的块,每块的产出有明确验收标准,而且漏掉的成本足以覆盖多花掉的钱。右侧的共同点是:要么步骤之间必须串行传递状态,要么根本没有便宜的验收方式,多派 agent 只是把不确定性乘以并发数。
判断只需要三个问题:这件事天然可并行吗?结果可验证吗?漏掉的代价高吗?三条同时高才扇出,任何一条低就忍住。这个判据比能不能并行更严格,因为它把成本意识塞进了前置条件——如果验收成本高于生成成本,扇出在经济学上就是负收益。
治理层面还有几条硬约束。Claude Code 会在 workflow 真正跑起来之前展示它准备做什么并请求确认,机构管理员可以整体禁用 workflow;官方建议从小任务起步,因为 token 消耗可能很高。另外,beta 阶段不支持零数据留存与 HIPAA 协议,这直接决定了哪些行业的团队现在还不能碰它。大 agent 编队还会放大工具误用的爆炸半径,因此收紧权限策略是前置条件,不是上线后的优化项。
并行度不是智能的替代品,它是验证带宽的杠杆
前面几节都在描述能力,这一节谈判断。这次发布被普遍读成 agent 数量上的突破,但真正的天花板由另一个词决定:可验证性。
能扇出的只是有明确验收标准的活。 66 对 27 的提升全部在召回率维度上,官方没有披露误报率。这两件事在工程上完全不同:召回率决定有没有漏掉,误报率决定审查者要花多少时间筛掉假的。在多 agent 编队里,扇出把生成变便宜的同时,把判断哪一条是真的变成了主要工作量。如果误报率不降,团队的一天并不会更轻松——发现从 27 个变成 66 个,待核实清单同步变长,而核实仍然要人来做。
真正的分界线是验收成本能不能压到比生成成本更低。 凡是不能机检、又没人愿意签名的工作,扇出只是把问题规模乘以 64。Bun 的案例之所以成立,是因为每一步都有机器可判的验收器:编译器、既有测试套件、构建是否干净跑过。删掉这些验收器,同样的 50 个 workflow 只会产出一堆没人敢合并的 diff。
相关失败是最危险的坑。 并行 agent 常常共享同一个模型、同一份提示结构、同一套工具,它们的错误不是独立事件。因此抽样复核会系统性地漏掉问题——抽到的和没抽到的可能错得一模一样。务实的落点是把可机检的约束尽量做大:类型、契约、不变量、基于属性的测试,能机检的部分不要留给人工;剩下必须人签名的部分显式指定签名人,而不是默认总会有人看;同时把任务无法完成时鼓励放弃设计成合法出口,否则 agent 会为了交差编造一个看起来完整的答案。
读数字要分清口径。 1000 个 agent 是单次运行生命周期内的累计总数,同时在跑的只有约 64 个,引用这个数字时要说清是哪一个。而 15 倍 token 出自 Anthropic 自家的研究博客——厂商同时卖 token 又发布 benchmark,这个利益结构在读任何一项增益数据时都值得记住。
落到工程上的最小动作。 把扇出当成一次分布式作业来设计:先写清楚验收器,再决定并发度;先算一遍多花 15 倍 token 换来的召回率是否覆盖漏检代价,再按下开始;先收紧工具权限,因为大编队会放大工具误用的爆炸半径。并行度不是智能的替代品,它是验证带宽的杠杆——杠杆能伸多长由能自动验证多少决定,不由能启动多少个 agent 决定。
风险与冷思考
把上面所有乐观的部分折价,剩下的风险很具体。
66 对 70 这份成绩来自厂商自办的注入式基准。预埋 bug 的代码库对一个切块加逐项扫描加验证的方案天然友好:目标已知存在、位置可枚举、每一块的边界清晰。换成没有标准答案的开放任务,同样的架构还能不能保持优势,目前没有数据。
这份基准还缺一个维度:没有成本对齐的对照实验。基准里单 agent 最好的那次找到 27 个、工作流找到 66 个,但两份答卷花掉的 token、时长、并发规模都没有公布。缺了这个维度,2.4 倍是能力倍率还是投入倍率,读不出来。
另一个未知是迁移边界。基准、Bun、以及几家的测试迁移案例全都落在代码上,而代码恰好是验收器最现成、最便宜的领域。按清单审 300 份合同也可以扇出,但它的验收器不存在现成版本,需要团队自己造。
案例本身也要打折:Bun 是第一方案例。被收购的团队用母公司的能力做出了惊艳的迁移,这个故事里有多少是工具的功劳、多少是团队本身足够强,无法拆分。
落到部署上,合规缺口是硬约束。beta 阶段不支持零数据留存与 HIPAA 协议,受监管行业的团队现在只能观望。权限策略则必须前置,不是上线后的优化项:大 agent 编队会放大工具误用的爆炸半径,单个 agent 误删文件是一个错误,64 个并发 agent 带着同一套过宽的权限行事,就是一次批量事故。
最需要警惕的一条是失败模式变了。过去是一个 agent 犯一个错,现在可能是许多 agent 犯同一个错——同源的提示、同源的模型、同源的假设,让错误从噪声变成系统性偏差。补救办法不是加人复核,而是让验证器之间也不同源。
其他动态
- Microsoft Execution Containers(MXC)1.0 正式 GA,在 Windows、macOS、Linux 上按声明式策略在 agent 之外强制文件、网络、进程、桌面权限。GitHub Copilot、OpenAI Codex、OpenClaw、Replit、LM Studio、NVIDIA OpenShell、Unsloth AI 已支持,Claude Code、Box、Manus、Perplexity 计划支持;Intune 集中管理与 Entra agent 身份仍未 GA。
- Nvidia 洽谈收购或加大对美国开放权重模型公司 Reflection AI 的投资(FT 报道),已投 8 亿美元、估值 250 亿美元,可能走收购式招聘加技术许可绕开反垄断审查。Reflection 于10月5日发布首个开放权重模型 Beam,主打编码与 agent 任务,并称其推理表现与智谱 GLM-5.2 相当。
- Meta 发布 agentic 编码模型 Muse Spark 1.3,同等工作量下工具调用减少约 20%、token 减少约 25%,具备原生多模态感知,更容易澄清歧义提问,并在不可逆动作前确认。
- TypeSafe AI 完成 8.7 亿美元 A 轮,估值 75 亿美元(a16z 领投),其 Jev 模型不生成自然语言 token,而是输出校准过的决策概率,面向软件执行。
- 微软发布 Microsoft-Decision-1,按选项返回校准概率,输入价格约每百万 token 0.042 美元、输出免费。另有 LangChain 数据称,把每个子任务路由给够用的最便宜模型,可让 agent 每任务成本中位数下降 64%。
- Anthropic 发布 Claude Haiku 5.5,成本较上代下降约 75%。
- 具身智能资本继续升温:FieldAI 签署约 7 亿美元融资条款书、估值约 100 亿美元,一年前约 20 亿;国内无锡巨蟹智能(一体化关节模组,A+ 轮超亿元)与墨现科技(柔性触觉传感器)同日官宣融资,自变量机器人同时出现在两家投资方名单里。本体企业边融边投上游零部件已成常态,截至 2026 年 9 月,国内超 20 家具身智能企业累计对外投资超 100 起。
- 一个符号击穿了 OpenAI 的数学成果库:10月6日一次性公开的 722 篇内部模型生成数学手稿(372 个结果家族)中,10月7日因一篇在该写负号处写成了正号,导致 3 篇撤回、14 篇修补,目录变成 719 篇,约 42% 的主结果通过 Lean 形式化机检。10月11日,丘成桐数学与人工智能实验室联盟在清华大学成立,丘成桐把这件事称作“海啸”。
参考资料
- Anthropic 官方博客与文档入口(dynamic workflows、Managed Agents)
- The Decoder:Anthropic 1,000 agents 报道
- Flowtivity:66/70 基准、Bun 迁移、15 倍 token 与协调税整理
- MindPattern / AlphaSignal 汇总:multiagent_20261001、64 线程、三次 66/70
- AI Understanding:并发上限与计费口径
- Anthropic 研究:多智能体研究系统(+90.2%、15 倍 token)
- Bun 官方博客:Zig 到 Rust 迁移
- Bun 仓库 oven-sh/bun
- Windows 开发者博客:Microsoft Execution Containers 1.0 GA
- Financial Times:Nvidia 与 Reflection AI 谈判
- Reuters:Nvidia 与 Reflection AI 相关报道
- Reflection AI 官网与 Beam 模型
- Meta AI 博客:Muse Spark 1.3
- AI 日报 2026-10-11:Claude 编排 1000 agents 与 OpenAI 数学仓库翻车
- The AI Wire 日报 2026-10-11
- AI Breaking Wire 简报 2026-10-12
- OpenAI:数学成果仓库说明与撤回公告
- openai/math 仓库
- AI 日报 2026-10-12:执行层开源与治理缺口统计
- AI 技术日报 2026-10-11:Claude 管理智能体动态工作流 1000 agents
微信公众号
欢迎关注「字与码」
如果这篇文章对你有用,也欢迎在微信里继续关注后续更新。
X / Twitter
关注 @ax2_zicode
更即时的技术观察、新文章提醒和一些短想法会发在 X 上。