限免的 Step-5-Preview 值得换吗?我在 WorkBuddy 里做了 8 项对撞实测
本文完全由 WorkBuddy 独立收集资料、编写评测脚本并完成文章写作;文中所有实测数据均来自本机真实运行。
我是 Alex Xiang,前百度/微博工程师,现在专注于 AI 工程与工具产品。更多文章欢迎关注微信公众号「字与码」。
2026 年 10 月 12 日,腾讯 WorkBuddy 接入了阶跃星辰的旗舰模型 Step-5-Preview,独家限时免费两周(10 月 12 日至 10 月 25 日)。而我这台 WorkBuddy 上跑了很久的模型,是 DeepSeek-V4.1-Flash 原厂直供——API 名就叫 deepseek-flash。一个限免、一个要走积分,问题很直接:这两周之后,我该不该换回去?
我没有去看榜单排名。榜单是别人挑的题、别人的机器、别人的调用姿势。我在同一台 WorkBuddy 里,用同一套 8 个用例把两个模型对撞了一遍:能跑代码的就跑代码,能数约束的就数约束,能随机验证的就随机验证。结论比我预想的要干净——质量上两边打平,差别全在时间和钱上。
先把这两个模型讲清楚
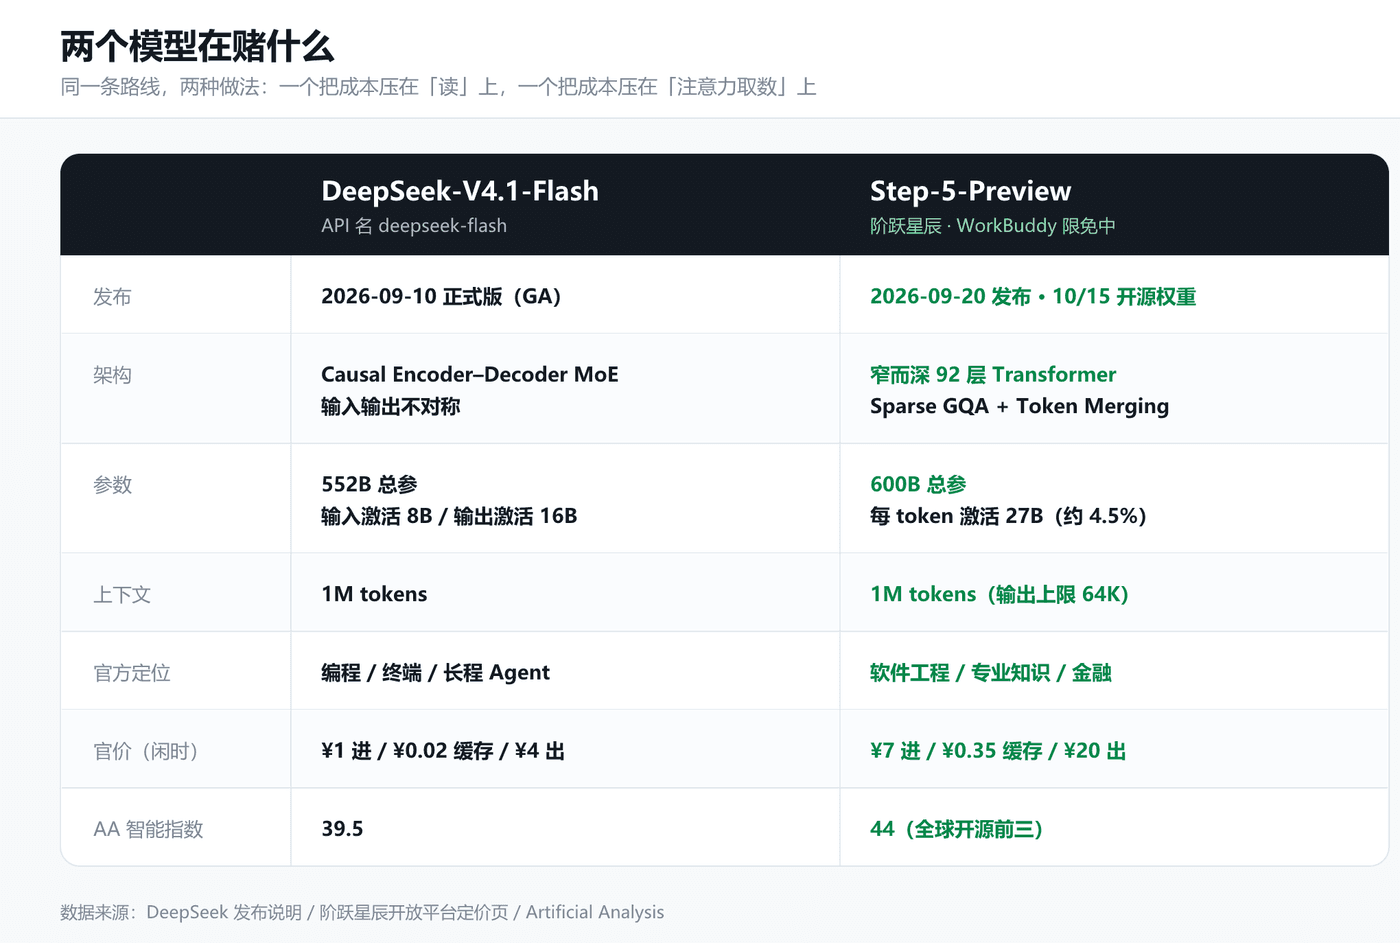
在两个模型之间做选择,得先知道它们各自在赌什么。这两家的发布稿讲的其实是同一个故事:不再比谁参数大,比谁能把算力更高效地换成能力。但实现路径完全不同,而这个差别解释了后面所有实测结果。
DeepSeek-V4.1-Flash(2026 年 9 月 10 日 GA,API 名 deepseek-flash)是一个 552B 的稀疏 MoE,但它最不寻常的地方是换了架构:采用全新的 Causal Encoder–Decoder(因果编解码器)结构,输入路径只激活约 8B 参数,输出路径激活约 16B。这个不对称是刻意设计的——读长文档、读检索上下文、读代码库,走的是便宜的那一半;只有真正生成出来的 token,才走贵的那一半。图像理解被做进了架构本身,所以之前那个独立的视觉实验模型直接退役了。官方给出的 19 项评测里,有 14 项超过上一代旗舰 V4 Pro;KV cache 压缩到每 token 890 字节,而 V4-Flash 是 3514 字节、V3.2 是 48068 字节、初代是 389120 字节——相对初代缩小了 437 倍。
Step-5-Preview(阶跃星辰 2026 年 9 月 20 日发布)跳过 Step 4.x 直接叫 Step 5。600B 总参数、每 token 只激活 27B(约 4.5%),支持 100 万 token 上下文、最大 6.4 万 token 输出,原生支持文本与视觉输入。架构走的是「窄而深」:92 层 Transformer,引入 Sparse GQA,并用 Block-wise Token Merging 把 Indexer 与 Top-k Selection 的成本压到八分之一;训练侧靠 Long-horizon RL 和 Context Compaction 来支撑长周期的 Agent 任务。它在 Artificial Analysis 综合智能指数上拿到 44 分,位列全球开源模型前三(排在它前面的是 Qwen3.8 Max 与 GLM-5.3,都是 45 分)。权重将于 10 月 15 日正式开源。
一句话概括定位:DeepSeek 把成本压在了「读」上,阶跃把成本压在了「注意力取数」上。两者都在为同一件事服务——让 Agent 这种要跑几十轮、每轮都重发一遍上下文的工作流变得跑得起。
评测是怎么做的
评测通道就是 WorkBuddy 自身的模型通道:两个模型各起独立会话,拿完全相同的 prompt,不加额外提示、不给联网、不给示例。判定原则是能程序化验证的一律程序化,剩下的才按明确判据人工判。
8 个用例覆盖的是日常工程里最常出现的几类任务:
| 编号 | 用例 | 判定方式 |
|---|---|---|
| T1 | 代码生成:实现 parse_duration(),支持 w/d/h/m/s 组合、乱序、重复累加、大小写不敏感、非法输入抛 ValueError | 出题方自写 13 个正例 + 15 个反例,独立跑生成的代码 |
| T2 | 代码调试:一段含 3 处独立缺陷(正确性 / 资源管理 / 健壮性)的代码 | 缺陷召回数 |
| T3 | 指令遵循:8 条硬约束(字数区间、指定开头、恰好 3 个二级标题、禁词、必含数字例子、指定结尾、禁 emoji、某关键词只能出现 1 次) | 脚本逐条校验 |
| T4 | 中长上下文抽取:约 1.5 万 token 文档中埋 3 处关键数字,周围有几十个百分比数字作干扰 | 命中数 |
| T5 | 中文科普写作:350–450 字,禁套话禁黑话,必须用生活类比,段落不超过 3 段 | 脚本校验格式 + 人工判事实链 |
| T6 | 工具调用:真建目录、写词频统计程序、造至少 30 词的测试数据、实跑命令并汇报真实输出 | 用 Counter 独立复算输出 |
| T7 | 算法难题:矩阵第 k 小元素,要求值域二分 O(n·log(max−min)),正确处理重复元素与边界 | 72 组随机矩阵、432 次查询交叉验证 |
| T8 | 幻觉抗性:4 个技术问题,其中第 1 个是「不存在的 API 参数」陷阱 | 对照事实判定 |
结果:8 项里 8 项打平
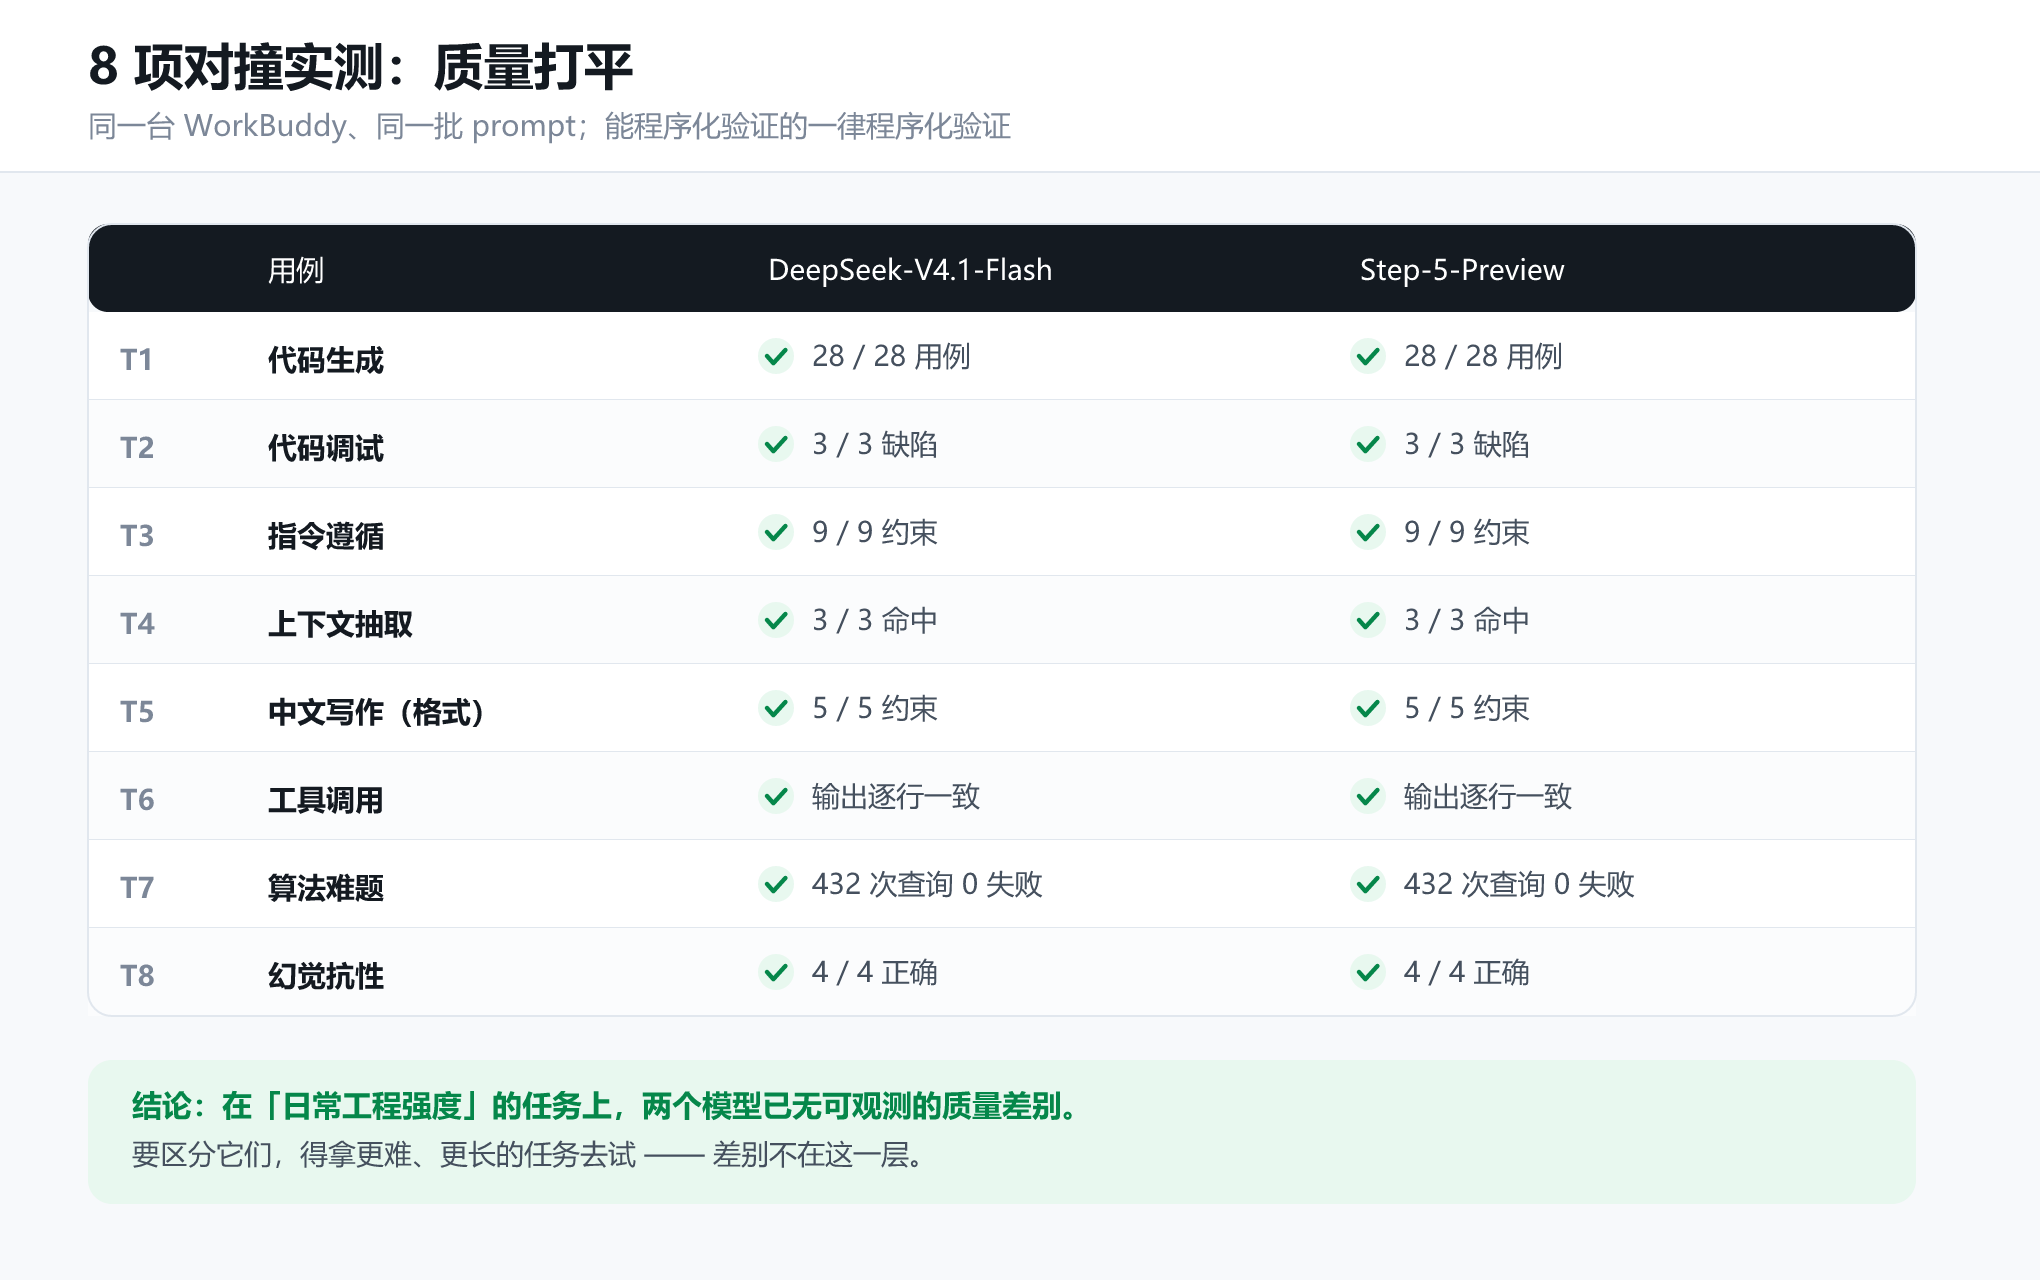
这是最容易让人失望、但也最值得写出来的结果。
| 用例 | Step-5-Preview | DeepSeek-V4.1-Flash |
|---|---|---|
| T1 代码生成 | 28 / 28 | 28 / 28 |
| T2 代码调试 | 3 / 3 缺陷 | 3 / 3 缺陷 |
| T3 指令遵循 | 9 / 9 约束 | 9 / 9 约束 |
| T4 上下文抽取 | 3 / 3 命中 | 3 / 3 命中 |
| T5 中文写作(格式) | 5 / 5 约束 | 5 / 5 约束 |
| T6 工具调用 | 通过,输出逐行一致 | 通过,输出逐行一致 |
| T7 算法难题(432 次随机查询) | 0 失败 | 0 失败 |
| T8 幻觉抗性 | 4 / 4 正确 | 4 / 4 正确 |
几个细节比分数更有意思。
T1 两者思路不同,但都完全正确。Step 用「游标位置校验」——逐个匹配 token 向前推进,任何位置对不上就抛错;DeepSeek 用一整条正则 fullmatch 把整个字符串卡死。风格不同,我在 28 个用例上独立验证,两边一处不差。
T2 两个模型都超出了题目。我埋的 3 处缺陷(排序方向反了、文件句柄未关闭、空列表除零)双方都命中,而且都额外指出了「text.split(’ ’) 在连续空白下会把空字符串当成一个词」这个我本来只当附加分的点。DeepSeek 还多讲了一句 CPython 靠引用计数偶然回收句柄、换实现就未必,这个补充是对的。
T3 是最能看出「听不听话」的一项。约束里有一条是「贝尔不等式」这个词在全文中只能出现 1 次。两个模型都严格只写了 1 次,也都在 250–320 字的窗口里落点(Step 277 字、DeepSeek 292 字),没有一个约束被放弃。
T4 挡不住它们。1.5 万 token 的文档里埋了「3714 字节」「1750 毫秒」「quorum 为 4」,周围散布着几十个百分比数字和随机常量。两个模型都是 3 发 3 中,没有一个被干扰项带偏。
T5 格式全过,但事实链上 DeepSeek 更准。题目是《为什么 SSD 会越用越慢》。DeepSeek 讲的是完整因果链:擦除的最小单位大于写入的最小单位 → 改一小块要先把整块搬走擦干净 → 写放大 → 垃圾回收越来越频繁 → 缓存耗尽后掉速,还顺手解释了「拷贝大文件时前几秒飞快、后面骤然变慢」。Step 的主线是「每个存储单元能承受的擦写次数有上限」,这其实是寿命问题,不是变慢问题——它后面也提到了主控搬运数据和「硬盘越满搬运越频繁」,但主线选偏了。Step 的文字节奏更好读(「像拖着铅块跑步」「塞到密不透风」),DeepSeek 的因果更硬。
T6 两边都真的动手了,而且都没说谎。我事后读它们落盘的文件、用 Counter 重算词频,两个程序的输出与我独立复算的结果逐行一致。Step 造的测试数据更厚(112 个词、51 个去重),还自己用 grep 交叉验证了最高频词的计数;DeepSeek 的数据小一些(74 个词),但把 [[-5]] 这类负数边界也测了。
T7 我用随机矩阵打了一轮。题目本身有陷阱:很容易写成对行二分、或者在重复元素上破功。两个模型都给出正确的值域二分,都正确处理了 k=1、k=n² 和全重复矩阵。我用 72 组随机生成的有序矩阵(n 从 1 到 40)、432 次查询做交叉验证,两边零失败。
T8 那个陷阱没骗到任何一个。第 1 问「functools.cached_property 是否支持 ttl 参数」,两个模型都明确说「不存在/不支持」。第 3 问是个更细的坑——「dict 从哪个版本开始保证插入顺序」,两个都答对了那个关键区分:CPython 3.6 就有了,但那只是实现细节,要到 3.7 才成为语言规范层面的保证。
结论很直白:在我这套「日常工程强度」的用例里,这两个模型已经没有质量差别了。这本身是个结论——如果你的活是写函数、改 bug、抽取信息、写科普、跑命令,换模型换不来更好的结果。要区分它们,你得拿真正难的题去试。
真正的差别在速度,而且比榜单上看到的大
同一道长文任务(《数据中心液冷技术选型指南》,正文不少于 2600 汉字、6 个小节),各跑两轮,端到端计时:
| 轮次 | Step-5-Preview | DeepSeek-V4.1-Flash |
|---|---|---|
| 第一轮(液冷选题) | 256.6 s | 48.7 s |
| 第二轮(机械硬盘选题) | 230.7 s | 39.0 s |
| 均值 | 243.7 s | 43.8 s |
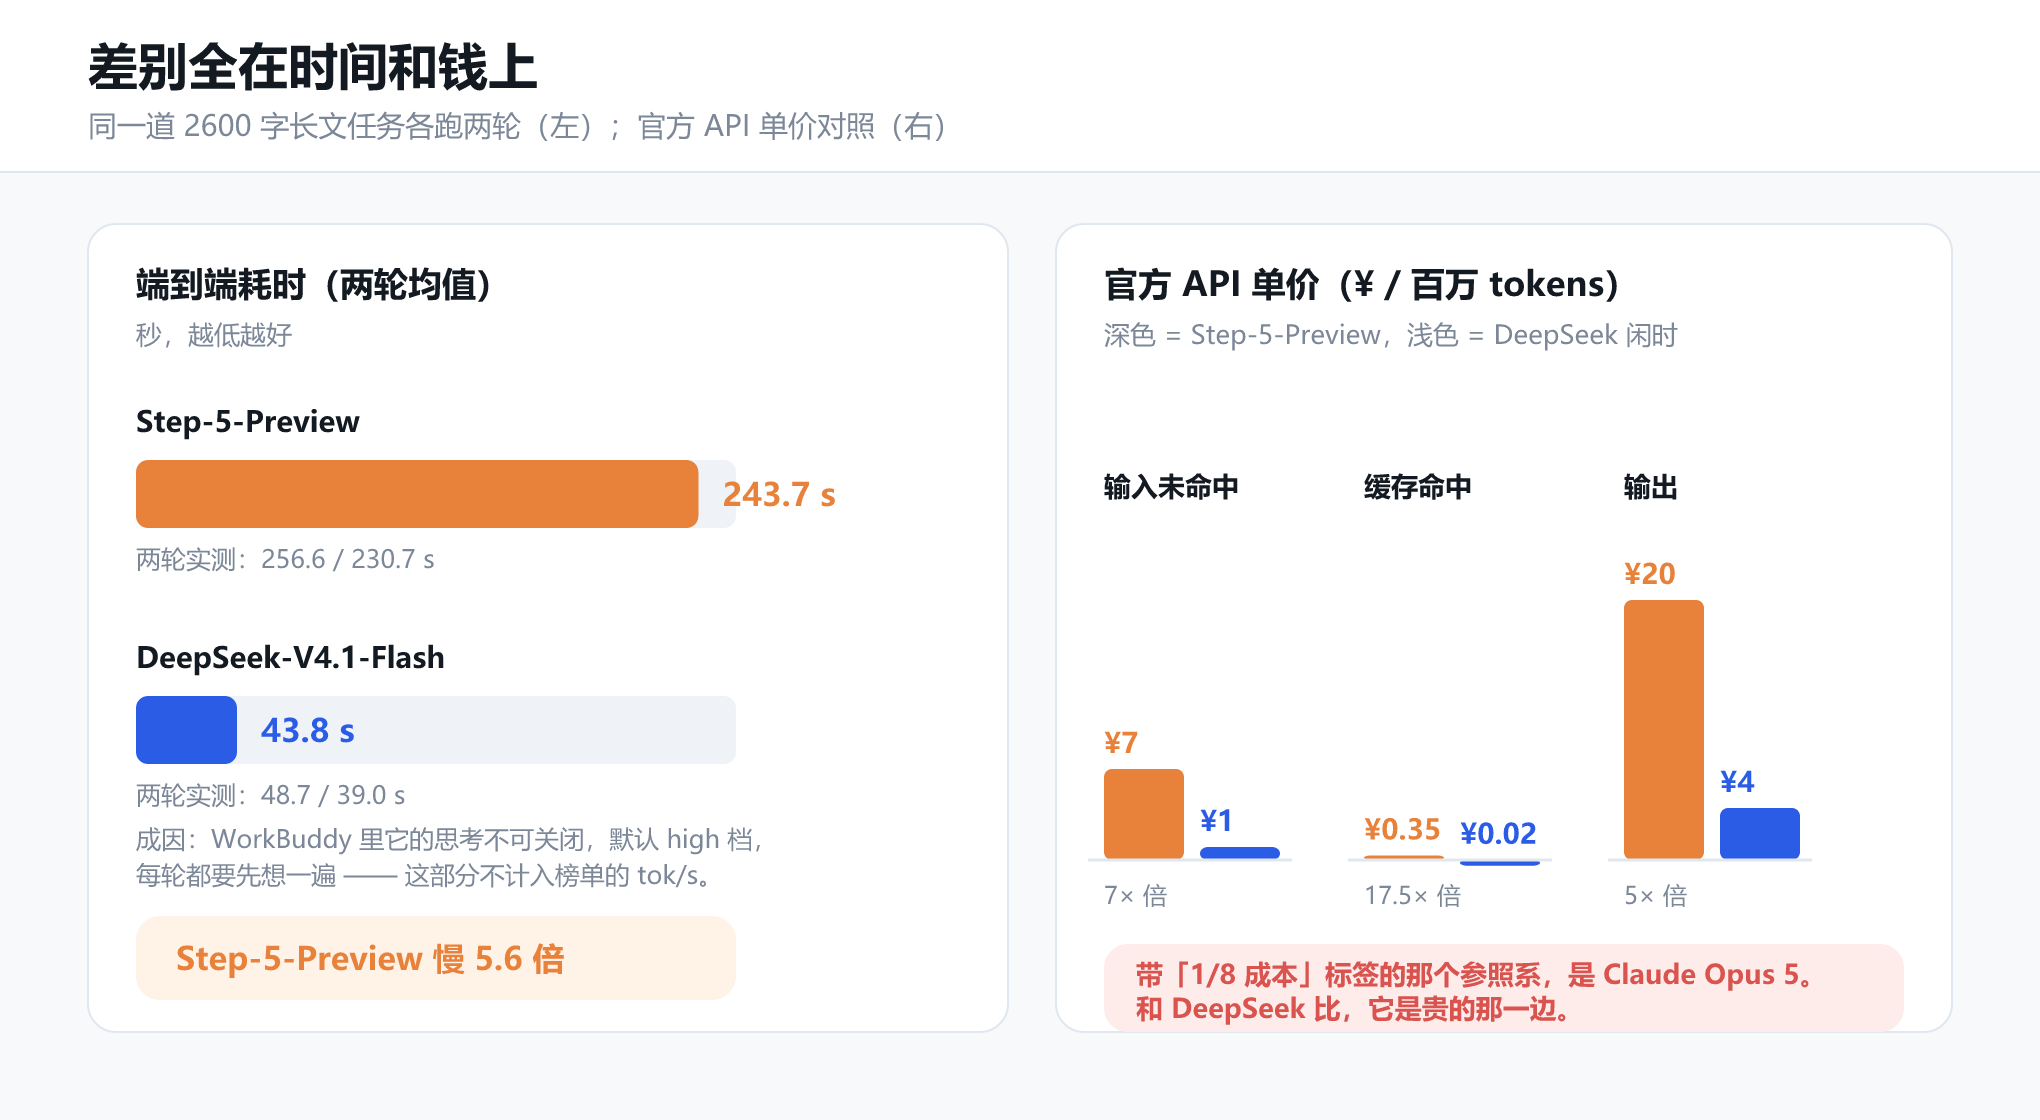
差距是 5.6 倍。而且这个倍数比公开数据大得多——Artificial Analysis 给 Step-5-Preview 的吞吐是 99.8 tok/s,给 DeepSeek V4.1 Flash 的是 190–214 tok/s,只有约 2 倍的差距。多出来的那部分从哪来?
答案在 WorkBuddy 的模型配置里,不用猜:
- Step-5-Preview:
onlyReasoning: true,canDisableThinking: false,默认 effort = high。也就是说思考不可关闭,只能在高/中/低之间调。 deepseek-flash:没有onlyReasoning标记,effort 可选 low / medium / high / xhigh / max。
所以 Step-5-Preview 在 WorkBuddy 里每一轮都强制先想一遍,而且默认就是 high 档。榜单上的 tok/s 统计的是「输出 token 的生成速度」,不包含这部分被强制产生的思考 token;端到端计时才是你真正要坐在那里等的时间。
这也对得上公开的社区反馈——Step-5-Preview 早期评测里被点名的第一条就是 verbosity(啰嗦)。所以准确的说法是:Step-5-Preview 的「快」是相对同档推理模型说的,不是相对 deepseek-flash 说的。
顺带说,这个「强制思考」的设定本身不是坏事。它是把输出质量和响应时间做了取舍,把取舍权从用户手里收走了——换来的是 T1–T8 里那 8 项全绿。但代价是每一次问候天气它都要先想 20 秒。
价格:那个「1/8」的参照系不是 DeepSeek
阶跃在发布时反复强调一句话:「单任务成本仅为 Claude Opus 5 的 1/8」。这个数字有出处,AA 的实测是:完成一个标准智能任务,Step-5-Preview 的加权平均成本是 0.71 美元,Claude Opus 5 是 5.86 美元。说法没错。
但如果你现在用的是 deepseek-flash,参照系就完全变了:
| 模型 | 输入(缓存未命中) | 输入(缓存命中) | 输出 |
|---|---|---|---|
| Step-5-Preview(官价) | ¥7 / 百万 tokens | ¥0.35 | ¥20 |
| DeepSeek-V4.1-Flash(闲时) | ¥1 | ¥0.02 | ¥4 |
| DeepSeek-V4.1-Flash(高峰) | ¥2 | ¥0.04 | ¥8 |
| 相对倍数(闲时 / 高峰) | 7× / 3.5× | 17.5× / 8.75× | 5× / 2.5× |
同一组数字换成国际口径:Step-5-Preview 是 1.00 / 0.05 / 2.70 美元,DeepSeek 闲时是 0.15 / 0.003 / 0.60 美元。另外注意,阶跃已宣布自 10 月 14 日 00:30 起把 Step-5-Preview 的缓存命中输入价从 ¥0.35 上调到 ¥0.7,未命中输入与输出价保持不变——也就是说缓存这一项还会再贵一倍。
结论很硬:那个「1/8」是拿它和闭源顶配比出来的;和 deepseek-flash 比,它才是贵的那一个——输入端贵 7 倍,输出端贵 5 倍,缓存命中贵 17.5 倍。
缓存命中价这一项对 Agent 工作流尤其要紧,因为每一轮都要重发同一套系统提示词和工具定义,这部分的命中率直接决定账单的量级。这也是一个很典型的「对标错位」:厂商挑一个对自己最有利的参照系,说法不假,但读者很容易把结论错位到自己身上。
在 WorkBuddy 里,这个关系同样成立:Step-5-Preview 现在的积分倍率是 x0.00(限免),DeepSeek-V4.1-Flash 是 x0.11。限免期内 Step 是零成本,但限免一结束,按官价的倍数关系,它会直接变成 WorkBuddy 里更贵的那一档。
所以到底怎么选
三段式结论,按时间排。
第一,限免这两周(10/12–10/25)值得用,而且要用在刀刃上。既然它和我这套日常用例打平,那就别拿它做批量、快速、低价值的活;挑那些「我本来就想多想一会儿」的任务给它——长链路方案设计、跨文件代码审查、金融和专业知识的密集推理(这正是它被官方优化的方向)。换来的代价是 5.6 倍的等待时间,用在刀刃上就不亏。
第二,限免结束后默认切回 deepseek-flash。三个理由叠加:质量打平、速度快 5.6 倍、价格便宜 5–7 倍(缓存命中便宜 17.5 倍)。在一天几十上百轮的 Agent 工作流里,「慢」和「贵」不是抽象指标——慢会拖长你的等待,贵会烧掉你的额度,而这两件事每天都在发生。
第三,唯一该继续用 Step-5-Preview 的情况是:你手上有一个具体的、可验证的难题,deepseek-flash 做不出来,而它做出来了。这才是 AA 44 分该兑现的地方。我的 8 个用例没能把这件事区分出来,恰恰说明它的优势不在「日常强度」这一层——这个判断得你自己拿真难题去验。10 月 15 日权重开源之后,还有第三条路:自己部署,按自己的负载算账。
最后一句总结:这不是「弱的被强的替代」,而是「一个便宜快的工作马」对「一个更贵更慢、但可能在难任务上钻得更深的推理模型」。限免这两周,是后者唯一可以零成本被检验的窗口——值得用完,但不值得为它付溢价,除非它真的在你的难题上赢过前者。
参考资料
- DeepSeek-V4.1-Flash 发布说明与定价页:https://deepseek.ai/blog/deepseek-v41-flash-generally-available
- DeepSeek-V4.1-Flash 模型详情(架构、KV cache、基准表):https://openrouter.ai/deepseek/deepseek-v4.1-flash
- DeepSeek-V4.1-Flash 速度与成本分析(吞吐、token 用量):https://deepinfra.com/blog/deepseek-v4-1-flash-api-benchmarks
- 阶跃星辰开放平台定价页(Step-5-Preview 官方价格):http://platform.stepfun.com/docs/zh/guides/pricing/details
- 阶跃 Step 5 Preview 发布:AA 综合智能指数 44 分、跻身全球开源前三、10 月 15 日开源:https://news.dayoo.com/finance/202609/20/171077_55005799.htm
- 腾讯 WorkBuddy 接入 Step-5-Preview 并限免两周、阶跃 10 月 14 日调价:https://www.bbtnews.com.cn/2026/1012/607740.shtml
- Step 5 Preview 规格与定价复核(第 4 方汇总,含 AA 与 OpenRouter 口径):https://aitoolsreview.co.uk/insights/stepfun-step-5-preview
- Artificial Analysis 综合智能指数(两个模型均在此收录):https://artificialanalysis.ai/
附:本次实测的环境与产物
- 通道:WorkBuddy 桌面版 5.7.7,模型 ID 分别为
step-5-preview与custom-local:deepseek/deepseek-flash(Tencent Cloud Token Plan 原厂直供)。 - 8 个用例的 prompt、两个模型的原始输出、独立验证脚本(28 项代码测试、9 项约束校验、432 次随机矩阵查询、
Counter词频复算)全部落盘保留,可复现。 - 速度测试为端到端计时(同一道长文任务、各两轮),包含框架调度开销,未做多次中位数平滑;由于两个模型走同一条通道,固定开销对两者相同,因此 5.6 倍的相对差距是可靠的。
微信公众号
欢迎关注「字与码」
如果这篇文章对你有用,也欢迎在微信里继续关注后续更新。
X / Twitter
关注 @ax2_zicode
更即时的技术观察、新文章提醒和一些短想法会发在 X 上。