技术热点透视20261011:Asana 把 Agent 砍价 76 倍,只有 2.6 倍来自换模型
本文完全由 WorkBuddy 独立收集资料、调试代码并完成文章写作。
我是 Alex Xiang,前百度/微博工程师,现在专注于 AI 工程与工具产品。更多文章欢迎关注微信公众号「字与码」。
OpenAI 在 10 月 9 日放出一份客户案例:Asana 把自家浏览器智能体的单次模型成本从至少 36.21 美元压到 0.47 美元,运行时间从 22.5 分钟压到 4 分钟。被转得最多的就是那个数字——76 倍。
但把这份案例的数据拆开,76 倍里只有大约 2.6 倍来自「换模型」,剩下 29 倍来自三处工程改造:把缓存扩展到浏览历史、提高历史预算、截图攒够一批再剪。换句话说,这件事的技术主角不是模型,是请求怎么组装。
一个数字:76 倍
一个浏览器智能体,跑一次任务要花掉 36 美元以上,还要等二十多分钟。优化之后,同样一件事,0.47 美元,4 分钟出结果。成本掉到七十六分之一,时间掉到五分之一多一点。
这是 OpenAI 在 2026-10-09 放出的官方客户案例,主角是 Asana 收购来的 StackAI 平台里的浏览器智能体。客户不用写代码,就能在里面搭一条“打开网站、填表单、把信息抓回来”的自动化流程。主导这次优化的是 StackAI 的 CTO Frank Hidalgo 博士,而真正干活的那位——把代码库读完、把假设试完、把结果对比完——是跑在 Codex 里的 GPT-6 Astra。Hidalgo 自己的估算是:这套调研加试错,人工要做一到两个月,实际用了一周。他的原话是:“我睡前给它设一个 /goal,早上起来看结果。”
76 倍这个数字当天被全行业转了又转。它看起来像一个模型发布会的标题:换了个更聪明的模型,账单立刻腰斩再腰斩。但把这份案例的数据拆开,故事完全是另一个走向。七十六倍里,真正来自“换模型”的只有大约 2.6 倍。剩下那 29 倍,全部来自工程改造——怎么排布请求,怎么剪枝截图,怎么给历史留预算。
这不是修辞上的拆分,是案例里明明白白列出来的两段。
拆开这 76 倍
先把结果链原样摆出来。
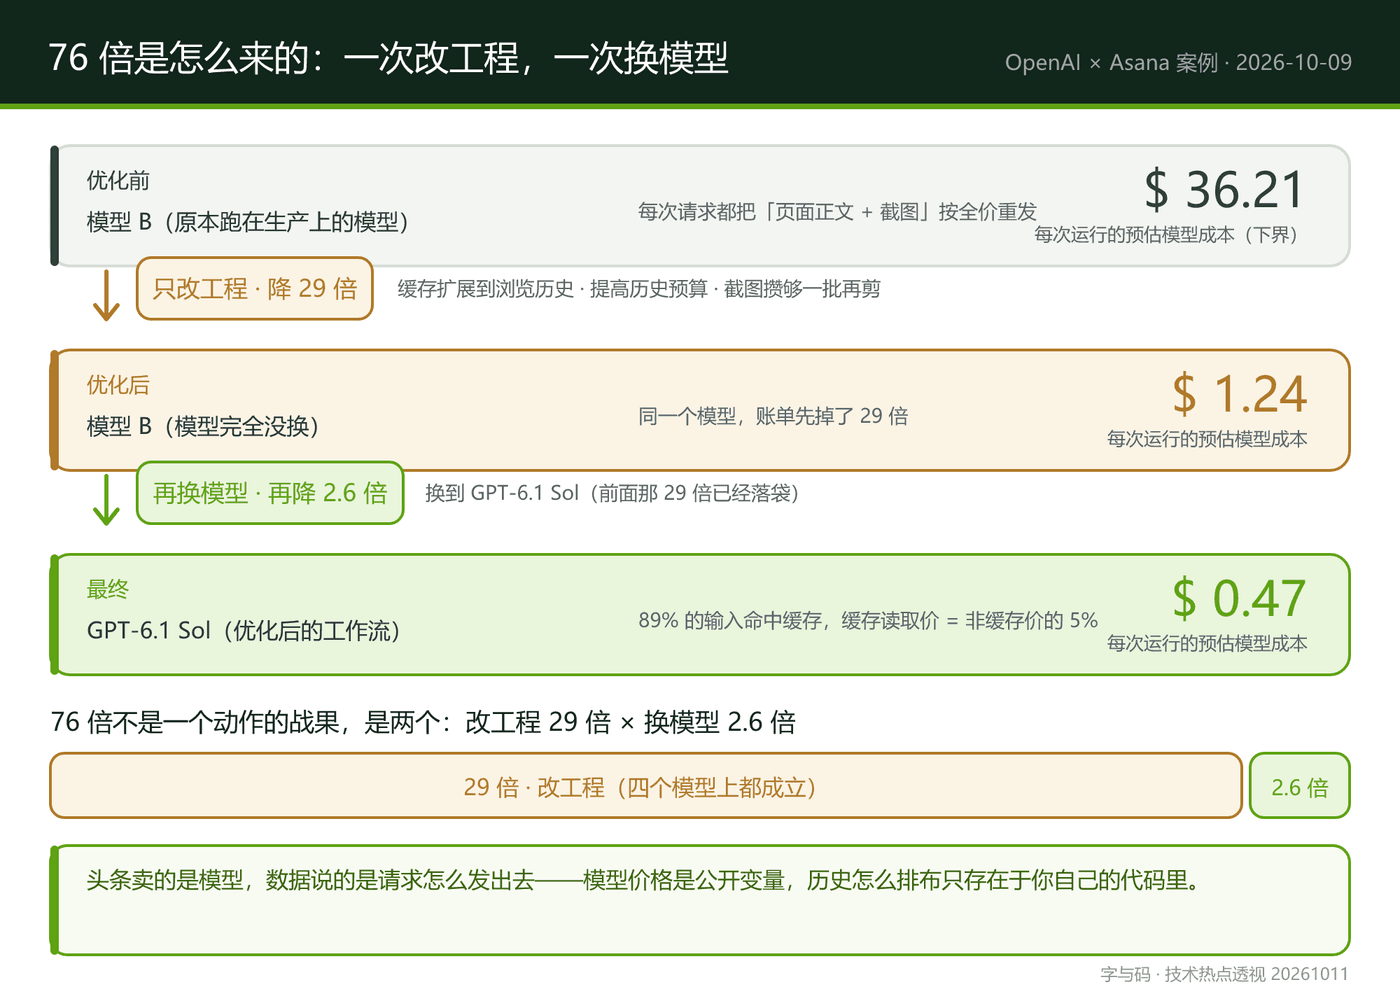
生产上原本跑的是模型 B(2026 年夏发布,价格与 Sol 相同)。在 B 上,什么都不换,只做工程改造,单次成本从至少 36.21 美元降到 1.24 美元,降了 29 倍;运行时间从最少 22.5 分钟压到约 4 分钟。同样这套优化流程,把模型换成 OpenAI 的 GPT-6.1 Sol,成本再降 2.6 倍,落到 0.47 美元一次——这就是标题里的 76 倍。
再单独看 Sol 自己:优化前 1.97 美元一次,优化后 0.47 美元,降 4 倍。原因是优化后 89% 的输入来自 prompt cache,而缓存读取价只有非缓存输入价的 5%,于是每次调用便宜了大约 3 倍。
而那个“原本用于生产”的模型 B,优化后是 1.24 美元;如果换成同一家前沿实验室的更新版模型 C,是 0.66 美元一次、3.5 分钟——比 Sol 的 4.0 分钟还快一点。模型 A 是 2025 年秋发布的小模型,价格只有 Sol 的一半。
把这些数字按“换模型”和“改工程”两个轴摆开,结论就藏不住了:76 倍里 2.6 倍是模型,29 倍是请求组装方式。头条卖的是模型,数据说的是请求怎么发出去。
这里的错位值得多看一眼。模型价格是一个公开、透明、写在价目表上的变量,任何人打开网页就能比价;而历史怎么排布、缓存能不能命中,是一个只存在于你自己代码里的变量,没人替你做基准测试。于是行业叙事自然滑向更容易讲的那一半:又便宜了,因为模型又变强了。但这份案例里,真正把账单按到地上的动作,和模型的智商没有关系。
还有一层更隐蔽的代价。换模型是一次性决策,改工程也是一次性投入,可两者的收益结构完全不同。换模型省下的是这个月的账单,下个月模型一降价、一换代,你之前搭好的比较基准就作废了。改工程省下的是每一年的账单,而且它跟模型解耦——案例里那 29 倍,在四个模型上都成立。所以更合理的顺序是:先量缓存,再谈换模型。一个变量的收益会随市场漂移,另一个不会。
缓存最怕的,是“每走一步就整理一遍历史”
要理解那 29 倍从哪来,得先理解 prompt cache 到底缓存了什么。它缓存的不是“整段对话”,而是最长的那一段不变前缀:从请求开头开始,一路比对,直到第一个发生变化的 token 为止,之前的部分才能命中缓存、按 5% 的价格计价。一旦中间某处改了,后面全部作废,按全价重算。
这是一个前缀问题,不是一个内容问题。很多人把它当成“给上下文打个折”,于是得出一个非常自然的直觉:上下文越长越贵,那我每轮压缩一下、裁剪一下,不就把钱省下来了吗?
这个直觉在缓存时代是反的。
Hidalgo 诊断出的原始设计,正是这个直觉的产物。智能体缓存了固定指令和工具定义——这是 LLM API 的标准做法,人人都做。但它没有缓存那个不断增长的“页面正文 + 截图”历史,于是每次请求都把这份历史按全价重发一遍。更麻烦的是,它几乎每一步都在丢旧截图、裁正文。每一次这类编辑,都在改写历史的中段,把原本可能命中的前缀一刀切断。哪怕后来给历史加上了缓存,也救不回来——缓存只认最长的不变前缀,而你每一步都在动它。
换句话说,那个为了省 token 而做的每轮压缩,把能命中的缓存重新打回了全价。省下的是可见的 token,亏掉的是不可见的折扣。
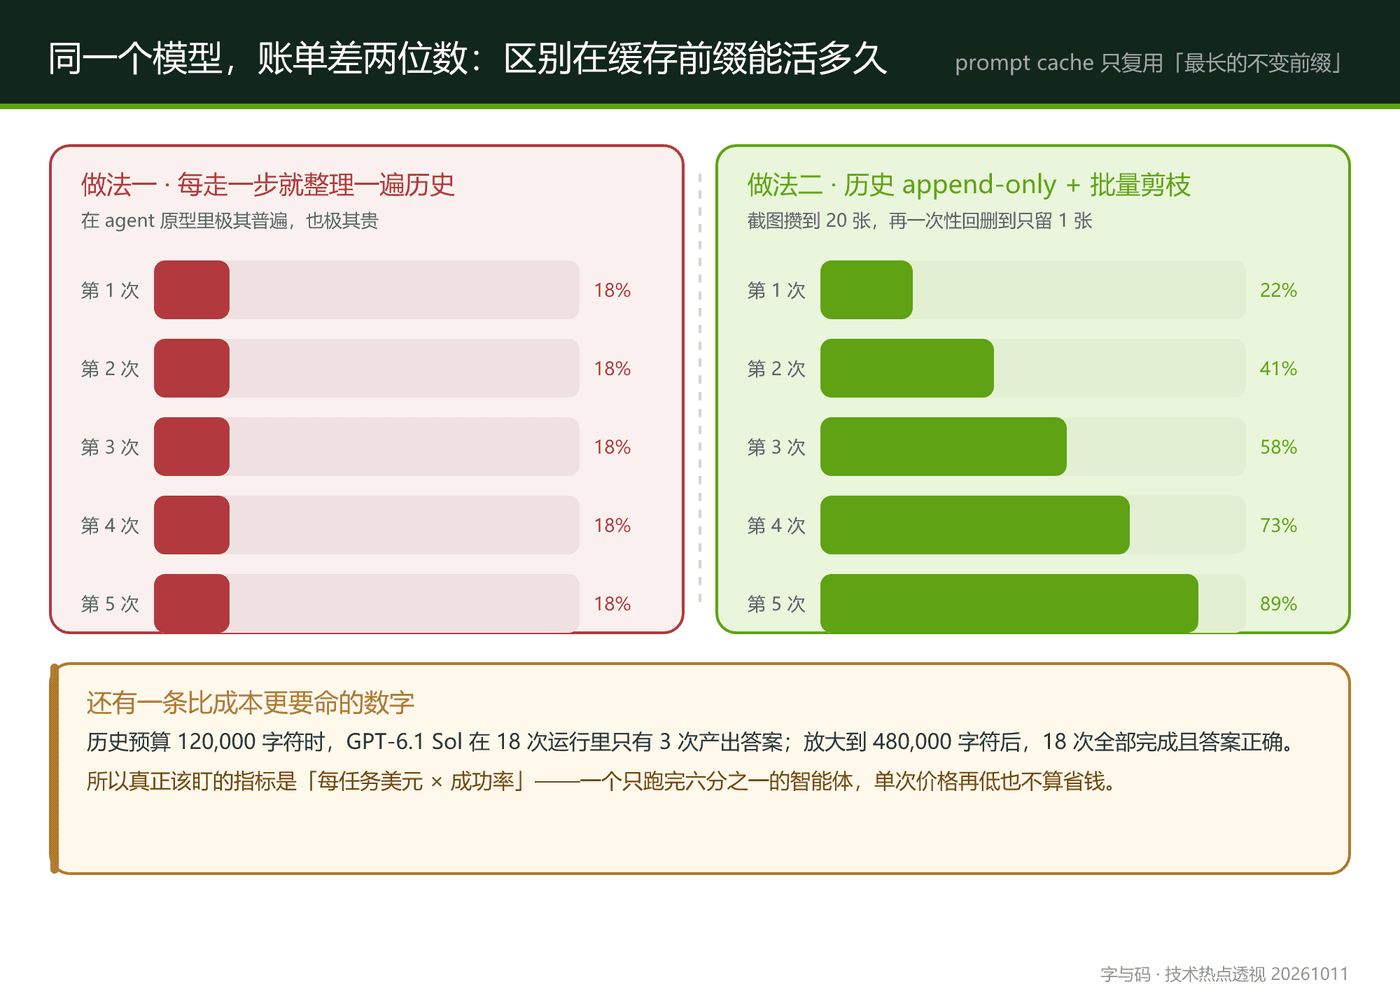
研究里最终有效的做法,是把剪枝从“每步一次”改成“攒够一批再一次”:让截图累积到 20 张,再一次性回删到只留最新 1 张。这样一来,两次删除之间,更早的那段历史保持不变,缓存得以生效。约 19 次连续调用复用同一份前缀,成本曲线就塌下来了。
伪代码大致是这样两种写法的对照:
# 读法一:每轮都“整理”历史——省 token,却每轮击穿缓存前缀
def build_request_naive(history, page_text, screenshot):
    history.append(UserMsg(page_text, screenshot))
    history = trim_text(history, max_chars=20_000)    # 每轮裁正文
    history = drop_old_screenshots(history, keep=1)   # 每轮删旧图
    return history

# 读法二:历史 append-only,剪枝攒够一批再做
def build_request_batched(history, page_text, screenshot,
                          shot_budget=20):
    history.append(UserMsg(page_text, screenshot))
    if count_screenshots(history) >= shot_budget:
        history = batch_prune(history, keep_screenshots=1)
    return history   # 两次剪枝之间前缀长期不变,缓存可复用
差别不在“省了多少 token”,而在“前缀能活多久”。第一版每一步都在重写历史,第二版把一条长长的稳定区间留给缓存。同一次任务、同一个模型,账单差出两位数。
这也是诊断顺序上的一次修正。大多数人遇到账单贵,第一反应是换个便宜模型,或者把上下文砍掉一半——两个动作都是在“单个请求”这一层动手。而真正的问题,是“这些请求彼此像不像”。两份请求越像,重复的那段越能白拿;越不像,每一份都要从头付全价。让请求彼此相似,比让单个请求变小,值钱得多。
这里还有一个容易被忽略的细节:代码原本根本不是为受控实验写的。Astra 先把它重构了,让一套前后端能并行跑多种配置。没有这一步,后面那 144 次运行(历史预算 120,000 与 480,000 字符 × 6 种缓存/截图策略 × 4 个模型 × 每组 3 次)无从谈起。任务也固定得很死:从公开演示目录里为 32 本书各采集 6 个字段,共 192 条事实,逐条对照参考答案打分。工程改造从来不只是“改个参数”,它先是让问题可测量。
更便宜但老出错的智能体,不算省钱
案例里最容易被人跳过、却最该被记住的,是那组可靠性数字。
历史预算设成 120,000 字符时,GPT-6.1 Sol 在 18 次运行里只有 3 次产出了答案。把预算放大到 480,000 字符,18 次全部完成,而且答案正确。优化后的流程里,每一次运行都完成了任务并返回正确答案。
3/18 对 18/18。这不是一个调优的细节,这是“能不能用”的分界。
一个只跑完六分之一的智能体,单次价格再低也没有意义——因为你得跑很多次才能等到一次成功,而失败那一次次白烧掉的时间、上游重试、人工介入,全都不是免费的。所以“每千 token 多少钱”是个会误导人的指标,它衡量的是最容易比较、却最不说明问题的那一维。真正该盯的是每任务美元乘以成功率。
换算口径其实很简单。假设 A 方案每次 0.47 美元、成功率接近 1,B 方案每次 0.20 美元、成功率只有六分之一。要看“拿到一个正确答案的平均花费”,就得把单次价格除以成功率:A 约 0.47 美元,B 约 1.2 美元,还要再乘上失败时白烧掉的时间。便宜的表价,贵的结果。
这个换算还有一层反向用法:当你发现某个配置的成功率只有三分之一,最快的成本优化不是压单价,而是先把它做到能跑完。案例里 Sol 从 1.97 美元降到 0.47 美元的那 4 倍,本质上是“让它稳定跑完”带来的副产品,不是靠精打细算抠出来的。
而且成功率在 agent 场景里不是线性的。它经常在某个阈值附近突然坍塌——历史预算不够,模型看不到关键页面,于是循环、重试、撞上步数上限。案例里的 120,000 对 480,000 就是这样一个阈值:不是“慢一点”,是“基本不成”。把上下文砍到勉强够用,省下来的钱会以失败率的形式加倍还回来。
同一天,所有人都在打同一张牌
把这一天前后几家的动作摆在一起看,会发现竞争维度正在集体迁移。
阿里 Qoder 在 10 月 10 日上线 Fast 档:首次响应约 3 秒,credit 倍率 0.8x;国际版直接替换掉原来的 Performance 档,首响从约 8 秒降到 3 秒,credit 从 1.1x 降到 0.8x,约便宜 27%。官方自测口径(未经第三方核实)说 Fast 大约是同类国内产品耗时的三分之一、海外产品的四分之一。它卖的不是模型更聪明,是更快、更便宜。
Google 停售了独立的付费产品 Gemini Code Assist,把用户导向 Antigravity;同时把企业 AI 收拢到统一入口的 Gemini Agent——云端跑数小时到数天、可派生子智能体、每个任务有硬性预算上限。
字节 TRAE 把 TraeWork 与 TraeCode 合并成统一的全链路开发平台,Agent 模式与 IDE 模式共用同一套工程上下文,切换不必重新导入项目。
OpenAI 同一批发的不止 Asana 一个案例:Sophos 用 Daybreak 把网络威胁调查时间缩短 96%、自动化了 52% 的 MDR 工单(人工分析师保留监督);LegalOn 把 Codex 的预估日均花费降 65%,做法是按任务匹配 GPT-6 Astra / Sol / Luna 三档模型,再加预算管理;Oracle 把 ChatGPT Work 与 Codex 铺到招聘、工程、运营。同期还上了 Codex 的“即时纠偏”——任务中途改方向,模型立刻响应,而不是先把当前思路跑完。
这几件事表面各干各的,底下是同一根轴:从“模型智商”转向“每任务美元”。Qoder 拿速度和 credit 说话,LegalOn 拿按任务匹配模型说话,Google 的 Gemini Agent 干脆把预算上限做成产品特性。再往下一层,争夺的其实是三样东西:入口——用户从哪进;上下文——工程状态怎么共享;预算闸门——钱在哪一层被卡住。谁把这三点捏在一起,谁就拿走长时任务的账单。
为什么是现在
因为 agent 的形态变了。
一次问答,请求数是个位数,上下文布局无所谓——反正总共就发几次,怎么排都差不多。但当一个 agent 变成跑几小时到几天的常驻进程,请求数从个位数跳到几百上千次,事情的性质就换了。Gemini Agent 明说云端跑数小时到数天,dots 那种常驻形态、Claude 的长任务模式,都在往同一个方向走。请求数一多,每一次的多发一点、每一次的少命中一点,都会被放大成账单上的主变量。
行业简报里有一句话概括得很准:新一批 agent 平台假设的是长时任务,于是工程回报转移到了状态、缓存与成本控制上。对长时运行的 agent 来说,现在“上下文的排布方式”比“选哪个模型”更决定账单。
Cloudflare 吞并 Deno 是这条判断最直白的注脚。Ryan Dahl 带着整个 Deno 团队加入,Deno 运行时再维护一年(之后核心开发停止,代码仍开源),Deno Deploy 六个月后关停,付费客户协助迁到 Cloudflare Workers,JSR 迁到 Cloudflare 基础设施。Cloudflare 自己说得很清楚,它要的奖品是“agent harness(智能体执行载体)的状态层”——Durable Objects,每个对象是一个可单独寻址的小服务器、内嵌 SQLite、单线程、自带 WebSocket。Dahl 的原话大意是:可扩展性应该内建在编程模型里,不该每个应用自己去拼基础设施。
翻译一下:巨头们押的不是“谁的模型更聪明”,而是“谁来托管 agent 的状态”。状态在哪里,缓存、预算、多日运行就在哪里,账单的定价权也就在哪里。这和 Asana 案例讲的是同一件事的两端:一端在产品形态,一端在账单结构。
五个必须打的折扣
不过必须给这一整串叙事打几个折扣,否则它会被用错。
其一,这是供应商案例研究,不是同行评审。没有第三方复现,图表里的部分柱子与标准差是从原图近似重建的。
其二,每个组合只跑 3 次。StackAI 自己承认,研究显示的是大趋势,不是细微差别。把 3 次运行之间的差异当结论,会得出过度精确的错误。
其三,“36.21 美元”是下界。基线里包含被步数上限截断的运行,真实的基线成本只会更高、不会更低。
其四,缓存不是免费午餐。不做批量剪枝时,“缓存更大的历史”在四个模型里有三个反而比不缓存更贵。缓存需要被设计,不是打开开关就有的红利。
其五,把 29 倍和 2.6 倍乘起来报成 76 倍这个口径,要拆开读。两段优化的性质不同:一段改工程,一段换模型;把它们乘在一起报一个数,读起来像一次改动的战果,实际是两次。
现在就可以做的五件事
把这套逻辑落回自己的代码,有五件事今天就能做。
-
把历史做成 append-only,剪枝改成批量的。别再每轮裁剪上下文。让消息只追加、不改写,把截图和长正文的删除攒成一批再一次做掉。判断标准是“前缀能连续存活多少次调用”,不是“这一轮省了多少 token”。
-
把缓存命中率当成一级监控指标。案例里优化后 89% 的输入来自缓存,这是成本下降的直接原因。你的 agent 现在命中率是多少?没人知道的话,就等于在摸黑调参。把它打到面板上,和 P99 延迟并排看。
-
换指标:从“token 单价”换成“每任务美元乘以成功率”。只比表价的选型,会系统性地偏向便宜但跑不完的方案。把成功率和单次成本乘在一起,你才会发现 120,000 字符那个配置根本不划算。
-
换模型之前,先量一遍自己的缓存命中率和历史预算曲线。Asana 的结果摆在那:先做完工程改造,29 倍已经在手,换模型只是再加 2.6 倍。顺序反了,你会先花力气去追更小的那一段,还误以为已经优化过了。
-
为长时任务设计预算闸门和可撤销性分级。不是所有动作都值得花钱,也不是所有动作都能回滚。给每个任务设硬性预算上限,把“只读、可重试”和“写入、不可撤销”的操作分开对待——便宜的那类可以多试几次,贵的那类必须先卡闸门。Google 把预算上限做进 Gemini Agent,不是产品点缀,是长时运行的默认姿态。
真正需要转变的是视角:成本问题的主要矛盾,从来不在价目表上。
其他动态
- Cloudflare 把整个 Deno 团队收了:Ryan Dahl 与 Bert Belder 带团队加入 Cloudflare,把 Deno 的 celld 项目与 Cloudflare 的 workerd 合并,目标是把 Workers + Durable Objects 这套编程模型做成自托管服务器的默认方式。代价写得也很具体:Deno 运行时再维护一年(每月 bug 与安全更新),之后官方停止开发、代码仍开源;Deno Deploy 六个月后关停,付费客户协助迁移到 Workers;JSR 继续运营但基础设施搬到 Cloudflare。Deno 官方与 Cloudflare 官方帖都没披露交易金额与结构。
- OpenAI DevDay 的常驻智能体 dots:每个 dot 配一台独立云电脑与专用浏览器,经 ChatGPT 插件接 4000 多款应用,可以驻进 Slack、Microsoft Teams,支持自定义规则(哪些动作要问、哪些可以自己做)和「自动复核」,改密码这类敏感操作明确保留在人侧。同期还发了人机协作空间 ChatGPT Space。多家报道为 10 月上旬,具体上线节奏以官方为准。
- OpenAI 的收入口径:向 Bloomberg 表示 9 月年化收入约 500 亿美元,预计年底达到 700 亿;GPT-6 与 Intelligent UI 已覆盖 Plus、Pro、Business、Enterprise 全部付费档。
- Google 收拢企业 AI 入口:停售独立的付费产品 Gemini Code Assist,把用户导向 Antigravity;统一的 Gemini Agent 在云端跑数小时到数天、可派生子智能体、每个任务带硬性预算上限。
- 字节 TRAE 双端合一:TraeWork 与 TraeCode 合并成统一的全链路开发平台,Agent 模式与 IDE 模式共用同一套工程上下文,切换不必重新导入项目。
- 阿里 Qoder 上线 Fast 档:首次响应约 3 秒、credit 倍率 0.8x;国际版直接替换掉原来的 Performance 档,首响从约 8 秒降到 3 秒、credit 从 1.1x 降到 0.8x。
- 微软研究院开源 Agent Lightning v1.0:约 3500 行,解决的是「训练环境里的 agent 和部署出去的 agent 不是同一个」这个老问题——它直接用真实部署形态训;在 SWE-bench Verified 上把 Qwen 从 41.8% 提到 56.4%,用了约 6000 条训练样本。
- 具身智能一天之内多笔融资:简智机器人(一年 7 轮、累计超 2 亿美元,百度与银河通用直接入股,做的是多模态数据采集与治理)、智身科技 B 轮(阿联酋产业资本领投,已跨 1.5 万台量产)、厘清智能(蚂蚁连续两轮领投,主打 Physical AI Infra)、本溯智能种子轮(五源领投,做动作原生具身基础模型)。同期 AWS 开源 Physical AI Toolchain,称设计借鉴了运营超 100 万台机器人的经验,NEURA Robotics、RLWRLD 是早期用户。
参考资料
- OpenAI 官方案例(英文):Asana cuts model costs 76x in browser tests with GPT-6.1 Sol
- OpenAI 官方案例(中文):Asana 借助 GPT-6.1 Sol,在浏览器测试中将模型成本降至原来的 1/76
- Rush Commerce 的拆解(“省下来的不是模型,是缓存”,含 29 倍与 2.6 倍的分解算法):Asana’s browser agent got 76x cheaper: the fix was caching
- METAL Lab 的完整数据链(含优化后模型 C 的 0.66 美元 / 3.5 分钟,以及“大部分差距来自修好历史管理”的结论):Asana cuts browser agent model costs 76x
- iMasters 报道(Hidalgo 原话、实验设计与「上下文修剪策略反过来破坏缓存」的定性):Asana Cuts Browsing Agent Cost by 76x With GPT-6.1 Sol
- iFeeling Daily(GPT-6 Astra 如何先重构代码、实验如何记录进 Command 并推到生产):Asana Uses GPT-6 Astra in Codex to Cut Browser Agent Costs by 76x
- AI Builders Digest(10/10;agent 成本、即时纠偏、训练框架三条线):AI Builders Digest — Saturday, October 10, 2026
- The AI Wire 日报(10/10;“agent 正在被像员工一样配置”,成本回报转向状态、缓存与成本控制):Daily AI Brief — Saturday, October 10, 2026
- my2cents(OpenAI 同日四个案例:Asana / Sophos / LegalOn / Oracle):OpenAI AI Updates: October 10, 2026
- AI Briefing(OpenAI 年化收入口径、GPT-6 覆盖档位、Sophos 与 Asana 案例):AI News Today — Daily AI Briefing
- AI Agents Directory 简报(10/10;Google 收拢企业 AI、700 家软件公司研究等):AI Agents News Brief: October 10, 2026
- Deno 官方公告(Ryan Dahl 逐条列出运行时、Deploy、JSR、rusty_v8 的去向):Deno is joining Cloudflare
- Cloudflare 官方博客(Kenton Varda 与 Dahl 的联合说明,celld 与 workerd 合并):Deno is joining Cloudflare
- SaaSCity 分析(为什么 Durable Objects 是 agent harness 的状态层,以及这轮开发者工具并购潮):Cloudflare Just Bought Deno — and Put a One-Year Clock on the Runtime
- Pandaily(Qoder Fast 档的自测口径、Striding AI 等具身进展):Pandaily — China Tech News, AI & EV Insights
- 今日头条 / IT168(字节 TRAE 双端合并为统一全链路开发平台):字节AI编程双端合一:全新TRAE整合Agent与IDE
- 网易 / 前沿在线(智身科技 B 轮与 1.5 万台量产):多类型资本押注B轮,智身科技15000台量产背后
- 今日头条 / 红星资本局(简智机器人一年 7 轮、累计超 2 亿美元,百度与银河通用入股):一年7轮融资,累计超2亿美元!百度、银河通用押注具身智能数据“卖铲人”
- 同花顺财经(厘清智能 Physical AI Infra 融资,蚂蚁连续两轮领投):蚂蚁集团领投厘清智能数亿元融资,Physical AI Infra赛道再获资本加码
- 商道创投网(本溯智能种子轮,五源资本领投):本溯智能·完成种子轮融资
微信公众号
欢迎关注「字与码」
如果这篇文章对你有用,也欢迎在微信里继续关注后续更新。
X / Twitter
关注 @ax2_zicode
更即时的技术观察、新文章提醒和一些短想法会发在 X 上。