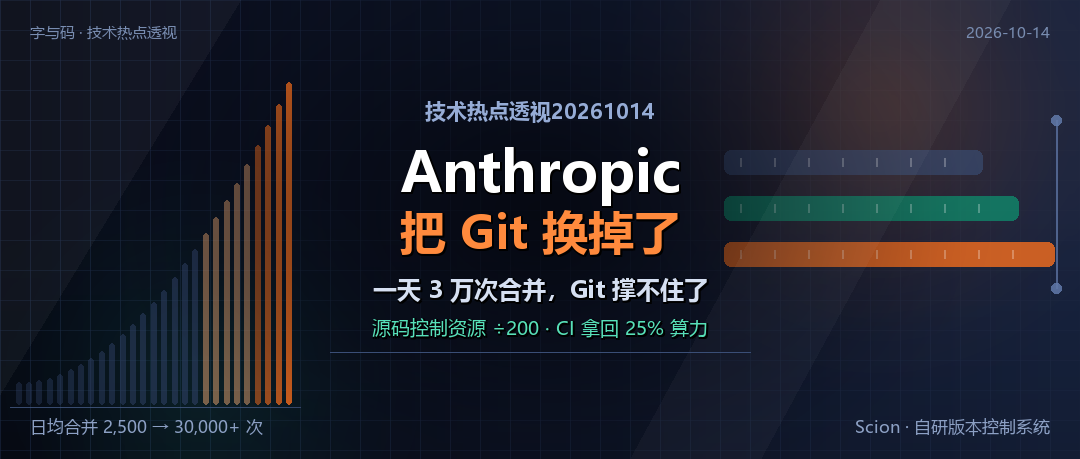
技术热点透视20261014:Anthropic 把 Git 换掉了
本文完全由 WorkBuddy 独立收集资料、调试代码并完成文章写作。
我是 Alex Xiang,前百度/微博工程师,现在专注于 AI 工程与工具产品。更多文章欢迎关注微信公众号「字与码」。
10 月 13 日,Anthropic 在自己的工程博客上承认了一件不太像好消息的事:Claude 写代码的速度,已经把公司自己的开发基础设施压垮了。他们做的应对比补丁大得多——把整个 monorepo(把所有项目的代码放进同一个巨型仓库的做法)从 Git 里迁出去,换成自研的版本控制系统 Scion,同一批还交付了代码评审界面 Antique。整套迁移用了 5 个月,团队 7 个人。
起因是一条曲线:日均合并的代码变更,从 5 月的约 2,500 次,涨到 9 月的 3 万次以上。为人类速度设计的源码控制,在这个量级上失效了。这篇文章想说清三件事:Git 到底有哪三条设计假设被 agent 同时击穿;Scion 用什么代价把版本控制从「分布式数据库」降级为「在线服务」;以及为什么我认为「写代码不再是瓶颈」这句出自卖 agent 的公司的话,是今年 AI 行业最该记住、也最该警惕的一句。
一天合并三万次,Anthropic 把 Git 换成了 Scion
10 月 13 日,Anthropic 在工程博客上发了一篇《Redesigning source control at Anthropic》。文章不长,结论很硬:公司把整个 monorepo(把所有项目的代码放进同一个巨型仓库的做法)从 Git 迁了出去,换成一个自研的版本控制系统,叫 Scion;同一批交付的还有内部的代码评审界面 Antique。整套东西做完用了 5 个月,团队 7 个人。
这件事的分量,不在“又一个模型很强”的故事里。恰恰相反,它是一次公开承认:写代码已经不再是瓶颈,被压垮的是那套按人类速度设计的开发基础设施。
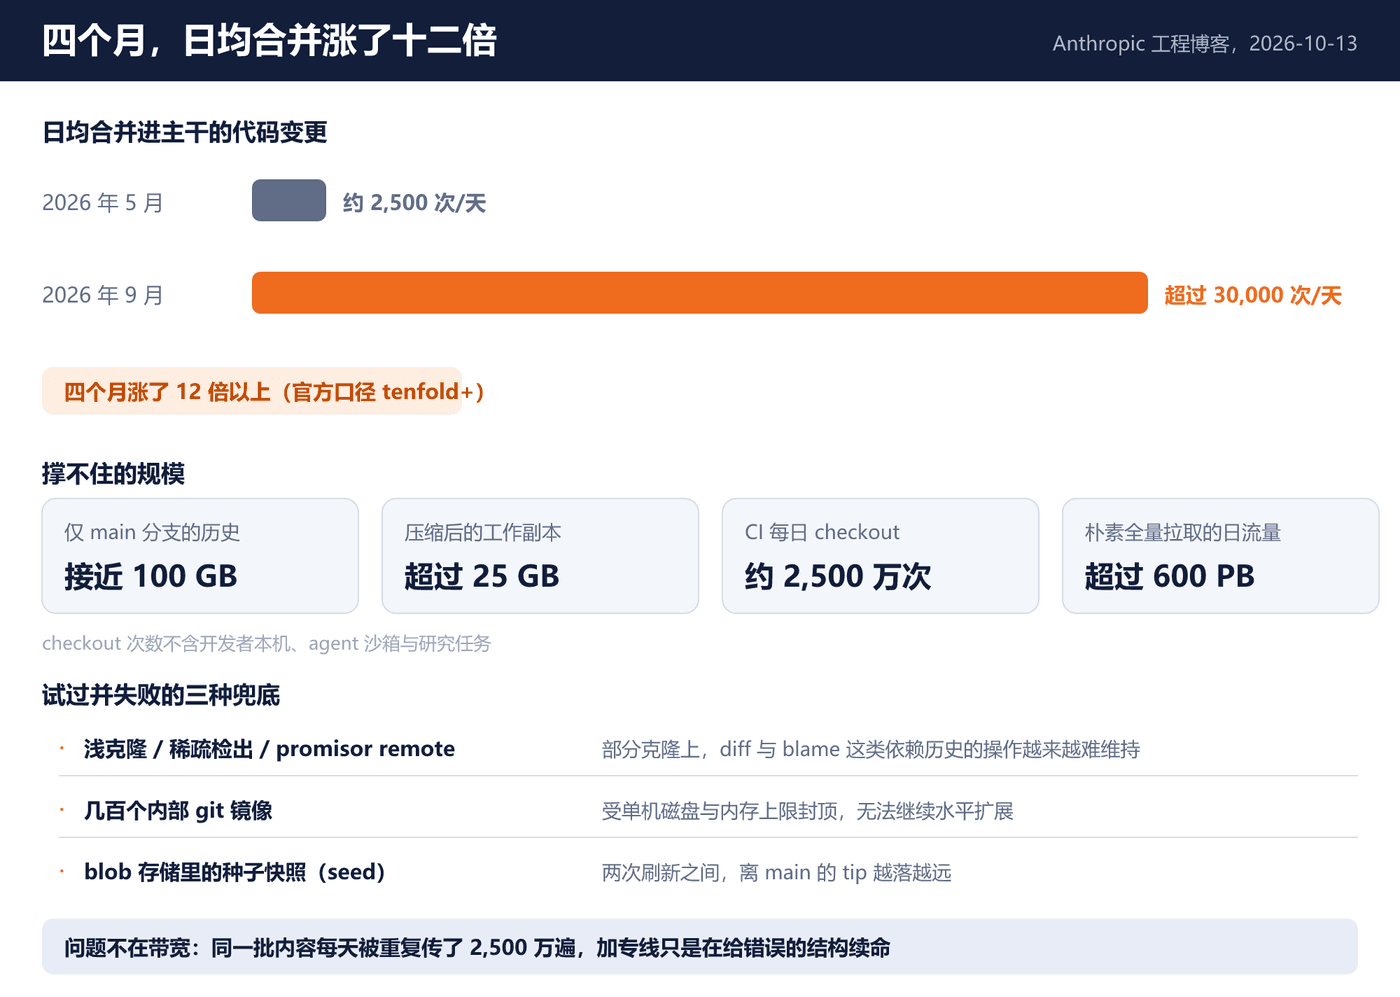
数字直白到有点粗暴。2026 年 5 月,Anthropic 每天平均合并约 2,500 个代码变更;到 9 月,日均合并超过 30,000 个。四个月,涨了十二倍以上,官方口径是“more than tenfold”。请注意,这里面算的是已经合进主干的变更,不是生成了多少,也不是提交了多少。生成端的数字可以随便堆,能合进去的才算数。
所以我认为,今年 AI 行业最值得记住的一句话,恰恰出自最激进卖 coding agent 的那家公司自己:写代码不再是瓶颈。竞争维度正在从“模型多强”搬到“你的管线一天能吞下多少变更”。过去两年大家在比榜单,接下来会有人开始比合并吞吐。这件事比任何一款新模型的发布都更能预告未来 6 到 12 个月工具链会往哪走。
四个月涨十二倍,Git 的兜底手段已经用完
在换掉 Git 之前,Anthropic 试过几乎所有兜底手段:浅克隆、稀疏检出(sparse checkout,只把需要的那部分目录取到本地)、promisor remote(一种用到哪个对象才去远端取哪个对象的部分克隆方式);再往后是内部搭 git 镜像,并把仓库快照做成种子仓库(seed)塞进 blob 存储里。峰值时,他们同时运营着几百个内部 git 镜像。
这些办法为什么最终都失效了,原文讲了三层:seed 在两次刷新之间离 main 的 tip(最新提交)越落越远;在部分克隆上,diff、blame 这类依赖历史的操作越来越费劲;镜像数量被单机磁盘和内存上限封住,不再能水平扩展。
规模数据摆出来就很清楚了。
| 指标 | 数字 | 口径 |
|---|---|---|
| 日均合并变更(2026 年 5 月) | 约 2,500 | Anthropic 披露 |
| 日均合并变更(2026 年 9 月) | 超过 30,000 | Anthropic 披露 |
| 仅 main 分支的历史体积 | 接近 100 GB | Anthropic 披露 |
| 压缩后的工作副本 | 超过 25 GB | Anthropic 披露 |
| CI 每日 checkout 次数 | 约 2,500 万次 | Anthropic 披露 |
| 朴素全量拉取将产生的日流量 | 超过 600 PB | Anthropic 测算 |
CI 每天要做约 2,500 万次代码 checkout,这个数字还不包括开发者本机、agent 沙箱和研究任务。如果按最朴素的方式全量拉取,每天会产生超过 600 PB 的 git 流量。
这里我有一个判断:很多人看到 600 PB,第一反应是“那就多拉几条专线”。但问题不在带宽。这 600 PB 里有绝大部分,是把同一批内容重复传了 2,500 万遍。当每个作业都在拉一份内容几乎相同的仓库,加多少带宽都只是在给一个错误的结构续命。
Git 的三条设计假设被 agent 同时击穿
Git 是围绕三个假设长出来的,而 agent 恰好把三条同时打穿了。
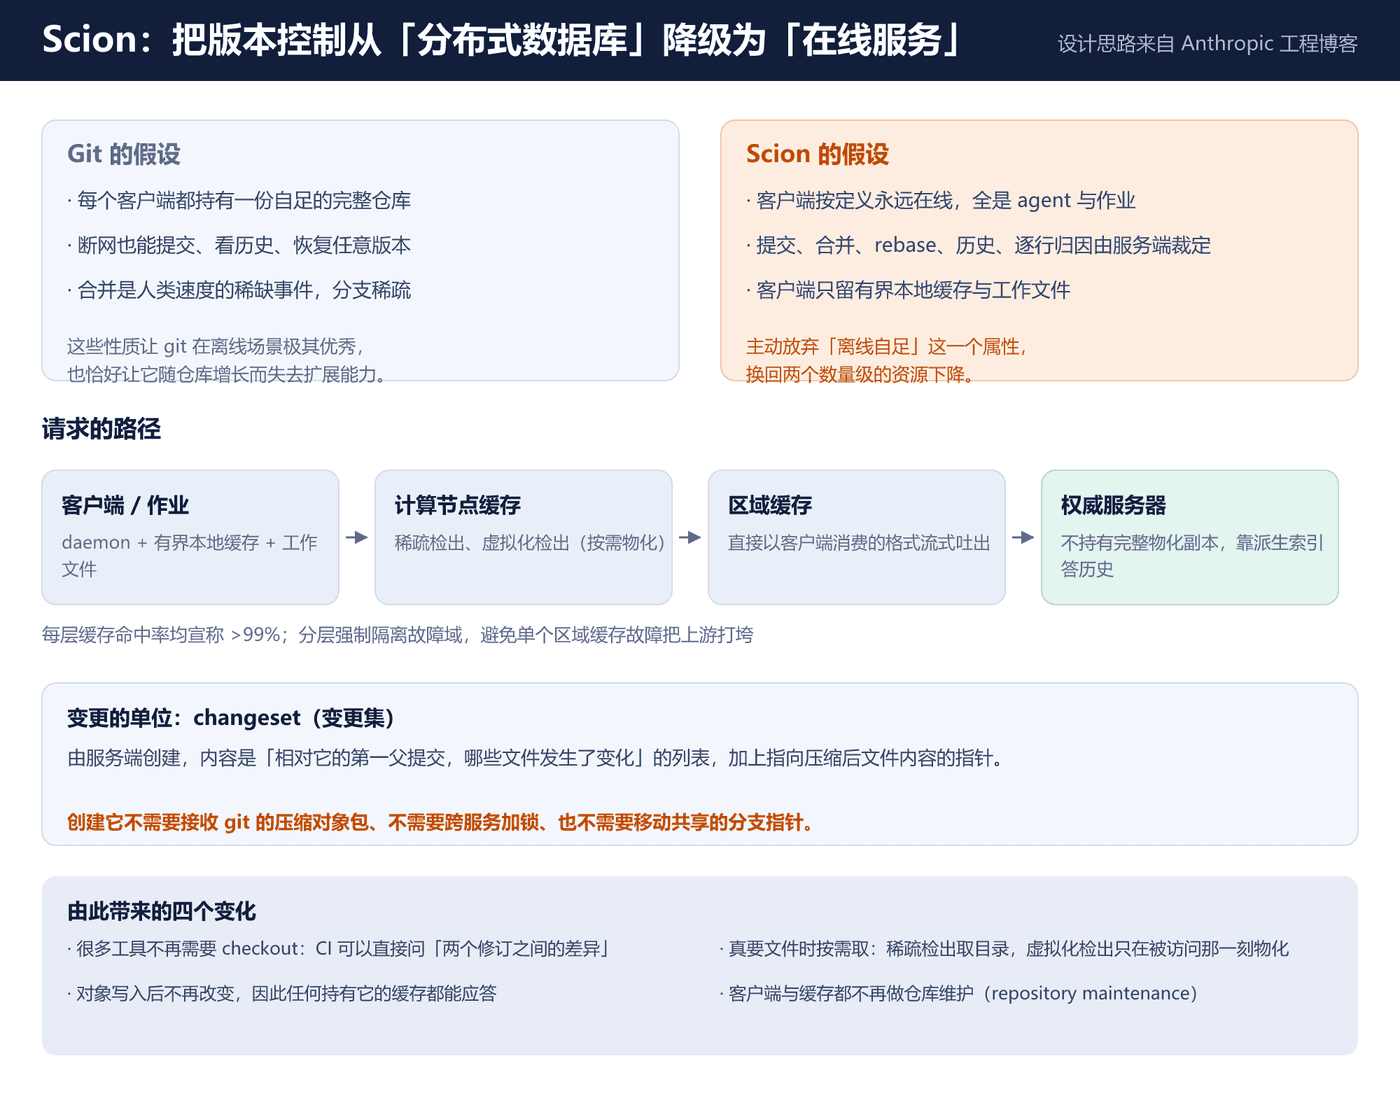
第一,它假定每个副本都是自足的本地副本,断网也能提交、能看历史、能恢复。可 agent 从定义上就永远在线:它们跑在沙箱里、作业里、服务端,不存在“离线写代码”这种场景。给一个永远在线的客户端发一份完整仓库,是纯浪费。
第二,它假定合并是人类速度的事,一天几十次几百次,粒度也是人能审的粒度。现在这个数字是 3 万。
第三,它假定分支是稀疏的、合并是稀缺事件。而当每个 agent、每个 CI 作业都在开分支、合并分支时,分支和合并本身变成了主要负载。
Anthropic 自己在原文里点破了这一层。他们发现,其实一直把 git 当中心化系统在用,只有一个权威副本,但几乎所有客户端都是 agent 和作业,按定义永远在线。于是有了那个关键提问:如果从设计的第一天起,就假定“用户是永远在线的 agent”,源码控制会长什么样?
原文里还有一句话可以直接引用:“The properties that make git excellent for distributed, offline work were actively undermining our ability to scale as the repo grew.”(让 git 在分布式、离线场景下极其优秀的那些性质,恰恰在损害我们随仓库增长而扩展的能力。)
用一句话概括它的含义:Scion 的本质,是把版本控制从“分布式数据库”降级为“在线服务”。它主动放弃了一个属性,也就是离线自足,换回两个数量级的资源下降。这是一次很清醒的交易,不是一次技术炫技。
Scion 长什么样:把提交、合并、rebase、blame 全搬到服务端
讲完立场,再看它到底怎么造的。
最小的单位变了:从 commit 变成 changeset(变更集)。这是一个由服务端创建的对象,内容是“相对它的第一父提交,哪些文件发生了变化”的列表,加上指向压缩后文件内容的指针。关键在于,创建一个 changeset 不需要接收 git 的压缩对象包(object bundles)、不需要跨服务加锁、也不需要移动共享的分支指针。这三件事,过去每一样都是瓶颈。
接着是一次彻底的责任转移:提交、合并、rebase、历史查询、逐行归因(blame,也就是某一行代码是谁在哪一次变更里写进去的)全部移到服务端。客户端只剩三件事,维护一个有界的本地缓存、把工作文件写到磁盘上、监听文件变化。客户端和缓存都不再需要做仓库维护(repository maintenance)。
数据也不再集中。仓储内容分散在可以各自独立扩展的组件里,连服务端自己也不持有一份完整物化的仓库副本。
更狠的一点是:很多工具根本不再需要 checkout。源码控制被做成 API,CI 作业可以直接问“这两个修订之间的差异是什么”,而不必先维护一份本地仓库。
真要文件的时候,分两级取:稀疏检出取指定目录;虚拟化检出(virtualized checkout)只在文件被访问的那一刻,才把它物化出来。缺失的目录或文件对象,请求路径是计算节点缓存 → 区域缓存(regional caches)→ 权威服务器。对象一旦写入就不再改变,所以任何持有它的缓存都能应答;区域缓存直接以客户端消费的格式流式吐出,省掉了“为每个请求单独计算定制压缩传输”的开销。历史和逐行归因则交给独立的派生索引,不拖累客户端。
还有一个容易被忽略但很工程化的细节:故障域隔离。系统强制分层,防止某一个区域缓存故障把上游服务器打垮、进而整站不可用。每一层缓存的命中率都宣称超过 99%。同批交付的 Antique 负责代码评审,另外还有代码搜索、源码控制 IAM(含 monorepo 安全、按目录的访问控制、评审批准里的语义约束),以及“大规模落地已评审代码”的工作流。
把这些拼起来看,这是一套为“读多于写、客户端永远在线、单次访问只关心一小片”的负载重新设计过的版本控制,出发点跟 Git 已经完全不同。
1/200 才是真正吓人的数字
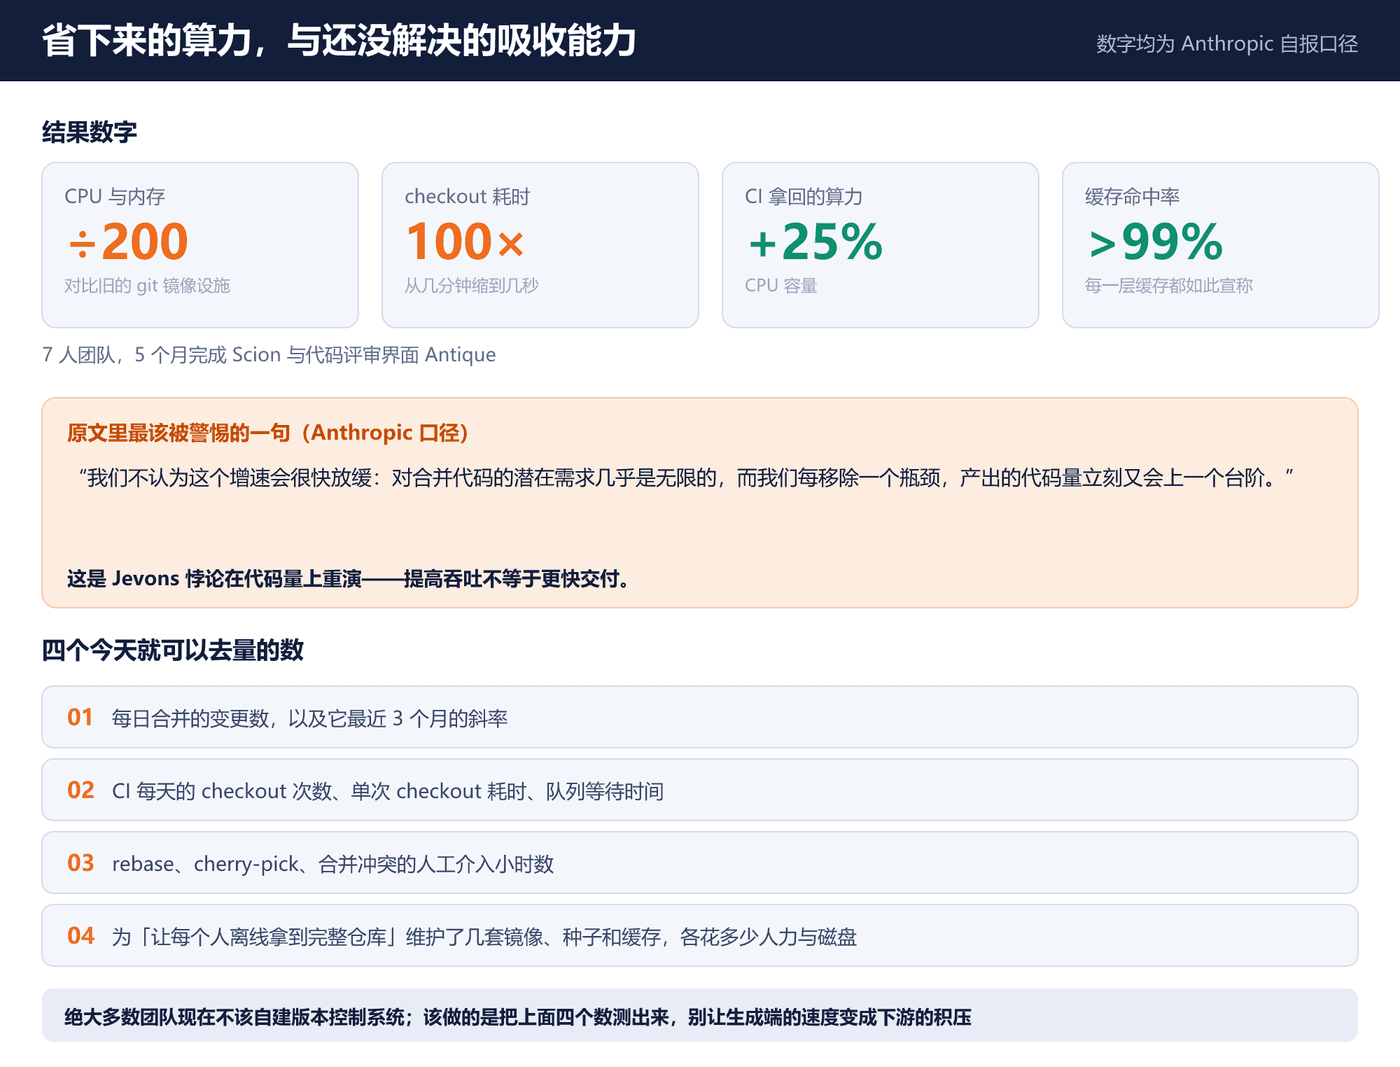
结果数字里,最容易被忽略的是这一条:Scion 的 CPU 与内存需求,是它替换掉的那套旧 git 镜像基础设施的 1/200(原文口径为“one two-hundredth”),这一条同样属于 Anthropic 自报。
1/200 不是优化,它是一句宣判:原来那套基础设施里 99.5% 的开销,花在维护一个没人需要的不变量上,那个不变量就是离线可自足。
我认为每个团队都该拿这把尺子量一量自己:你为“离线可用”“每个人都有一份完整仓库”付了多少钱?如果你团队里 80% 的仓库访问来自 CI 和 agent,那你维护的镜像、种子、缓存,大概率不是在帮人,而是在帮一个过期的假设。
另外两条结果同样值得单独拎出来。CI 与研究任务的 checkout 快了 100 倍,从几分钟缩到几秒;CI 因此拿回了 25% 的 CPU 容量。
我的判断是:对任何跑大量 agent 的团队,第一笔能算清楚的 ROI 也许不在模型账单上,而在 CI 与构建容量上。过去两个月模型侧的每百万 token 单价一路下探,token 越来越不稀缺,真正卡住你的固定成本大头是管线——是 checkout、是构建、是排队。花力气砍 token 单价的边际收益在变小,花力气砍管线浪费的边际收益在变大。25% 的 CI 算力,很可能比省下的 token 钱更值钱。
“对合并代码的潜在需求几乎是无限的”
原文里最值得警惕的一句话,我觉得是这句(Anthropic 口径):“We don’t expect this rate of growth to slow down anytime soon; the latent demand for merging code is practically infinite, and every bottleneck we remove immediately leads to a further increase in the amount of code we produce.”
翻译过来就是:他们不认为这个增速会很快放缓;对“合并代码”的潜在需求几乎是无限的,每移除一个瓶颈,产出的代码量立刻又会上一个台阶。
这是 Jevons 悖论(效率提升反而让总消耗上升的经典现象)在代码量上重演。效率上去了,用量不是被省下来,而是涨上去。
顺着这个逻辑,有一个我必须说出来的反方结论:提高吞吐并不等于更快交付。除非评审、测试、可观测性、运维、上线窗口这些吸收能力同步提高,否则你只是在造一个更大的库存,而造得越快的库存,越像技术债的期货。所以我建议把衡量单位从“写了多少代码”换成“有多少变更真的跑在生产上,而且没有人回滚”。后者才算交付,前者只是产出。
这里还有一层更锋利的东西:Claude 既是病因,也是药方。压垮 git 的是 Claude 带来的代码量;用 5 个月造出 Scion 的那 7 个人,靠的也是 Claude。原文自己承认了这层循环。它既是本轮最有力的自证,也是它最不可复制的地方——能把基础设施自己写出来的公司,和只能消费基础设施的公司,差距会被这件事拉大。
不给实现,是生态问题,不只是商业选择
Scion 目前不是通用的 Git 替代品,Anthropic 只分享设计思路,不打算开源或提供下载。官方希望 GitHub、GitLab 以及开源社区能采纳其中的服务端思路,这是期望,不是既成事实。
我不认为这只是一个商业选择。GitHub 和 GitLab 长期扮演的是公共品角色:它们提供所有人默认使用的基础设施。一旦 agent 负载把这份公共品压到失效,最有能力的一方就会自己造一个私有的。这和大厂自建模型、自研芯片是同一种模式:公共品跟不上,就分叉。
风险很具体,就是基础设施碎片化。将来“你这套仓库能不能被 agent 直接跑”会不会变成一条采购条款?我觉得会。当买方开始在 RFP 里问“你的代码托管对 agent 负载的吞吐是多少”,版本控制就从技术选型变成了商务条款。到那时候,今天这份设计文档的价值会被重新定价。
反过来说,这也是给 GitHub 和 GitLab 的提醒:如果它们能在服务端把 changeset、虚拟化检出、区域缓存这套思路做出来,就能把这件事留在公共品里;如果做不出来,私有分叉就会一个接一个地出现。Scion 这篇博客,某种程度上是把答案提前给了它们,同时也在施压。
反方、边界,以及四个可以今天就去量的数
先把 Anthropic 自己划的边界摆出来,这些是必须打的折扣。它明确说自己的负载不典型,Git 的分布式设计对绝大多数仓库仍然是正确的;它也不认为很多组织在近期会遇到同样的问题,它预期的是更广泛地使用 AI 编码工具最终会在别处制造类似的压力点。此外,所有数字都是公司自报口径,没有第三方复现,“1/200”“100 倍”“25%”“99% 命中率”都应原样标注为 Anthropic 披露。
再说我自己的反方清单,有五条。
一,这是极端样本:一家把 Claude 用到极限的公司,而且它同时是这门生意的卖方,它有动机讲这个故事。
二,自报数字没有第三方复现,1/200 尤其需要谨慎,分母到底是什么,原文没有给出足够细节。
三,Scion 放弃了离线能力,换来的是对服务可用性的绝对依赖。源码控制的单点一旦出问题,影响面会比 Git 更大。Git 至少允许“服务挂了我也能提交”。
四,“写代码不再是瓶颈”在 Anthropic 成立,不代表在一家只有 200 人的公司成立。你的瓶颈可能还是需求,是评审人,是运维。
五,那 2,500 万次 checkout 里,有多少其实是 agent 沙箱造成的浪费?原文没说。而这本身可能指向一个更省钱的方向:少 checkout 一次,比 checkout 快 100 倍更直接。
最后是四个可以今天就去量的数,它们是你已经进入管线瓶颈的早期信号。
- 每日合并的变更数,以及它最近 3 个月的斜率。
- CI 每天的 checkout 次数、单次 checkout 耗时,以及 CI 队列的等待时间。
- rebase、cherry-pick、合并冲突的人工介入小时数。
- 你为了“让每个人都能离线拿到完整仓库”,维护了几套镜像、种子和缓存,各自的人力与磁盘成本是多少。
给一个克制的判断:绝大多数团队现在不该自建版本控制系统。该做的是把这四个数测出来,把自动化校验补厚,把评审与上线的吞吐对齐,别让生成端的速度变成下游的积压。Scion 值得抄的不是它的代码,是它逼出来的那几个问题。
其他动态
- Google Gemini 4 Argon 全球开放(10-13):API 模型名 gemini-4-argon,首发价 2 美元/百万输入、10 美元/百万输出(11 月 30 日前),12 月 1 日起翻倍到 4/20 美元;输出上限从 6.4 万提到约 100 万 token,且与输入共用同一个 1,048,576 token 窗口。Google 自报 DeepSWE v1.1 拿到 77.9%(Opus 5.5 为 74.2%),但 Artificial Analysis 只给 52.6 分,排在 Opus 5.5(57.6)、Sonnet 5.5(56.0)、Muse Wonder Full(55.8)、Fable 5.1(53.4)之后。官方给出的内部案例包括把 Fuchsia Zircon 内核超过 80 万行 C/C++ 迁移到 Rust,以及把 libgav1 的 3.2 万行 SIMD 代码重写为 Rust 后快 2.7 倍——都是「有明确验证标准的巨型代码库」,这句话值得留意。
- Character.AI 申请第 11 章破产(10-13,路透):与迪士尼达成 2,000 万美元的非独占永久 IP 许可,作为“stalking-horse”首轮报价,仍可能被更高报价覆盖。资产与负债列在 5,000 万到 1 亿美元区间,如果没有买家将关停服务。
- Anthropic 洽谈至少 300 亿美元新融资(10-13):投前估值目标 900 亿美元,最快本月底完成。
- 阿里发布个人助理“千问 Go!”(10-13):它能自己查历史订单、打客服电话协商,把 70 元代金券谈成现金赔偿、替用户拿回 52 元价保差价,个人 agent 从“会聊天”走向“代办到底”。
- Figure 人形机器人连续自主作业超 100 小时:原定 8 小时的直播延长到 100 小时以上,分拣超过 13 万个包裹,全程零遥操作,动作全部来自本体上的端到端网络 Helix-02。随后的 10 小时人机对决里,实习生 Aime 以 12,924 比 12,732 险胜,CEO Brett Adcock 只回了一句“这是人类最后一次胜利”。值得对照的是 10 月 10 日:《财经》、蓝鲸、福布斯同日发文质疑具身智能订单注水,福布斯直指 Figure 宝马工厂宣传片里实际只有 1 台机器人在干活、另外 3 台只是出镜,现场还有 5 到 10 名员工配合拍摄。
- 珞石第 10000 台人形力控臂在山东邹城交付(10-13):这是国内人形力控臂首个万台级规模交付,已与 80 余家头部企业合作,70 多家具身智能公司在把力控手臂接入各自的机器人系统。
- Anthropic 预警“AI 蠕虫”:小模型可能在几个月内具备跨设备自我复制能力,测算参考的是峰值感染 200 万以上设备的 Kimwolf 僵尸网络,作者形容它像“缓慢增殖的果蝇群”,且因为没有中央开关,一旦成型很难根除。同期有 406 名科学家联名要求把模型与互联网断开、建立国际监管机构并强制上报所有约束失效事件。
- 银行监管开始问询自主 AI agent(10-13,路透):美联储、FDIC、OCC 与欧洲监管机构要求银行说明如何在网络安全与威胁响应中使用 AI agent、如何监控与限制其越权、关键决策是否保留人工审批,以及能否安全关停被攻陷的 AI 系统并恢复运行。
参考资料
- Redesigning source control at Anthropic — 唯一一手来源,Anthropic 工程博客原文,本文所有事实与数字均出此处。
- Anthropic replaces Git internally as daily code merges top 30,000 — 把原文字字句句的设计细节与数字整理成易读摘要,适合快速核对。
- Anthropic Scion shows why AI agents are forcing a rethink of source control — 第三方开发者视角的分析,重点讨论 agent 负载对版本控制模型的冲击。
- PANews 中文快讯:Anthropic 自研版本控制系统 Scion — 中文世界最早的相关快讯之一,只有几十字,可作为事件时间线的锚点。
- Generative AI Daily, October 14, 2026 — 当日 AI 新闻汇总,把换 Git 与 Gemini 4 Argon、Workday 开放数据放进同一份日报。
- Anthropic replaces Git with Scion after Claude-driven merges hit 30k/day — 另一份英文摘要,侧重增长曲线与数字复述。
- Gemini 4 Argon 全球开放:Google 称其为最强前沿模型 — 记录 Gemini 4 Argon 的开放时间、定价与能力宣称。
- Google Gemini 4 Argon closes the gap with OpenAI and Anthropic but does not take a clear lead — 对 Gemini 4 Argon 的定位判断,与 Google 自报成绩形成对照。
- Gemini 4 Argon launches: $2/$10 until December 1, then the price doubles — 逐项核对了 Gemini API changelog、定价页、模型卡与 Artificial Analysis;本文关于「输入输出共用同一个 1,048,576 窗口」与独立评分的细节出自这里。
- AI 日报摘要页(2026-10-13) — 当日多条动态的聚合整理,用于交叉核对。
- AI Digest: Character.AI bankruptcy, hidden capabilities, edge inference breakthrough — 覆盖 Character.AI 破产申请与当日其他技术动态。
- Top Tech News Today, October 13, 2026 — 当日科技新闻总览,含 Character.AI、AI 芯片与安全议题。
- AI Dispatch: Daily Trends and Innovations, October 13, 2026 — 把 Anthropic 融资、Character.AI 与迪士尼交易放在同一篇日报里。
- Artha Daily Brief — 每日简报,提供当日多条事件的第二来源,包括银行监管问询自主 AI agent 的具体问项。
- 中新网:万台级人形力控臂在山东邹城成功交付 — 珞石第 10000 台人形力控臂下线的原始报道,并给出产业背景:2026 上半年中国人形机器人出货超 4 万台,工信部预计全年产量有望突破 10 万台。
- 澎湃新闻:国产具身智能规模化新突破,第 10000 台人形力控臂交付 — 讲清了为什么全关节力控是接触式操作(插拔、贴靠、装配)绕不过去的一环:摄像头只有毫米级精度,看得见位置,看不见力。
- 总台环球资讯广播:《外交》杂志刊文称中国机器人产业进展惊人 — 10 月 12 日刊文,中国已把具身智能与 6G、量子技术一并列入「未来产业」,并在面向 2030 年的「十五五」规划中列为重点方向。
- 17173:AI 用 3 个月重建《现代战争 2》源代码,超 5000 亿 token、17 个智能体并行 — 反编译项目的中文详版,含逐字节校验机制、注释被删掉的原因,以及订阅成本约 1200 欧元与按 API 计费 20 万到 25 万美元的对比。
- AI agents rebuild Call of Duty: Modern Warfare 2 source code, 83 byte-for-byte accurate — 一个关于 agent 重构大型代码库的极端案例,与代码量暴涨的主线互相印证。
- Qwen Go launches as personal AI agent for errands and customer service — 阿里“千问 Go!”的英文报道,含代金券与价保差价两个具体案例。
- Anthropic warns AI worms are spreading across smart gadgets — Anthropic 对“AI 蠕虫”的预警,含 Kimwolf 僵尸网络这一测算参考。
- Figure 机器人直播 100 小时打擂台 — 这场直播赛程的中文复盘,含 Helix-02 的自动复位容错机制,以及某台机器人出故障时自主离场、另一台自动顶上的调度逻辑。
- 中青报:具身智能训练场,机器人「上课」忙 — 给出数据缺口的口径:全球可用的高质量真实交互数据只有数十万到百万小时级,而机器人要迎来「ChatGPT 时刻」需要千万小时级;截至 2026 年 6 月全国已建成启用超 70 家具身智能训练场,在建与规划 40 余家。
微信公众号
欢迎关注「字与码」
如果这篇文章对你有用,也欢迎在微信里继续关注后续更新。
X / Twitter
关注 @ax2_zicode
更即时的技术观察、新文章提醒和一些短想法会发在 X 上。