在本地开发机上安装可用的开源模型:先选对运行方式
这是一篇持续更新的本地开源模型安装记录。从一台 64GB 内存、WSL 分配 32GB、RTX 4060 Laptop 8GB 显存的 Windows + Ubuntu 26.04 LTS 开发机出发,先判断 Ollama 应该跑在 Windows 还是 WSL,再比较 llama.cpp、LM Studio、vLLM 等方案,最后整理适合本机长期使用的模型清单。
第 13 页。归档页按时间倒序展示,每页只加载一组文章封面,减少首屏压力。
这是一篇持续更新的本地开源模型安装记录。从一台 64GB 内存、WSL 分配 32GB、RTX 4060 Laptop 8GB 显存的 Windows + Ubuntu 26.04 LTS 开发机出发,先判断 Ollama 应该跑在 Windows 还是 WSL,再比较 llama.cpp、LM Studio、vLLM 等方案,最后整理适合本机长期使用的模型清单。
从吴恩达关于小团队和高上下文工程师的判断说起,聊聊为什么 AI 会把资深开发者推向真正的产品全栈:需求、原型、代码、文案、合规、上线和运营都要能先跑一遍。
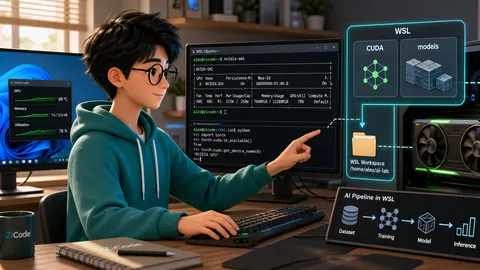
从一台带 NVIDIA 显卡的 Windows 开发机出发,讲清楚 WSL 里验证 CUDA、跑 PyTorch、部署本地模型、管理模型缓存和排查 GPU 没被用上的方法。
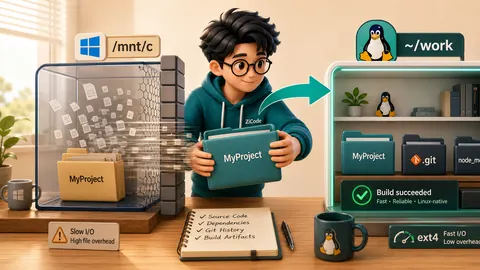
用一次真实的项目迁移做主线:把放在 Windows 分区的混合 Python/Node 仓库搬进 WSL 的 Linux 文件系统,重新梳理文件、路径、进程互调和性能边界。
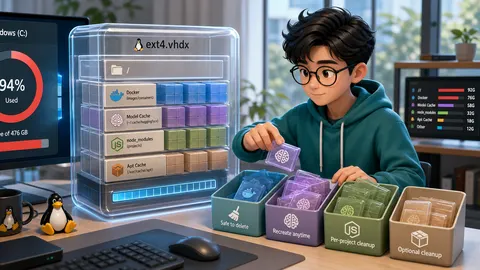
从一次 C 盘爆满开始,拆解 WSL2 的 ext4.vhdx 为什么只涨不降,如何定位 Docker、node_modules、模型缓存和包缓存,并给出安全清理与压缩流程。
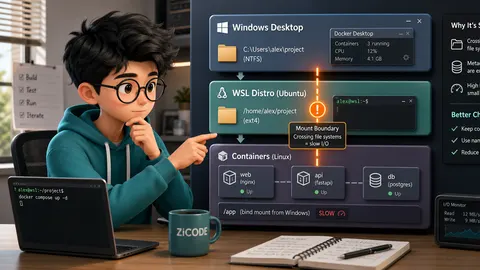
用一个本地 API 服务的排障过程讲清楚 Docker Desktop WSL 后端、bind mount、named volume、热更新、日志和磁盘空间治理。
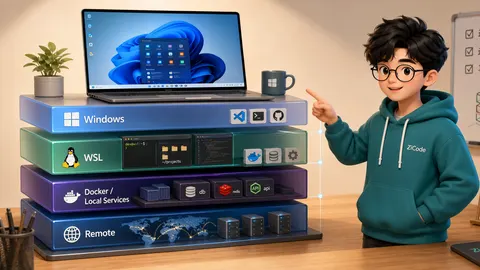
从一次团队开发环境迁移说起,解释 WSL1、WSL2、发行版、VHDX、Windows 集成、systemd、网络和文件系统的边界,帮你判断什么工作适合放进 WSL。
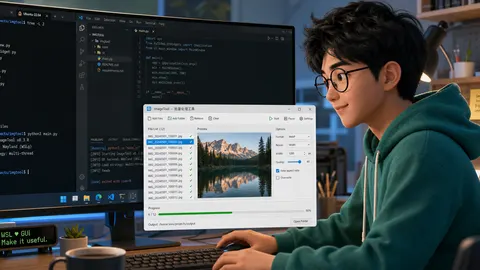
用一个图片批处理小工具贯穿全文,讲清楚 WSLg 下开发 Qt/GTK/OpenCV GUI 的环境、调试、文件边界、打包取舍和团队使用方式。
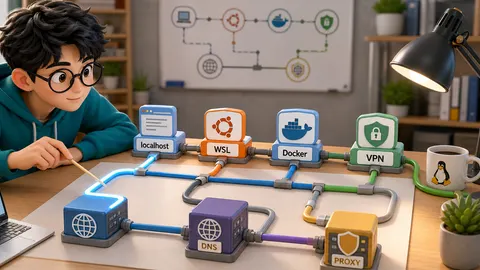
用一个本地 API 服务访问失败的案例,系统梳理 WSL NAT、mirrored networking、DNS tunneling、autoProxy、Windows 防火墙和 Docker 端口映射。
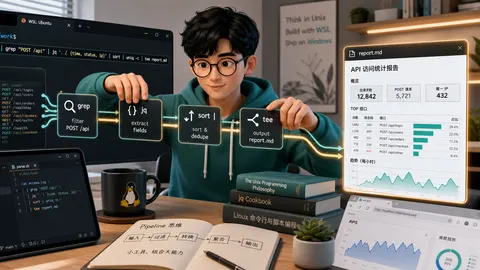
用一个排查线上日志和批量整理文件的真实流程,讲清楚如何在 WSL 里把 rg、jq、awk、fzf、make、cron/systemd timer 和 Windows 工具连成稳定工作流。
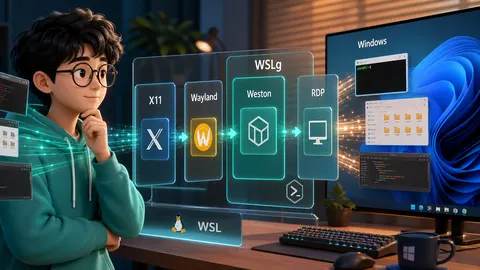
从 xeyes、gedit 和一个远程窗口的例子讲起,拆开 X11、Wayland、XWayland、Weston 和 RDP 在 WSLg 里的分工,顺便解释为什么旧教程里的 DISPLAY 配置现在经常是反效果。
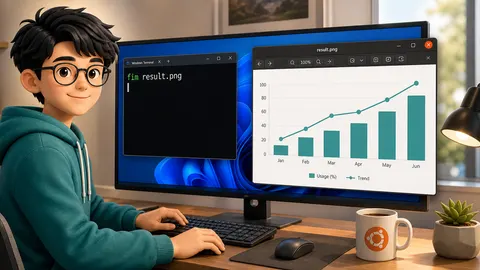
从一条 fim image.png 命令说起,拆一下 WSLg 为什么能把 Linux 图形程序直接显示到 Windows 桌面,以及它在图片预览、图像开发、X11 小工具里的日常用法。
一次在测试机上对 gemma4:12b 音频输入能力的实测记录:模型元数据声明支持 audio,但 Ollama 原生 /api/chat 不能可靠接收音频;真正可用的是 OpenAI 兼容接口里的 input_audio。
一次从官方资料到本地实测的记录:Gemma 4 12B 具备帧序列视频理解能力,但 Ollama 当前不能直接接收 MP4,稳定做法是先抽帧再多图输入。
A/B test 不只是前端页面实验。接口服务里的策略、排序、限流、供应商选择和成本控制同样需要实验纪律:稳定分桶、真实曝光、跨请求归因、护栏指标和实验收尾。
世界杯预测不是让大模型猜一个冠军。更靠谱的做法,是把历史赛果、球队强弱、进球分布、赛程模拟和临场信息放进同一套概率框架里,再诚实地展示不确定性。
浏览器 Agent 从能看网页走到能点按钮、填表单、提交操作,产品价值变大了,误操作和越权风险也同步变大。守护栏要比自动化能力先成熟。
Agent 系统不再只是写一段提示词。真正决定效果的,是如何选择、裁剪、排序和验证上下文,让模型在每一步拿到刚好够用的信息。