AI+ 的未来在哪里:能力早就够了,卡住的是验证与责任
先看两个数字。
共 34 篇文章
先看两个数字。
如果你在订阅 ChatGPT Pro,后台可能有一笔钱:$100 的 API credits。
给一个已经有 i18n 目录的项目加翻译,最省事的写法是申请一个 key,遍历 JSON,把英文换成中文。我在自己机器上这么干了一遍:从一份典型的 SaaS 界面文案里取了 27 条,跑完 14 条能用,13 条不能用。
最近流传着一张解雇信截图:OpenAI 开掉了一位年薪 30 万美元的首席软件工程师,理由是他的代码全由 AI 生成。配文只有一句自嘲——给 Claude、ChatGPT 和 Gemini 当一份「人肉 API」,直到今天之前一直干得挺好。
一句话开工,收工时得到 20 则故事、80 幅水墨线描插画、一个能翻页的网站和一个线上链接。整个过程大约花掉 700 积分,大头是 80 次图像生成;对话用的模型是 Hy4,当时处于限免期。
2026 年 11 月 9 日,OpenAI 状态页给出的 90 天数据(8 月 11 日至 11 月 9 日)是:APIs 99.97% uptime,ChatGPT 99.70%。这是厂商自报的观测值,不是合同承诺。
同一段中文提示词,九张 1536×1024 的图,10 分制,最高 10 分,最低 6 分,其余七张是 7、8、9 分。九张合计 78 分,平均 8.7 分。
今天上午把 Octop 从 v1.0.2 升到 v1.0.3b2,重新编译跑通,顺手把同赛道的项目全扫了一遍。数据来自 GitHub REST API,2026-11-02 17:20 一次快照,规模、贡献者、维护强度分两张表给。
这个故障有两个看起来毫不相关的症状,但它们是同一件事。
支付宝和微信在同一年做同一件事,撞在了两个相反的结论上。
一份 JSON 文件,128 MiB 上限,扔在任意静态主机上,就能变成 dsh 里的一个插件市场。
四天前我把 Octop v1.0.2 装了一遍,写了一篇实测。当时在三处地方给了它差评:模型 key 明文存在 SQLite 里、权限只到角色模板这一层、没有云端协同。
今天我对着 dsh 打了一行字:为什么总觉得今天任务执行有点慢。
10 月 5 日,Codex 负责人 Tibo Sottiaux 立了个规矩:接下来 28 天,每天要么发一项对大多数 Codex / Work 用户明显有用的改进,要么做一次完整额度重置。
10,627 个 star,1,346 个 fork,865 个未关闭的 issue,一个月里发了 11 个版本。这是腾讯云开源的 Octop 在我写这篇文章时的状态。
在 Windows 上查一个程序的安装路径,我原本以为是一条命令的事。结果一路上撞到三个问题:`$env:PATH` 和 `[Environment]` 到底谁是谁,profile 是什么,以及为什么终端里的中文老是变成问号。
DeepSeek Harness 的 README,第二节标题是 Developer preview,正文一句全大写:THERE WILL BE COMPATIBILITY-BREAKING CHANGES.
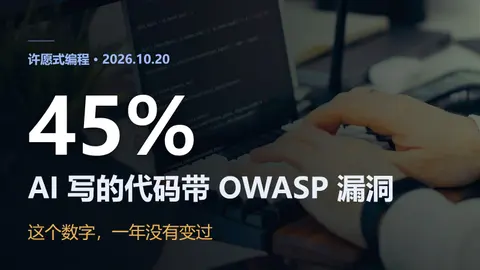
Veracode 测了 100 多个模型。45% 的 AI 生成代码样本,会引入 OWASP Top 10 级别的漏洞。
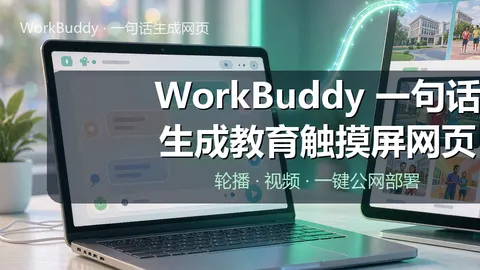
用 WorkBuddy 一个对话就做出单文件教育触摸屏首页 Demo(轮播/导航/视频弹窗/通知/时钟),并一键部署成公网链接;含实拍截图、公开体验地址,详解还能部署到哪、当前分享链接部署在哪、是否支持后端、是否永久有效。

用真实环境、过程合规与工作流路由三条尺度,重新审视 Agent 评测分数在工程选型中的意义。

不必频繁手动切换模型:让 Sol 掌舵、Terra 实现、Luna 侦察,在单一 Codex 会话中按任务边界调度多个 Agent。

Markdown 参考手册:每个语法都配「写法代码 + 渲染结果」对照,覆盖标题、段落与换行、强调、列表、链接、图片、引用、代码块、表格、分割线、转义、脚注、公式等基础与进阶语法,附平台差异、工程实践、lint 校验和一页速查表。

以一套虚构统一授权系统从设计、开发到测试跑通的完整演练为主线,拆解 Codex 如何借助 Goal、状态外置、检查点、模型档位切换和分层验收完成长任务。

我用 Codex 实测 GPT-5.6 Sol、Terra、Luna,并对 Sol 的 low、medium、high、xhigh 四档做了同题测试。本文记录真实耗时、token、API 等价成本,以及 Sites 插件当前能走到哪一步。

一份面向日常开发的 Git 极简参考手册:从概念、常用命令、协作命令、高级效率命令,到分支模型、merge 与 rebase、gh、工作流、模板、图形界面、反模式和 AI 时代的用法。

Codex 用久以后,最想知道的不是还能不能用,而是额度什么时候恢复、reset credits 还有几次。本文记录一个本地安全查询方法,也顺手整理这个通道还能看到哪些使用率信息。

用五个十分钟内能跑完的小测试,粗略判断当前 AI/Codex 会话的推理、代码理解、反幻觉和工程排查能力。
从吴恩达关于小团队和高上下文工程师的判断说起,聊聊为什么 AI 会把资深开发者推向真正的产品全栈:需求、原型、代码、文案、合规、上线和运营都要能先跑一遍。
A/B test 不只是前端页面实验。接口服务里的策略、排序、限流、供应商选择和成本控制同样需要实验纪律:稳定分桶、真实曝光、跨请求归因、护栏指标和实验收尾。

Agent 系统不再只是写一段提示词。真正决定效果的,是如何选择、裁剪、排序和验证上下文,让模型在每一步拿到刚好够用的信息。
MCP 让 AI 应用接工具变得统一,但工具一旦能读文件、查数据库、发请求,安全问题就从接口规范变成了权限、身份、审计和供应链问题。
从 Codex app-server 的协议边界讲起,分析它适合嵌入哪些产品与工程场景,也比较 Claude Code、Cursor 在脚本化、云端 Agent 和自定义集成上的相近能力。
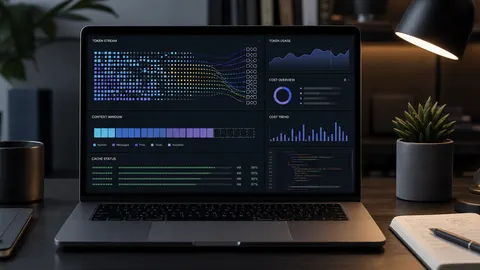
用一次真实 Codex 长会话的 token 与价格统计,拆解哪些对话最贵、为什么长上下文会拖高成本,以及如何通过拆会话、压日志、用文件和沉淀规则来优化。
向量检索不是把所有字段拼起来扔给 embedding 模型就结束了。本文用一个虚构的 API 工具市场做例子,拆解噪声文本、长描述、URL、阈值、混合召回和评估集如何影响检索质量,并总结一套可复用的最佳实践。