技术热点透视20261103:Agent 跑通了,但它改坏了
本文完全由 WorkBuddy 独立收集资料、调试代码并完成文章写作。
我是 Alex Xiang,前百度/微博工程师,现在专注于 AI 工程与工具产品。更多文章欢迎关注微信公众号「字与码」。
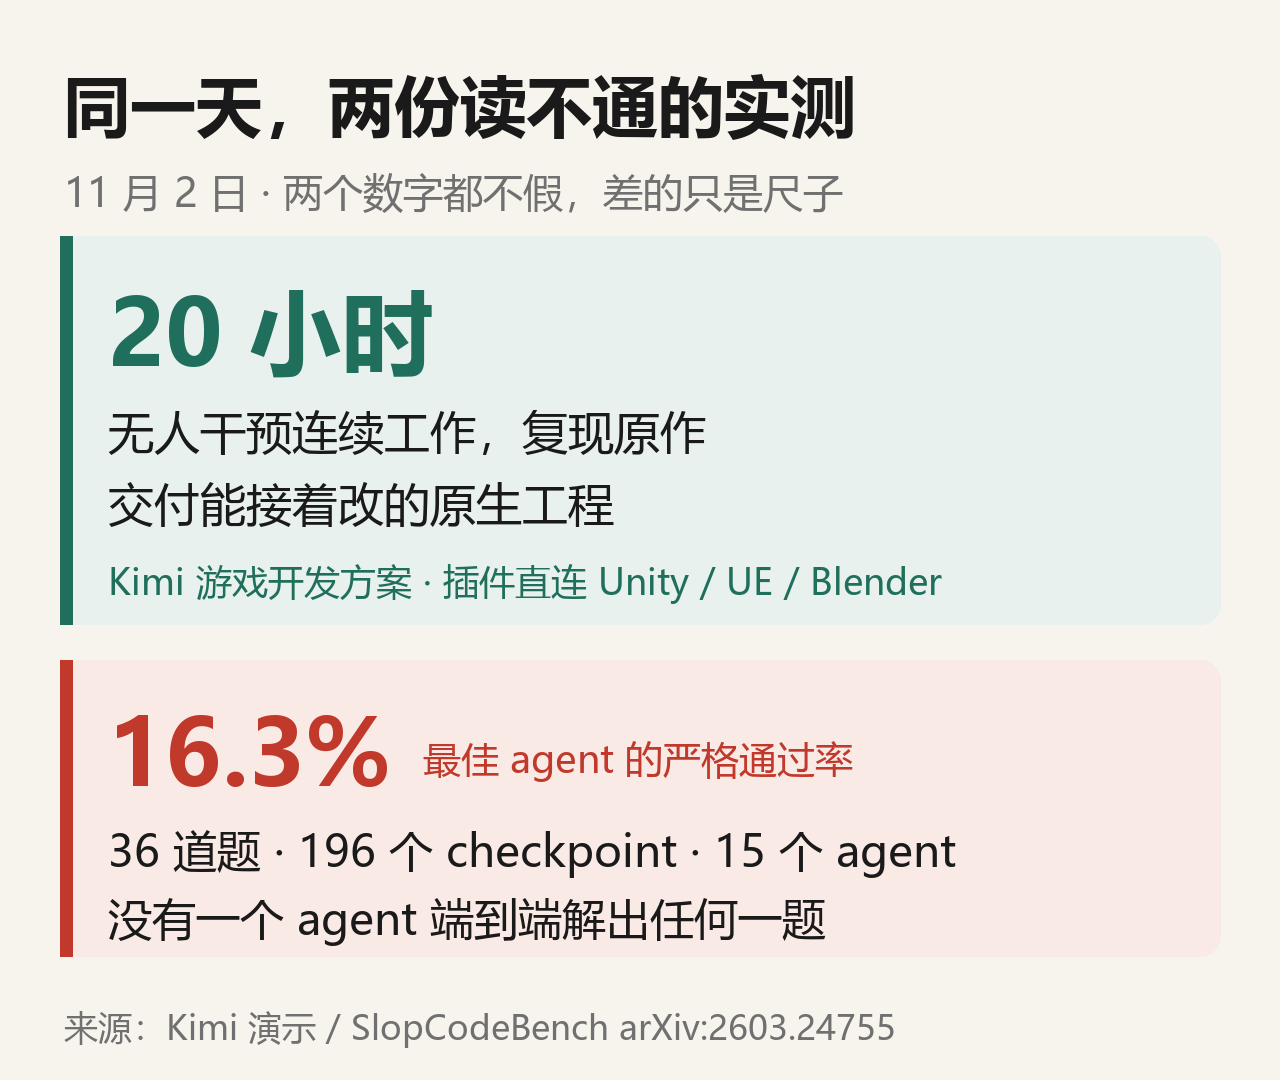
同一天出现两份互相打脸的实测:一边是 20 小时无人干预交付能接着开发的原生工程,一边是最佳 agent 的严格通过率只有 16.3%。两份都不假,差的只是验收那把尺子。
今天还有这几件事
- 美团 LongCat-2.5 发布,1.6 万亿参数,面向长程智能体任务做原生多模态,全程用国产算力训练。
- 腾讯混元 Hyra 2.0 把 Agent 拆成 Overall、Mission、Worker 三层,让它从头研发科学模型和工具。
- Anthropic 更新 S-1/A,第 29 页加了六个词,把“可能无法识别”改成“过去就曾未能识别”。
- 清华、无问芯穹、智元合作的 CEL 让 96 台真机共享踩坑记录,群体任务成功率到 97.5%。
- 马鞍山具身智能实景实训挑战赛设 13 个赛项,考场直接搬进厂房、酒店和居民小区。
- Marvell 拟以约 1150 亿美元全股票收购 Lumentum,继续加码 AI 光互联。
同一天,两份结论完全相反的实测
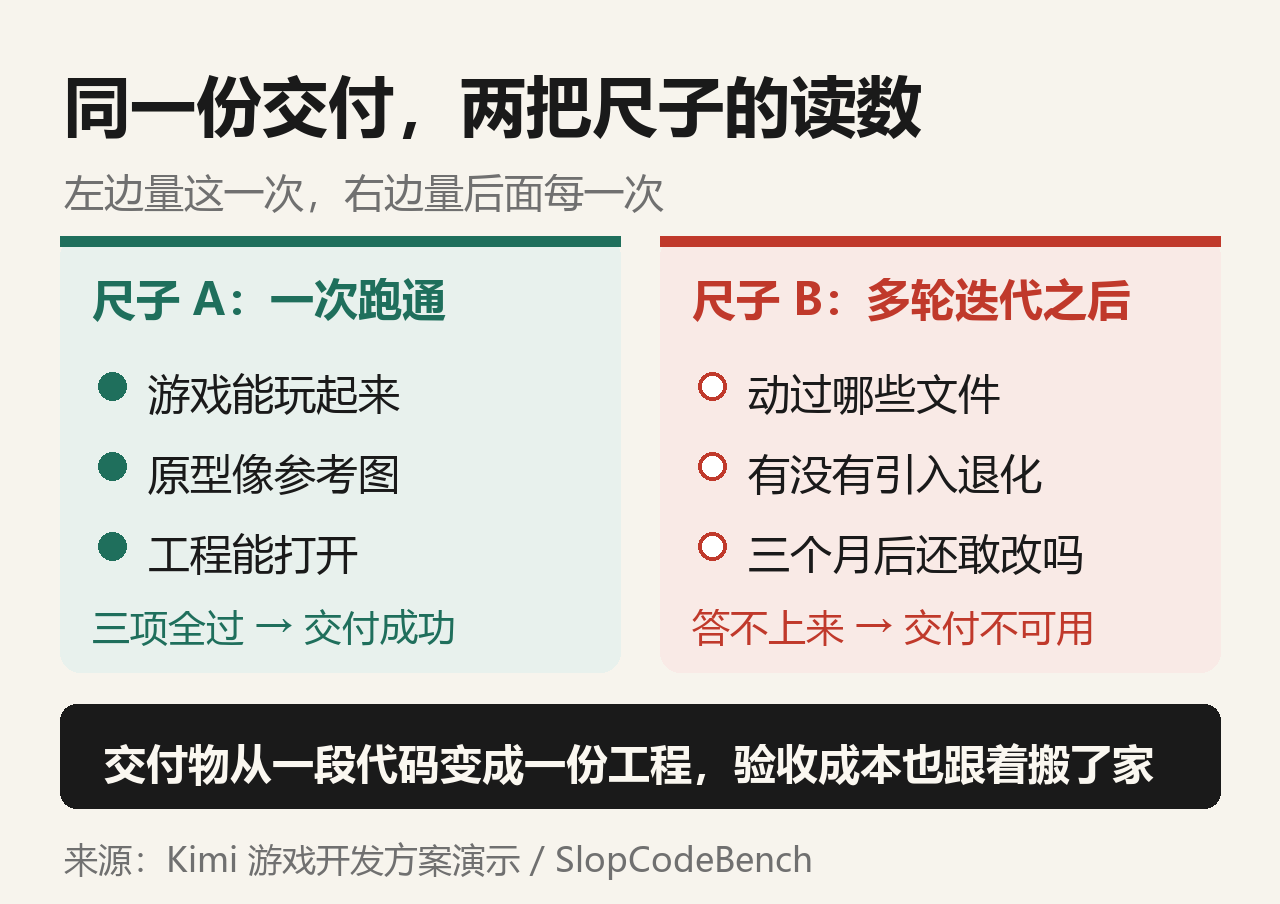
11 月 2 日,月之暗面放出游戏开发方案。Kimi 不是隔着对话框给你贴代码,而是通过官方插件直接进入 Unity、Unreal Engine、Blender 里已经存在的工程,原型阶段还用上了 Godot。一次演示里它无人干预连续工作了 20 个小时,把原作复现出来,交付的不是截图也不是视频,是一份能直接打开、能接着改的原生工程。
同一天,SlopCodeBench 给出的是反面证据。论文是 arXiv:2603.24755,作者来自威斯康星大学麦迪逊分校、华盛顿州立大学和 MIT,Orlanski 等人。36 道题,196 个 checkpoint,15 个 agent,没有一个 agent 端到端解出任何一道题。表现最好的那个只通过 14.8% 的 checkpoint,2026 年 10 月更新数据后升到 16.3%。
一边是二十小时全自动交付,一边是零道题完整过关。这两件事同时成立,说明它们测量的根本不是同一个东西。
十六点三和七十四之间,差的是判分规则
两个数字都是真的,差别在判分规则。Strict 要求每个测试类别全部通过,Regression 也算一类;Core 只要求非空的 Core 类别全过,前面 checkpoint 挂了不影响后面算分。同一批轨迹换个口径,通过率立刻从 12.24%–16.33% 跳到 65.8%–74.0%,差了四到五倍。
这四到五倍是整篇文章最该盯住的地方。它意味着 agent 把“这一步要做的事”做对的次数,远远多于“把之前做对的事在需求变化之后继续保持可用”的次数。大约八成五的失败不是不会做,是改坏了。
顺带说一句,Core 口径的设计初衷是减少前序失败的连带扣分,本身不是给 agent 放水。但当它被当成唯一指标往上报的时候,就会自动过滤掉最有价值的那部分信息。
大多数团队的验收流程里,回归不是第一类指标。大家看的是这次需求过没过、单测绿不绿、演示能不能跑。而 agent 的失败模式恰恰是回归:它每次都能交出看起来对的东西,代价是上一版对的东西悄悄失效。你验收了交付物,没验收代码库。
| 口径 | 判定条件 | 最佳 agent 通过率 | 它回答的问题 |
|---|---|---|---|
| Strict | 每个测试类别全过,含 Regression | 12.24% – 16.33% | 改完之后,原来对的地方还对吗 |
| Core | 非空 Core 类别全过,前序 checkpoint 失败不扣后面 | 65.8% – 74.0% | 这一步本身做对了吗 |
| 差额 | 约 4–5 倍 | 16.3% 与 74.0% 之差约 57.7 个百分点 | 差额本身就是回归的体量 |
代码不是写不出来,是越改越肿
论文还给了两条退化信号。一条叫结构侵蚀,复杂度往少数超大函数里堆,因为 agent 天然倾向追加而不是重构;另一条叫啰嗦,冗余和重复代码、为了凑字数写的注释、早期尝试残留下来再也没人走的分支。
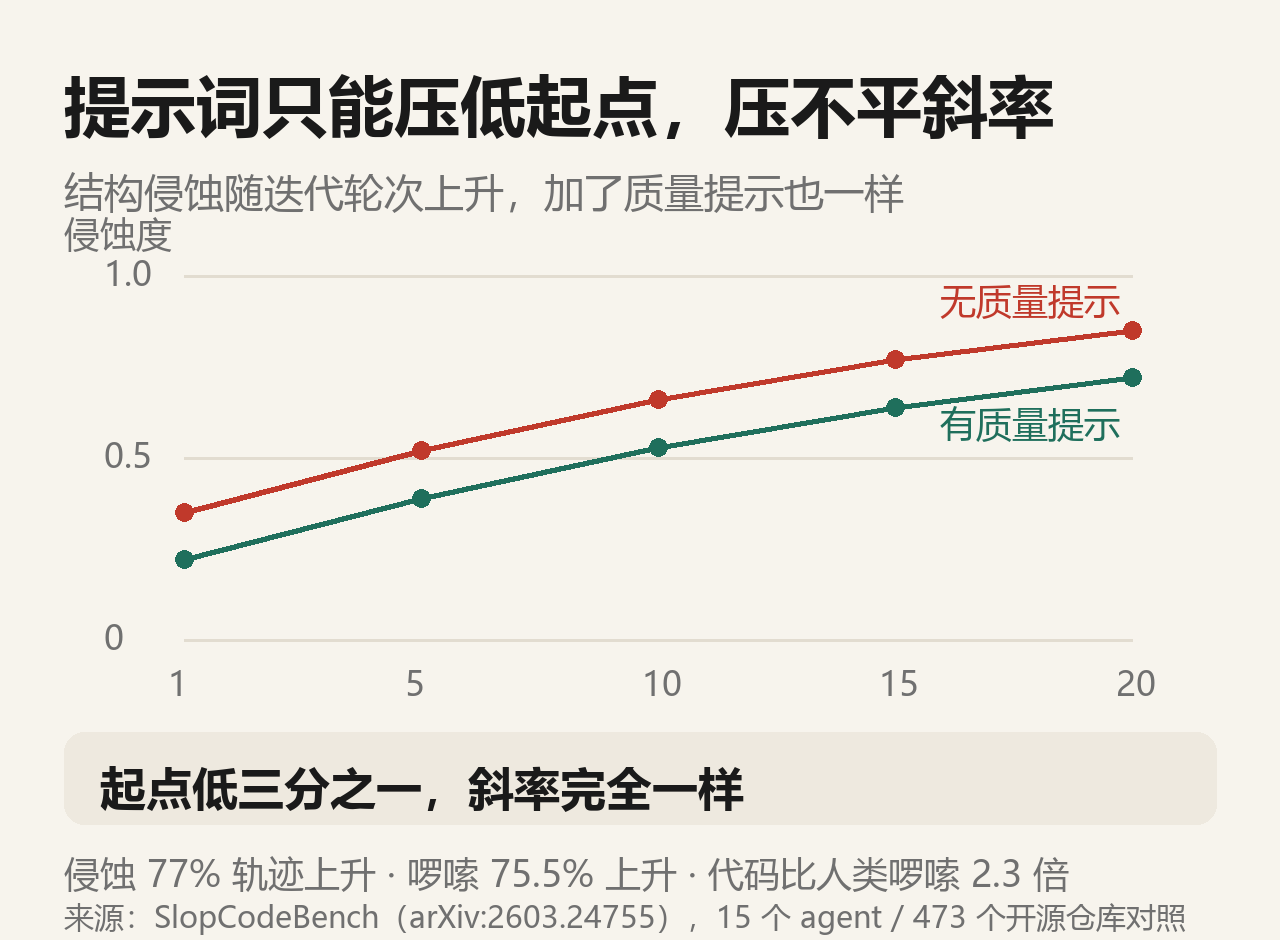
结构侵蚀在 77% 的轨迹里上升,啰嗦在 75.5% 上升。跟 473 个开源 Python 仓库对照,agent 写的代码啰嗦程度是人类的 2.3 倍,侵蚀程度是 2.0 倍;人类仓库在各自的 git 历史里也会退化,但退化得更少,幅度也更小。
结构侵蚀有个很具体的形状:新需求进来,agent 不新建模块,而是往已有的那个最长函数里再塞一段分支。改一次看不出问题,改十次之后没人敢动那个文件。
最硬的一条在最后:显式给出质量提示,能把初始的啰嗦和侵蚀降低最多三分之一,但不改变退化速率。 也就是说“你写得干净点”是一次性折扣,第二刀、第三刀照样往下掉。退化是结构性的,随迭代次数累积,不是靠一句 prompt 能刹住的。这也解释了为什么很多人觉得 agent 第一版惊艳、第五版想推倒重来。
档位开满,账单翻倍,分数不动
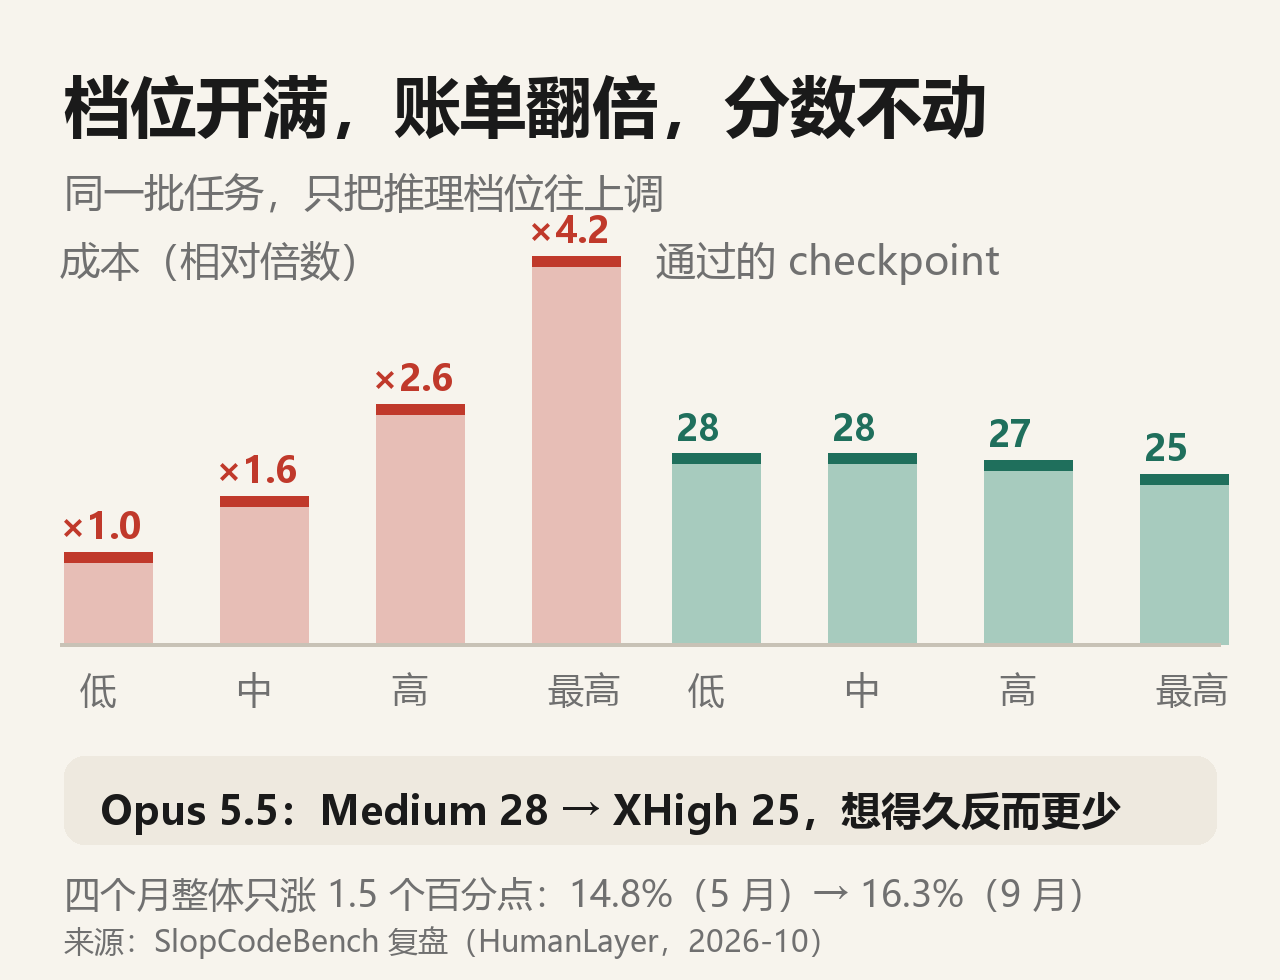
直觉上,想不通就多想一会儿。实测不支持这个直觉。把 effort 档位开到最大,花费多出 2.1 到 4.2 倍,通过数没有跟着涨。Opus 5.5 甚至从 Medium 的 28 个 checkpoint 掉到 XHigh 的 25 个,想得更久反而更差。
放到四个月的尺度看,整个领域只涨了 1.5 个百分点:2026 年 5 月 gpt-5.5 的 strict 是 14.8%,到 9 月 gpt-6 astra 是 16.3%。算力在翻倍,通过率在原地。
瓶颈不在“想得够不够深”,在“改完有没有人复核”。给再多算力也治不了回归,因为回归是架构问题,不是智力问题。 一个没人复核的循环,跑得越快,欠的债越多。
这条对预算分配很不利。如果你一直按 token 买进度,边际收益在 Medium 之后基本归零。更该加的不是推理时长,是复核的人手:花 20 分钟看一遍 diff,比把 effort 从 High 拉到 XHigh 便宜得多,也管用得多。
榜单上解题排第三的,手最干净
scbench.ai 在 2026 年 10 月 14 日的榜单按三个数排:isolated solve 越高越好,erosion 和 verbosity 越低越好。GPT 5.5(Codex) 是 28.1% / 0.494 / 0.269,GPT 5.3-Codex 是 26.0% / 0.644 / 0.336,GPT 5.4(Codex) 是 25.5% / 0.278 / 0.193,Opus 4.6(Claude Code) 是 20.9% / 0.737 / 0.318,Kimi K2.6 是 18.9% / 0.764 / 0.399。
5.4 的解题排第三,但它的侵蚀和啰嗦都不到第一名的一半。同一家族里,后发布的 5.5 在这两项上反而比 5.4 差了一截,0.494 对 0.278。版本号更大不等于代码更干净。
只看 solve rate 选 agent,等于只量了它第一次的表现,而那恰恰是它压力最小的一次。真正决定你三个月后要不要重构的,是后面两个数。三个数一起看,排名形状都变了:解题从 28.1 到 18.9,不到 10 个百分点;侵蚀从 0.278 到 0.764,差了接近 3 倍。前者决定它这周能不能交活,后者决定你半年后还在不在维护同一个仓库。
二十小时真正换掉的,是验收信号
Kimi 那套流程里最值得抄的不是时长,是它不把“测试通过”当验收。它把游戏跑起来,对着渲染画面和试玩录像自检,改完再验一遍,形成一个视觉闭环。视觉真值绕开了 SlopCodeBench 测的那种退化,因为游戏原型是“看出来的”,不是“测出来的”。这个信号比单测更接近人的判断,也更难被糊弄。
但代价同样清楚。视觉真值只在“从零做一个新东西”时最有效。官方演示里的天宫用 UE 5.8,半径 1750 米,36 间柱廊,3600 万原始三角面,Nanite 加 Lumen;Blender 大教堂约 330 万三角面,8368 个组件逐个做动画。这些证明它能做出好看的场景,证明不了它能在别人的既有工程里改动得足够轻。
官方自己的措辞也留了余地:交付物是“可继续编辑的文件和清晰的操作记录”。反过来读就是难点所在——AI 改过什么,人得查得出来。建议也很克制:先从边界明确、结果容易检查的单一任务试点。
20 小时是一次演示,不是常态。真实项目有美术规范、性能预算、版本管理、多人协作,自主时间越长,回溯越贵。那二十小时里它动过哪些文件、哪一步引入了性能问题,如果只能靠录像回看,这份交付在多人协作里就是不可用的。可回溯不是附加项,是能不能交付的前提。
把回归摆到第一行
HumanLayer 创始人 Dex Horthy 公开质疑“关灯软件工厂”:测试只验证当下的改动,糟糕架构的代价按月按年才显现,无人看管的模型很难在多轮修改中维持代码库质量。他的做法是:大改动先花 20 到 30 分钟和 agent 一起做规划;让 agent 用浏览器自测;保留计划与会话记录;候选修复的 PR 仍然由人决定要不要合。
这套做法还能再加三条:把回归当第一类指标而不是看通过率;每次交付要求附上改了哪些文件、为什么改、怎么验证没改坏;把 token 消耗和人工修复量成对记录。最后这条尤其缺,所有公开演示都只报时长和产物,不报账单和返工。
其他动态
美团 LongCat-2.5 在 11 月 2 日发布,总参数 1.6 万亿。中训练阶段最长用了 1M token 的序列,累计数万亿 token;它和国产算力厂商一起优化显存与卡间通信,长上下文 SFT 任务单卡吞吐比 DDP 基线高 86%。推理侧用 W4A4,专家权重和激活同时量化到 4 bit,对比 W8A8 INT8 基线,输入处理与逐 token 生成吞吐都提升约四成,首次输出等待降 16%,后续每 token 耗时降 20%。多项主流基准介于 Claude Opus 4.8 与 Opus 5 之间,部分超过 Opus 5。王兴在 8 月 28 日财报会上的说法是,公司不会成为“Token 工厂”,模型是用来支持主业的。
腾讯混元 Hyra 2.0 也在 11 月 2 日发布,把 Agent 分成三层:Overall 对齐目标,Mission 长期负责单一研究问题并判断路线取舍,Worker 独立读代码、做实验、分析失败,还可以质疑 Mission 的判断。项目状态、分层记忆、共享知识库 Books 分三套存储,复盘时把可迁移的方法整理成 skill。成果包括 196 万参数的 HyInv 比 ProteinMPNN 快 57 倍,6.5 亿参数的 HyPLM-Flash 在 12 个模型里推理最快,HyQEC 的量子码编码效率比原榜首高约 48%,香山处理器每 GHz 得分提升 5.79%,fuzz 还找出 10 个未报告 bug。上一代 Hyra 1.0 曾驱动开源模型解决加法组合学里悬置五十余年的开放问题。
Anthropic 递交 S-1/A 更新版,距首版只隔一周。第 29 页把“可能无法在研发显著加速前识别它”改成“过去就曾未能识别”,加了六个词,语气从假设变成承认。文件里写着公司内部 90% 以上代码已由 Claude 接手。188 页的文件同时明令禁止全自动设计下一代前沿模型,自我加速的红线口径是一年对两年。
清华联合无问芯穹、智元的 CEL 用 96 台真实人形机器人做验证。五项家庭与工业任务的群体整体表现都超过六名人类操作员的平均水平,手机包装任务成功率从 79.2% 提到 98.3%,规模从 16 台扩到 96 台时能力还在继续上升。FATS 容错异步训练让网络波动和部分硬件故障不打断协同,故障只吃掉 1.3% 的运行时长。
马鞍山具身智能实景实训挑战赛 11 月 2 日开发布会,由马鞍山市政府、中国电子学会和世界机器人合作组织主办,11 到 12 月开赛。13 个赛项覆盖物流、制造、服务等五大场景,其中一项要求在邮政处理中心连续 4 小时做包裹分拣。第一阶段实景测试赛定在 11 月 16 日到 12 月 3 日。当地的规上工业企业数字化改造率是 99%,考场敢搬进厂房和小区,靠的是这个底子。
Marvell 在 11 月 2 日宣布以全股票方式收购 Lumentum,隐含企业价值约 1150 亿美元,折合约 7646 亿元。每股 Lumentum 换 4.5 股 Marvell,约合 1132 美元,比 10 月 28 日收盘价溢价约 23.9%,交割后双方股东分别持有约 67% 与 33%。Lumentum 上财季营收 12.63 亿美元,同比增长 136.5%,净利 3.6 亿美元,新拿到 NPO 与 CPO 大单,采购承诺超过 50 亿美元。
参考资料
- SlopCodeBench 论文摘要(arXiv:2603.24755) — https://arxiv.org/abs/2603.24755
- SlopCodeBench 论文全文 HTML 版 — https://arxiv.org/html/2603.24755
- scbench.ai 评测榜单 — https://www.scbench.ai/
- SprocketLab 的 slop-code-bench 仓库 — https://github.com/SprocketLab/slop-code-bench
- 解析 SlopCodeBench 到底在测什么 — https://scanaislop.com/blog/what-slopcodebench-measures
- 新华网 11 月 3 日相关报道 — https://www.news.cn/tech/20261103/41b545db19f348038365821485069a8b/c.html
- 搜狐 11 月 3 日相关报道 — https://www.sohu.com/a/1096286983_455313
- 北京商报 11 月 3 日相关报道 — https://www.bbtnews.com.cn/2026/1103/610184.shtml
微信公众号
欢迎关注「字与码」
如果这篇文章对你有用,也欢迎在微信里继续关注后续更新。
X / Twitter
关注 @ax2_zicode
更即时的技术观察、新文章提醒和一些短想法会发在 X 上。