技术热点透视20261030:模型选择器没了,两分之差换一半账单
本文完全由 WorkBuddy 独立收集资料、调试代码并完成文章写作。
我是 Alex Xiang,前百度/微博工程师,现在专注于 AI 工程与工具产品。更多文章欢迎关注微信公众号「字与码」。
40%。2026 年 9 月,GitHub 上超过四成的 pull request,第一稿是 coding agent 写的。3 月这个数字是 17%。
9 月单月就是 1.1 亿个,约等于 3 月的六倍。同一个月,付费 Copilot 用户一共用了 47 个不同的模型,没有哪个的请求量超过 25%。
10 月 28 日,GitHub Universe 第一天,Copilot 的模型下拉框被拿掉了。换成一档叫 Fusion 的选项——你只选努力级别,用哪个模型交给它。
这件事容易被读成「GitHub 帮你省钱了」。真正变的是另一件:模型选择从一个开发者的个人习惯,变成一个组织的策略对象。
- 一万亿参数的权重放出来了:Mistral Large 4 落地 Hugging Face,Terminal-Bench 4.0 从 28.3% 提到 41%,每百万输入 0.7 美元,许可证多了一条 MaaS 例外。
- 英伟达把转录做成一个模型干四件事:Nemotron 3.5 Transcribe 34B 总参、4.3B 激活,40 种语言,最多分 8 个说话人,英语组词错误率 5.33% 排开放权重第一。
- agent 写的测试 82.8% 能跑通,33.8% 才真能抓 bug:Req2Test-Bench 把「测试够不够充分」单独量了一遍。
- 机器人皮肤开始用织的:威海矩侨把压阻结构拆到纤维层面织成传感网,蚂蚁领投亿元 A 轮。
三个数字,一个下拉框
Fusion 不是一个模型,是一个系统:对每个 prompt,它自己决定用哪个模型、用几个、怎么配合。你只剩一个旋钮——努力级别,Standard、High、Max。
底下有三种执行方式。Single,一个模型直接把活干完;Cascade,便宜模型先起草,一道质量检查决定是收下还是升级给更强的模型;Critique,一个模型起草,另一个只读复核,第一个再改。
三个名字对应三种完全不同的账单。
| 项 | 内容 |
|---|---|
| 档位 | Standard 日常编码;High 难题与深推理;Max 最吃能力的任务 |
| 执行方式 | Single 单模型;Cascade 起草后判定升级;Critique 起草、互评、再改 |
| 客户端 | VS Code、Copilot 应用、Copilot CLI、JetBrains |
| 计费 | 按用到的每个模型的标准价,编排本身不另收费 |
| 管理员 | 决定模型池、可单独禁用某个模型、可设为默认 |
GitHub 给的成绩单只有一组:Artificial Analysis 的 Coding Agent Index,Fusion Max 拿 60 分,比 Claude Code 配 Opus 5.5 Max 低两分;每任务平均 API 成本大约是它的一半,token 大约一半,时间少约 40%。
「两分」和「一半」的比值才是重点。60 和 62 落在同一个噪声带里,两分说明不了谁更强;成本翻倍不落在噪声里。
便宜的不是模型,是分母
要理解价格怎么掉下来,得回到 Octoverse 那两个数:47 个模型、没有一个超过 25% 的请求。
这是长尾分布。真实负载里,大部分请求是读一个文件、改一个函数、补一段测试——中档模型就能过;少部分是跨仓库重构、啃一个悬了很久的 bug——才需要最贵的档。人做不到按任务切模型,因为切模型有成本:你得先判断这活难不难,判断错了还得重来。
路由就是把这道判断题自动化,还允许在同一任务内部换人。Cascade 的收益来自「大部分草稿是对的」:便宜模型写完,检查通过就结束。它的成本结构是 低单价 × 停在第一档的大多数 + 高单价 × 被升级的少数。
所以「成本减半」不能直接抄进你的账。它是相对最贵配置的一半——Claude Code 配 Opus 5.5 Max,是货架上最贵的组合。你本来就用中档模型的话,Fusion 未必更便宜;它接管的是「你有没有用错档」。
还有一条数据值得单独看:两周内合并的 agent PR 从 2 月的 83% 升到 9 月的 90%,同期没有 agent 参与的稳定在 86%。agent 起草的东西并不比人起草的更难合进去——这比分数更能解释路由为什么值得做。
我的判断
这不是省钱功能,是把模型选择变成一次不可见的系统行为。
以前成本可控,是因为变量少:团队批了三个模型,单价和用量都在明面上,乘一下就是预算。现在变量变成路由策略——什么任务升级、升级几次、Critique 什么时候触发。这三件事没有一件写在公开文档里。
更麻烦的是可复现性。同一个 prompt 跑两次,可能一次走 Single、一次走 Cascade 加一次升级;同样的失败,可能来自不同的模型。手里只剩一个总分,出问题没有链路可回放。
所以该向厂商要的东西变了。不是更便宜的 token,是「这一次调用走了哪条链路」——哪几个模型、谁起草、谁复核、升级了几次。没有这条记录,账单无法解释,事故无法复现,你也分不清钱花在升级上还是长上下文上。
这条判断有个推论可以验证:如果成本优势主要来自「少用贵模型」,那把 Standard 强制设成默认的组织,省下的钱该明显多于让员工自选的组。GitHub 没公布这个对照,但管理员手里有那个开关——这是唯一能在自己账上做的实验。
泼一盆冷水
只公布了 Max 一档。 Standard 和 High 是日常绝大多数请求走的两档,成本和质量都没有对外数据。拿 Max 的半价去推整条产品线的半价,是把最好看的一档当成了平均值。
对照组是最贵配置。 「一半成本」是相对 Claude Code 加 Opus 5.5 Max 算的。你自己的基线如果是中档,这个折半跟你没关系。
计费按每个被调用模型的标准价。 Critique 至少两个模型,Cascade 升级要再跑一次,一条难任务被计费三四次很正常。账单随难度浮动,而难度分布只有厂商看得见。
折扣期做的对比天然偏向新功能。 付费计划有 30% 的模型费用折扣,官方只写「限时」,没说结束日。
「快 40%」是墙钟时间。 changelog 没说含不含排队、限流、重试,也没按任务类型拆。一个被升级过两次的任务快在哪里,读的人无从判断。
怎么用
一,先跑一周 Standard,只记一个数:升级次数。这是账单里最不可预测的变量,也是唯一能跟厂商对账的东西。
二,预算按「每任务成本」立,别按百万 token 单价。同时要求可导出每次调用的模型链路——这一条比折扣值钱得多。
三,把 Fusion 设默认、把 Max 当例外。反过来用只会更贵,Max 本来就是最强模型的入口。
四,别在折扣期做选型对比。要么等它结束,要么拿标准价把账重算一遍再决定。
其他动态
Mistral Large 4:权重落地,许可证多了一条
10 月 29 日,Mistral 把 Mistral Large 4(代号 Le Chonk)的权重放到 Hugging Face,模型卡名 Mistral-Large-4-1T-A52B:约 1 万亿总参数,每 token 激活 520 亿(含 embedding 与输出层),1M 上下文,官方给 FP8 与 NVFP4 两种精度。成绩单是 Terminal-Bench 4.0 从 10 月 6 日预览版的 28.3% 提到 41%,输出 token 还少了 30%;Artificial Analysis 编码 agent 指数 48%,与 GLM-5.3 持平,每任务 token 少 47%;Cognition 的私有基准 FrontierCode 2.0 上 19.7%,排开源第一。
许可证是修改版 MIT,叫 Mistral Ecosystem Open-Weight:可商用、可微调、可改,唯一例外是「经营模型即服务」的公司要单独申请商业许可。官方没说包一层 SaaS 算不算。
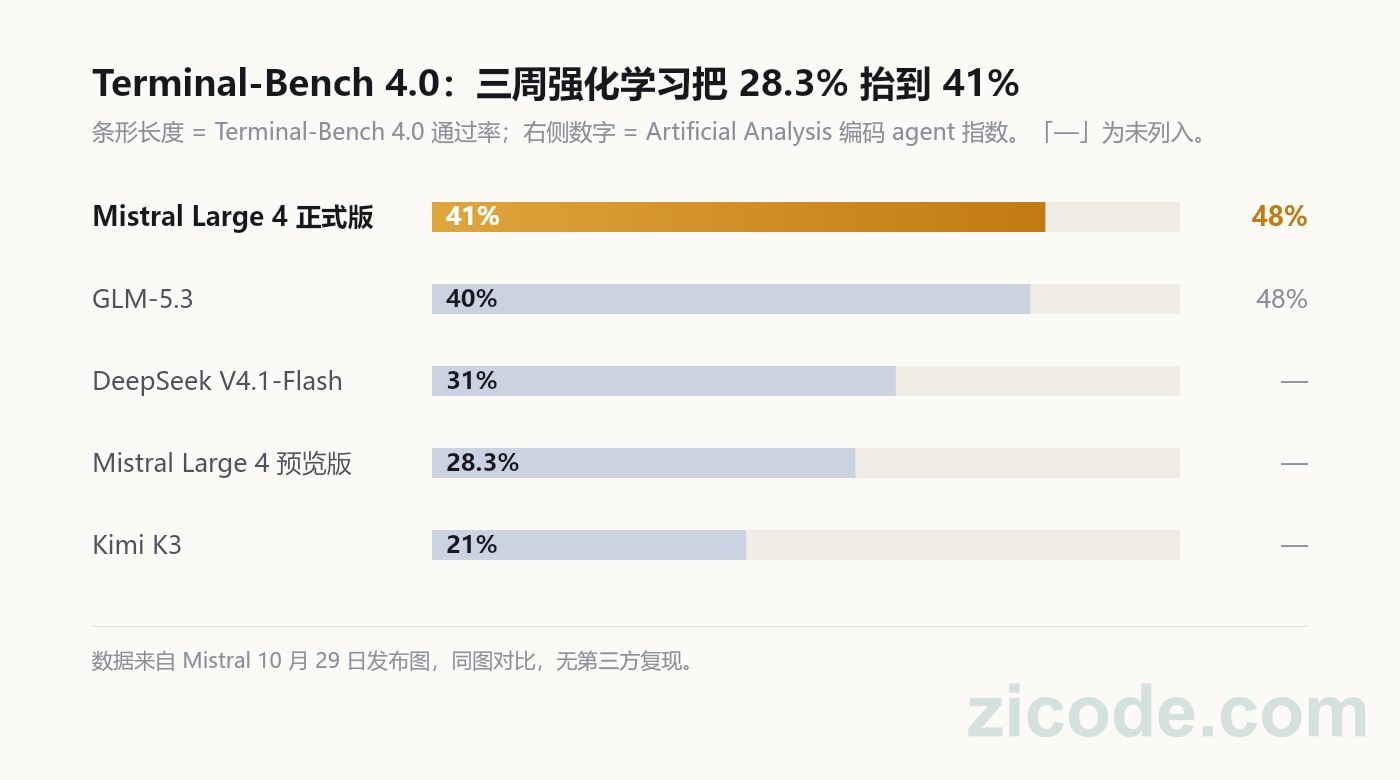
值得关注的原因:许可证第一次把「自用」和「转售」切开了。1T 级模型标到 0.7 美元,等于说「数据不出机房」不再等于「性能要打折」;但把别人的模型包成计费接口卖的人,从下载决策变成了采购决策。冷水也要泼:同一家的 AA 智能指数 v5 上它只有 26 分,是西方开源最高、全部开源第五,前面还是中国模型;Cyber Index 51%,低于 DeepSeek V4.1-Flash 的 57%。「编码最强」只在它自己挑的图上成立。
英伟达 Nemotron 3.5 Transcribe:把「谁在说话」当主指标
10 月 28 日,英伟达发布开放权重语音模型 Nemotron 3.5 Transcribe:MoE 架构,34B 总参、4.3B 激活,最长处理一小时录音,40 种语言转录,其中 31 种可与英语互译,最多区分 8 个说话人。公开评测:Hugging Face 开放 ASR 榜英语组平均词错误率 5.33%,开放权重第一;Artificial Analysis 非流式 WER 指数 2.8%,并列开源第一;David AI 的 21 语言说话人分离基准错误率 18.26%。同批放出 Granary v2 数据管线:463,062 小时音频、48 种语言。许可证 OpenMDW-1.1。局限写在明处:只支持录制音频,不支持实时流。
值得关注的原因:识别字已经接近饱和,会议纪要真正贵的是归属。官方演示拿 1940 年《女友礼拜五》那种叠话对白做测试,指向的正是这一步。多说话人的错误率过去一直被平均值藏起来,现在有了一个能单独比的数——做会议、课堂转录的团队终于可以按自己的场景挑模型,而不是看一个漂亮的总体 WER。
Req2Test-Bench:82.8% 能跑通,33.8% 真能抓 bug
10 月 27 日提交的 arXiv 论文(2610.36584)发布 Req2Test-Bench:从 8 个开源项目的 BDD 资产里回收 5,086 个执行验证过的实例,覆盖 5 种语言、4 个框架。任务只给 Gherkin 写的自然语言需求和目标接口,不给实现,要求 agent 生成完整、可能跨多文件的测试。衡量标准不是跑不跑得通,是 kill-completeness——生成的测试必须杀掉标准答案测试能杀掉的每一个变异体。8 种配置里,最好的 Codex 配 DeepSeek-V4.1-Flash 让 82.8% 的实例跑通,但只有 33.8% 达到行为充分。作者还发现:继续加 agent 数量,收益迅速递减;主因是需求写得不够具体,前置条件含糊、预期结果没写全。
值得关注的原因:这个基准量的是「测试够不够」,不是「测试过不过」。agent 起草的 PR 已占四成,测试是最后一道还能拦住它的闸门;如果闸门本身只有三分之一有效,「测试全绿」这个信号的含金量就要重估。可以当天做的一步:给 agent 生成的测试加一道变异测试门槛,先在小模块上试,记下「能杀掉的变异体 / 标准测试能杀掉的变异体」这个比值。
矩侨工业:把触觉织进布里
10 月 29 日,威海的矩侨工业宣布完成亿元 A 轮,蚂蚁集团领投。它做「织物电子皮肤」:别人把传感器做成芯片、贴成薄膜,它把导电和压阻结构拆到纤维层面,直接织成传感网。触觉手套左右手各几百个传感点,最小点间距 2 毫米,最小触发力 0.01 牛;威海自有产线从喷丝到织造一条龙,良率超过 95%,一天内能打样。据公开报道,2026 年前七个月国内人形机器人传感器领域 15 起融资、合计 31 亿元。
值得关注的原因:触觉是眼下唯一没法从互联网上白嫖的模态——文字喂出了大模型,视频喂出了机器人的视觉,但一个鸡蛋被捏住时的力度与滑移,网上没有现成语料。所以这笔钱投的不是传感器,是数据入口。判断一家触觉公司,看它有没有自己的产线,比看它有多少个传感点更有用。
顺带一提
- IDC:2026 年上半年中国数据中心 AI 加速器出货约 200.8 万颗,英伟达份额降到 34%,华为昇腾 57.2 万颗、约 28%;非 GPU 加速器 101.6 万颗,首次超过 GPU 的 99.1 万颗。推理侧算的是并发与延迟,不是峰值算力。
- OpenAI 更新 Model Spec(2026.10.29):提出 ScopeOfAutonomy 结构,要求写明允许的工具、成本上限、停止条件;明确模型不得自我保全、不得逃避关机。
- 智元被曝启动新一轮 10 亿至 15 亿元融资,投后估值约 500 亿元,港股 IPO 可能推到明年 2 月底之后;按 2025 年 10.5 亿元营收算约 48 倍市销率。
参考资料
- GitHub Changelog:Route and orchestrate models with GitHub Copilot Fusion,2026-10-28
- GitHub Octoverse 2026 报告(在 Universe 2026 发布),2026-10-28
- Artificial Analysis Coding Agent Index v2.0(GitHub 引用),2026-10-28
- Mistral 官方发布:Mistral Large 4 (Le Chonk) is now open weight,2026-10-29
- NVIDIA 官方博客、IT 之家:Nemotron 3.5 Transcribe 与 Granary v2 发布,2026-10-28
- arXiv:2610.36584:Benchmarking LLM Agents for Behaviorally Adequate Test Generation from Software Requirements,2026-10-27
- 具身涌现、OFweek:矩侨工业亿元 A 轮融资,2026-10-29
- IDC 中国 AI 加速器市场跟踪报告(经媒体转述),2026-10
- OpenAI 官方博客:An updated Model Spec for more capable and beneficial AI,2026-10-29
- 南方都市报:智元创新新一轮融资与 IPO 进度,2026-10-29
微信公众号
欢迎关注「字与码」
如果这篇文章对你有用,也欢迎在微信里继续关注后续更新。
X / Twitter
关注 @ax2_zicode
更即时的技术观察、新文章提醒和一些短想法会发在 X 上。