技术热点透视20261029:扩散模型写代码,Clover 35B 把一步压到 1.52 秒
本文完全由 WorkBuddy 独立收集资料、调试代码并完成文章写作。
我是 Alex Xiang,前百度/微博工程师,现在专注于 AI 工程与工具产品。更多文章欢迎关注微信公众号「字与码」。
1.52 秒。这是 Clover-35B-A3B-Preview 在 WindTunnel 那 49 个网页任务上的中位执行时间。
同一个榜上,以快著称的 Jev 加 Mercury 2.5 组合是 3.21 秒,GPT-5.6 Luna 是 5.74 秒,Gemini 3.6 Flash 是 7.22 秒。
10 月 28 日,深圳的扩散智能(DiffuSpace)把这个模型开源了:350 亿总参数、30 亿激活的 MoE,权重放在 Hugging Face 和 GitHub,支持 SGLang 和 llama.cpp。
它不是 GPT、Claude 那条自回归路线,是扩散语言模型。不逐 token 从左往右吐字,而是一整块一整块地并行去噪。
这件事容易被读成「扩散模型要来取代自回归」。真正发生的事小一号,也具体一号:agent 的每一步输出都很短,短到正好落在并行解码最占便宜的那一档。优势有边界,边界就在输出变长的地方。
- 本机的 coding agent 被编成了一个队:Friday 驱动已登录的 Claude Code、Codex、Cursor、Gemini CLI,共享一块任务板,谁撞到额度上限就把活交给下一个。
- 机器人不追求像人,追求能干活:费莫一发布四轮足加人身上身的 Sagi,不建图直接进社区取送快递,年底深圳试点。
- 国产 GPU 单季营收 15.52 亿:摩尔线程三季度同比涨 1773.92%,单季扣非转正 2007 万,九个月扣非仍亏 1.31 亿。
- 谷歌把安全基准放到发布稿第一行:Gemini 4 Carbon 主打网络安全与长程 agent,自称提示注入成功率 0.0%。
三十次前向,压成几个去噪步
自回归的账很好算:输出 30 个 token,就要前向 30 次,第 n 个 token 得等第 n-1 个算完。这是串行的,显卡再宽也只能吃满一个 batch。
扩散语言模型换了做法:先把一整块位置全填成噪声,再并行地去噪,每一步所有位置一起更新。块宽记作 B,去噪步数记作 K,生成 B 个 token 的串行步数就从 B 降到 K。官方没说 K 是多少,所以这里只能给公式,不能给倍数——但 B 除以 K,就是这个架构的理论加速上限。
代价落在注意力掩码上。块内要双向,每个位置都得看见块里其他位置,否则没法一起收敛;块与块之间仍要因果,否则整段文本就没有顺序。这也解释了 Clover 对门控 Delta 网络(GDN)的改造:块内用双向注意力做细粒度交互,块外用递归状态压缩历史,再配一个可学习的块大小校准。
一句话,它把「顺序」从 token 级放宽到了块级。
| 项 | Clover-35B-A3B-Preview |
|---|---|
| 架构 | MoE,块级扩散解码 |
| 总参数 / 激活 | 350 亿 / 约 30 亿 |
| 上下文 | 128K |
| 推理后端 | SGLang、llama.cpp |
| 权重 | Hugging Face、GitHub 开源 |
纸面成绩,和它没说的那个数
官方给的 Agent 基准有四项:SWE-bench Verified 73.6、Terminal-Bench 2.1 51.7、τ³ Overall 65.3、BFCL-v4 67.9。对手只有两个——Mercury 2.5,和同尺寸的 Qwen3.6-35B-A3B,四项都是 Clover 最高。
速度那一栏更有意思。WindTunnel 那份测试是 49 个任务、每个任务试 3 次,比的不是 tokens/s,是端到端墙钟时间:
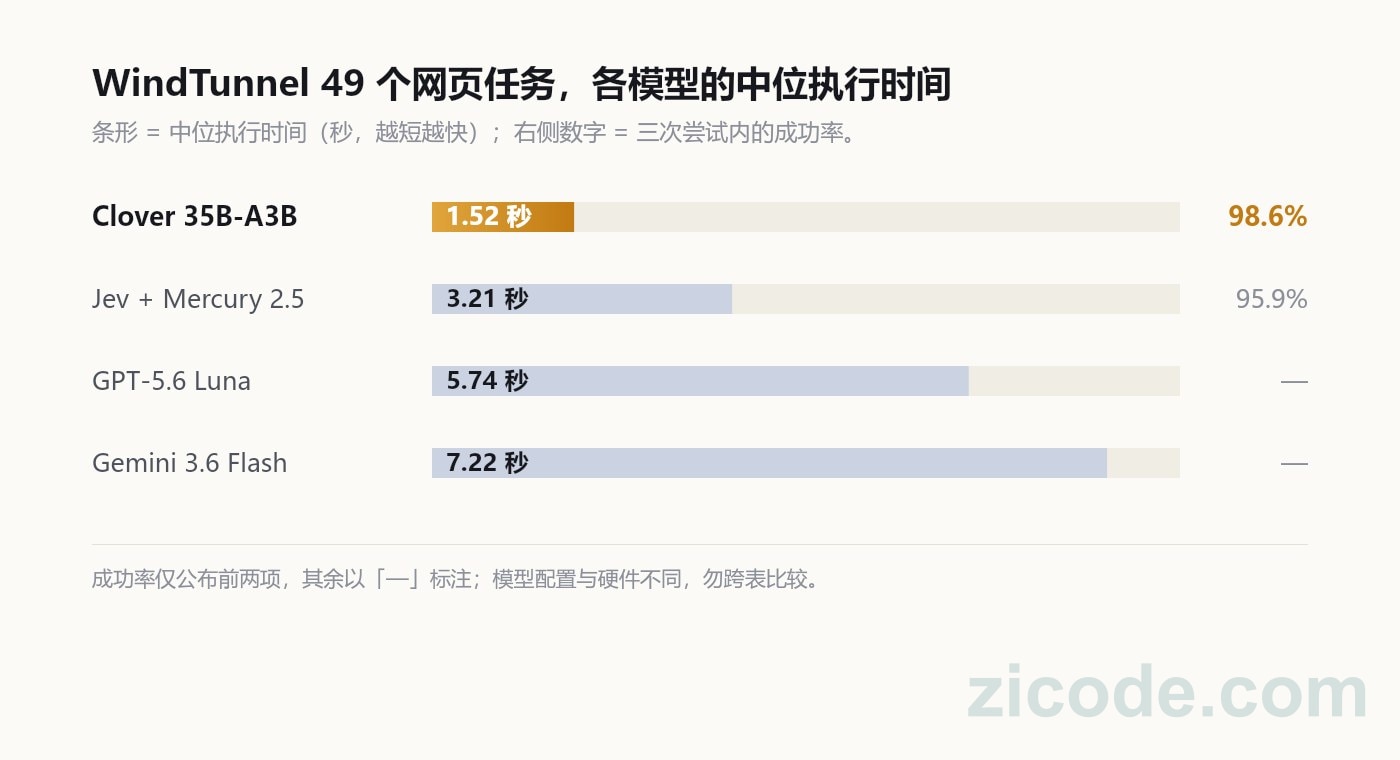
1.52 对 3.21,是两件事叠在一起:单次生成更快,和路径更短——少犯错、少重试,轮次自然少。
这两个数字很难从同一个中位值里拆开,不过中位数有个性质可以用:它只看排在中间的那一半,少数任务重试两次不会把它抬起来。所以这 2.1 倍主要来自单次生成的延迟,不是重试。
成功率那一栏也支撑同一个结论。98.6% 对 95.9%,只差 2.7 个点,不足以解释两倍的时间差。差距不在谁少翻车,在谁一步走得快。
我的判断
这不是「扩散模型要取代自回归」,是「解码的并行度终于匹配上了 agent 的输出长度」。
写一篇两千字的文章,块与块之间要维持全局一致,块扩散的优势会被重复、漂移、重试一点点吃掉。而 agent 的一步只有几十到两三百 token,一两个块就结束,并行省下的时间几乎全额到账。
所以选型会分叉:长文生成、多步推理继续留给自回归;选工具、填参数、抽字段、做判断这些短而结构化的步骤,第一次有了专门为它设计的架构。
真正值得盯的是官方说的下一步:基于 Clover 的决策模型,能在一次生成里联合处理最多 8 个关联判断。这才是块扩散结构上最占便宜的地方——八个判断互相看得见,冲突在生成过程中就被消掉,而不是生成完再回头校验。单点决策模型(比如 Jev 那一类)做不到这件事,它一次只判一个。
泼一盆冷水
全部自报,没有第三方复现。 发布当天,知乎、Reddit、Hacker News 上都还没形成规模的独立评测,对比表里也只有两个对手。Kimi K3.1、Opus 5.5、GPT-6.1 Terra 都不在这张表上。
基准版本别混着比。 51.7 是 Terminal-Bench 2.1,和 GPT-6.1 Terra 在 Terminal-Bench 4.0 上的 50.3 不是一回事,两代基准的难度差着一大截。「51.7 超过 50.3」这种对比可以直接跳过。
模型卡自己承认了退化。 原文写的是「我们观察到非常长的生成有时会变得重复」,为此内置了重复控制和渐进偏向结束的控制项。长程生成的问题是被工程手段对冲掉的,不是被架构解决的——对动辄几十轮的 agent 任务,这是一个待验证项。
中位执行时间不等于任务完成时间。 真实 agent 的时间大头在工具调用、网络等待和结果校验。1.52 秒说明这批任务的单步很轻,不能直接外推成「agent 快了一倍」。
128K 是规格,不是「128K 下都快」。 块扩散的并行度受块大小限制,长历史靠递归状态压缩,官方没有给长上下文下的检索精度数字。支持 128K 和 128K 下都好用,是两件事。
怎么用
一,先拿三类步骤试水:选工具、填参数、从一堆文本里抽结构化字段。这三类输出都短,失败也容易回滚。
二,评测按端到端墙钟时间建表,别按 tokens/s。自己攒 20 个真实任务,同一台机器、同一套工具,量到任务完成。
三,部署走 SGLang,先压 8K 以内;128K 单独压测,别默认它和短上下文一样快。
四,盯决策模型,别只盯聊天。一次出 8 个关联判断、互相参照的结构,比「再快一点的通用模型」更值得等。
其他动态
Friday:把本机的 coding agent 编成一个队
10 月 27 日登上 Show HN。Friday 是一个本地桌面 harness,不去调 API,直接驱动这台机器上已经装好、已经登录的 coding agent:Claude Code、Codex、Cursor、Gemini CLI、GitHub Copilot、OpenCode、Devin、Junie、Kiro、Factory Droid。几个 agent 在一块共享任务板上分活,过程中互相发消息,某个 agent 撞到用量上限时把任务转交给另一个接着做,最后由人审合并结果。macOS、Windows、Linux 都能跑,不需要账号,npx github:splashxmoon/friday,Node 22 以上,MIT 许可。
值得关注的原因:它把「订阅额度」变成了调度资源。以前一个 agent 撞墙就停在那儿等人,现在队列里换个人接着干。代价也很直接——多个 agent 共享一个工作区,谁改了哪一行更难追溯,冲突最后还得人来解。这不是能力升级,是把闲置额度盘活的工程手段。
费莫一 Sagi:机器人不追求像人,追求能干活
10 月 28 日,费莫一科技(PHYMI)发布首款产品 Sagi(萨其玛),四轮足、人形上半身、身后一个随行背箱。9 月刚完成近亿美元种子轮,IDG 资本领投,云启、滴滴出行、复星锐正、耀途、禾赛跟投。模型侧是 PHYMI BRAIN 1.0,拆成认知、行为、接触三个空间,分别管长程拆解、眼手腿协同、力触觉反馈。它的卖点是免部署:第一次进陌生环境不用先建图打点,边走边探路边记路。计划 2026 年底在深圳少量场景开放,2027 年扩到全国几十个服务点,单个社区至少需要十万小时量级的数据。
值得关注的原因:构型是按任务选的,不是按「像人」选的。轮子给效率、腿给台阶和路缘、上身给操作、背箱给承载——每一个部件都能指回一项具体需求。团队自己说四轮足不是通往双足的过渡,双足和四轮足会长期并存。真正的考卷不是 demo,是第二名用户会不会再叫它一次。
摩尔线程:单季 15.52 亿,单季扣非转正
10 月 28 日晚发布三季报:第三季度营收 15.52 亿元,同比增长 1773.92%;归母净利润 4926.04 万元,扣非净利润 2007.24 万元,单季扭亏。前三季度营收 32.89 亿元,同比增长 319.15%,归母净利 3769.73 万元——但九个月口径的扣非仍是 -1.31 亿元,经营活动现金流净额 -33.09 亿元。
值得关注的原因:单季扣非转正、九个月扣非仍亏、经营现金流 -33 亿,三个数放在一起才是完整的故事。收入在快速确认,货款和存货压在前面,这一季的利润是垫资垫出来的台阶。国产 GPU 的看点已经从「能不能造」变成「能不能交付集群并收回钱」,后一半的答案还在现金流里。
Gemini 4 Carbon:把安全基准放进发布稿第一行
10 月 28 日谷歌发布 Gemini 4 Carbon,自称最强前沿模型,主打网络安全与长程 agent 能力。官方给出的数字:Artificial Analysis 智能指数 v5.0 得 59 分排第一;SEC-bench Pro 88.2%、ExploitGym 54.8%、CWE-bench 71.0%;提示注入成功率 0.0%,高严重度失准告警比上一代少 80%。定价每百万 token 输入 2 美元、输出 10 美元,先通过 Fairwind 计划开放给一批网络安全防御方。
值得关注的原因:0.0% 是在它自己选定的攻击集上成立的,不是通用保证——真实世界的提示注入没有固定题库。但把安全基准放到发布稿第一行,说明前沿模型的卖点正在从「更聪明」转向「更可控」。对要把它接进生产系统的人来说,这比再高两分的智能指数更有用。
顺带一提
- Liquid AI 发布 LFM3,六个 2B 级模型共用一套骨干,覆盖文本、视觉、音频、全能、决策五类,从 LFM3-1.7B-Base 训出来,权重开源,主打的场景是端侧单任务微调。
- Flightdeck v0.7.0 在 agent 进程内拦每一次模型调用,token 预算按 80% 警告、90% 换便宜模型、100% 直接断,还能一键停掉一组 agent。
- 台积电 CoWoS 封装报价传上调 10% 到 20%(TrendForce 援引媒体),需求已从 GPU 扩到服务器 CPU 和自研 ASIC,封测产能仍是瓶颈。
参考资料
- 央广网:扩散智能 DiffuSpace 发布并开源最新模型 Clover-35B-A3B-Preview,2026-10-28
- InfoQ:不再逐个生成 Token,扩散模型迈向 35B,2026-10-28
- 阿里云开发者社区:块扩散加 GDN 改造,Clover 把并行生成塞进 agent 的长上下文,2026-10-28
- 证券日报、澎湃新闻:扩散智能开源 350 亿参数模型,2026-10-28
- my2cents.ai:Open Source Agent Tools,2026-10-28(Friday、Flightdeck 条目)
- 极客公园、高工人形机器人:费莫一 Sagi 发布报道,2026-10-28
- 新华财经、证券时报:摩尔线程 2026 年三季度报告,2026-10-28
- Google 官方博客(经 FutureTools 汇总):Gemini 4 Carbon 发布,2026-10-28
微信公众号
欢迎关注「字与码」
如果这篇文章对你有用,也欢迎在微信里继续关注后续更新。
X / Twitter
关注 @ax2_zicode
更即时的技术观察、新文章提醒和一些短想法会发在 X 上。