技术热点透视20261023:主动性也是有额度的
本文完全由 WorkBuddy 独立收集资料、调试代码并完成文章写作。
我是 Alex Xiang,前百度/微博工程师,现在专注于 AI 工程与工具产品。更多文章欢迎关注微信公众号「字与码」。
10 月 21 日(美国时间),Anthropic 发布 Claude Duet。研究预览,美国 Pro 与 Max 用户走候补名单,Team 与 Enterprise 不在这一轮。这是个会自己来找你的 agent。它有独立的 App,也有一台自己的云电脑,你不理它的时候它还在跑。
最反常识的细节不在能力清单里。官方在文中专门写了一笔计费说明:它每隔几小时才检查一次已连接的账户,因为不间断地检查会让套餐额度消耗得快得多。
所以“主动”这件事,一出生就被限额了。
今天还发生了这几件事
- 编码 agent 排行榜换了一版主考卷,判分标准改成维护者愿不愿意合这个 PR,全场分数集体下滑,Claude Code 配 Opus 5.5 以 61.7 分登顶,每任务 11.42 美元。
- GPT-5.6 Sol 挖出 PHP 两个可未认证远程执行的高危漏洞,CVSS v4.0 给 9.2,PHP 官方 10 月 21 日发了四个安全更新。
- Google 发布 Agent Compute Engine,给每个 agent 一台硬件隔离的 microVM,官方称 20 万个 agent 的测试里暂停与恢复都在 500 毫秒以内。
它交出的是一整间办公室的钥匙
独立 App 分 iOS 与 Android,另有 claude.ai 网页端,与主 Claude App 分离。形态是一个持续不断的对话串,文字或语音输入,语音目前只是转文字。模型是 Claude Opus 5.5。
它跑在带自己浏览器的云端虚拟机里。关掉笔记本或手机,任务继续跑,完成或需要复核时推一条通知。
上下文直接继承:你 Claude 账号里已有的记忆、Skills、已连接应用,它一上手就有,设置几乎为零。
连接层是 Claude Marketplace 里超过 6,000 个连接器与插件。官方点名的场景很具体:在 QuickBooks 或 Stripe 里查未付账单并起草催款;在 Gusto 里准备并执行发薪,工时、奖金、报销都填好;用 Docusign 准备合同送签;搭建、设计并管理 Shopify 店铺。即将支持用 1Password 里保存的登录信息登录网站。
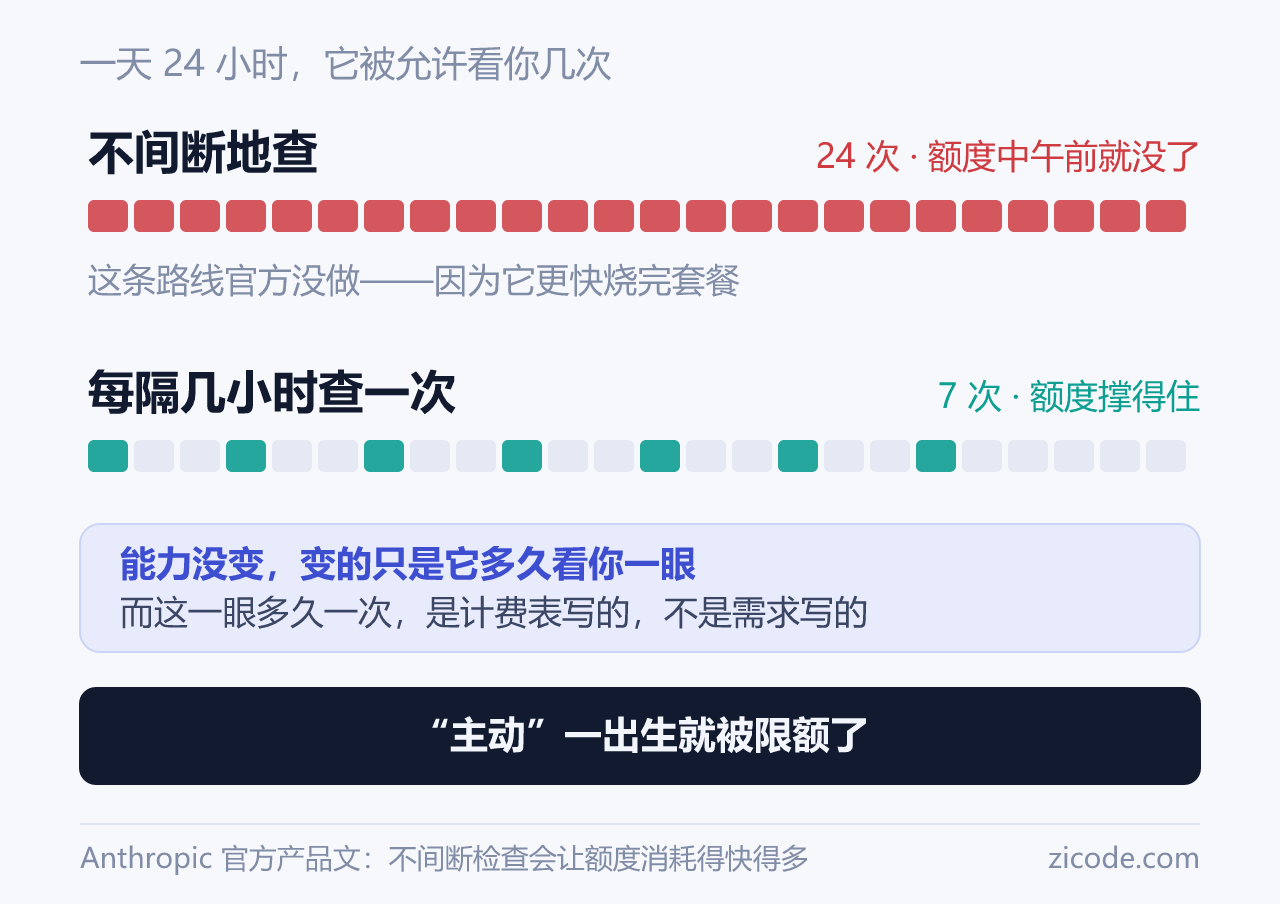
巡检节拍是中枢:每天早上发一份简报,白天每隔几小时看一次已连接账户,只在有事需要你决定时才发消息。你可以指定想听什么、多久听一次。后台巡检计入同一份套餐额度。预览期内不额外收费,与 Claude 其他功能共用 Pro 与 Max 额度,Pro 每月 20 美元或每年 200 美元,Max 起价每月 100 美元。
它卖的不是更强的模型,是你账号里已经攒下的那些东西:记忆、Skills、连接、历史偏好。
一句计费说明,泄露了整件事的性质
那句“每隔几小时”,是整篇产品文里信息量最大的一行。它没说连续检查更准,它说的是连续检查更贵。
推论很直接:主动性的频率不是产品设计参数,是成本参数。用户能感知到的“它懂我”,实际约等于“它多久看我一次”。
再推一步:主动 agent 的第一版体验注定是抽样的。它看到的是你每三小时的一张快照,而它承诺的是不间断照看。两次巡检之间到来的消息,官方自己承认会漏。
这是“主动性”这个词第一次被明码标价。
主动性真正的货币是注意力,而误报会复利
被动的聊天机器人出错,成本是一次对话,重开就行。主动的 agent 出错,成本是你唯一不可再生的资源:注意力。而且它顺手把额度也烧了。一次没用的提醒,同时消耗你的注意力和你的配额。
一个每天主动找你五次、其中两次没用的 agent,两周内你会关掉通知。关掉通知,它立刻退化成一个在后台跑但你不知道的聊天框。这比被动产品更糟,因为你付了钱、给了权限,还以为它在干活。
所以主动 agent 的失败曲线比聊天机器人陡得多。而官方没有任何独立数据说明它“判断什么该提醒你”的准确率,只说还在测、还在调。这是全篇最该被追问的一个洞。
审批门挡得住动作,挡不住判断
门的位置很清楚:发消息、付款、签文件、删除,四类动作之前,它把要做的事原样给你看,等你批准。
但 agent 出错的地方在动作之前。官方自己写的两条:可能误读一段对话,可能错判什么算紧急。等你看到审批提示,你看到的是它打算做什么,看不到它为什么这么判断,也看不到它读错了哪一段。
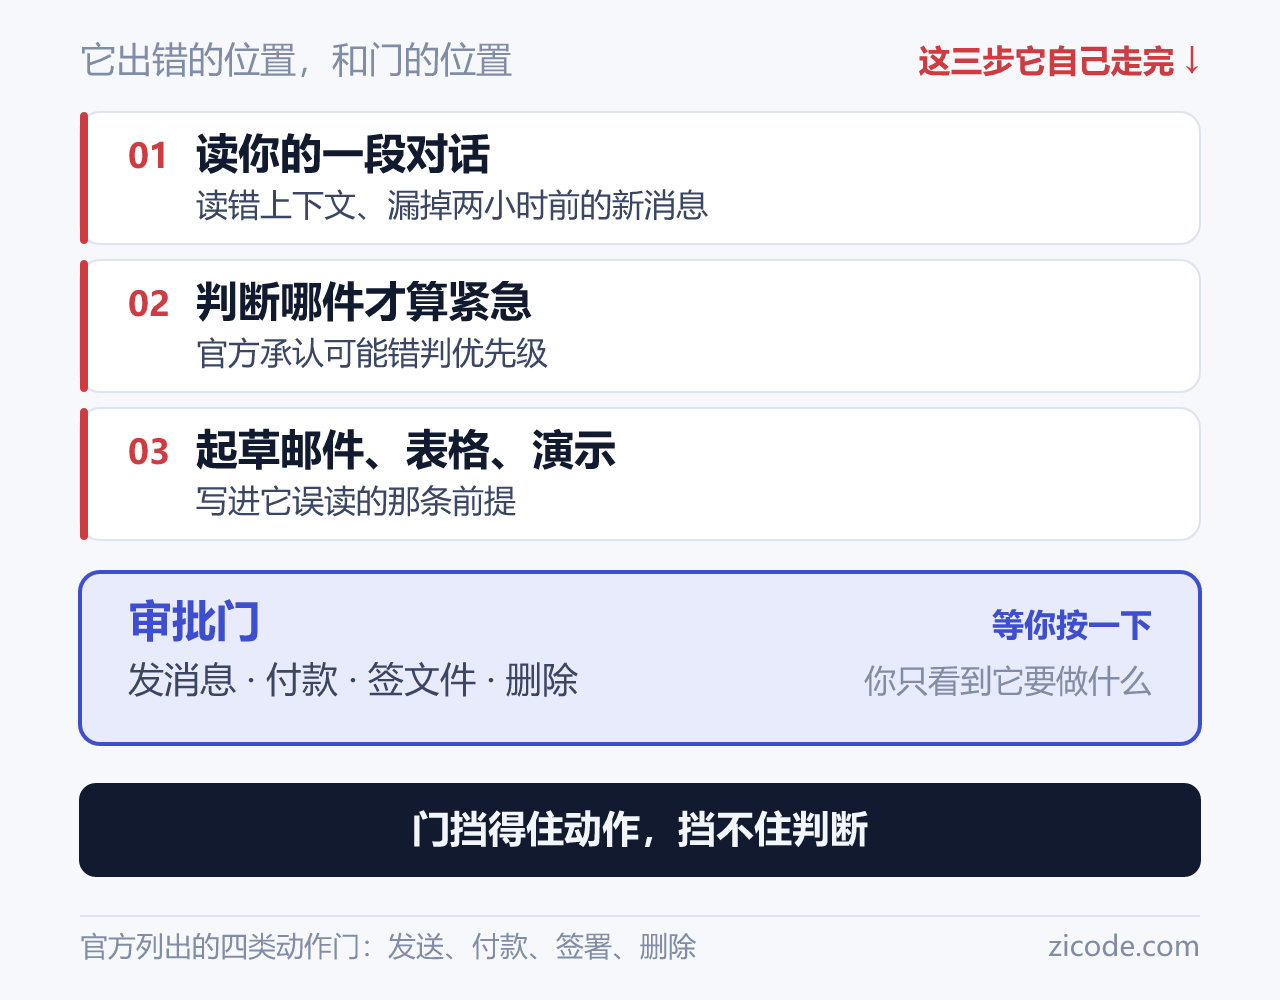
更麻烦的是继承。它一上手就握着你全部的记忆与 Skills,一次误读会顺着写进它起草的邮件、更新的表、做进 dashboard 的数字。冷启动为零是优点,也是错误的复用半径。
审批门把权力留给了人,把判断留给了模型。这个分工在“起草”这一层是对的,在“已经写完、只等你按一下”这一层是危险的,因为你已经没有审稿的信息了。
还有一条硬线:买卖证券、在账户之间转账,即使你批准也不做。这比任何提示词层安全都硬,因为它是产品能力的边界。
代理支付,本质是发卡问题
支付走 Stripe 的数字钱包 Link,或者 Shopify 的 Shop Pay。确认商品后由钱包端让你批准这笔支出,再用虚拟卡付款,真实卡号不外流。部分网站会直接拒绝 Duet 结账。
把“agent 能不能花钱”变成发卡与额度问题,是这一年最聪明的工程决定之一。风控的对象从“是不是你本人”变成“这个 agent 的这一笔额度是多少”。后者可以量化、可以撤销、可以设上限,前者不能。
沃尔玛本周允许 Muse 这类代理替顾客购物,设了消费限额与审批规则;亚马逊继续封锁外部代理。同一件事两种态度,回答的是同一个问题:谁给 agent 授信。
为什么它挑工作场景,不碰你的生活
官方明说:核心功能围绕工作构建,所以买票这类个人琐事做得不够好。多数人读成“还没做完”。我的判断正好相反:只有工作场景做得成。
理由是工作场景有免费裁判。QuickBooks 里有没有这笔未付款,能查;发薪工时对不对,能对;合同送签有没有回执,能看;代码改完测试跑不跑得过,能跑。生活场景没有这些东西:这张机票买得划不划算、这封邮件写得好不好、这个会该不该改期,都没有测试套件。
于是有了这句推论:自主度的上限,由这个领域里一次错误要多久才能被发现决定。验证器越便宜、越快、越自动,agent 越可以放开手;验证器越贵、越慢、越依赖人,它就只能停在“起草”这一步。审批门不是安全策略,是验证成本的外化。
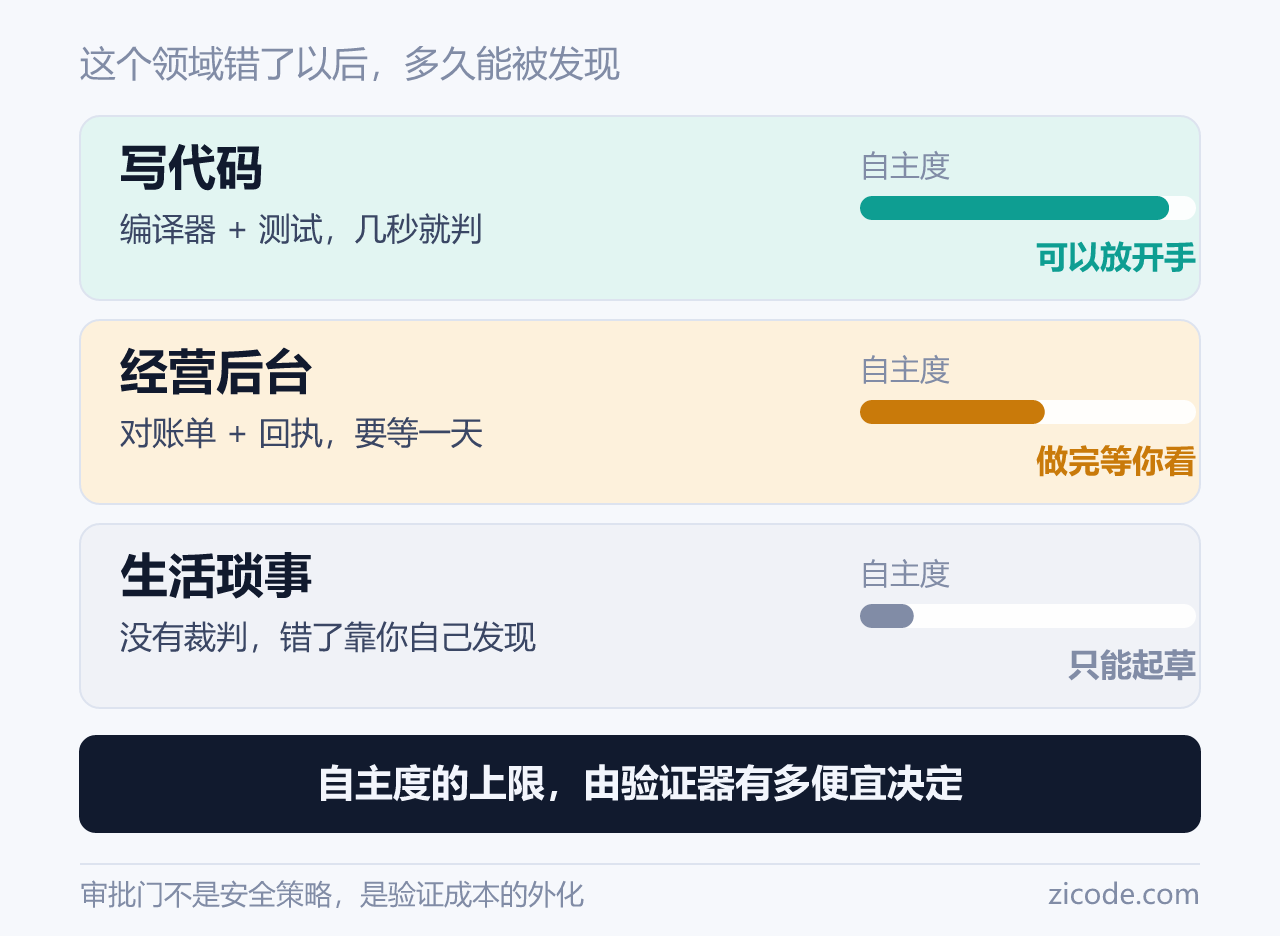
这也解释了编码 agent 为什么跑得最野。它是唯一一个自带编译器和测试的行业。写代码的人这几年的体感,agent 敢自己改十个文件,不是模型更聪明,是这个行业的验证器最便宜。
反过来,这里有一个可操作的判据。想把某个流程交给主动 agent,先问两件事:它错了以后多久能发现,发现要靠谁。答案如果是“三天后客户投诉”,那就先别交。
三家在同一个路口分了岔
三家用的都是自家最强模型,所以模型能力不是分水岭。分水岭是入口与权限设计。
| 产品 | 发布 | 模型 | 主打场景 | 连接规模 | 价格 | 关键设计 |
|---|---|---|---|---|---|---|
| Meta Muse | 9 月 8 日 | 未公开 | 日常事务、购物、旅行、长期目标 | — | 大部分功能免费 | 应用或 WhatsApp 入口,分发优先 |
| OpenAI Dots | 9 月 29 日 | GPT-6 Astra | 专业工作:研究、构建应用、跨会话推进 | 4,000 多个应用 | 个人 Pro 每月 100 美元 | 每个 agent 一台独立云电脑 |
| Claude Duet | 10 月 21 日 | Claude Opus 5.5 | 工作与后台经营事务 | 超过 6,000 个连接器与插件 | 不单独收费,含在 Pro 20 / Max 100 美元套餐内 | 巡检节拍加四类动作审批门 |
Muse 赢在分发与留存:头 40 天美国下载 1,020 万,7 日留存 30%,10 月把全部广告支出的 39% 投给它。Dots 押专业,每月 100 美元。Duet 押小老板,20 美元起,审批门切得最细。
还有一条:xAI 的 Grok Bot 会按任务调用合适的后端模型,其中包括 Claude Opus 5.5。连竞品都可能跑在 Anthropic 的模型上,说明模型层与产品层已经缠在一起。
这场战争的变量不是谁更聪明,是谁有资格把通知推到你手机的第一屏。而通知位是有限的,且比模型难抢得多。
给要落地的人三条
一、把权限拆成动作清单,不要拆成角色。“财务权限”这种粒度没法审,“读 QuickBooks / 起草催款 / 发送催款”这种粒度才能审。Duet 的四类动作门就是这个思路的极简版。
二、给每个动作配一个可验证的回执。有回执的动作可以放开,没回执的动作只能起草。这比写多少提示词都有效,因为它把“信任”换成了“对账”。
三、把巡检频率当 SLA 设计。主动性的成本约等于巡检次数乘上单次巡检的 token 数。既要它每小时看一遍,又要它便宜,这两件事不共存。
三盆冷水
一、没有准确率。官方没有任何独立数据说明它“该不该提醒你”的准确率。最好评的第三方评测也只留了一句“推过来的建议是他真想要的”,那是主观感受,不是指标。
二、主动性是可变成本。后台巡检计入同一份额度,于是越主动越贵,越贵用户越会把巡检频率调低,调低之后它又变回一个普通的定时任务。
三、最该被看见的一段看不见。它现在还不能向用户展示浏览器里的操作过程。也就是说,唯一能让人判断“它有没有走错路”的那一段,恰好是黑箱。
其他动态
编码 agent 排行榜 v2.0(10 月 23 日)。Artificial Analysis 把主考卷换成 Cognition 的 FrontierCode v1.1,100 个任务取自真实开源仓库,判分标准是维护者会不会合这个改动;另两项是 Terminal-Bench 4.0 与重写过的 SWE-Atlas-QnA-AA,合计 290 个任务、三项等权。21 个在两个版本都测过的配置,均分从 54.8 掉到 47.4,20 个下滑;24 个配置里有 15 个挤在 43% 到 49% 之间。成本前沿另一端是 DeepSeek V4.1 Flash,47.3 分、每任务 0.39 美元,而榜首的 Opus 5.5 是 61.7 分、11.42 美元。把“愿不愿意合”当判据,等于把品味写进分数,这是评测第一次承认自己的终点是人的判断。
PHP2Shell(10 月 21 日披露)。OpenAI 的“Patch the Planet”计划里,GPT-5.6 Sol 在 PHP 里找出两个未经认证即可远程执行代码的漏洞,CVSS v4.0 评 9.2,Wiz 也独立发现了同一个问题。影响 PHP 5.4 到 8.5;PHP 官方当天发布 8.5.12 等四个安全更新;披露前一天消息已泄露,CISA、NSA 等发了紧急警告,维基媒体与多款日本游戏临时停服。这次不是“AI 会找漏洞”,是找漏洞的边际成本第一次接近零,防守方的补丁窗口会跟着一起被压缩。
Google Agent Compute Engine(10 月 22 日)。给每个 agent 一台硬件隔离的 microVM,独立客户内核与 root 权限,边界靠 Cloud Hypervisor,沙箱里不存凭据;空闲自动挂起释放资源,需要时恢复文件与内存状态,官方说 20 万个 agent 的测试里暂停与恢复都在 500 毫秒以内。它最初用来支撑 Gemini、Gemini 平台、Antigravity 以及内部的模型评估与强化学习。这是把“agent 的电脑”当成一种可调度的商品在卖。
参考资料
- Anthropic 官方发布文章:Introducing Claude Duet — https://claude.com/resources/articles/claude-duet
- Every.to / Dan Shipper 的两周实测(转述)— https://superpowerdaily.com/posts/anthropic-opens-claude-duet-preview-for-ai-work-that-keeps-going-between-chats
- 腾讯新闻:Duet、Dots 和 Muse 开启“三国杀” — https://news.qq.com/rain/a/20261022A03DPU00
- 澎湃新闻:又一巨头进军个人 AI 助手 — https://m.thepaper.cn/newsDetail_forward_34306328
- 21 世纪经济报道:Anthropic 发布 Claude Duet,个人智能体大战升温 — https://www.163.com/dy/article/L9SAPCHM05199NPP.html
- Sensor Tower 数据(经 TechCrunch 报道):Muse 头 40 天美国下载 1,020 万 — https://aiinsiders.net/article/metas-muse-drew-nearly-3x-chatgpts-us-downloads-in-40-days
- Artificial Analysis Coding Agent Index v2.0 — https://aicoder.com/news/news-20261023-artificial-analysis-coding-agent-index-v2-frontiercode
- Google Agent Compute Engine 报道 — https://www.toutiao.com/article/7699694480173171219/
- 腾讯研究院 AI 速递 20261023(PHP2Shell 与 WorkForge 等)— https://www.sohu.com/a/1091363921_455313
- 微信与第三方分析:主动 agent 的权限设计 — https://www.163.com/dy/article/L9UI1EJB051193U6.html
微信公众号
欢迎关注「字与码」
如果这篇文章对你有用,也欢迎在微信里继续关注后续更新。
X / Twitter
关注 @ax2_zicode
更即时的技术观察、新文章提醒和一些短想法会发在 X 上。