GPT-Image-2.6 原生输出 GIF 与 SVG:一张证件照变成 12 款卡通表情包
本文完全由 WorkBuddy 独立收集资料、调试代码并完成文章写作。
我是 Alex Xiang,前百度/微博工程师,现在专注于 AI 工程与工具产品。更多文章欢迎关注微信公众号「字与码」。
上周 OpenAI 发布 Images 2.6 时,最容易被忽略的一行是:GIF 和 SVG 成了模型的原生输出格式。不是外挂转码工具,也不是「先出图再让人拼」,而是 output_format 里直接多两个取值。我拿一张普通证件照跑了一遍完整链路:换成休闲装卡通矢量、以同一张 SVG 为底版生成 12 款夸张表情动图、逐帧加中文文案,最后得到能直接发微信的表情包。整个过程没用视频模型,也没用任何在线动图工具。
一手资料:OpenAI 官方发布页 · 官方图像生成 API 文档
先把模型名字和能力边界说清楚
这次发布的是 Images 2.6 / GPT-Image-2.6(2026 年 11 月 4 日),API 里分两档:gpt-image-2.6-flare 偏快、gpt-image-2.6-sunburst 偏细。GIF 和 SVG 都是这一版新增的原生能力,但两者的生成机制完全不同。
GIF 是服务端排好帧直接返回完整 GIF89a,帧数、每帧时长、尺寸都在请求里控制,还带 NETSCAPE 无限循环标志。我实测 8 帧 × 150ms 得到 1.2 秒循环,delay 与请求值精确一致,不用自己拼帧。
SVG 则是两阶段:图像模型先出一张参考栅格图,再由撰写模型 gpt-6.1-sol 把它写成矢量代码,所以双重计费、明显更慢——这次卡通肖像花了 93 秒,而单个 GIF 只要 12–44 秒。代价换来的是一份 4.8 KB、26 条 path 的纯静态 XML:没有脚本、没有外链、没有内嵌位图,中文还是真正的 <text> 元素而非描成路径,可搜索、可程序化改写。
文档写「不支持」的四处,实测都能用
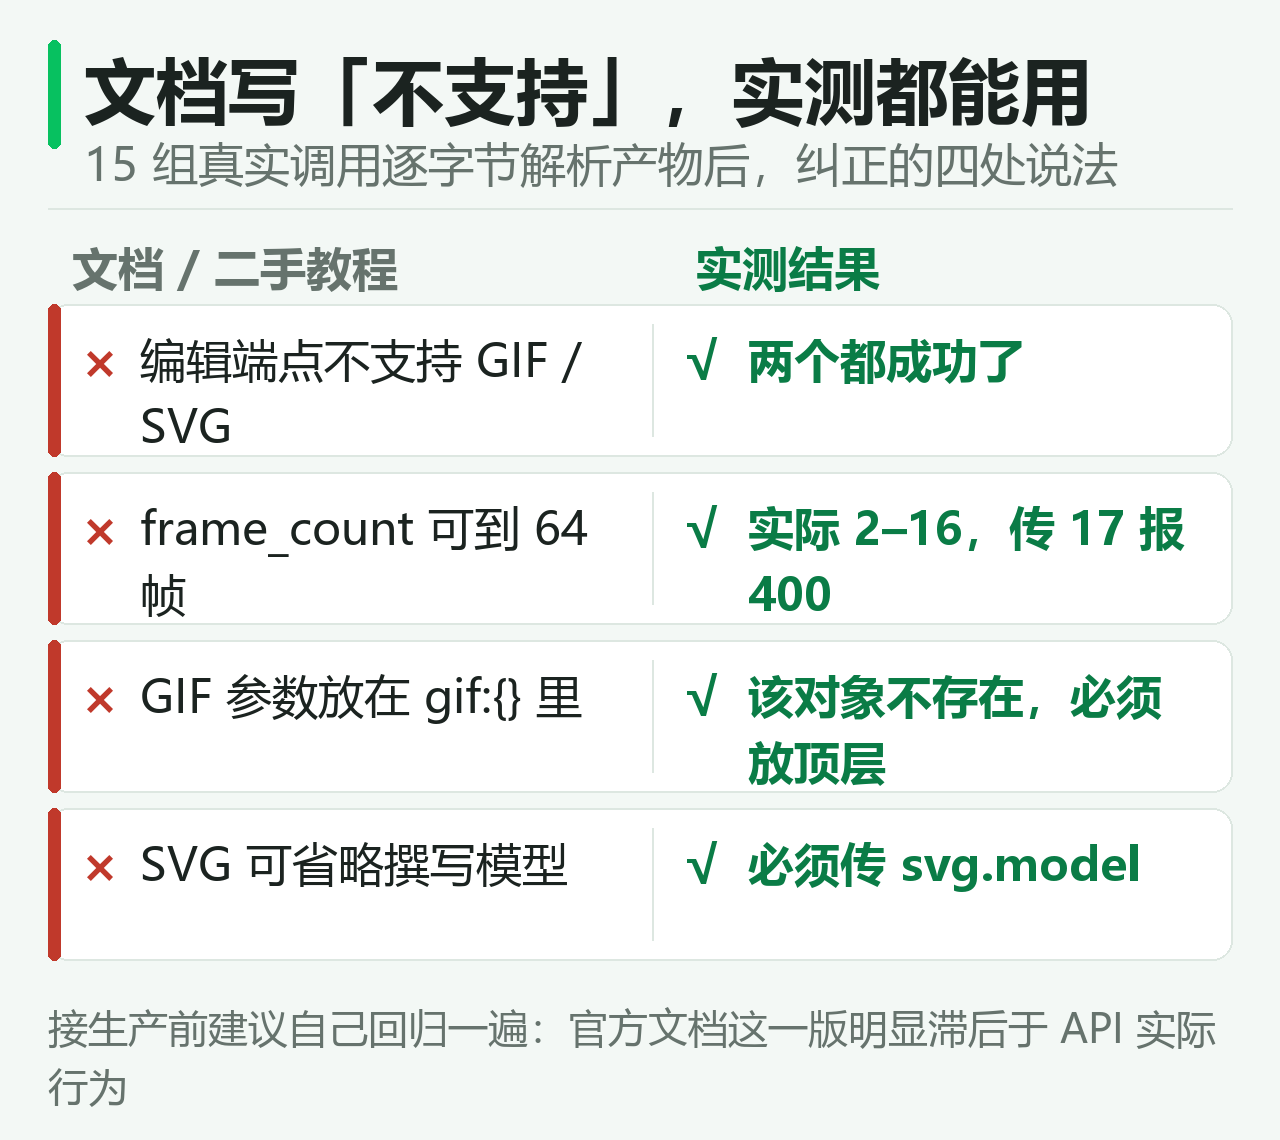
二手教程在参数范围上互相矛盾,我用 15 组真实调用逐字节解析产物,纠正了几处流传很广的说法。
| 常见说法 | 实测结果 |
|---|---|
| 编辑端点不支持 GIF / SVG | /v1/images/edits 两个都成功了,能把自己的图变成动图或矢量图 |
frame_count 可到 64 帧 | 实际 2–16,传 17 直接 400 |
GIF 参数放在 gif:{} 对象里 | 该对象根本不存在,参数必须放顶层 |
| SVG 可省略撰写模型 | 必须传 svg.model,不传报 400 |
SVG 的 n 可以大于 1 | 只能为 1 |
最值钱的是第一行。官方文档和多篇二手文章都写「edits 端点不能输出 GIF/SVG」,但我用自己的 PNG 作输入,成功产出了 6 帧动图和一张带渐变、clipPath 的矢量图。这条路径一通,「把已有的 LOGO、角色、产品图变成动图或矢量」才成立,不必只能从文字凭空生成。文档明显滞后于 API 实际行为,接生产前建议自己回归一遍。
另外 frame_duration_ms 只校验下限 20,传 10000 也能成功(20 秒循环),别被「上限 2000」的说法限制住。
一张证件照改了三代,最后选了夸张
第一版把黑西装、白衬衫、领带全换成鼠尾草绿圆领卫衣,身份特征保留得不错,但把原照片的痣点如实画进了矢量图,嘴偏宽厚,头发还画成了浓密尖刺头。第二版按「去斑点、小嘴、少发、更简洁」重做,26 条 path、4.9 KB,比例更贴本人,代价是头发稀疏到接近秃顶、眉毛细到几乎没有存在感。
原始证件照涉及本人隐私,文中不展示,只留一个占位框和文字说明:白底、正面免冠、黑西装白衬衫领带、短黑发。它只以文字描述的形式进入提示词,不出现在任何一张配图里。
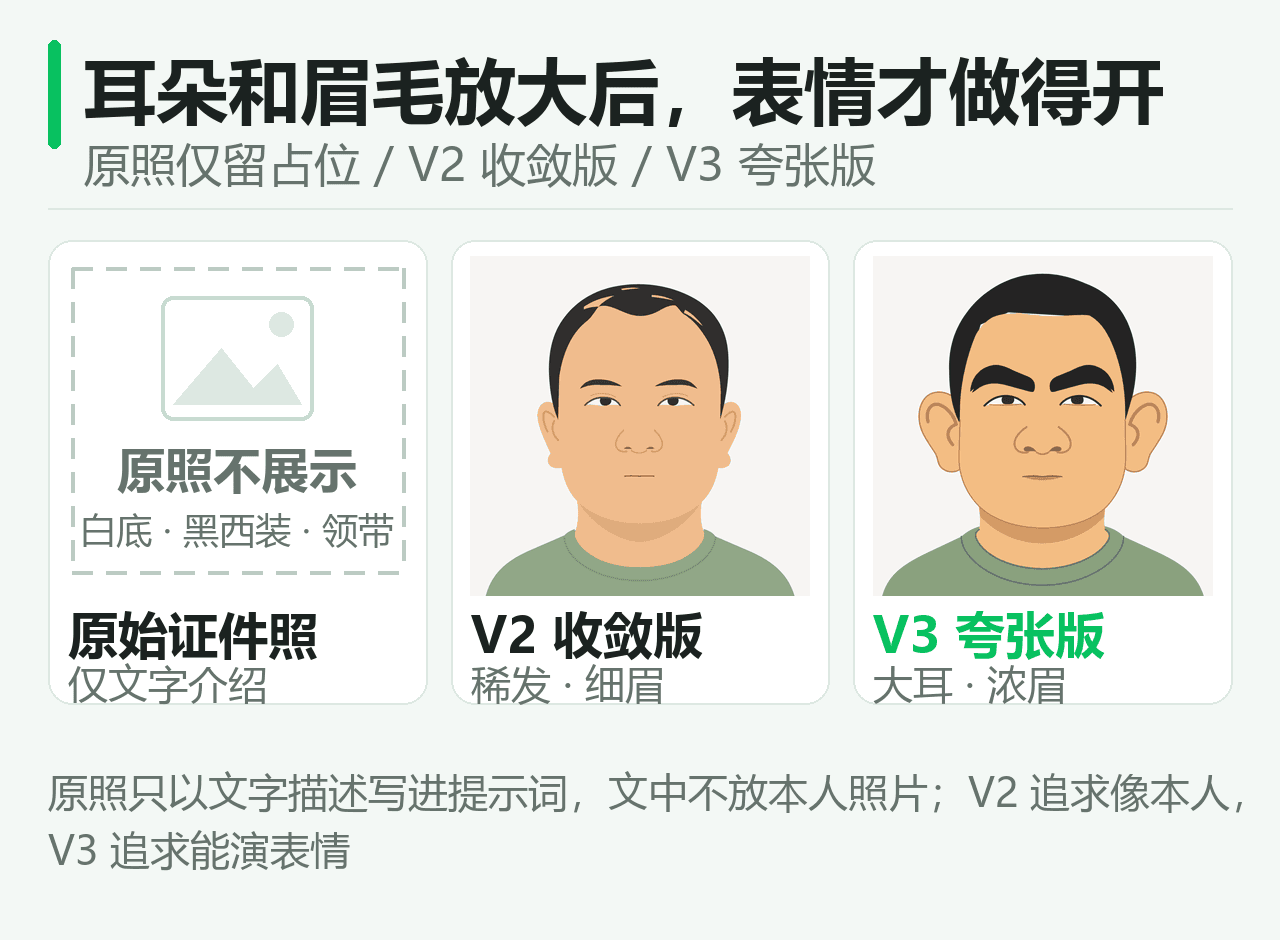
第三版换了方向:把耳朵放大到约 1.3 倍、明显向外支起;眉毛加粗到约 2 倍,做成两块压住上半张脸的浓黑实心形;头发恢复成满头整齐短黑发、自然圆润发际线,明确禁止 bald / thinning / receding / visible scalp,同时仍不许尖刺蓬松。皮肤干净、小嘴、极简几何、绿卫衣全部保留。
这里有个反直觉的判断:相似度靠比例和特征位置,不靠细节堆砌;但要做表情包,「更像本人」和「更能演」是两件事。收敛写实的细眉小耳,在 512×512 的动图里几乎看不见形变;大耳浓眉一旦成为识别锚点,就算嘴张成 O、眼睛挤成缝,读者仍然认得出是同一个人。夸张不是为了好看,是为了给动画留出形变余量。
整条链路只调了两次模型
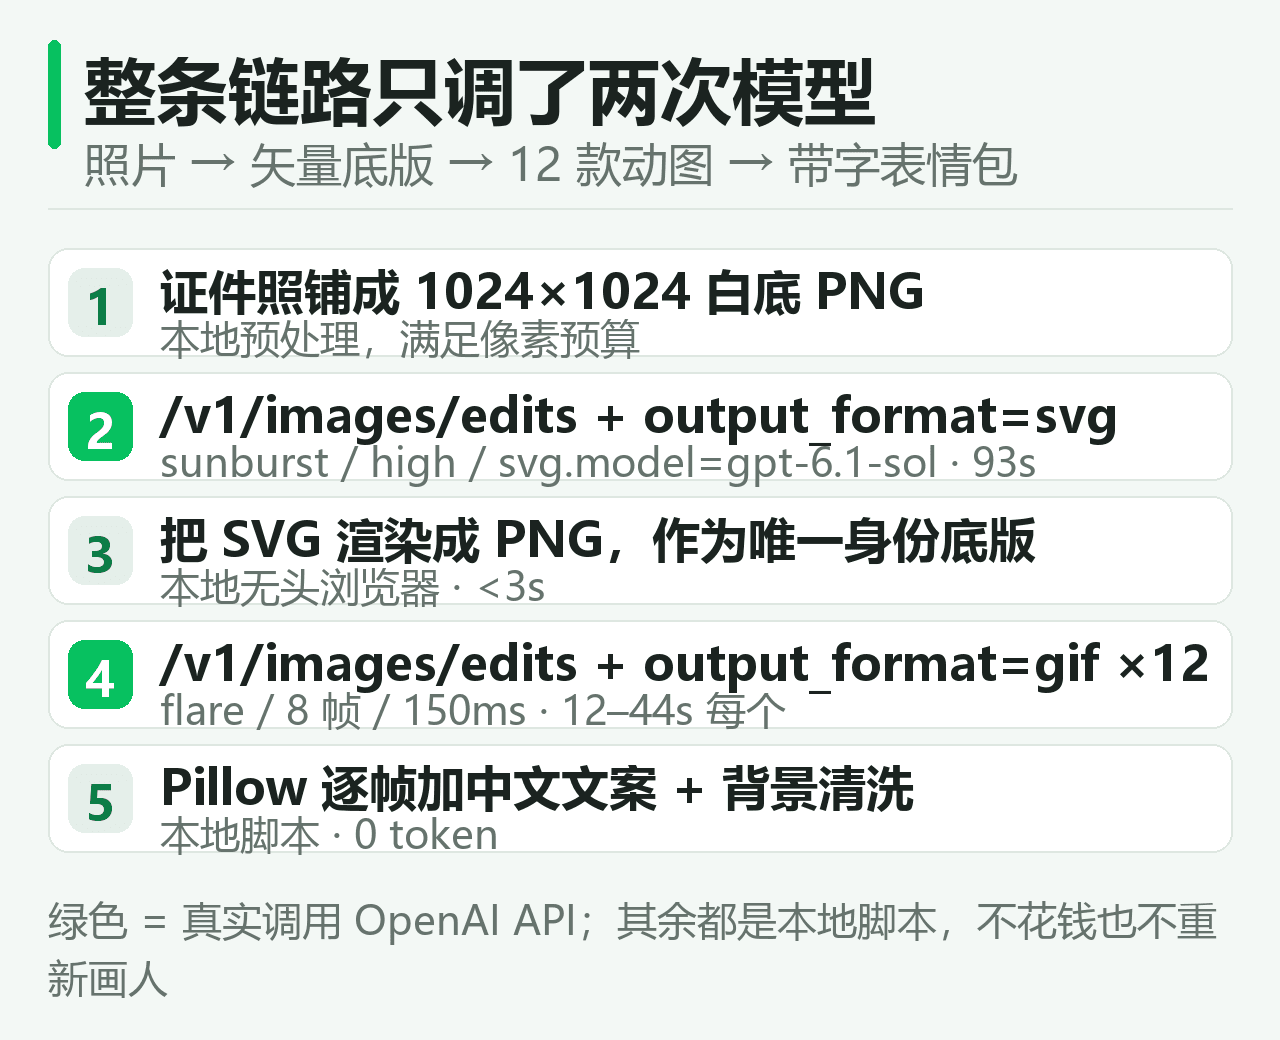
| 环节 | 模型 / 参数 | 耗时 | 产物 |
|---|---|---|---|
| 证件照 → 卡通 SVG | sunburst · quality=high · svg.model=gpt-6.1-sol | 93s | 4.8 KB SVG,26 path / 9 个分组 |
| SVG → PNG 底版 | 本地无头浏览器渲染 1024×1024 | <3s | 唯一身份底版 |
| 底版 → 表情动图 ×12 | flare · frame_count=8 · frame_duration_ms=150 · quality=medium | 12–44s / 个 | 12 个 GIF,8 帧循环 |
| 清洗背景 + 逐帧加字 | 本地 Pillow,不调用模型 | <20s | 12 个带字表情包 |
一致性的关键不是「写 12 段更好的提示词」,而是只渲染一张底版:把 SVG 转成 PNG 后,12 次调用全部以这张图为输入,共用同一段身份锁前缀(脸型、满发、大耳、浓眉、细长眼、宽鼻、肤色、小嘴、无斑点、绿卫衣、正面机位、近白背景),再各接一句表情描述。所以 12 个动图是同一个人在做 12 种表情,不是 12 个长得像的人。
最小可运行调用长这样,只留关键行:
files = {"image": open("cartoon_base.png", "rb")}
data = {
    "model": "gpt-image-2.6-flare",
    "prompt": IDENT_LOCK + "a huge hearty laugh ...",
    "output_format": "gif",
    "frame_count": 8,
    "frame_duration_ms": 150,
    "quality": "medium",
}
r = requests.post("https://api.openai.com/v1/images/edits",
                  headers={"Authorization": "Bearer " + KEY},
                  files=files, data=data)
open("laugh.gif", "wb").write(base64.b64decode(r.json()["data"][0]["b64_json"]))
注意 GIF 参数全部在顶层,svg[model] 这种嵌套写法只用于 SVG 请求。
表情夸张靠放开形变,不靠换提示词
V2 的 12 个表情其实已经齐全,但幅度克制:「惊讶」只是眉毛微抬,「大笑」嘴只张开一点,总览图里 12 张看起来像同一张脸。V3 做了两处改动。
一是身份锁里明确放开五官形变:浓眉可以高飞、紧锁或一高一低,眼睛可以瞪圆或完全挤闭,中性小嘴允许张大成 O 或咧成大笑,头部允许明显倾斜和点动;同时锁死发型、服装、背景不许变。二是每条表情描述都写成可量化的大动作,并要求「neutral → peak 的变化一眼可辨」。
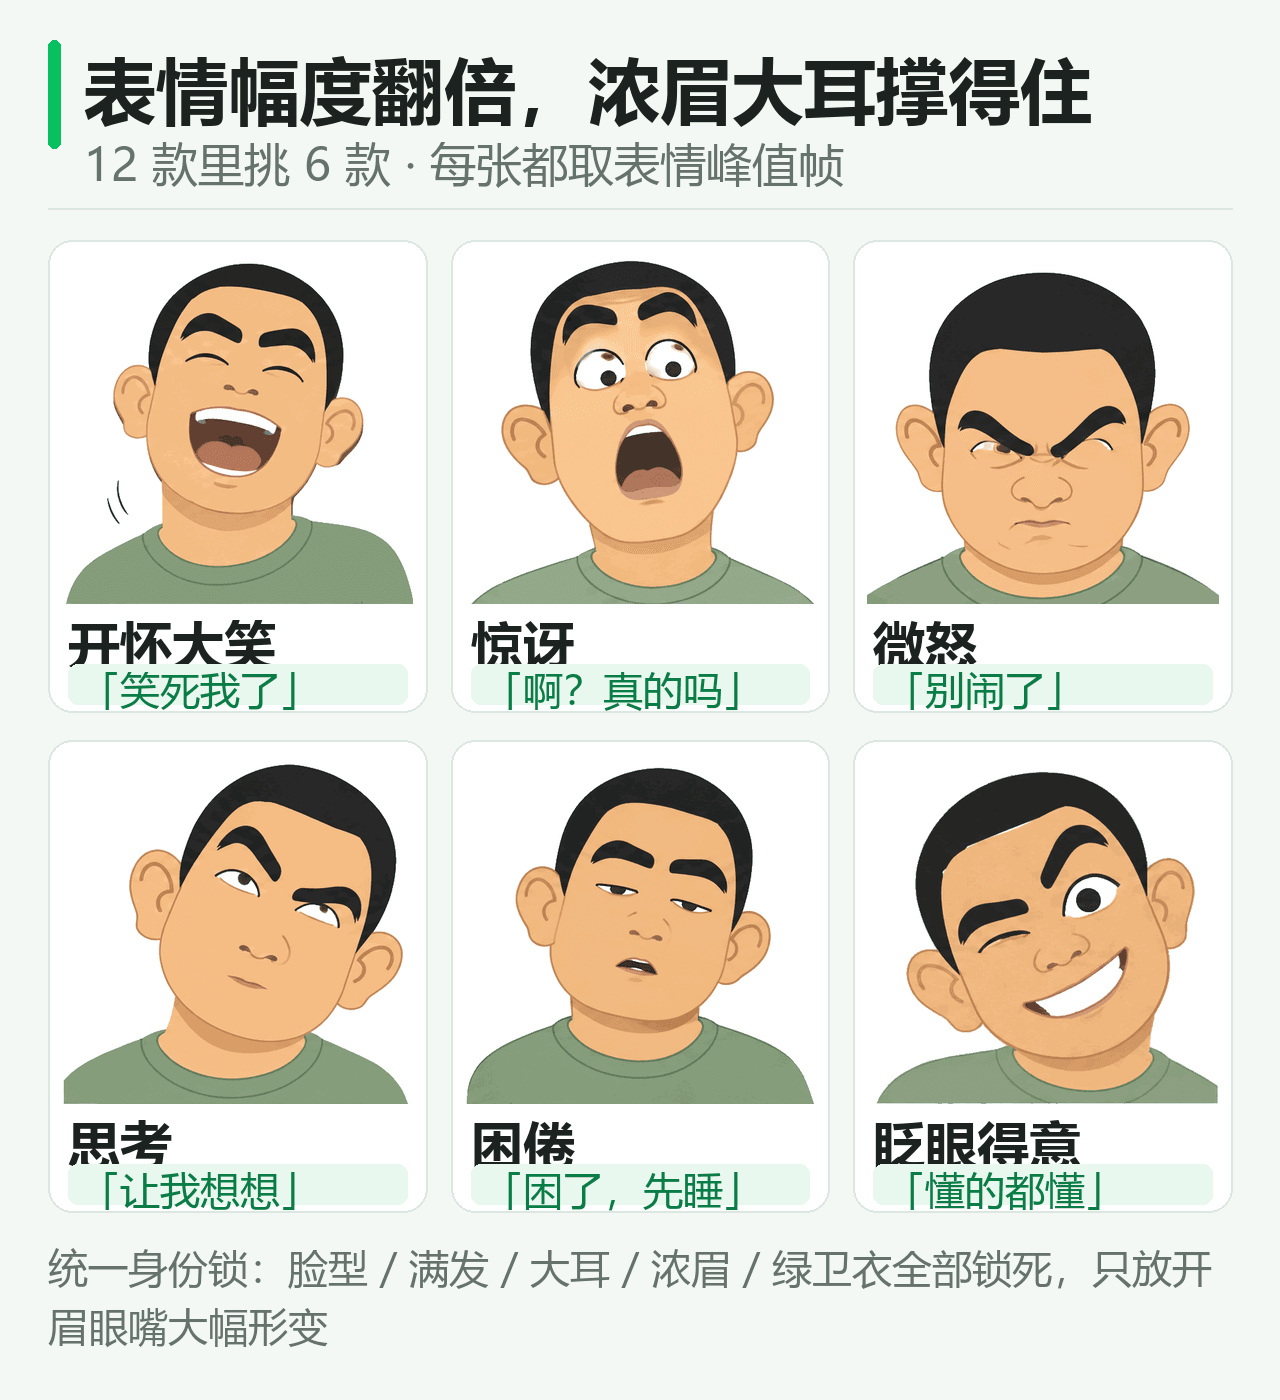
结果 12 款分别是开心微笑、开怀大笑、眨眼得意、惊讶、思考、疑惑、困倦、微怒、腼腆、无语、委屈、点头赞同,统一 8 帧 × 150ms、512×512、无限循环。逐张抽帧目检过:大笑张嘴仰头、惊讶浓眉高飞眼睛瞪圆、微怒眉头紧锁下压、委屈眉心高抬嘴角下撇,同一个人、同样的绿卫衣,没有串脸或崩坏。
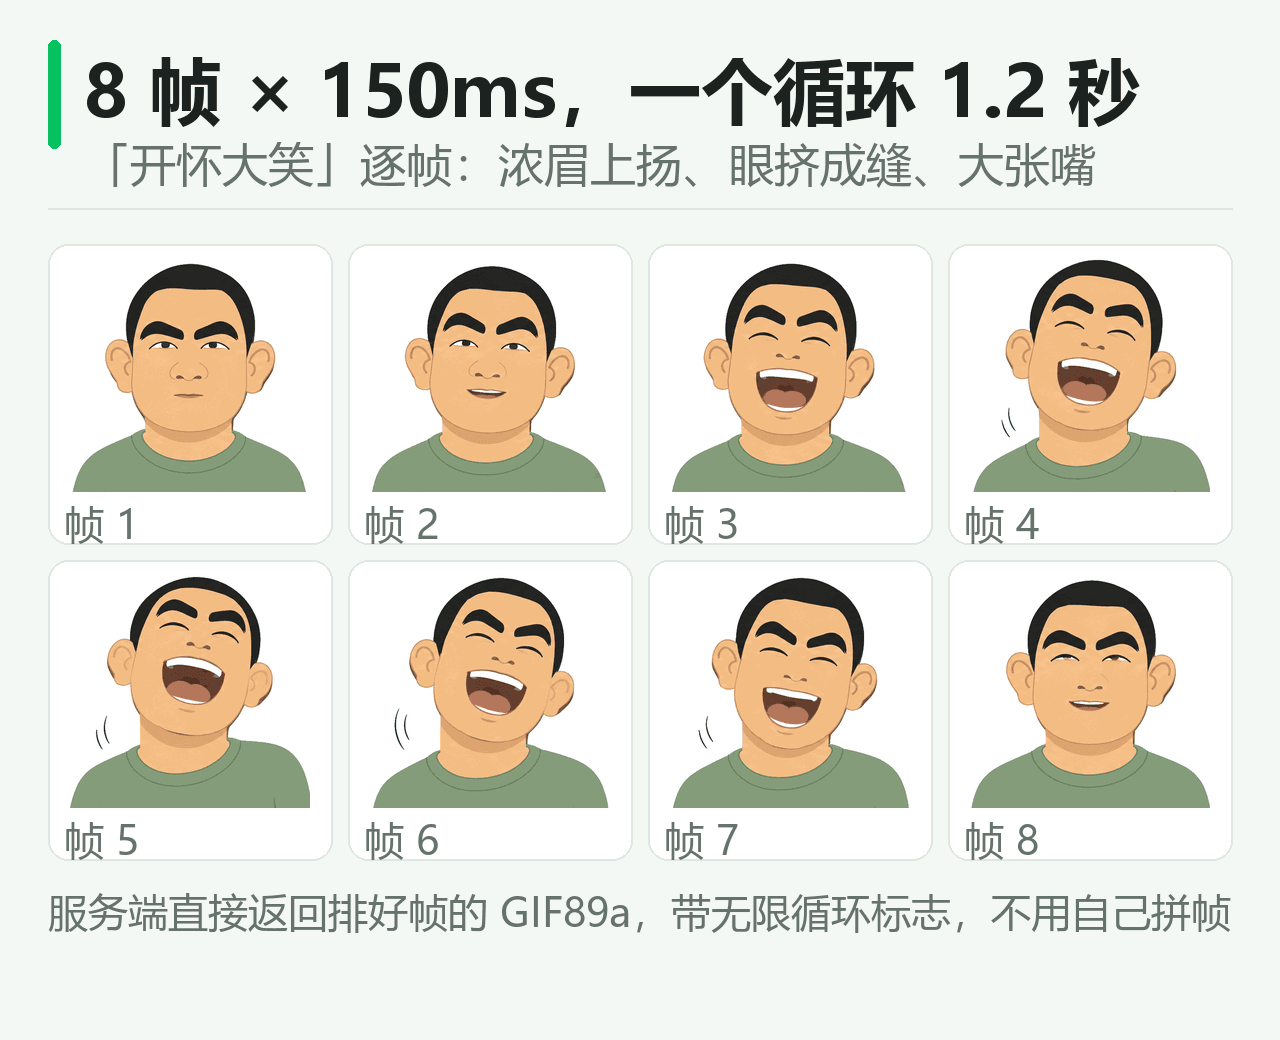
中文文案是本地加的:给每个 GIF 的每一帧叠 92px 白条,微软雅黑粗体 46px 居中,统一 256 色调色板避免帧间闪烁,loop=0 保持不变。这一步零 API 调用、零 token,「笑死我了」「懂的都懂」「让我想想」「……无话可说」这类聊天文案可以直接换成任何一套。
SVG 是一份能改的素材
模型给 SVG 打了语义化分组 id,这次拿到 9 个:sweatshirt、neck、ears、hair、face、brows、eyes、nose、mouth。这件事的价值比「矢量不糊」大得多。
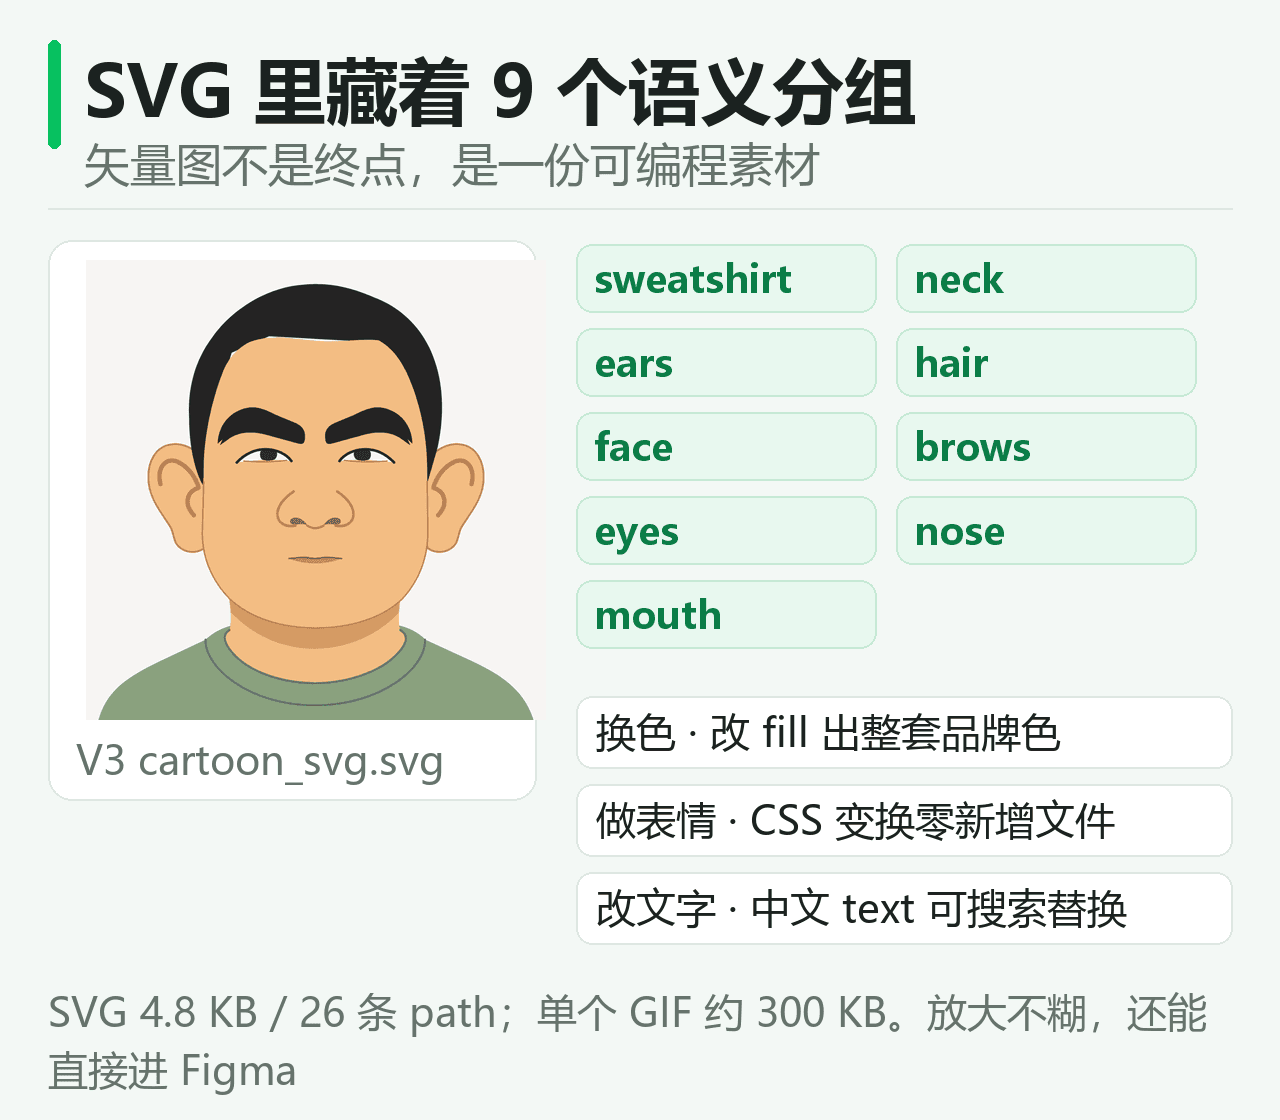
- 换色:直接改
.sweatshirt的fill,一次生成出整套品牌色、深浅色图标,不用重新调模型。 - 做表情:CSS 压扁
eyes就是眯眼、上移brows就是惊讶、缩放mouth就是张口或抿嘴。12 种表情在代码层切换,零新增文件、无损缩放,还能绑到加载中/成功/报错这些业务状态上。 - 改文字:中文是
<text>元素(带思源黑体/微软雅黑回退),可搜索、可批量替换,做徽章、封面、多语言版本都是脚本活。
体积对比很直观:SVG 4.8 KB,单个 GIF 约 300 KB。真实情绪表演是 AI 动图更自然,状态联动和批量素材是矢量更合适,两者互补而不是替代。
最后一公里还是本地脚本
生成模型没有把工程问题一起解决。头部轻微侧移时,模型会在背景留下浅灰晕、不规则白块,甚至偏肤色的残影——「思考」那张最重,边缘脏像素一度到 25.9%。这类残影是近中性亮色,而肤色明显偏橙(红蓝通道差约 100),所以清洗判据定成「三通道极差 < 20 且最暗通道 > 165 就刷白」,只清背景、不碰人物;再从 raw/ 里的原始 GIF 幂等重清洗,统一 256 色调色板重编码,保留每帧时长与无限循环。偏肤色那张清不掉,追加「每帧背景必须完全一致、不得有任何光晕或残影」的约束单独重生成一次才彻底干净。
这提醒了一件很实际的事:把模型接进生产流程,最后通常还是要有传统图像处理兜底,以及一套可复跑的清洗脚本。
能拿去用的三个场景
表情包与角色资产:一张立绘出一个角色的三态资产——SVG 做图标与换色、PNG 做参考图、GIF 做表情与分镜,同一模型家族、同一套描述,一致性比跨工具拼凑好。短剧或视频项目也可以先用 8 帧 GIF 验证角色动作,再投贵的视频生成。
状态联动的数字人:把语义分组接进组件,用 CSS 变换做加载中、成功、报错,不新增文件、不花 token,尺寸任意缩放。
技术文章配图:内联 SVG 天然满足「移动端不糊、字号可调、离线可开」,比把 1080 宽、14px 字的 PNG 塞进手机正文清楚得多。
两点提醒
一是成本结构:SVG 走两阶段双计费,93 秒、3731 tokens;单个 GIF 约 12–44 秒、2440 tokens。批量做表情包前先算好账,SVG 只做一次底版最划算。二是这次把 API key 明文贴在对话里做测试,用完应当去控制台轮换一次;另外调 api.openai.com 时环境自带代理会返回 502、本机 DNS 也被污染,最后走本机 127.0.0.1:1080 才通,后续沿用这条路径。
参考资料
- OpenAI 官方发布页:https://openai.com/index/introducing-images-2-6/
- OpenAI 图像生成 API 文档:https://developers.openai.com/api/docs/guides/image-generation
- 本文全部实测产物与可复跑脚本:
image26-lab/portrait/v3/(12 个纯净动图、12 个带字表情包、可编辑 SVG)、image26-lab/portrait_pipeline.py、image26-lab/build_showcase.py
微信公众号
欢迎关注「字与码」
如果这篇文章对你有用,也欢迎在微信里继续关注后续更新。
X / Twitter
关注 @ax2_zicode
更即时的技术观察、新文章提醒和一些短想法会发在 X 上。