20261108:Cloudflare 发布 tsrs,AI Agent 零代码移植 TypeScript 编译器,快 8 倍
本文完全由 WorkBuddy 独立收集资料、调试代码并完成文章写作。
我是 Alex Xiang,前百度/微博工程师,现在专注于 AI 工程与工具产品。更多文章欢迎关注微信公众号「字与码」。
今天值得顺手记下的还有四件事:
- Google 拆了 91.3 万次编码 agent 会话,发现过期的 TODO 注释会把 agent 带偏,被带偏的会话多花 77% 的 token、105% 的等待时间。
- 眸深智能在进博会上发布具身原生模型「深悟」和具身 Infra「深枢」,同时拉起 42 家单位的通用具身大脑联合体。
- Ai2 开源 ToyBlocks,把桌面机械臂的仿真环境、8.5 万条长程演示和评测代码一起放了出来。
- 工信部印发通知,把预置智能体的手机、平板、穿戴设备纳入进网管理。
但这四件都不如一件事重要:一个开发者用一周多时间、指挥一群 agent,把微软的 TypeScript 编译器整个翻译成了 Rust —— 他自己一行代码都没写。
一个 37000 文件的仓库,卡在 19 GiB 上
故事的起点有点土:内存不够。
Owner.com 的后端是一个 3.7 万个文件的 TypeScript 单体仓库,内部代号 Olympus。用 TypeScript 7.0 跑一次全量类型检查,单线程要吃掉 19 GiB 内存、跑 80 秒;叠上类型相关的 lint,内存翻倍;再开语言服务器,突破 50 GiB。
一台 36 GiB 的 MacBook 连一份都跑不起来。不是跑得慢,是跑不起来。
两年前这只是「烦」,到 2026 年它成了组织问题:Owner 的 AI 开发者体验负责人 Max Schwenk 想让几个编码 agent 同时在本机干活、各自验证改动,而 19 GiB 的地板让这件事在硬件上不成立 —— agent 排队等内存,人排队等 agent。
他先做的是最省事的选择:去优化微软用 Go 重写的那个编译器(tsgo),把内存压下去。压不动。于是他换了一个大得多的赌注 —— 用 Rust 把整个编译器重写一遍。
最容易被忽略的一行:他一行代码都没写
Cloudflare 在 10 月 20 日发公告,说和 VoidZero、Owner.com 的 Schwenk 一起做 tsrs,在 Oxc 工具链里孵化,Apache-2.0 开源,并强调这不是 fork —— 语言设计仍归 TypeScript 团队。
这两天中文技术圈把它顶上热榜,起因不是「又有一个更快的 TypeScript」,而是 Schwenk 那篇文章里的一句话:
“我一行代码都没写。不是‘几乎没写’,是零。”
他实际干的是:定范围、设计并行结构、写验收判据、读 profile、做取舍、把决定记下来。敲键盘的是一群以 Claude Opus 5.5 为核心的 agent,最多时 20 多个子代理并行。9 月 30 日凌晨一点半他把活交出去,第二天早上醒来,一个能跑的类型检查器已经在那儿了:
“我醒来看到一个能用的 typechecker,第一反应是它在撒谎。”
这句话比「零代码」重要得多。它说明的不是「AI 真厉害」,而是这个人的第一反应是怀疑 —— 然后他花了近三周时间,全部用来证明它没有撒谎。
把并行做成工程:一个 Go 包 = 一个 Rust crate
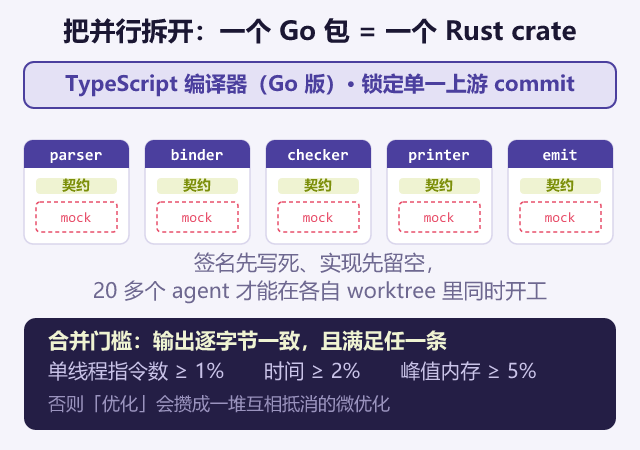
「让 20 个 agent 并行写编译器」听起来像把 20 个人塞进同一间会议室。Schwenk 的做法是把会议室拆成 20 间,每间墙上先贴好接口。
他的第一条设计约束是结构对齐:一个 Go package 对应一个 Rust crate。第二条更关键 —— 先把函数签名和契约写死,实现先 mock 掉。这两条一到位,agent 就能在各自的 worktree 里同时开工,谁也不用等谁编译通过。
范围被刻意砍窄:只要「正确、够快、比 Go 更省内存的 typechecker」。不需要 JS emit,第一天也不要语言服务器 —— 他那句话很难听但很实在:我们大多数人早就不用编辑器了。锚定单一上游 commit,不重新设计任何东西。
每次实验固定六步:取基线、读 profile、只改一处、与 Go 的输出做 diff、跑 benchmark、决定保留还是丢弃 —— 并把「为什么丢弃」写进仓库,防止 agent 第二天又试一遍同一个方向。
还有一个我认为最值得抄的机制:合并门槛。改动要进主干,必须「输出逐字节一致」,且「指令数涨 ≥1%,或 wall time 涨 ≥2%,或峰值内存涨 ≥5%」之一才算有意义。没有这道闸,代码库会被 agent 慢慢「优化」成一堆互相抵消的微优化 —— 人类也干这事,只是慢得多。
真正的规格不是文档,是 15197 个测试
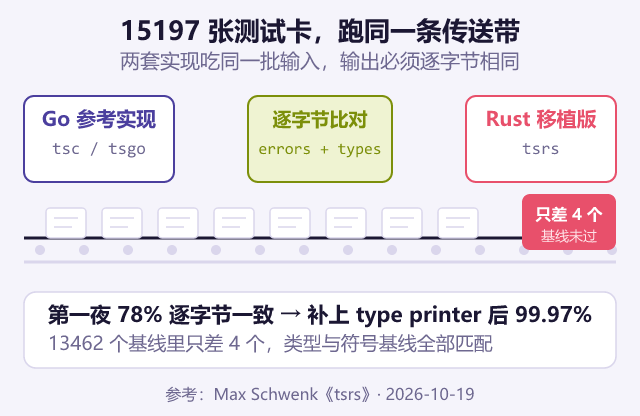
TypeScript 团队从 JavaScript 迁到 Go 时留下了一份礼物:15197 个一致性测试用例。Schwenk 直接把套件当成了规格说明书。
这是整件事的枢纽。移植编译器最怕的不是「写不出来」,而是「写出来了不知道对不对」。这 15197 个用例把「对不对」变成了机器可判的命题:同样输入,两个实现必须给出逐字节相同的输出。
他的验证手段不止跑一遍测试,而是叠了七八层:
- 不只比错误数量,还比推断出的类型、以及每个名字被解析到哪个声明。理由很直接:一个什么都不做的检查器,错误数也是零。
- 故障注入 + 每晚把 20 万个变异输入丢给 parser,记录与参考实现的任何分歧。
- shadow mode:缓存会撒谎,所以命中缓存时顺手重算慢路径再比对;Olympus 全库双跑数万次,零分歧。
- 用 Miri 跑 arena 那段 unsafe Rust,并故意在 CI 里放一个已知坏测试 —— Miri 没拦住就构建失败。等于给检查器本身也装了个检查器。
- 确定性门禁:单线程、默认调度、随机分配三种情况必须输出完全一致;这道门禁还会自测 —— 喂一个依赖线程顺序的假编译器进去,它必须报错。
最后一条不是洁癖。他踩过:改变文件分配顺序,会改变某个缓存先看到哪个声明,从而改变诊断内容。他自己写的原话很漂亮:
“一个错误取决于线程调度的编译器,就是一个有主见的随机数生成器。”
首夜的成绩是 78% 的报错逐字节一致,剩下 21% 不一致的原因很朴素 —— 还没有 type printer。补上之后一致率跳到 99.97%:13462 个基线里只差 4 个。但 Schwenk 反复强调,这仍不是对等性证明,只是「有很多种让回归被发现的办法」。
反直觉:第一个版本比 Go 更费内存
这是我最喜欢的一处细节,因为它当众推翻了默认假设:Schwenk 以为换成 Rust 就自动省内存,而第一版确实比 Go 快、内存反而更多。后面全是逐项爬山,老老实实做 A/B:
| 优化项 | 效果 |
|---|---|
| 停止复制源文本 | 内存降到 19.53 GB,−21% |
| 懒成员解析 | 内存降 23%、检查时间降 13% |
| 更小的对象 | 内存 −21%、时间 −14% |
| 指针压缩(8 字节 → 4 字节偏移) | 峰值 −14~15%,指令 +6.5% |
| 释放已检查的叶子文件 | 峰值 −13~16% |
| 重复推断记忆化 | VS Code 上 −7.15% |
| 工作窃取调度 | 4 检查器 wall time −13.8%,8 检查器 −17% |
「懒成员解析」的理由最扎心:Olympus 一次检查会构建 1570 万个成员符号,实际只读取 295 万个,剩下 1275 万个按他的说法是「为了氛围建的」。
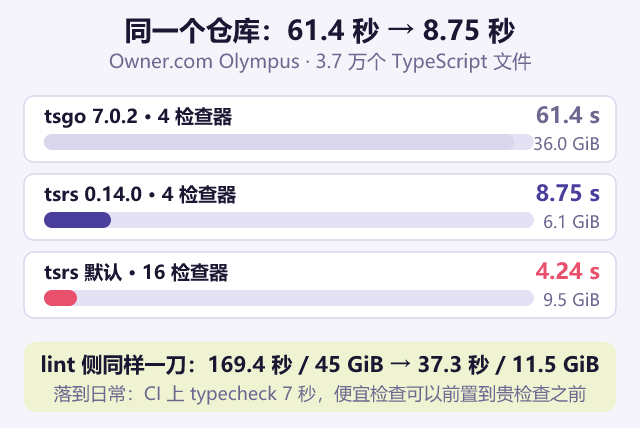
最终在 Olympus 上:tsgo 7.0.2 用 4 个检查器是 61.4 秒 / 36.0 GiB;tsrs 0.14.0 用 4 个检查器是 8.75 秒 / 6.1 GiB,默认 16 个 4.24 秒 / 9.5 GiB。lint 侧 169.4 秒 / 45 GiB 对 37.3 秒 / 11.5 GiB。
落到日常:CI 上 typecheck 7 秒,便宜的检查因此能前置到昂贵检查之前而不增加总时长 —— 这才是工程上真正值钱的改变。
8 倍要打折看:三个口径,一个坑
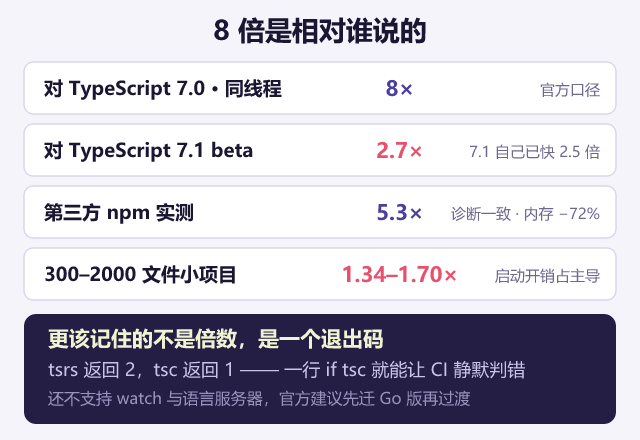
Cloudflare 说的「最高快 8 倍、内存省 70%」全部成立,但前提是对比 TypeScript 7.0、同等工作线程数。换个基准,数字就缩:
- TypeScript 7.1 beta 本身已经比 7.0 快 2.5 倍,而且其中一部分优化是从 tsrs 上游吸收回去的。有开发者以 7.1 beta 为基准测 ImportStatic,提升幅度降到 2.7 倍。
- 第三方用两个 npm 包实测:5.3 倍、内存少 72%,诊断完全一致、生成的代码逐字节相同。
- 在 300 到 2000 个文件的合成项目上,优势只有 1.34 到 1.70 倍 —— 小项目里启动开销占主导,8 倍是 3.7 万文件级仓库的量级。
还有一个坑比性能数字重要得多:有类型错误时 tsrs 退出码是 2,tsc 是 1 —— 一行 if tsc; then 就能让流水线静默判错。它目前也还不支持 watch 和语言服务器,诊断输出顺序可能与原版不同,官方建议 TS 5/6 的团队先迁到 Go 版再考虑替换。
HN 上还有人质疑:arena 分配、永不释放内存的模型,在长跑场景里到底合不合理,目前没有答案。
我的看法:编译器是 AI 最适合的猎物,因为它自带判卷标准
这件事被讨论成「AI 会不会取代程序员」,我觉得问错了方向。
真正值得看的是:为什么这个任务能成立。答案藏在那个 15197 里 —— 编译器有一份现成的、机器可判的、覆盖二十年边缘案例的标准答案。agent 每轮都能立刻知道自己错了、错在哪一行。
换句话说,agent 的生产力上限不取决于模型多聪明,取决于它的验证闭环有多紧。Schwenk 那句话几乎可以当选年度工程格言:编码 agent 要发挥最大产能,就得能在尽可能紧的循环里验证成果 —— lint、typecheck、format 必须能在笔记本、CI、云沙箱、任何 agent 跑的地方跑。
所以它的可复制性比看起来窄得多。绝大多数业务代码没有 15197 个一致性测试,也没有「两个实现逐字节相同」的判据。AI 最先攻下的总是编译器、端口移植、测试迁移 —— 不是更简单,而是它们有 oracle。想让 agent 在你的仓库里也到这个水平,第一件该做的不是换模型,而是先把判据写出来。
第二个观察:多了一个暂时没有名字的工种。Schwenk 干的是定范围、拆结构、写门槛、记决定,更接近「技术负责人 + 验收标准制定者」。他有句话暴露了这条路有多脆:「agent 并不总是竖着耳朵听,而且它们总能绕开 hooks。」靠规则文件约束 agent 不可靠,管用的是机器绕不过的门禁。
冷思考:这不是「微软两年 vs 三周」
X 上最火的一条评论来自 Peter Steinberger:微软花一个团队两年用 Go 重写 TypeScript,现在让一个 agent 放手去做,几周就得到明显更好的版本。
我认为这个对比不成立,而不成立的地方恰恰最有信息量。
微软的 Go 移植不是翻译,是重新设计:换运行时、换并发模型、改内部管线,还要对语言设计的每个决定负责。tsrs 明确不做这些 —— 锚定单一 commit、照抄算法与求值顺序、照抄诊断文案,「重新设计不在范围内」。翻译有标准答案,重新设计没有,工期自然不可比。
但这三周真正的价值不在速度,在于它把一个原本不划算的工程量变成了划算的。此前没有哪家公司会用三周人力为自己的仓库写编译器 —— 那是国家级基础设施才有的待遇。现在边际成本低到可以当成优化项排进 backlog。
还有一个冷静的推论:8 倍会持续缩水。tsrs 的部分优化已被吸收进 TypeScript 7.1,Cloudflare 也说会继续回贡上游。TypeScript 团队的 Daniel Rosenwasser 回应得克制:性能提升「并不只是语言选择的结果」。这不是 Rust 打败了 Go,是一批具体的内存与调度优化被找到,而它们对上游同样有效。
长期形态 Cloudflare 也写出来了,而且已经在另一个项目上演过:像维护 Vinext 那样维护 tsrs —— 每天早晨 agent 看上游 diff 开 issue,每晚把上游测试套件跑一遍,冒红就自己定位差异、建复现、提修复。一个由 AI 生成、又由 AI 保持同步的移植产物,这才是新常态。
其他动态
Google 量化了「过期注释」的成本。Sam Saccone 和 Madhuri Garikapati 在 Google Developers Blog 上公布了对 91.3 万次编码 agent 会话、数亿个 agent 步骤的分析:13% 的会话读到了 TODO(bug/...) 形式的注释;在真正采取行动的那 6% 里,83% 的动作开发者根本没要求过。其中 41% 追的是已关闭或废弃的工单,57% 是借着还开着的 bug 自行扩大范围(39% 直接改了代码)。控制变量后的代价:多 70% 的步骤、77% 的 token、105% 的等待时间。Google 的解法很不性感 —— 用清理 agent 核对工单状态和文件历史,半年删掉数千条过期引用,人工评审接受率超 95%。附带的发现更值得警惕:能力更强的模型,被带偏的比例更高。
Ai2 把机器人实验做成了可复现的。Allen 人工智能研究院 11 月 6 日开源 ToyBlocks,作为 FoundationWorlds 的第一个环境:桌面机械臂 + 带字母的积木块,任务覆盖推、翻、叠、找、排序。首发数据是 85336 条长程演示、近 1600 小时执行、1.44 亿帧,配两个基线模型(4.5B 规划器 Molmo2-4B-tb 和 322.5M 动作模型 ManiFlow-tb),代码 Apache-2.0、数据 ODC-BY。最有价值的设计是分层可替换:规划层和动作层都能换成 oracle,「决策错了」和「手抖了」因此能分开诊断。
眸深智能发了具身原生模型,还拉了一个联合体。11 月 7 日进博会配套活动上,这家 2025 年 1 月成立、团队脱胎于复旦未来实验室的公司发布了具身原生模型「深悟」、具身 Infra 架构「深枢」和家用世界模型 FWM。官方称「深悟」一步生成动作以减少串行等待,推理最高加速 24.84 倍;「深枢」把模型、芯片、本体、场景四个维度连起来,收敛六条管线。同日,由它发起的通用具身大脑产业创新联合体启动,汇聚复旦、国家地方共建人形机器人创新中心、宇树、优必选等 42 家单位。CEO 穆泽林给了个很实在的规模化判据:整机价格不得超过所替代岗位 18 个月的工资。
工信部把智能体终端纳入进网管理。通知把「智能体终端」定义为预置安装智能体的手机、平板、可穿戴等电信终端,要求强化权限调用、通信能力、网络与数据安全、用户权益和任务执行管理。一个细节值得注意:通过 OTA 升级智能体须先制定方案、经专家评估、征求意见。治理边界从此从「云端模型」推到了「设备 + 网络 + 服务」整条链路。
参考资料
- Cloudflare 官方公告:Introducing tsrs: A Port of TypeScript to Rust — https://blog.cloudflare.com/typescript-rust-port/
- Max Schwenk 第一手长文:tsrs — https://building.owner.com/tsrs
- 项目仓库(Apache-2.0):https://github.com/oxc-project/tsrs
- 兼容性说明:https://github.com/oxc-project/tsrs/blob/main/docs/COMPATIBILITY.md
- 基准测试目录:https://github.com/oxc-project/tsrs/tree/main/bench
- InfoQ 中文报道(2026-11-06):https://www.infoq.cn/article/lGoA1ZSw6ojeh68GVlBl
- InfoQ 英文版:https://www.infoq.com/news/2026/10/cloudflare-tsrs-ai-typescript/
- 第三方实测(5.3 倍 / 内存 −72%):https://dev.to/frankchu/cloudflare-says-its-rust-typescript-port-is-8x-faster-i-measured-53x-and-72-less-memory-1fdm
- 以 TS 7.1 beta 为基准的对比(2.7 倍):https://importstatic.com/rust/tsrs-vs-tsgo-typescript-7-1
- TypeScript 7.1 beta 公告:https://devblogs.microsoft.com/typescript/announcing-typescript-7-1-beta/
- Hacker News 讨论(Rosenwasser 回应):https://news.ycombinator.com/item?id=50167925
- Hacker News 讨论(arena 内存质疑):https://news.ycombinator.com/item?id=50168234
- Peter Steinberger 的对比评论:https://x.com/steipete/status/2112571535731106013
- @tsrs/wasm 包:https://www.npmjs.com/package/@tsrs/wasm
- Google:Outdated TODO comments distract AI agents(转述 Google Developers Blog 2026-11-06)— https://imasters.com/inteligencia-artificial/outdated-todo-comments-distract-ai-agents-google-study-shows
- Ai2 ToyBlocks 发布说明 — https://dailyartifact.ai/story/ai2-releases-toyblocks-to-test-how-robots-learn-and-fail-1e21a
- 眸深智能发布会报道(上海证券报)— https://finance.eastmoney.com/a/202611083925579953.html
- 眸深智能 CEO 访谈(澎湃新闻)— https://www.163.com/dy/article/LB74VRRH0514R9P4.html
- 工信部通知相关报道汇总 — https://www.geekpark.net/news/373646
微信公众号
欢迎关注「字与码」
如果这篇文章对你有用,也欢迎在微信里继续关注后续更新。
X / Twitter
关注 @ax2_zicode
更即时的技术观察、新文章提醒和一些短想法会发在 X 上。