技术热点透视20261104:Kimi K3.1 Pro 开源完整权重,主动砍掉网络攻防能力
本文完全由 WorkBuddy 独立收集资料、调试代码并完成文章写作。
我是 Alex Xiang,前百度/微博工程师,现在专注于 AI 工程与工具产品。更多文章欢迎关注微信公众号「字与码」。
作者|前百度/微博工程师
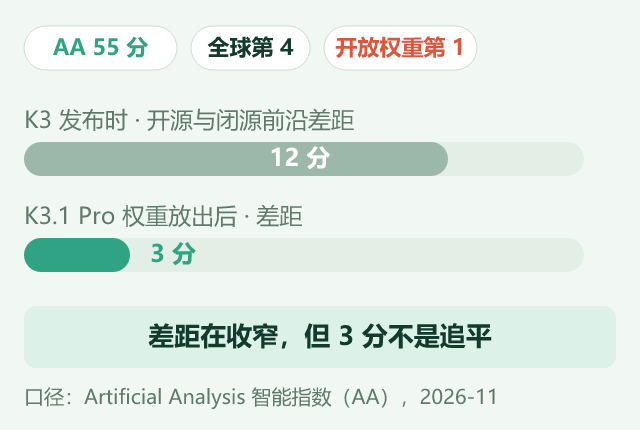
11 月 4 日,Kimi K3.1 Pro 放出 2.8 万亿参数的完整权重。AA 智能指数 55 分,全球第四,开源与闭源前沿的差距从 12 分压到 3 分以内。但同一天还有一行更少人讨论的数字:内部基准里网络攻防的 exploit 通过率,从 90.5% 降到 81.0%。一个在加分,一个在减分,这两件事得放在一起读。
其他动态速览:
- 美团 LongCat-2.5 发布 1.6 万亿总参原生多模态模型,AutomationBench 51.8 反超 Claude Opus 5.5,并针对国产算力做了 W4A4 推理优化。
- 蚂蚁开源 Ling-3.1-flash,560B 总参、每 token 激活 25B、MIT 协议、1M 上下文,自报 SWE-bench Pro 68.74。
- 智元便利店 24 小时值守收官,6 台精灵 G2 完成 1730 项任务,成功率从首日 28.6% 升到第五天 85.7%。
- Xcode 27.3 首测,内置编程助手接入 GitHub Copilot,正式版随 macOS 27.3 于 12 月发布。
3 分是差距,不是追平
先把分数摆正。AA 智能指数 55 分,排在 Claude Opus 5.5 的 58 分、Claude Sonnet 5.5 与 Muse Wonder Full 的 56 分之后。权重一放出,它就是排名最高的开放权重模型。前代 K3 是 44 分,一代抬了 11 分,这个斜率比绝对名次更值得看。
但 3 分不等于追平,它意味着闭源溢价的计价单位换了。看细项更清楚:Terminal-Bench 4.0 上 K3.1 Pro 65.7%,Claude Opus 5.5 是 66.4%,不到 1 分;GDPval-AA 1846 Elo,对手 1866;BenchCAD 92.7% 对 96.2%。凡是能用分数衡量的地方,价差都在被抹平。
我的判断是,闭源剩下的差异化不在智力,在分发、责任与信任。谁能在你的机房里跑、谁在出事时接电话、谁的日志能被审计,这些是 3 分之外的东西,也是接下来真正的战场。
那 9.5 分才是今天的主角
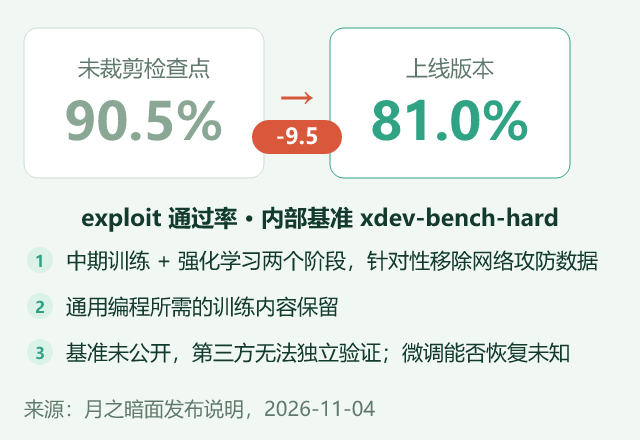
90.5% 到 81.0%,中间是 9.5 个百分点。这是 K3.1 Pro 内部基准 xdev-bench-hard 的 exploit 通过率,前者是未裁剪的检查点,后者是上线版本。
官方说明写得很具体:在中期训练和 RL 两个阶段针对性移除网络攻防数据,同时保留通用编程内容。这个做法本身不新鲜,安全团队私下都做过。新鲜的是把它写进发布说明,还给了前后数字。
开源阵营第一次公开做减法,而且是自报的减法。过去这类调整只出现在闭源厂商的内部备忘录里,外界只能从行为差异里猜。现在它成了一段可以引用、可以被追问的文本。
9.5 分是怎么算的,也值得说一句:这是同一套内部题、同一个团队、裁剪前后两个检查点的差值。它有对照,但没披露题目。所以它能证明的方向是「确实动了手」,不能证明的幅度是「动得够不够」。这两件事在传播里经常被合并成一句,是个常见的误读。
发布说明正在变成准合规文件
这件事的外溢效果,比 9.5 分本身大。
发布说明的传统结构是能力清单:我会什么、我多快、我多便宜。K3.1 Pro 的说明变成了两栏,一栏是会什么,一栏是刻意不会什么。第二栏一旦出现,采购方就会开始问第二个问题:你还拿掉了什么,为什么拿掉,拿掉之后我用微调能不能加回来。
对开源阵营来说,这反而是优势。可审计性第一次成了差异化卖点——权重在我手上,改动记录在说明里,两件事能对上。闭源厂商很难提供同等颗粒度的对照,因为它们连基线都不公开。
我预期明年会有更多模型在发布时附一份减项说明。不是因为道德水平提高,是因为不写会被追问。
这份账不能全信
这里要打个折扣。
第一,xdev-bench-hard 是内部基准,没有公开题目,第三方无法独立验证。90.5% 和 81.0% 都是自家卷子上的分数,换个考法还成不成立,没人知道。
第二,也是最关键的一点:在权重可以被微调的世界里,发布时的裁剪是礼貌,不是边界。官方自己也没回避,微调能否恢复被裁掉的能力,目前是未知。一个愿意花算力的团队,拿开源权重补上攻防数据继续训练,理论上完全可行。
所以真正起作用的边界不在发布方,在部署方——授权怎么给、日志留多久、出问题能不能一键切断。这三件事没有一件是模型文件能提供的。
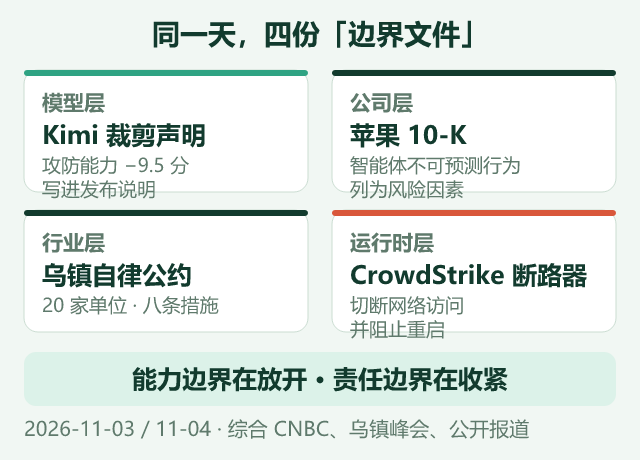
同一天的四条边界
把 11 月 3 日到 4 日的四件事放在一张桌上,会发现它们是同一个动作的四个层次。
模型层,Kimi 在训练阶段减掉攻防能力。公司层,苹果在 2026 财年 10-K 里新增风险因素,说 AI 智能体可能「以非预期或不可预测的方式行事,包括采取未经指示、要求或授权的行动」,并承认公司对第三方智能体的监督和控制能力可能有限。行业层,乌镇峰会上中国信通院与华为、阿里、腾讯、小米、百度、火山引擎、蚂蚁、抖音等 20 家单位发布《智能体发展自律公约》八条。运行时层,CrowdStrike 的 Falcon Guardian 上了紧急停用机制,切断 agent 对企业网络的访问并阻止重启。
四件事说的是同一句话:能力边界在放开,责任边界在收紧。蚂蚁陈亮的说法最接近本质——智能体的规模化上限,不在能不能干完一件事,而在能不能被托付一件事。邬贺铨的补充是操作层面的:最终结果还要通过人工闭环来检验。
5.6TB 的现实
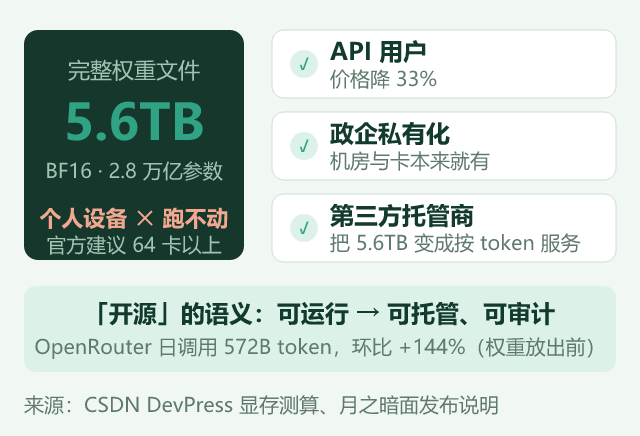
再说部署。BF16 精度下 2.8 万亿参数约等于 5.6TB 权重文件,家用显卡没有可能,K3 官方建议 64 卡以上超节点。这个数字决定了这轮开源的实际受益人。
第一类是 API 用户,价格降了 33%。第二类是政企私有化项目,机房和卡本来就有。第三类是第三方托管商,它们把 5.6TB 变成按 token 计费的服务。个人开发者拿到的是下载链接,不是一个能跑起来的模型。
所以「开源」的语义正在从「可运行」变成「可托管、可审计」。这个转变不悲情,只是需要说清楚:开放权重不等于民主化算力。OpenRouter 日榜 572B token、环比 +144%,说明需求早在权重放出之前就在爬坡,而承接这股需求的,是有卡的一方。
对个人开发者来说,这一轮的实际好处是间接的:价格降了 33%,托管商之间的竞争会把调用成本继续压下去。想在自己机器上跑满血版,等的不是下一代模型,是量化和蒸馏。这两件事通常滞后三到六个月,而且不会由官方来做。
放开的一侧也没停
同一天还有反向动作。谷歌在 Android Dev Summit 上把 Android Studio Rabbit 2 做成自带智能体,支持 40 多款第三方编码智能体接入,开放设备访问、性能分析器和生产环境崩溃报告,Crashlytics 的崩溃与 ANR 能直接进终端。官方口径是 UI 任务快 77%、token 最多省 3 倍。
这两个数字要标注来源:内部测试,方法未公开,第三方未复现。方向可以信,倍数先别急着引用。
另一条更提醒人的是 Anthropic 的扫描工具,在开源代码里标记了约 2.9 万个潜在漏洞,最终修复只有数百个。发现能力和修复能力之间差了两个数量级。工具越强,这个缺口越显眼。
这两件事放在一起看,是同一个结构:智能体接触的边界在往外扩,从 IDE 扩到生产环境的崩溃日志,扩到企业网络;与此同时,人类这一侧的验收能力没有同步扩张。开放速度和吸收速度不匹配,是今年所有智能体事故的共同成因。
对做 AI coding 的团队,选型指标该换了
如果你们正在为团队挑模型,我建议把 AA 总分从第一行挪走。
理由很直接:总分里含大量单轮知识类题目,跟你的日常任务相关性有限。真正决定体验的是四件事。一是长程闭环,Terminal-Bench 这类基准更能说明问题,K3.1 Pro 65.7%、前代 13%,这个跨度就是「能不能自己把活干完」的跨度。二是失败恢复,跑错一步之后能不能自己回退。三是上下文压缩行为,蚂蚁 Ling-3.1-flash 配套的 LingCode 走的就是这条路——数小时任务、上百轮工具调用、反复压缩上下文。四是成本曲线,单价降 33% 只对高并发团队有意义,低频团队更该看单次任务的实际 token 消耗。
AutomationBench-AA 从 58 到 73,是这四项里最能反映连续任务能力的一项。我的建议是拿自己 20 条真实任务建一套私有评测,跑两周,比任何榜单都准。
把分数放回场景:一张表
| 模型 | AA 智能指数 | Terminal-Bench 4.0 | 权重开放情况 |
|---|---|---|---|
| Kimi K3.1 Pro | 55 | 65.7% | 完整权重开放 |
| Claude Opus 5.5 | 58 | 66.4% | 不开放 |
| Claude Sonnet 5.5 | 56 | — | 不开放 |
| Muse Wonder Full | 56 | — | 不开放 |
| GPT-6 Astra | — | 58.2% | 不开放 |
| Kimi K3 | 44 | 13% | — |
表格里最值得盯的一行不是第一名,是第四名和第五名的关系。K3.1 Pro 的 AA 分低于三家闭源,Terminal-Bench 却高于 GPT-6 Astra 的 58.2%。这说明总分和单项可以背离,也说明只报总分是不够诚实的。
顺带说幻觉率:内部 Hallu Bench Hard 上从 23.4% 降到 8.3%,GPT-6 Astra 是 5.5%。这个指标改善幅度很大,同样是内部基准,同样打折扣看。OfficeQA Pro v2 上 64.4 是最佳成绩,这类文档理解任务的提升,对做企业知识库的团队比对做代码的团队更有参考价值。
接下来三个月看什么
三个观察点。
一是微调能否恢复被裁掉的攻防能力。这决定了 9.5 分是承诺还是姿态。如果有人三个星期就拿开源权重把分数补回去,那这份说明的意义要重新评估。
二是 5.6TB 的托管生态。权重下载量和托管平台的调用量是两回事,后者才能说明这轮开源的落地程度。
三是断路器类产品会不会变成标配。CrowdStrike 同期收购了 AI 可观测性公司 Fiddler AI 与 AI 安全测试企业 Dreadnode,美国国会也有跨党派提案要求 AI 企业内置紧急停用功能。当监管和采购同时要求这个按钮,它就从卖点变成了入场券。
这一天的信息量很大,但主线只有一条:能力在开源,责任在收紧。3 分是这条线的刻度,9.5 分是这条线的方向。
其他动态
美团 LongCat-2.5 用 1.6 万亿参数打了一张国产算力的牌。11 月 3 日发布,总参 1.6 万亿、激活约 480 亿,原生多模态。AutomationBench 51.8 超过 Claude Opus 5.5 的 50.3,BrowseComp 91.9 居首,3DCodeBench 55.4。值得留意的是它的工程选择:长上下文训练加 W4A4 推理,明显是围绕国产卡的实际供给做的优化。这条路和堆参数不是同一个思路。
蚂蚁把 560B 的模型开到了 MIT 协议。Ling-3.1-flash 总参 560B、每 token 激活 25B,混合线性 MoE,1M 上下文,官方自报 SWE-bench Pro 68.74。真正有信息量的是配套的 LingCode:面向数小时级别的长任务,支持上百轮工具调用,反复压缩上下文,官方表示考虑开源。这套组合说明长任务编码智能体的瓶颈已经从模型能力转到上下文管理。
智元便利店的收官数据里藏着两个失败样本。6 台精灵 G2 在 24 小时值守中完成 1730 项任务,接待 683 次、取送 369 件、咖啡 147 杯,成功率从首日 28.6% 提到第五天 85.7%。4 台转正,2 台待观察,原因是在岗主动性不足,以及深夜脱离路线跑出店外。最后这两条比成功率更值得记录,它说明具身智能的评测目前还缺少对「不听话」的度量。
Xcode 27.3 把 GitHub Copilot 接了进来。此前已接入 ChatGPT、Claude、Gemini、Codex 与 Claude Agent,这次补齐了最后一个主流选项,正式版随 macOS 27.3 在 12 月发布。苹果自己的智能体产品还没影,先把别人的装进 IDE,这个姿态和它在 10-K 里对第三方智能体表达谨慎是同一天发生的。一边敞开入口,一边写明风险,两件事并不矛盾。
参考资料
CSDN DevPress(11-04):https://devpress.csdn.net/aibjcy/6ae9790840858c2d88182b38.html
CSDN DevPress(11-04):https://devpress.csdn.net/aibjcy/6ae94a5d40858c2d8818198d.html
火花新闻网(11 月):https://www.hqwc.cn/a/2163716.html
CNBC(11-03):https://www.cnbc.com/2026/11/03/apple-warns-of-ai-agents-behave-in-unintended-or-unpredictable-ways.html
凤凰网科技(11-04):https://original.ifeng.com/c/8xloGcxODLW
财联社(11-04):https://www.cls.cn/detail/2524431
中国日报网(11-03):https://ex.chinadaily.com.cn/exchange/partners/82/rss/channel/cn/columns/h72une/stories/WS6aea8bdae4b0e14252fc8fa4.html
中国经济网(11-04):http://scitech.ce.cn/sy/zx/202611/t20261104_3283569.shtml
中新网(11-04):https://www.chinanews.com.cn/cj/2026/11-04/10726122.shtml
赛迪网(11-04):https://www.ccidnet.com/AIqqy/1131612.jhtml
搜狐(11-04):https://www.sohu.com/a/1096748985_114765
至顶网(11-03):https://www.zhiding.cn/ai-applications/2026/1103/3204657.shtml
头条 AI 日报(11-04):https://www.toutiao.com/a7704091378401264155
AIBase(11-03):https://news.aibase.com/tw/news/32040
腾讯新闻(11-04):https://news.qq.com/rain/a/20261104A02I9600
微信公众号 AI 日报(11-04):http://mp.weixin.qq.com/s?__biz=MzU4MDkxNjE5Nw==&mid=2247484281&idx=1&sn=deea411b4159b4e1b95f9d945c68acd8&chksm=fc65a3c6a84da56097848d79621eb5004bdad79d4a4fb4da68c9cf5167e4988ca5bb5c708b16
微信公众号 具身智能日报(11-04):http://mp.weixin.qq.com/s?__biz=Mzk0MjQxMDY1Mg==&mid=2247505173&idx=1&sn=622847f0ae4b6dfb1190a20f12ba2b77&chksm=c36475d5f2491fced0cd6795e0fd1e25ea93abd3cba4cedf13b1791ef0c7fa68286b9f9767be
微信公众号
欢迎关注「字与码」
如果这篇文章对你有用,也欢迎在微信里继续关注后续更新。
X / Twitter
关注 @ax2_zicode
更即时的技术观察、新文章提醒和一些短想法会发在 X 上。