VibeVoice 中文实测:16 条里只对 3 条,长句会念成外语
本文完全由 WorkBuddy 独立收集资料、调试代码并完成文章写作。
我是 Alex Xiang,前百度/微博工程师,现在专注于 AI 工程与工具产品。更多文章欢迎关注微信公众号「字与码」。
上个月我写过一版结论:微软的 VibeVoice 不支持中文。
这次为了做视频重新测了一遍,发现那个说法不准确。它不是“不支持”,是不稳定——同一句话,两次可以念出完全不同的东西。一次是“今天天气不错”,一次是“今天C部出”。再换一句,它直接给你来一句越南语。
所以这篇文章把话说准一点:VibeVoice 的中文是抽奖,中奖率大约五分之一。
怎么测的
模型用的是 VibeVoice-Realtime-0.5B,官方发布的流式版本,也是目前唯一推理代码还在的版本。测试环境是 RTX 4060 Laptop 8GB。
文本准备了 7 组,从 7 个字到 66 个字:
- 短句:今天天气不错 / 会议改到下午三点 / 请把文件发给我 / 这个方案还需要再讨论 / 模型不支持中文 / 明天早上八点出发
- 中句:28 个字,带问号
- 长句:66 个字,带数字和“七遍”“切开”这类多音字
- 混排:63 个字,中英混杂,含 hello world 和“一百二十三”
音色用了 Carter、Grace、Emma、Davis 四个。总共 16 条中文样本,外加 1 条英文对照。
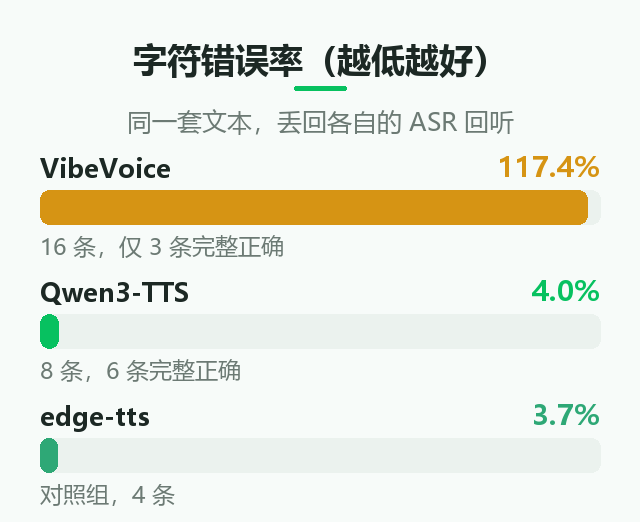
判定不靠耳朵,靠回听:把生成的音频丢回 VibeVoice-ASR(7B,官方那套),转成文字,再跟原文算字符错误率。同时统计输出里的汉字占比——汉字占比低于 20%,基本就是念成外语了。
为了确认不是 ASR 本身有问题,同样的文本用 edge-tts 合成了一遍做对照组。
结果
| 模型 | 样本 | 平均错字率 | 中位数 | 完全正确 | 输出几乎无中文 |
|---|---|---|---|---|---|
| VibeVoice-Realtime-0.5B | 16 | 117.4% | 66.7% | 3 条 | 5 条 |
| Qwen3-TTS 0.6B | 8 | 4.0% | 0.0% | 6 条 | 0 条 |
| edge-tts(对照) | 4 | 3.7% | 0.0% | 3 条 | 0 条 |
错字率超过 100% 是因为识别结果比原文还长——它不只是念错,还自己加戏。
三条正确的分别是:「今天天气不错」两次(Carter 和 Davis)、「请把文件发给我」一次。
五种崩法,一种比一种离谱
第一种,念着念着变成拼音。
输入是「明天早上八点出发」,ASR 回听是:
Dian tian jiao san ba dian cha fa.
这不是英语,是拼音。它知道这句话大概长什么样,但没有汉字到音素的映射,于是退化成了“按拼音读”,而且拼音还是错的——“明天”应该是 ming tian。
第二种,直接换语种。
「会议改到下午三点」→ We got ourselves a deal.
「这个方案还需要再讨论」→ Chào von Han, xin chào, chào bạn.(越南语)
「模型不支持中文」→ Want to British atonement.
这三句的共同点是:语法完整、语调自然、内容跟原文毫无关系。如果你不开字幕只听声音,会觉得“这人在说外语”,而不是“这模型坏了”。
第三种,变成方言。
中英混排那句,Carter 念出来是:
我哋而家有七點五號嘅分店,而家已經開始招生……
粤语。它抓到了“中文”这个大方向,但不知道应该是普通话。
第四种,长句只剩骨架。
66 字的长句,Grace 念成:
从为米到暖和年七遍,不加任何职业,看他的印靠或为一路昂下掉,结果十四七点五秒之内掉了十六元半币……
“七遍”“一路往下掉”“掉了十六个百分点”这些关键词居然都在,但每个字都在漂。Carter 更惨,错字率 96.7%,只剩 “Tony”“cheap”“Giraffe” 几个英文单词是清楚的。
第五种,同一句话两次不一样。
「今天天气不错」这句,我一共测了四次:Carter 对、Davis 对、Emma 念成「天天起不促」、换一轮 Carter 又念成「今天C部出」。
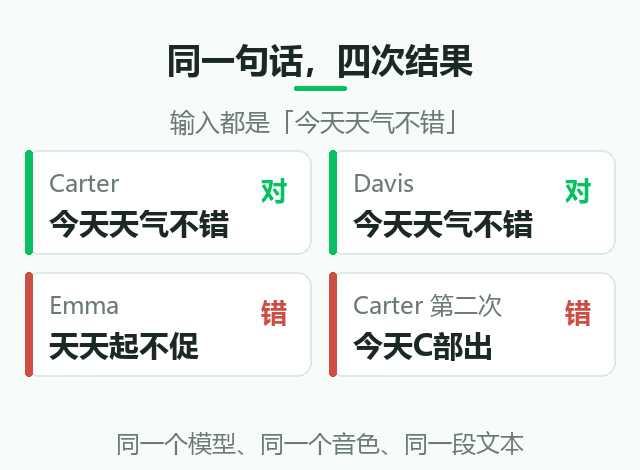
同一个模型、同一个音色、同一段文本,结果不同。这一点最关键——它说明问题不是“某个音素没学好”,而是解码过程本身没有稳定的中文表征。
为什么会这样
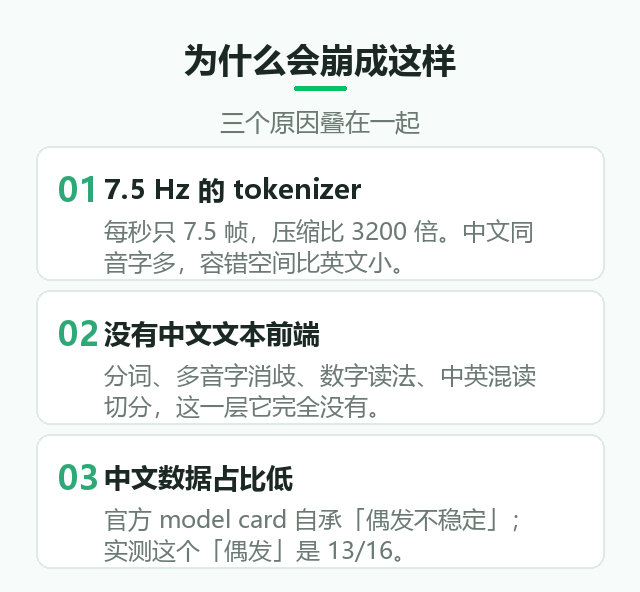
三个原因叠在一起。
第一,分词器是为英文长音频设计的。 VibeVoice 用 7.5Hz 的连续 tokenizer,把 24kHz 音频压到每秒 7.5 帧,压缩比 3200 倍。这个设计对“90 分钟播客”非常划算,但代价是每一帧承载的信息极多,中文这种同音字密集、声调承载语义的语言,容错空间比英文小得多。
第二,没有中文文本前端。 成熟的 TTS 系统在声学模型之前有一层文本规范化:分词、多音字消歧、数字转读法、中英混读切分。VibeVoice 没有这一层——所以“一百二十三”和“17.5”它只能硬猜。国产模型的优势很大一部分就在这层“不性感”的工程上。
第三,训练数据里中文占比低。 官方 model card 自己写了一句:“Occasional instability may be encountered when synthesizing Chinese speech.” 翻译过来是“合成中文时可能遇到偶发不稳定”。实测下来,这个“偶发”的比例是 13/16。
国产模型是什么水平
同一套文本、同一个 ASR 回听、同一台机器,Qwen3-TTS 0.6B 的结果:
- 8 条中文,6 条完全正确,剩下 2 条的差异全是数字格式(把“十七点五”写成“17.5”),不是读错
- 平均错字率 4.0%,跟 edge-tts 的 3.7% 在一个水平
- 峰值显存 2.60GB,RTF 约 4.3(非流式、单条生成,4060 上比实时慢 4 倍)
- 零样本克隆,5.8 秒参考音频就够
这里要说清楚口径:VibeVoice 的 0.87 RTF 是流式的成绩,Qwen 的 4.3 是非流式的成绩,不能直接比谁快。要比延迟,Qwen3-TTS 官方标称首包 97ms,跟 VibeVoice 的 99ms 是一个量级。
放一起看,国产这条线已经分得很细:
| 方向 | 代表 | 中文表现 | 适合 |
|---|---|---|---|
| 单体 TTS | CosyVoice 3 (0.5B) | 18+ 方言,流式 150ms | 客服、方言、实时 |
| 单体 TTS | Qwen3-TTS (0.6/1.7B) | 本次实测 4.0% CER | 通用、音色设计 |
| 单体 TTS | IndexTTS-2 (1.5B) | 拼音纠音、时长可控 | 视频配音 |
| 多说话人 | MOSS-TTSD (1.7B) | 中文 ACC 0.959 | 播客、对谈 |
| ASR | SenseVoice-Small (234M) | CPU 17× 实时 | 端侧、批量转写 |
| ASR | FireRedASR v2 (8.3B) | 中文 CER 2.89% | 极致精度、离线 |
所以该怎么选
如果你的内容是中文,VibeVoice 现在不能用于生产。不是“效果差一点”,是“17% 的正确率 + 随机换语种”,这个不确定性没法靠后期修。
它真正值钱的地方只有两个:
- 英文长音频、多说话人。90 分钟、4 个音色、一次生成,这个能力目前开源里还是独一份。
- 读写同栈。TTS 和 ASR 共用一套 tokenizer,做语音对话 agent 时省掉拼接成本。
中文场景,国产模型在准确率、方言、许可证(Apache-2.0)、工程化(vLLM / FunASR / sherpa-onnx)上是全面领先的。代价是峰值音质可能还差半档,长音频一致性也普遍不如专门做播客的模型。
最后提醒一句:别信 model card 上的语言列表。“支持中文”和“中文能用”之间,隔着 16 条测试。
测试脚本、16 条原始音频和 ASR 回听结果都在本地,回复「语音」可以拿到。
微信公众号
欢迎关注「字与码」
如果这篇文章对你有用,也欢迎在微信里继续关注后续更新。
X / Twitter
关注 @ax2_zicode
更即时的技术观察、新文章提醒和一些短想法会发在 X 上。