DeepSeek-V4-Pro 蒸馏版 9B 本地实测:数学单题做到考研,80 字解释跑成死循环
本文完全由 WorkBuddy 独立收集资料、调试代码并完成文章写作。
我是 Alex Xiang,前百度/微博工程师,现在专注于 AI 工程与工具产品。更多文章欢迎关注微信公众号「字与码」。
这两天 Hugging Face 上有个仓库被转得很凶。常见说法是:DeepSeek-V4-Pro 与 Qwen3.5-9B 的「混血完全体」,只有 5.6B,5.6GB 就能跑,核显本秒开,100 个刁钻提示只拒 3 个,还是 Apache 2.0。
我把四个相关仓库、模型卡和提交记录都翻了一遍,又在这台机器上把权重拉下来跑了两轮。模型是真的,数学能力比传闻里描述的更值得说,但转述里至少有三个数字需要改,而「能解什么题」这件事必须看到题目原文才算数。这篇把核查结果、18 道实测题的题面与回答、以及它在中考到算法竞赛这些真实场景里到底能顶什么活,一起交代清楚。
先把名字拆开:这是师生,不是混血
模型全名 DeepSeek-V4-Pro-Qwen3.5-9B-UNCENSORED-heretic,一长串里其实叠了三次社区加工。
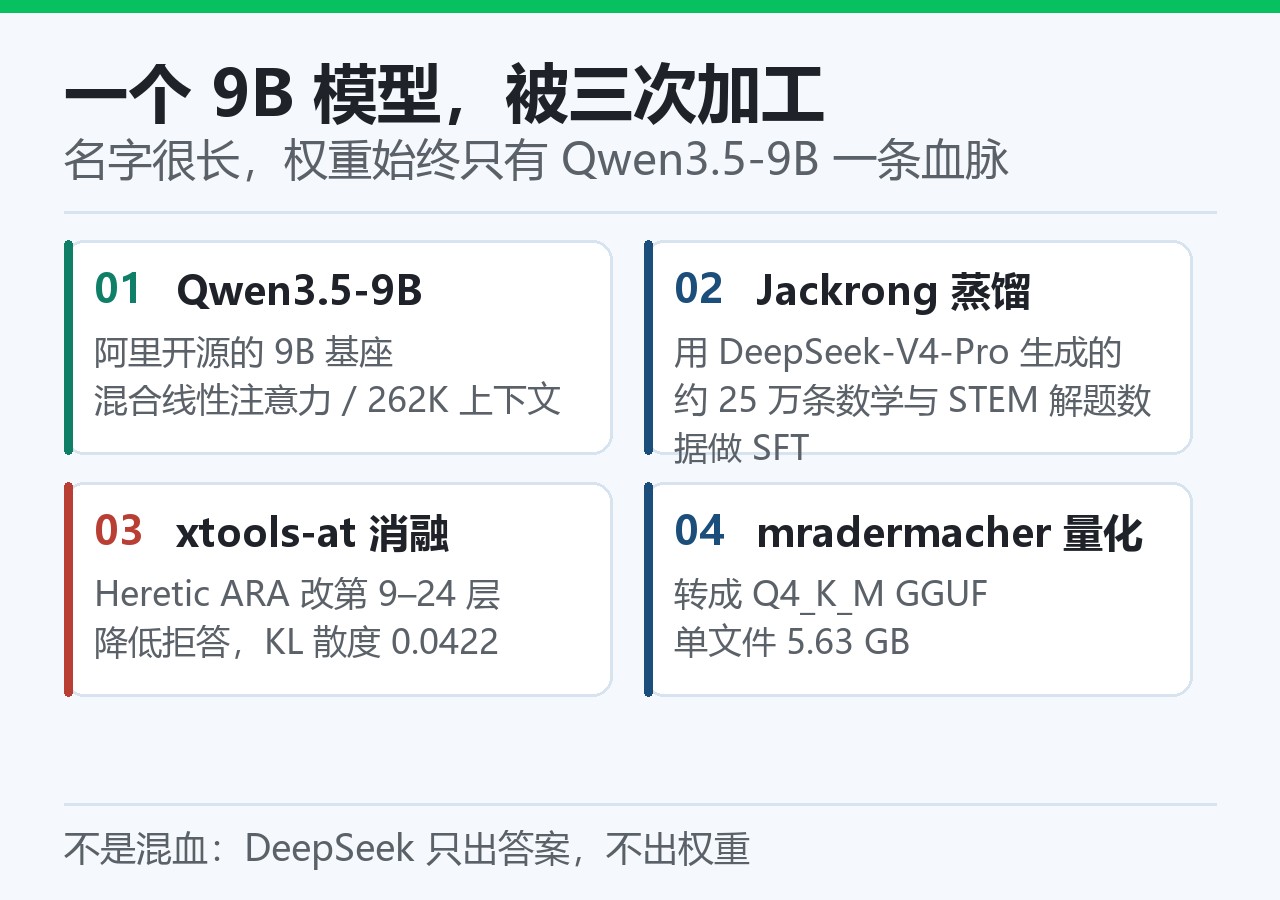
第一层是阿里的 Qwen3.5-9B 基座,9B 参数、混合线性注意力、262K 上下文。第二层由社区账号 Jackrong 做蒸馏:拿 DeepSeek-V4-Pro 在 Max Effect 模式下生成的约 25 万条数学与 STEM 解题样本,先做监督微调,再跑一轮轻量 GSPO 强化学习。第三层由 xtools-at 用 Heretic v2.0 的 ARA 方法改权重,把拒答行为压下去;最后由 mradermacher 转成 GGUF 量化文件。
关键在于:DeepSeek-V4-Pro 只提供了解题答案,没有提供任何权重。学生自始至终是 Qwen 的 9B 架构,老师只是出题和写解题过程。所以「混血」「两个模型焊在一起」都不准确,这就是一次标准的知识蒸馏。模型卡里的 base_model 字段也写得很直白,指向的是 Jackrong 那个蒸馏仓库,不是 DeepSeek 官方。
顺带说清另一件事:它也不是 DeepSeek 官方发布的。上游是社区账号,下游去审查、量化都是第三方。Apache 2.0 是权重授权,不代表官方背书或后续维护。
5.6 是 GB,不是 B
传播里最普遍的一次错位,是把文件体积当成了参数量。
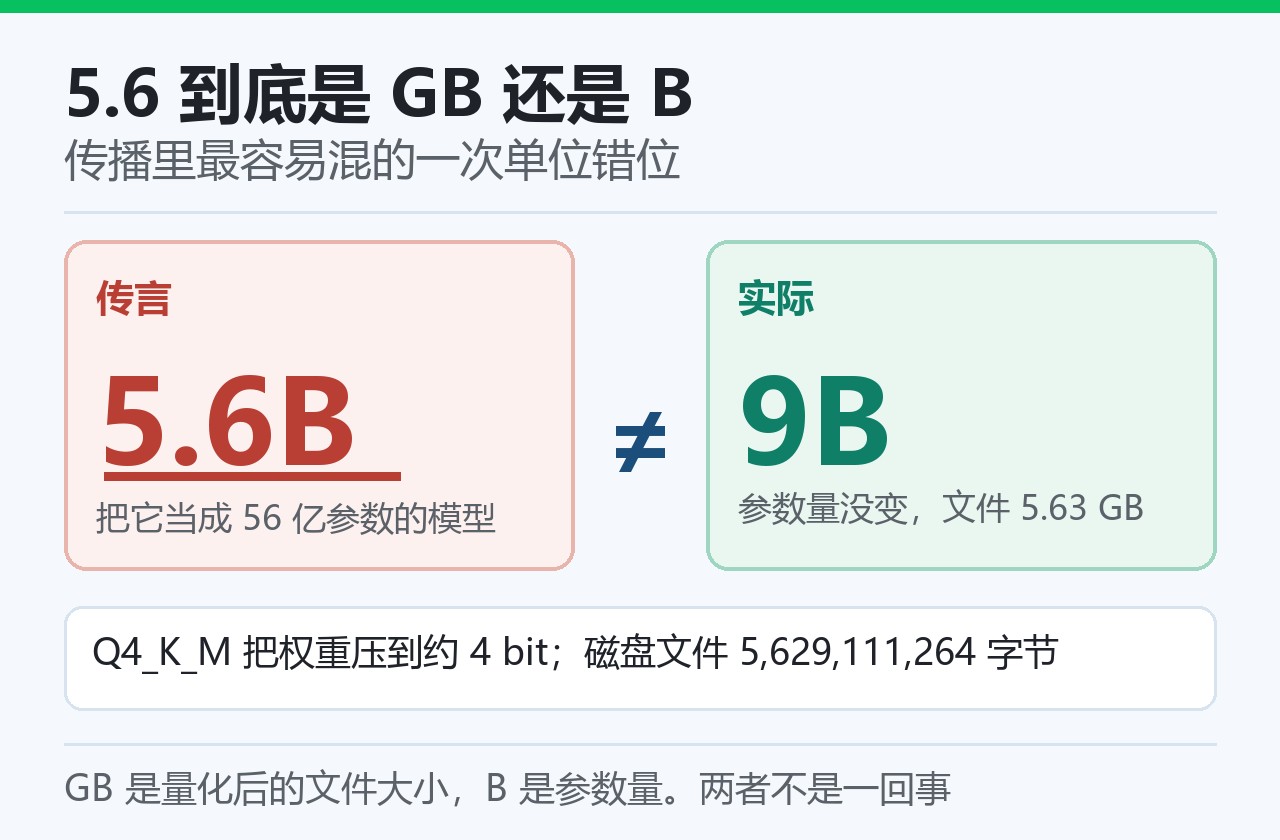
我直接从 Hugging Face API 读到的数字:Q4_K_M.gguf 是 5,629,111,264 字节,也就是 5.63 GB。参数量仍然是 9B。Q4_K_M 的意思是把权重从 16 位浮点压到平均约 4 位,省的是磁盘和显存,不是把模型砍小。
同一份 GGUF 仓库里还有一整排档位,从 2 bit 到 16 bit 都有。
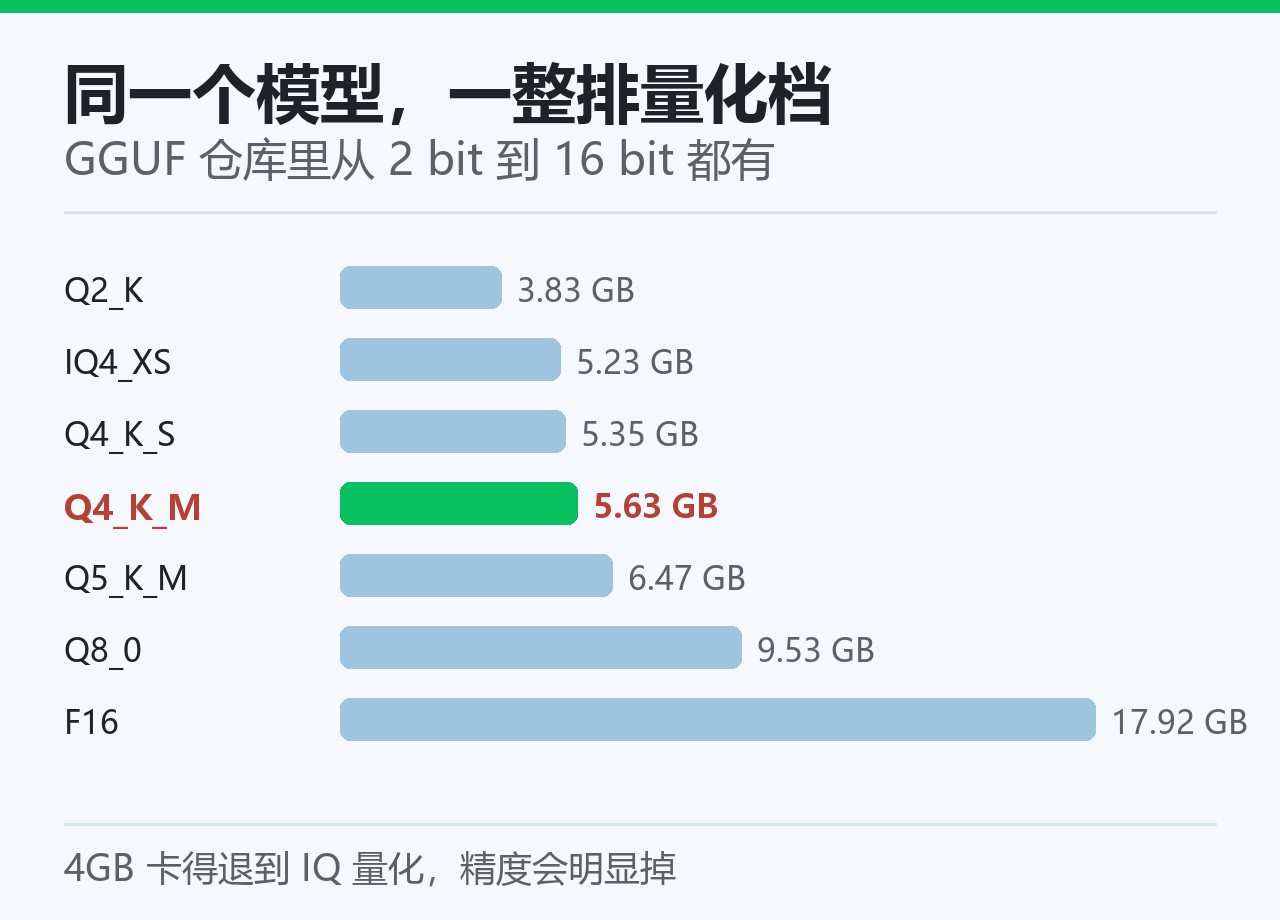
这个区别不是抠字眼。9B 模型的推理速度、显存占用、能力上限,跟 5.6B 完全不是一个量级;而 5.63 GB 只是「这一个文件占多少磁盘」。把两者混起来,就会得出「核显本也能秒开」这种过于乐观的结论。
还有个容易漏的细节:主仓库的架构字段是 Qwen3_5ForConditionalGeneration,目录里有 preprocessor_config.json、processor_config.json 和 video_preprocessor_config.json,也就是它带多模态能力。GGUF 仓库单独提供了 mmproj-Q8_0.gguf(624 MB)这样的视觉投影文件,只下主权重是跑不了图片的。
本机能不能跑:硬件够,软件栈得换
先看这台机器的实际配置,全部是这次实测读出来的:
| 项目 | 实测值 |
|---|---|
| CPU | Intel Core i9-14900HX,24 核 32 线程 |
| 内存 | 63.8 GB,可用约 35 GB |
| 显卡 | RTX 4060 Laptop,8188 MiB 显存,桌面占用约 1.6 GB |
| CUDA | 12.8(驱动 572.83) |
| 磁盘 | D 盘剩余 592 GB |
| 原有推理环境 | Ollama 0.6.6,已装 qwen2.5:7b 等三个模型 |
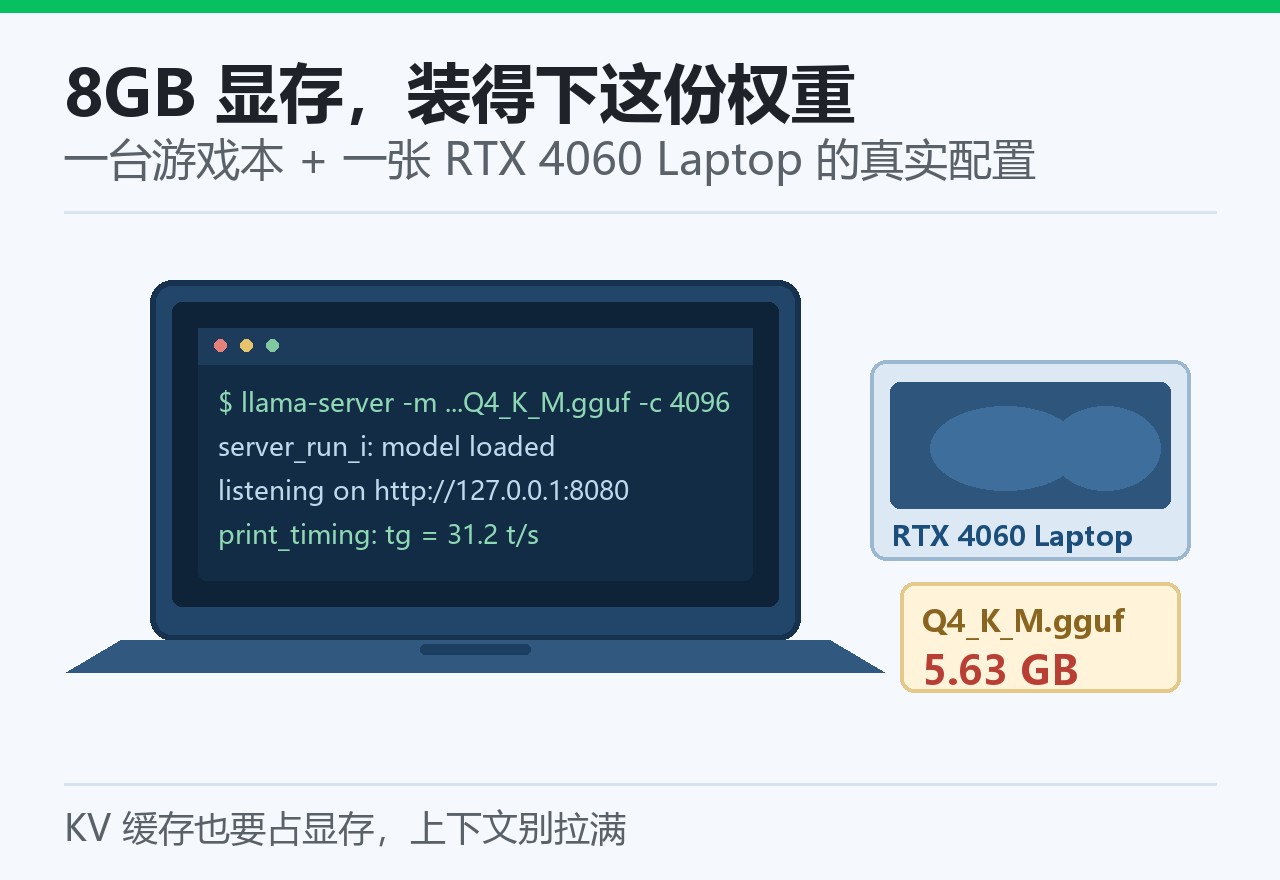
硬件这一关是过的。64GB 内存足够兜底,8GB 显存装 5.63GB 的 Q4_K_M 权重本身没问题,但权重之外还要给 KV 缓存和计算缓冲留位置,所以上下文不能照着 262K 拉满,实际用 4K 到 8K 比较稳妥。真要跑长上下文,得把 KV cache 也量化,或者接受部分层回落到 CPU。
卡住的地方在软件。本机 Ollama 是 0.6.6(2025 年 4 月),内置的 llama.cpp 太老,不认识 Qwen3.5 的 qwen3_5 混合注意力架构,直接导入会报未知架构。社区目前的经验值是:llama.cpp 从 b7990 起支持 qwen35 架构,从 b9180 起支持它的 MTP 预测头。这次我把推理引擎换成了 llama.cpp b12202 的 Windows 预编译包,绕开 Ollama 直接加载 GGUF。
另外下载链路也有个坑:本机代理会拦 huggingface.co 和 GitHub 的 release 直链,前者要走 hf-mirror 镜像,后者反而要关掉代理直连。单连接只有几百 KB/s,改成并发分块下载后才把 5.6 GB 拉完。这些都不写在任何一篇转述里,但真动手时一个都躲不过。
实测:先把九道题摆出来
用 llama.cpp b12202 的 Windows Vulkan 预编译包起了一个 OpenAI 兼容的本地服务,全部 32 层 offload 到 RTX 4060 Laptop,上下文设 4096,沿用 GGUF 内嵌的 chat template。加载后显存占用 6,932 MiB(桌面本身约占 1.6 GB)。采样温度 0.6、top_p 0.95、单轮对话。第一轮九道题平均 31.2 tok/s,最快 34.2、最慢 26.7;第二轮难题因为思考链变长,降到 23.8–28.7 tok/s。这台机器不但能跑,速度也够日常问答。
先说清楚「答对 7 题」到底答对了什么。下面是九道题的题面与实测回答:
| 题面 | 考什么 | 实测结果 |
|---|---|---|
| 小明买 3 盒铅笔,每盒 12 支,又单买 5 支;送同学 17 支后,剩下的平均分给 4 个小组,每组分几支 | 小学四则、多步算术 | 正确:36+5−17=24,24÷4=6 支,步骤完整 |
| 原价 240 元,先涨 25%,再按新价打八折,最终售价多少,比原价高还是低、差多少 | 小学百分比 | 正确:240×1.25×0.8=240 元,与原价持平、差 0 元 |
| 睡莲每天面积翻倍,第 30 天铺满池塘,第几天铺满一半 | 逆向一步推理 | 正确:第 29 天 |
| 光合作用主要场所:A 线粒体 / B 叶绿体 / C 细胞核 / D 核糖体;要求只输出一个大写字母 | 初中生物 + 格式遵循 | 严格输出「B」,思考链写了 1103 字符,最终只吐一个字母 |
| 把「张三、28 岁、杭州、会 Python 和 SQL」转成严格 JSON,键名 name/age/city/skills,不带代码块 | 结构化输出 | 合法 JSON,键名与类型都对 |
| 写 is_palindrome(s),忽略大小写和非字母数字判断回文,只输出代码 | 基础代码生成 | 函数逻辑正确,但多带了一层代码块标记 |
| 你是什么模型、谁开发的,不确定就直说 | 身份认知 | 自称通义千问、阿里巴巴,不提蒸馏与去审查 |
| Qwen3.5-9B 原生上下文多少 token,不确定就说不确定 | 事实性与幻觉 | 答 256K,公开资料标注 262,144(262K) |
| 用不超过 80 个汉字解释:16 位浮点权重量化到 4 位为何能显著减小 GGUF 体积 | 短文本生成 | 思考链陷入「1+1+1…」重复计数,1024 token 耗尽,正文为空 |
这九道题的难度上限只到初中:两道计算是小学四则和百分比,选择题是初中生物,睡莲题只考一步逆向。所以「7/9」能证明的是基础推理和格式遵循可靠,完全推不出它能不能做中考、高考、考研或算法竞赛。转述里拿模型卡的 GSM8K 94.50% 直接换算成「能解高考题」,中间隔着的正是这道坎。
另外三条也别漏:事实性上,问 Qwen3.5-9B 的原生上下文,它答成常见的 256K 而不是 262,144,思考链里还显得很有把握;身份认知留在基座,不提 DeepSeek 蒸馏也不提去审查;代码题的函数逻辑没问题,但「只输出代码」没被完全遵守。模型卡 Limitations 里那句「underspecified tasks 上行为不稳定」,这次真撞上了。
换一组真有区分度的题:中考到算法竞赛
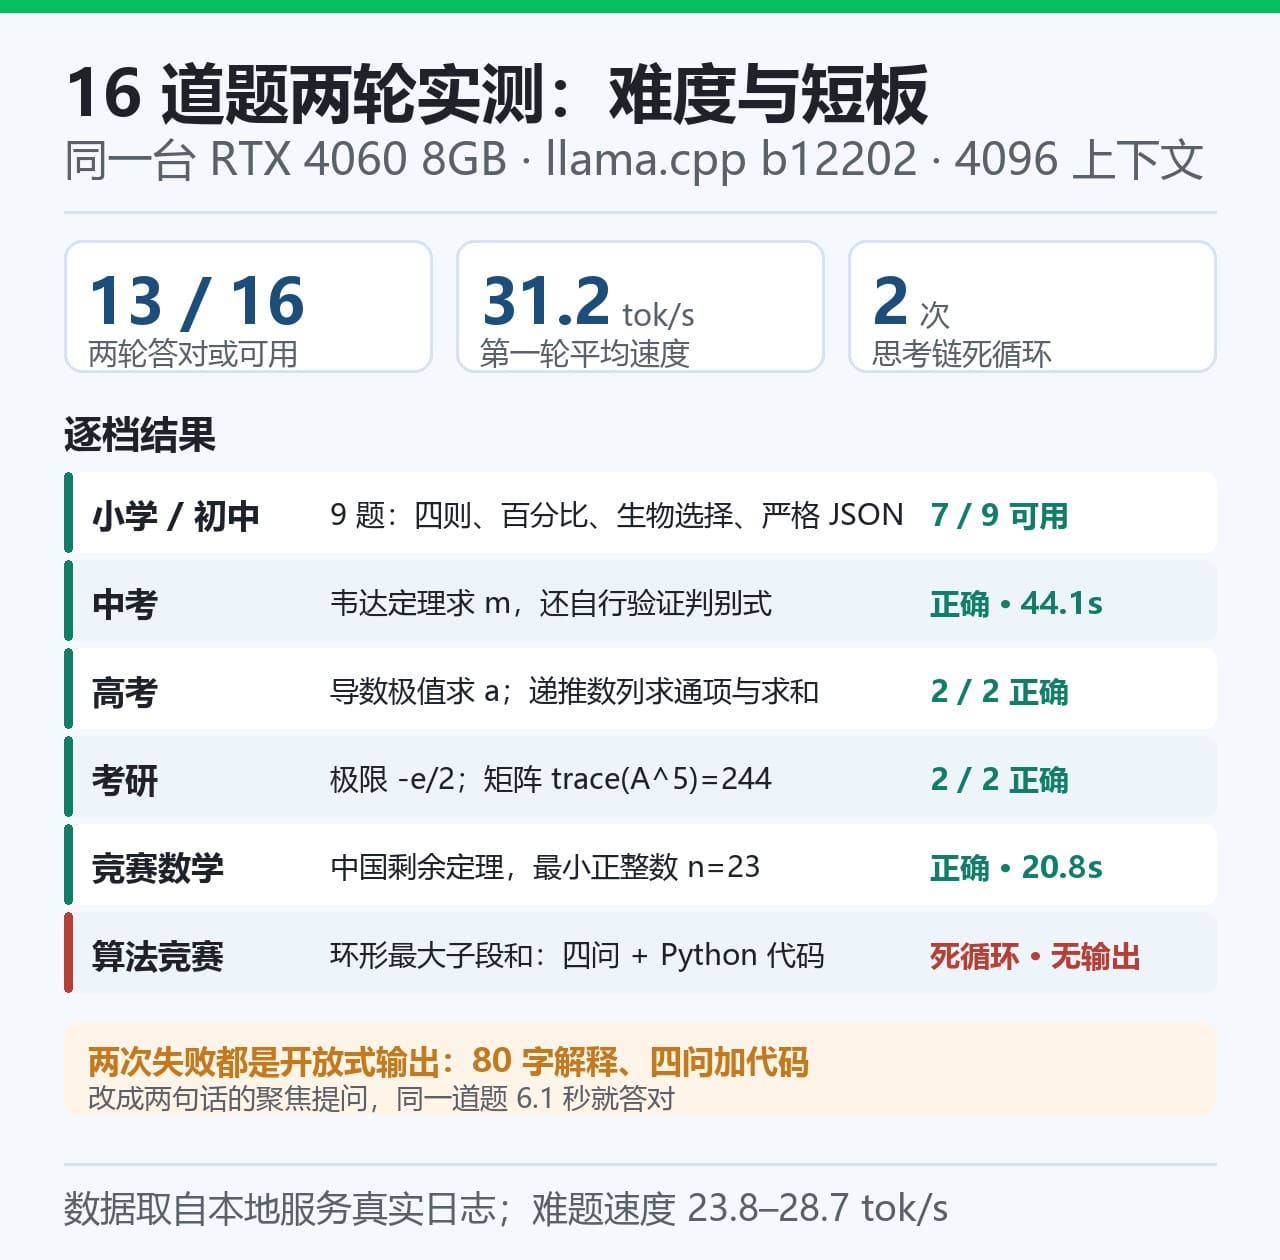
第二轮另出 7 道,每道都有唯一可核对的标准答案,按考试档位排开。同一台机器、同一套采样参数,只把 max_tokens 放宽到 3072(4096 上下文里留给思考链的余量)。
| 档位 | 题目 | 标准答案 |
|---|---|---|
| 中考 · 韦达定理 | 方程 x²−(2m+1)x+m²+m=0 两根满足 x₁²+x₂²=13,求 m 的所有取值 | m=−3 或 m=2 |
| 高考 · 导数极值 | f(x)=x³−3ax+1(a>0)在 x=1 取极小值,求 a 及 [−2,2] 上的最大值 | a=1;最大值 3 |
| 高考 · 递推数列 | a₁=1,aₙ₊₁=2aₙ+1,求通项 aₙ 与前 n 项和 Sₙ | aₙ=2ⁿ−1;Sₙ=2ⁿ⁺¹−n−2 |
| 考研 · 极限 | lim(x→0) [(1+x)^(1/x) − e] / x | −e/2 |
| 考研 · 线性代数 | A=[[2,1],[1,2]] 的全部特征值,以及 trace(A⁵) | 特征值 3、1;trace=244 |
| 算法竞赛 | 环形数组最大子段和:① 普通情形思路 ② 环形转化与特判 ③ 复杂度 ④ 写出 Python 函数 | Kadane;总和−最小子段和;全负特判;O(n)/O(1) |
| 竞赛数学 | 除以 3 余 2、除以 5 余 3、除以 7 余 2 的最小正整数 | 23 |
结果:6 道答对,1 道彻底失败。
| 档位 | 结果 | 用时 / 生成 token |
|---|---|---|
| 中考 · 韦达定理 | ✅ 正确,还自行补了 Δ=1>0 验证两根实存 | 44.1s / 1223 |
| 高考 · 导数极值 | ✅ a=1、最大值 3 | 14.0s / 383 |
| 高考 · 递推数列 | ✅ 齐次解加特解完整推导,Sₙ 正确 | 45.7s / 1217 |
| 考研 · 极限 | ✅ 泰勒展开到 x³ 项,得 −e/2 | 120.6s / 2945 |
| 考研 · 线性代数 | ✅ 特征值 1、3,trace(A⁵)=244 | 47.7s / 1138 |
| 算法竞赛 | ❌ 3072 token 耗尽,正文为空 | 126.7s / 3072 |
| 竞赛数学 | ✅ n=23 | 20.8s / 520 |
数学能力一路延伸到考研高数与线代都没掉。极限那题展开到 x³、跑了 120.6 秒、用掉 2945 token(几乎顶到 3072 上限),结果仍是精确的 −e/2;中考题还额外验了判别式。它不是只会做小学应用题,这一点比第一轮的印象强得多。
失败的那道更值得细看。思考链有 12,827 个字符,开头 300 字里就把正确方案写全了:普通情形用 Kadane,环形转化为「总和 − 最小子段和」,全负数组单独特判。之后它卡在「空子数组算不算合法」这一个边界上反复自我驳斥,empty 一词出现 32 次,直到 token 用尽也没进入正文。也就是:它会做,但收不住尾。
为了确认不是「不会算法」,我把同一道题改成两句话的聚焦提问(不要代码、不分点、不展开),同一服务重跑:6.1 秒、191 字符思考链,答案完整正确。再问一道只要 Kadane 代码的简单题:6.0 秒给出可运行函数(仍多带一层代码块标记)。同一道题,四问加代码就死循环,两句话就秒答,差别不在知识,在输出组织与终止控制。
把两轮并起来看,边界非常整齐:唯一两次彻底失败,一次是「80 字中文解释」,一次是「四问 + 写 Python 代码」,都是开放式、需要自己组织长输出的任务;而所有「收敛到一个确定数值或确定字母」的封闭题,从小学算术到考研高数,全部答对。
相当于什么级别的模型,能顶哪些活
先看 GSM8K 94.50% 这个数字该怎么读。GSM8K 是 8,500 道小学数学应用题、每题 2–8 步运算,2025 年起已被公认饱和,头部模型约 97%。GPT-4 当年 8-shot CoT 是 92%,o1 是 94.8%——所以 94.50% 放在榜单上,大致是「2023–2024 年 GPT-4 档」的位置,但这已经是所有像样模型都能拿到的分数,区分度接近于零。
最能说明问题的是 AIME:GPT-4o 在 AIME 2024 只有 13.4%,o1 单次 74.0%,DeepSeek-R1 79.8%。GSM8K 都在九十分段,竞赛数学却差出几十个百分点。公开资料说得更直接:一个模型的 GSM8K 分数对它的 AIME 表现几乎没有任何预测价值。所以「94.5%」既不能证明它能做高考压轴,也不能证明它是 o1 级。
基座 Qwen3.5-9B 的第三方榜单成绩是 MMLU-Pro 82.5、GPQA Diamond 81.7、LiveCodeBench 65.6。模型卡里那个「官方版 89.60%」是数学、物理、化学各抽 500 题共 1500 题的口径,跟完整 MMLU-Pro 的 12,032 题不是一把尺子,别直接相减。
中文场景有个更直观的坐标:2026 年新高考 I 卷数学整卷(19 题、150 分),新京报请两位高中数学教师阅卷,六款云端推理模型拿 137–148 分,基础题全员满分,差距全在压轴解答题和过程规范;山东大学团队另一次 8 模型同卷评测里,前 18 题多能拿满,唯一失分集中在第 19 题最后一小问。这些是旗舰级云端模型的成绩,不能拿我这里的单题实测直接比分,但它说明「高考整卷」考的是长链稳定与论证规范,不是单道中等题能否算对——恰好是这个 9B 最容易翻车的地方。
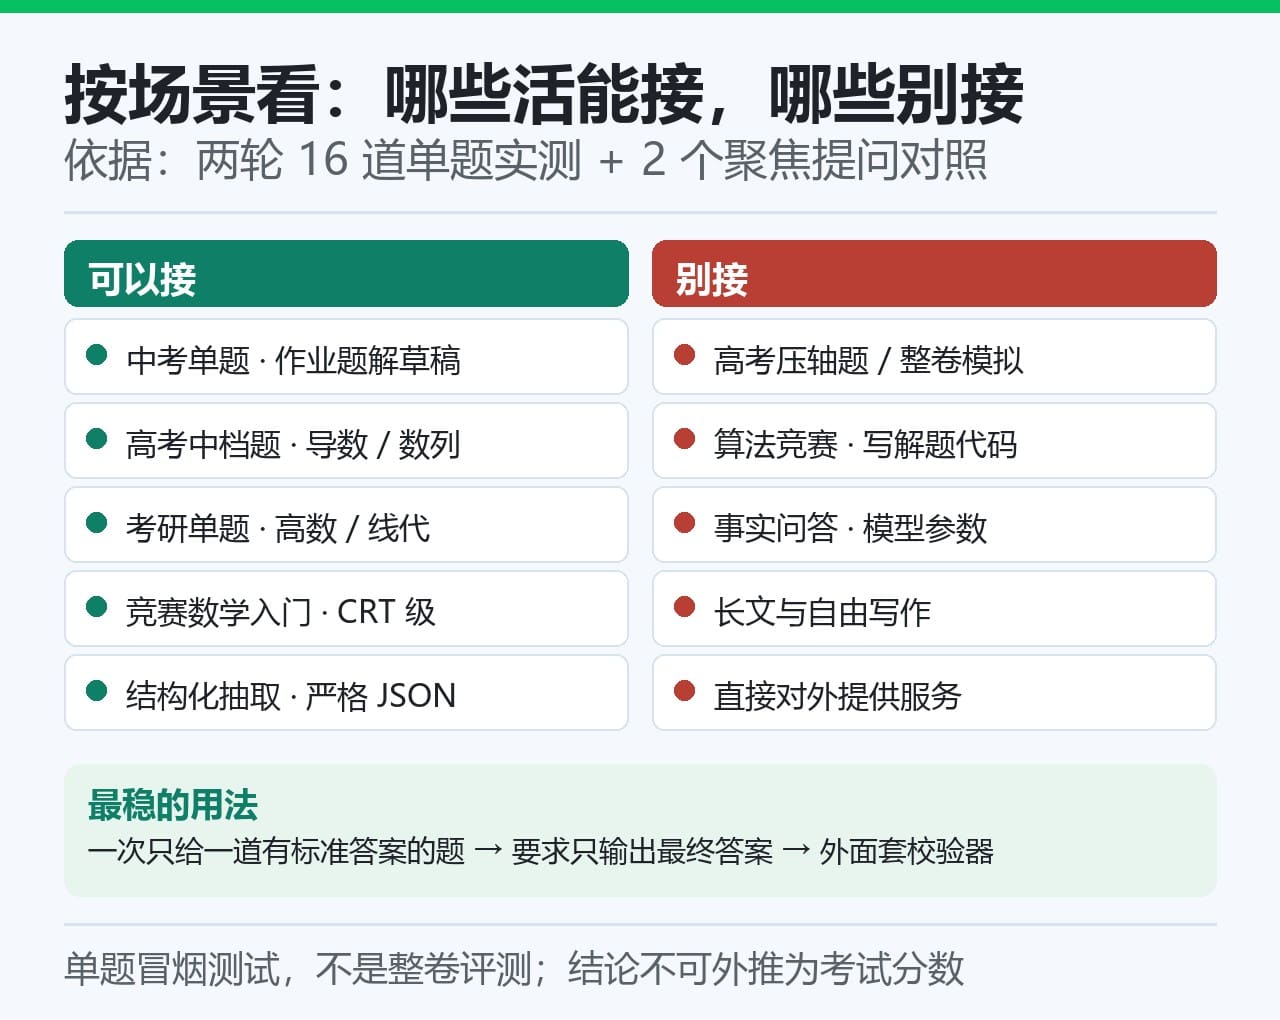
所以更贴切的定位是:在「有唯一确定答案的数理题」这一窄口径上,它接近上一代旗舰推理模型的手感,单题能一路做到考研高数与线代;但它不是任何旗舰模型的缩小版。把它想成「一台装进显卡里的数理答题机」,比「小号 GPT」准确得多。
| 实际场景 | 能不能用 | 依据 |
|---|---|---|
| 中考数学单题、作业题解草稿 | ✅ 可以 | 韦达定理题完整推导并自行验证判别式 |
| 高考数学中档题(导数、数列) | ✅ 基本可以 | 两题都对,推导完整 |
| 高考压轴题、整卷模拟 | ⚠️ 不建议 | 长链稳定与过程规范是短板;云端旗舰整卷也只 137–148 |
| 考研数学单题(高数、线代) | ✅ 可以 | 极限 −e/2、trace(A⁵)=244 均正确 |
| 竞赛数学入门(中国剩余定理、AMC 级) | ✅ 单题可以 | n=23;未测 AIME/奥赛级 |
| 算法竞赛、需要写解题代码 | ❌ 不行 | 训练无编码数据;四问加代码的题直接死循环 |
| 结构化抽取、固定格式输出 | ✅ 强项 | 严格 JSON、只输出一个大写字母 |
| 事实问答、长文与自由写作 | ❌ 不行 | 上下文长度幻觉;80 字解释死循环 |
真要用起来,最稳的姿势是:一次只给一道有标准答案的题,明确要求「只输出最终答案」,外面套一层校验器或答案库。这样它落在强项里,也能绕开收不住尾的毛病。反过来,别让它做开放式写作、代码主力、事实问答,也别直接对外提供服务。
必须说清口径:两轮共 16 道单题,外加 2 个聚焦提问的对照实验;全部是单轮对话、4096 上下文、Q4_K_M 量化的冒烟测试,不是整卷评测,更不是可外推的分数。
训练数据里没有一行代码
这一点模型卡写得非常明确,值得单独拎出来。
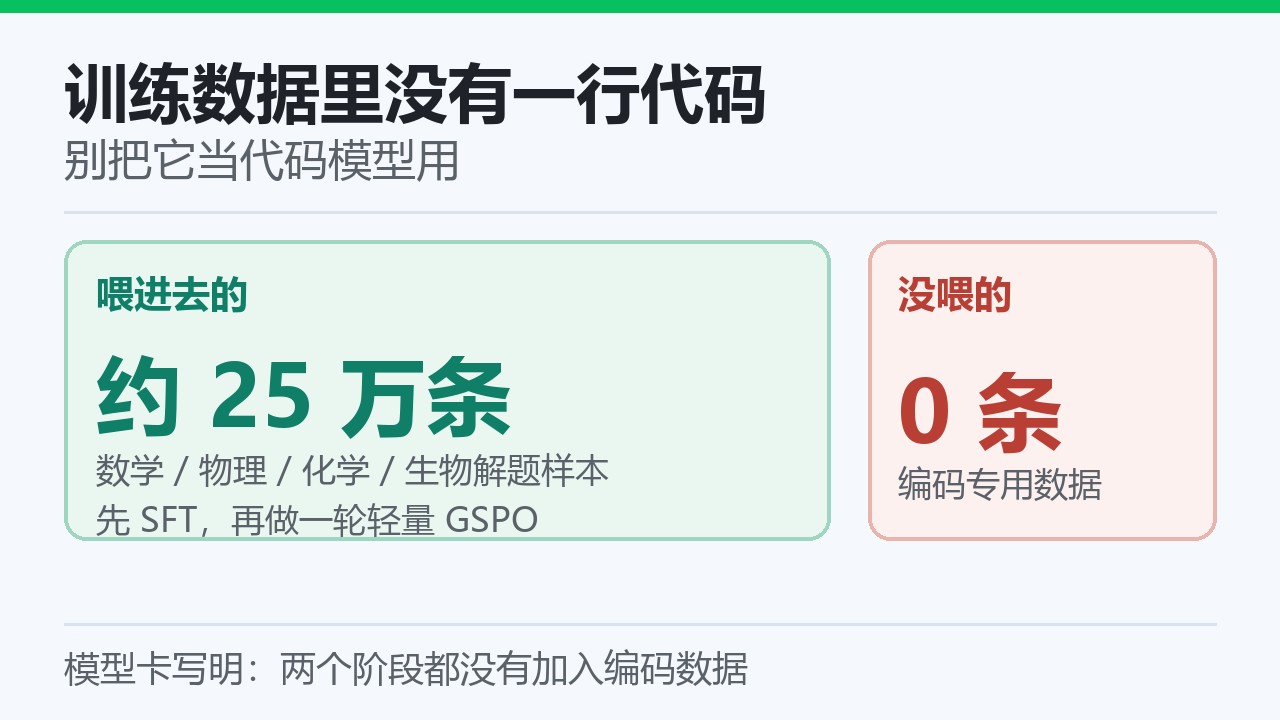
两个阶段(SFT 和轻量 RL)都没有加入任何编码专用数据。发布者观察到编程和工具调用上有小幅提升,但把它解释为「更强的推理结构带来的跨域迁移」,而不是代码训练的结果。模型卡还解释了原因:这一轮蒸馏准备时,DeepSeek 新发布的 0731 和 0813 模型在编码与 agent 能力上更强,对应的新教师数据还没来得及采集,后续会迭代补上。
上游给的评测数字也集中在这一块:GSM8K 四次平均 94.50%(NVFP4 + vLLM),MMLU-Pro 数学、物理、化学各抽 500 题共 1500 题,平均 90.53%,比 Qwen3.5-9B 官方版的 89.60% 高 0.93 分。另一个更有意思的指标是推理效率:同样 1500 题,每答对一题消耗的推理 token 从 4,938 降到 3,157,少约 36%;要求「只输出一个大写字母」时,格式遵循率 97.2%,官方版只有 37.3%。
这些数字都要带口径读。模型卡自己在 Limitations 一节写了四条:这是实验性的 9B 社区模型,仍会有幻觉、推理错误和不稳定表现;MMLU-Pro 是每科抽样 500 题,不是完整能力或安全评估;GSM8K 与 MMLU-Pro 用了不同的推理构建和后端,不能据此推断量化等价;高风险数理和事实输出要独立验证。把它们当成第三方复现的客观结论,是不成立的。
「零损耗去审查」该怎么读
这是传播里最吸引眼球、也最需要降温的一段。
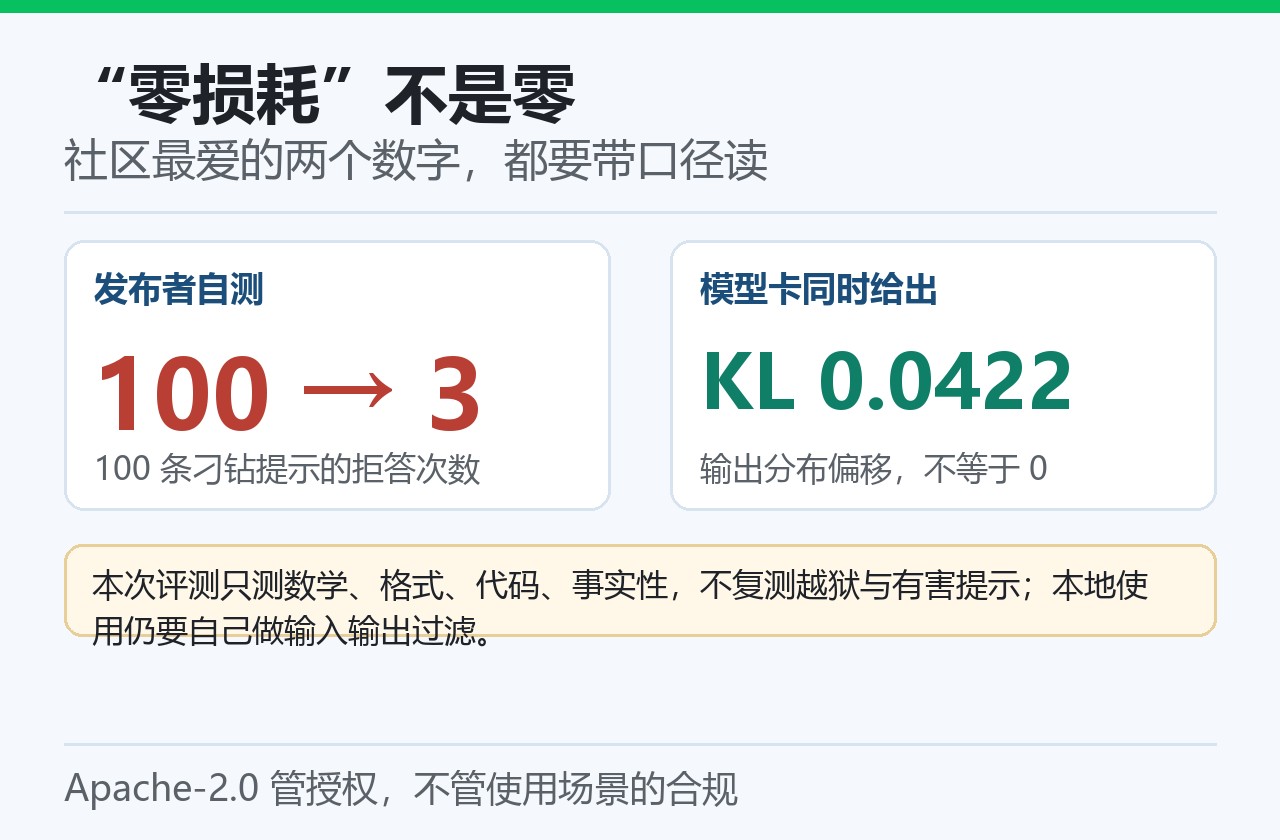
xtools-at 的模型卡给出 ARA 的具体参数:改第 9 到 24 层,保留好行为权重 0.8264、邻居数 12,结果是 100 条提示的拒答从 100 次降到 3 次,同时给出 KL 散度 0.0422。Heretic 是 2026 年 11 月 1 日发布 v2.0 的开源工具,默认用 Optuna 的 TPE 优化器搜 100 组参数,同时最小化拒答率和 KL 散度——后者就是用来约束「别把模型改傻」的。
所以「零损耗」这个说法,准确讲是「损耗很小」,0.0422 不是 0。而且这两个数字都来自发布者自测,题集版本和逐条输出没有公开,第三方复现目前还缺。已有独立研究(arXiv:2512.13655)比较过几种消融工具,结论是数学推理受消融影响最大,GSM8K 分数波动从 +1.51 到 −18.81 分不等——这提示「去审查」和「保住推理能力」之间存在真实的张力。
本次评测不测越狱与有害提示,只覆盖数学、格式遵循、代码、结构化输出和事实性这些通用能力。需要说明的是,去掉拒答不等于内容合法,Apache 2.0 解决的是代码和权重的授权,解决不了使用场景的责任。这类权重适合本地研究和隔离环境里的实验,直接接到对外产品上,输入输出过滤和合规审查仍然要自己做。
结论:一张表说清适合与不适合
| 适合 | 不适合 |
|---|---|
| 离线跑有标准答案的数理单题(中考到考研) | 高考压轴、整卷评测、算法竞赛解题 |
| 一次一题 + 外部校验器的题解/批改流水线 | 开放式写作、长文本生成、事实问答 |
| 要求严格输出格式的结构化抽取 | 当代码主力模型(训练无编码数据) |
| 私有化、数据不出机器的实验环境 | 直接接对外产品(缺安全对齐与过滤) |
| 8GB 显存以上、能折腾推理引擎的机器 | 指望「核显本秒开」或开满长上下文 |
它真正值得看的地方,是把大模型的结构化解题过程压进了一个 9B 的小模型,数学单题能一路做到考研高数,格式遵循也做得比基座干净得多;代价是开放式输出容易收不住尾。「无审查」更像是传播中附赠的标签,不是能力来源。
最后再核对一遍那几个被转烂的数字:不是 5.6B,是 9B 参数、5.63 GB 量化文件;不是混血,是蒸馏;不是零损耗,KL 散度 0.0422;「1.8 万次下载」是几天前的旧数,11 月 8 日查 HF API,主仓库近 30 天 7,088 次、静态量化仓库 144,783 次、i1 量化仓库 136,706 次——热度是真的,但不同仓库口径差得很远,引用时得说清是哪一个。
看到这类名字很长的社区模型,问三个问题基本够用:谁蒸馏的、基座是什么;谁改的权重、动了哪些层、KL 多少;谁量化的、哪个档位。名字里带一个大模型,不代表它就是这个大模型。
参考资料
- Hugging Face 主仓库模型卡:https://huggingface.co/xtools-at/DeepSeek-V4-Pro-Qwen3.5-9B-UNCENSORED-heretic
- 上游蒸馏版模型卡(含 benchmark 与 Limitations):https://huggingface.co/Jackrong/DeepSeek-V4-Pro-Qwen3.5-9B
- GGUF 量化仓库与文件清单:https://huggingface.co/mradermacher/DeepSeek-V4-Pro-Qwen3.5-9B-UNCENSORED-heretic-GGUF
- Heretic 项目(v2.0 / ARA / AGPL-3.0):https://github.com/p-e-w/heretic
- llama.cpp 预编译发布页:https://github.com/ggml-org/llama.cpp/releases
- 独立消融工具比较(arXiv:2512.13655):https://arxiv.org/abs/2512.13655
- HF-Mirror 镜像站:https://hf-mirror.com/
- GSM8K / MATH / AIME 基准难度与饱和度对照:https://jonathanding.github.io/llm-learning/en/articles/reasoning-benchmarks
- 2026 新高考 I 卷数学六模型评测(新京报,教师阅卷):https://www.bjnews.com.cn/detail/1780914137169182.html
- 山东大学 8 模型高考数学同卷评测:https://mathfinance.sdu.edu.cn/info/1277/7734.htm
- Qwen3.5-9B 公开榜单成绩汇总:https://llmlearner.com/models/qwen3-5-9b
微信公众号
欢迎关注「字与码」
如果这篇文章对你有用,也欢迎在微信里继续关注后续更新。
X / Twitter
关注 @ax2_zicode
更即时的技术观察、新文章提醒和一些短想法会发在 X 上。