LLM Wiki 深度评测:对话产出接进 Agent 知识库,能走多远
本文完全由 WorkBuddy 独立收集资料、调试代码并完成文章写作。
我是 Alex Xiang,前百度/微博工程师,现在专注于 AI 工程与工具产品。更多文章欢迎关注微信公众号「字与码」。
如果你在运营一个 Agent 产品,大概遇到过这个场景:用户上周在对话里跟你敲定了一套方案,这周他回过头问「上次那套方案最后是怎么定的」,你只能让他自己去翻历史会话列表。
对话产出是这个时代最被浪费的一种资产。它天然包含高价值内容——架构决策、排障结论、方案对比、接口约定——但它的载体是一次性的会话记录,问完就沉底。产品能做的通常只是「历史记录」和「关键词搜索」,这两样东西都解决不了「结论在哪里」的问题。
LLM Wiki 是这两年针对这个问题冒出来的一个技术路线。它的主张有点反直觉:不要建向量库,让模型把源材料编译成一部相互链接的 markdown wiki,然后持续维护它。
我把这条路线从原始设计到三个现成实现都过了一遍,也在一台 Windows 机器上把它装起来跑了完整流程。这篇文章讲清楚三件事:它到底怎么工作、把对话产出接进已有 Agent 产品有哪些具体走法、以及它的天花板在哪里。
一份 idea file 引出的路线
2026 年 4 月,Andrej Karpathy 发了一份 gist,标题就叫 LLM Wiki。他自己说这不是一个工具、一个包或一段脚本,而是一个「idea file」——设计意图就是让你复制粘贴给自己的 Agent,让 Agent 和你一起把它落地成具体的实现。
这份 gist 的核心论述很短:现在大多数人用 LLM 处理文档的方式是 RAG——上传一堆文件,模型在提问时检索相关片段,拼出答案。这能用,但模型每问一次就要重新发现一次知识。让它综合五份文档回答一个微妙的问题,它每次都得重新找、重新拼。什么都不会积累下来。
他提的方案是:让模型增量地构建并维护一部持久 wiki,夹在你和原始材料之间。加一个新源,模型不是把它索引起来等以后检索,而是读它、抽取关键信息、把它整合进已有 wiki——更新实体页、修订主题摘要、标注新数据在哪里与旧结论冲突、强化或挑战正在演化的综述。
一句话概括他的立场:知识编译一次,然后保持最新,而不是每次查询都重新推导。
gist 里最值得记住的其实是那个比喻。他说自己实际的工作状态是一边开着 LLM agent,一边开着 Obsidian,agent 按对话改文件,他实时浏览结果、跟链接、看图谱视图、读更新过的页面。然后他给这层关系定了性:
Obsidian 是 IDE,LLM 是程序员,wiki 是代码库。
这个比喻解释了很多设计取舍——为什么坚持纯 markdown、为什么要有版本控制、为什么「编译」这个词不是修辞。你在做的是一个构建过程,产出物是一个有结构的工件,不是在跟 AI 聊天。
他列了几个适用场景,其中两个和我们的问题直接相关:研究——几周几个月深挖一个主题,读论文、读文章、读报告,逐步积累出一部带演化论点的 wiki;团队场景——由 LLM 维护的内部 wiki,由 Slack 讨论、会议记录、项目文档、客户通话喂养,可能配人在回路里审阅更新,理由是「没有哪个团队成员愿意做的那种维护工作,LLM 不会嫌烦」。
最后那句其实就是在说对话产出这件事。
检索和编译,差的不只是快慢
很多人把这两条路线理解成新旧之分,我觉得这个理解是错的。它们真正的区别在于成本落在哪个阶段。
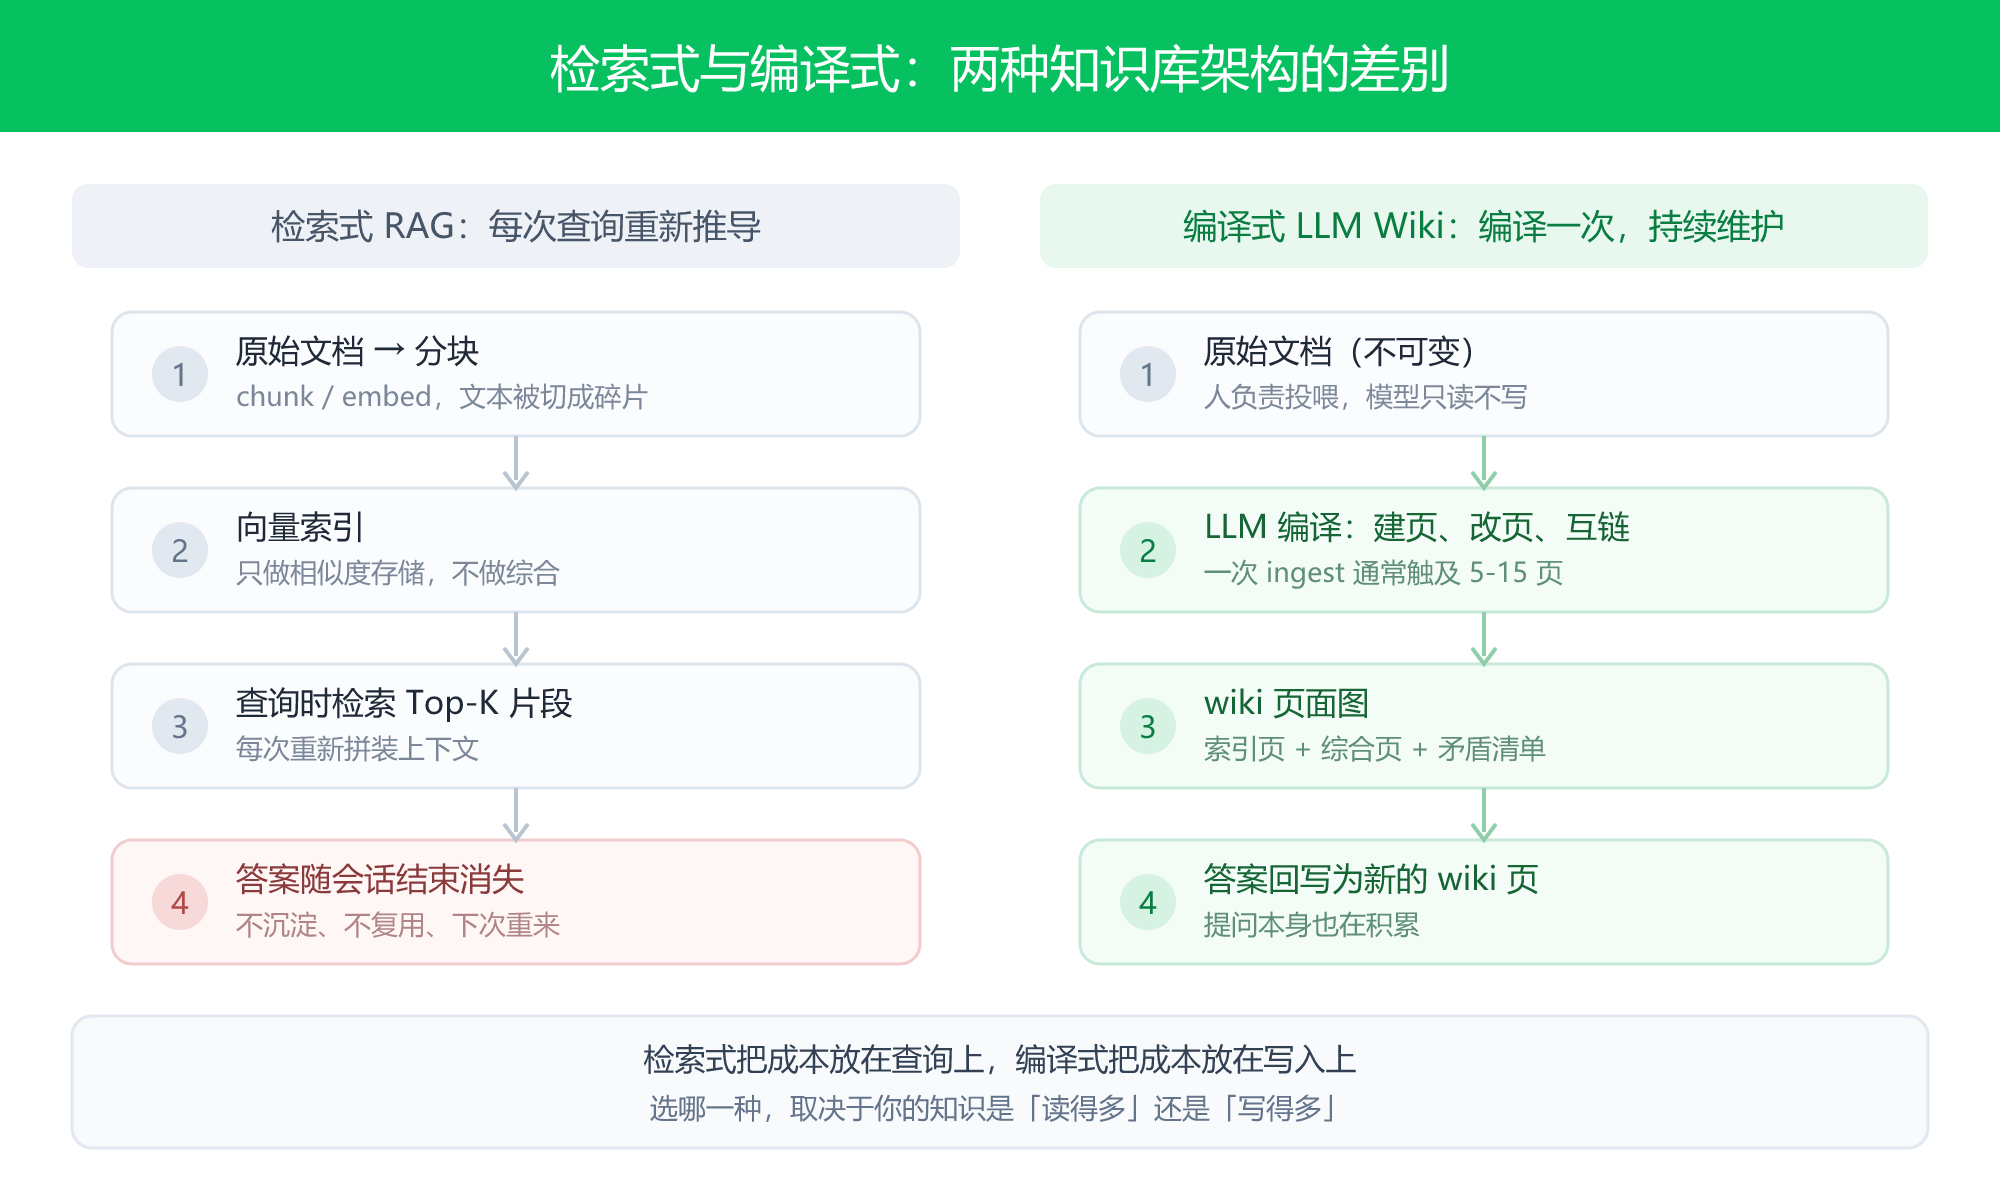
检索式把成本放在查询侧。写入很便宜——分块、算 embedding、进索引,几分钱的事。读的时候贵一点,每次都要检索、重排、拼上下文。好处是规模不敏感:你的语料涨到十万份文档,检索质量不会崩,只是召回率变差,可以靠重排和分块策略去调。
编译式把成本放在了写入侧。一次 ingest 要读源、找到所有相关页面、读它们、改它们、确保改完之后页面之间仍然一致、最后更新索引和日志。Karpathy 给的数字是「单个源可能触及 10 到 15 个页面」。这个成本是实打实的 token 消耗,而且它随 wiki 规模增长——wiki 越大,一次 ingest 要读到和改到的页面越多。
代价换来的东西是:检索侧几乎免费。因为答案已经被编译成页面了,查询只需要导航索引加读几个页面——读的是压过的页面,不是原始文档,token 消耗自然低一个量级,顺带也规避了长上下文里「中间内容被忽略」的老问题。
那什么时候该选哪一边?我的看法是用一个很粗的判断:
| 判断维度 | 偏向检索式 | 偏向编译式 |
|---|---|---|
| 语料更新频率 | 每天大量新增 | 按周按月增量 |
| 内容形态 | 异构、非结构化 | 有共同主题、可归类 |
| 查询模式 | 开放式、不可预测 | 反复问同类问题 |
| 答案性质 | 一次性的、查完就丢 | 需要沉淀、需要被引用 |
| 溯源要求 | 每个断言都要精确定位 | 页面级溯源够用 |
| 规模 | 十万份以上 | 数百页量级 |
对话产出这个场景几乎全落在右边,尤其是「反复问同类问题」和「需要沉淀」这两条。团队里「我们为什么选了这个方案」这种问题会被问一百遍,而且每次问都应该是同一个答案。这正是编译式擅长的。
反过来说,如果你的知识库是面向任意用户的开放问答、语料每天都在变,编译式会让你疲于奔命。
三层结构里最容易被低估的是规范层
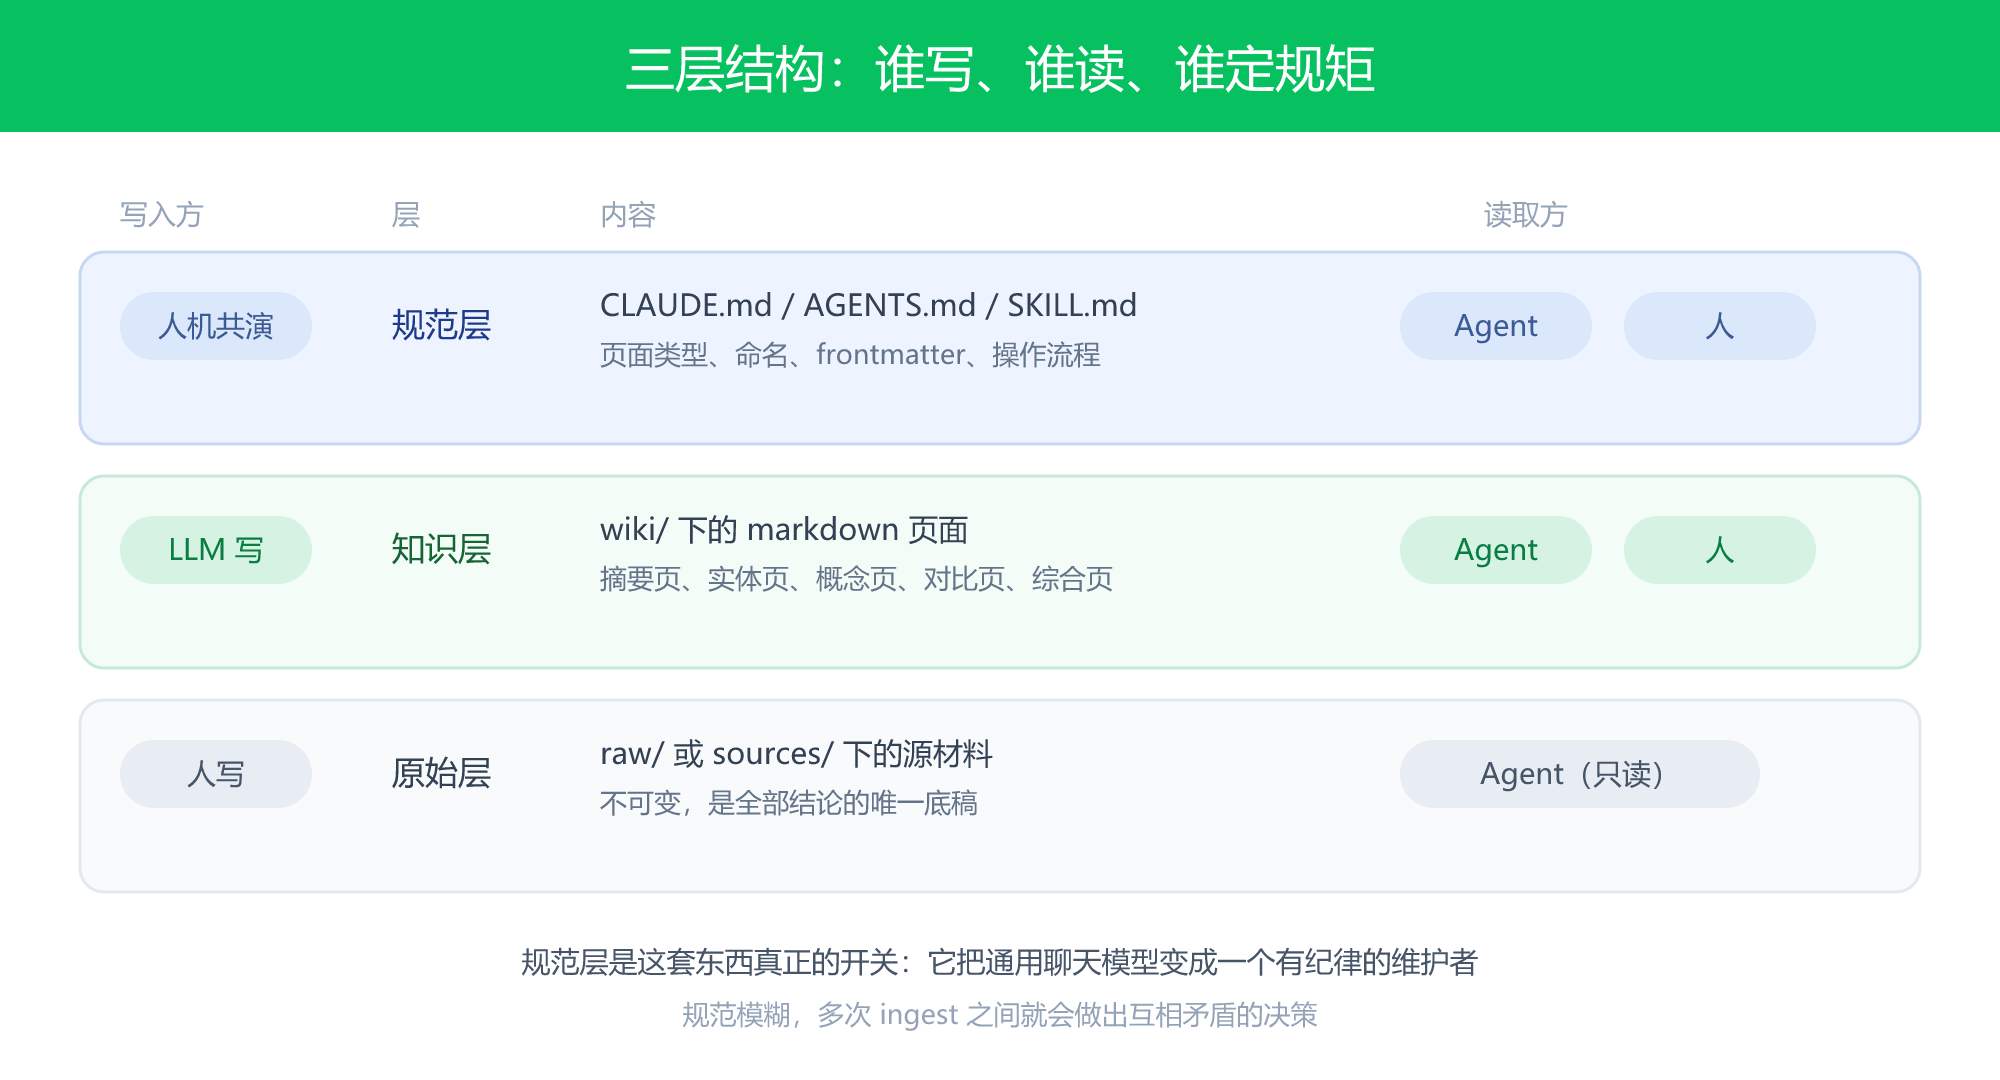
架构上这三层很朴素:
原始层是不可变的源材料。人负责往里放,模型只读不写。这一层是整个系统的底稿,所有结论最终都要能追溯到这里。
知识层是模型生成和维护的 markdown 页面——摘要页、实体页、概念页、对比页、综合页。人读,模型写。
规范层是一份告诉模型「这个 wiki 怎么组织、什么约定、ingest 时按什么流程走」的文档。在 Claude Code 里它叫 CLAUDE.md,在 Codex 里叫 AGENTS.md。
前两层很直观,第三层才是开关。Karpathy 说得很明确:这个配置文件是让 LLM 成为一个有纪律的 wiki 维护者、而不是一个通用聊天机器人的关键。它需要你和模型共同演化。
为什么它这么关键?因为模型的每一次 ingest 都是一次没有记忆的独立会话。它当次的「理解框架」取决于这一次上下文里装了哪些页面、提示词的细微差别、以及采样随机性。规范是唯一跨会话稳定的东西。
我看到过一个很到位的批评:wiki 的质量上限就是规范的质量。约定模糊或前后不一致,模型在不同 ingest 会话之间就会做出互相矛盾的决策。这不是模型能力问题,是规格说明问题。
这解释了为什么现成的实现都在这份文档上下了重功夫。我实测的那个 CLI 版本,初始化时往 .claude/skills/ 里放的规程文档是 315 行——里面定义了两套搜索路径怎么配合、页面 frontmatter 哪些字段必填、什么情况必须先跟用户讨论再动手、以及入库的准入判据。这些东西没有一条是模型能自己猜出来的。
三条实现路线,和一个跑通的
这条路线现在至少有四五个活跃实现。下面是三条典型路线——其中只有纯 CLI 那个我装到本机、跑通了从初始化到入库的完整流程,另外两个的依据是官方文档和仓库结构。
第一个是纯 CLI。装完看依赖清单有点意外:运行时只依赖三个包(commander、gray-matter、toml)。它的卖点是把基础设施压到最薄——不配向量库也能跑,搜索走 BM25,只要 markdown 和模型。许可证是 Apache-2.0。
这里有个反转值得单独说。它唯一的可选依赖是 pg,接上一个叫 DB9 的 Postgres 兼容服务之后,sync 会把页面的 embedding 推上去,search 就变成 BM25 加向量两路召回,再用 RRF 融合排序。也就是说,这个打着「不需要向量基础设施」旗号的实现,自己给自己留了一条向量退路——可选、后加、默认关闭。这个细节比任何口号都更能说明工程上的真实取舍:路线之争在理念上可以很纯粹,落到代码里总得留一道后门。
第二个是桌面应用。Tauri v2 加 React 19,三栏布局——左边知识树、中间聊天、右边预览,配套 Chrome 剪藏插件和本地 HTTP 服务。这条路线的定位很清楚:Obsidian 是原设计推荐的人机界面,但让普通用户先去装 Obsidian 再理解 wikilink 语法,门槛太高,所以干脆自己做一个。
第三个是托管版路线。还有一批实现走的是「开源 CLI 先行、hosted 版跟进」的路子,底层还是同一套 markdown wiki,用户可以选云端前沿模型或本地 Ollama 跑,按操作单独指定。
三个实现的共同点比分歧更有意思:都坚持纯 markdown 落盘、都把源材料和编译产物物理隔离、都依赖一份会话启动时自动加载的规程文档、都提供 lint 做健康检查。这四条是这条路线真正的内核,其余都是工程选择。
然后我撞上了一个 bug。第一次初始化,我用绝对路径:
node cli.js init C:\Users\ax2\WorkBuddy\...\my-wiki直接崩了:
Error: ENOENT: no such file or directory, mkdir
'C:\Users\ax2\WorkBuddy\2026-09-14-11-25-17\C:\Users\ax2\WorkBuddy\...\my-wiki\wiki'路径被拼了两遍。看拼法就知道成因:它把传入的路径当成相对路径无条件地 resolve 了一次,绝对路径没做处理。换成相对路径就正常了。
这个 bug 本身不重要——是个十分钟能修的小问题。但它说明一件更值得注意的事:这条路线目前还处在「开发者自用」阶段,作者们的主要使用方式是在项目目录里敲相对路径。这类实现的成熟度,和它 README 里描述的能力之间,是有落差的。
同一个包里还有一处落差。README 花了相当篇幅讲「四个聚焦技能」的目录布局——ingest、query、lint、research 各自一份 SKILL.md,说这样符合 Agent Skills 规范、能被更多工具自动发现。但我装上 npm 上最新的 0.5.1 版跑完 init,.claude/skills/ 里只有一个扁平的 llm-wiki.md。四技能拆分和规范目录布局(skills/<name>/SKILL.md)都是仓库主干后来才做的重构,提交记录摆在那里,npm 上的包还没跟上。
这不是攻击,是一个很实际的评估结论:如果你打算基于它做产品集成,要按仓库而不是按包来评估。README 描述的是主干,你装到的是上一个发布点。
编译出来的 wiki 到底长什么样
初始化之后的目录结构是这样的:
my-wiki/
├── CLAUDE.md            # Claude Code 会话启动时自动加载
├── AGENTS.md            # Codex 侧同一份
├── wiki-purpose.md      # 人写的范围定义,模型只读
├── wiki-schema.md       # 页面类型、命名、frontmatter 约定
├── wiki-agent.md        # 行为规则(可选)
├── wiki-log.md          # 追加式操作日志
├── wiki/                # 模型写的知识层
├── sources/             # 不可变源材料,按日期分区
├── .claude/skills/
├── .agents/skills/
└── .llm-wiki/
    ├── config.toml
    └── sync-state.json  # mtime + 内容哈希
我按它的规程真实跑了一次完整入库,源材料是一份中文的对话记录——正是那种「团队讨论后敲定了几条决策」的会议材料。按规程的 13 个步骤走完,产出是 5 个新页面加 2 个页面更新。
跑完之后工具能给出这些东西:
Wiki: My Wiki
Language: en

Pages:   11
Sources: 1
Links:   40
Log:     2 entries

Health Issues:
  ⚠ 1 pages without sources
  ⚠ 4 broken wikilinks
graph 命令的输出更有信息量:
Graph Analysis: 11 pages, 36 links

Top Hub Pages:
  [[llm-wiki-pattern]] — 7 outgoing, 6 incoming
  [[kb-integration-decisions]] — 5 outgoing, 6 incoming

Communities (1 detected):
  Cluster 1: contradiction-handling, index, integration-interface-forms, ...

Orphan Pages (1, no incoming links):
  [[index]]

Wanted Pages (2, linked but not created):
  [[context-window-inflation]] — linked from 3 page(s)
  [[karpathy]] — linked from 1 page(s)
「Wanted Pages」这一项是这套设计里我最欣赏的地方。它指的是被链接了但页面还不存在的条目——模型在写页面时如果引用了一个还没建页的概念,链接照写,于是这个词就变成一个显式的待办。这是把「知识缺口」从一种感觉变成了一行可以查询的数据。同样的思路也用在 orphan(没人链过来的页面)和 hub(连接数最多的页面)上。
我也顺手把几个真实的毛病记了下来。
指标口径是两套。status 报「4 broken wikilinks」,graph 报「2 个 wanted page 被引用 4 次」。一个在数链接,一个在数页面。如果你要把它接进产品的监控面板,得先决定信哪个。
索引页会污染关键词搜索。我搜 mcp,排第一的是索引页(得分 2.16),而真正讲 MCP 的页面排第二(1.98)。原因不难猜:索引页列出了所有页面的 slug,天然包含全部关键词。这不是分词问题,是排名问题——索引页在 BM25 里应该被降权或排除,否则它永远是噪音。
社区检测在单主题的小库上没有信息量。11 个页面只检出 1 个社区——全部页面在一个簇里。这个功能要等到 wiki 里真的有多个主题板块时才有意义。
中文分词是真的能用的。这条我自己先搞砸了一次。最早用 PowerShell 调命令行搜索「知识库」,返回 0 命中,我差点得出「中文支持不行」的结论。但输出里的关键词变成了乱码,说明参数在我这侧就已经被编码破坏了。换成用 node 直接传参重测:
=== search 知识库 ===
6 matches
  knowledge-admission-rules       Score: 5.7410
  kb-integration-decisions        Score: 4.7944
  integration-interface-forms     Score: 4.0639
  ...

=== search 准入规则 ===
5 matches
  knowledge-admission-rules       Score: 10.8458
  ...
中文检索完全正常,而且「准入规则」这种词能精确命中对应页面并给出两倍于次名的分数。技术上它用的是 CJK bigram——把中文按双字切分建索引,不需要外部分词器。这个坑是我自己的,写出来是因为如果你也在这类环境里做集成测试,很可能踩同一个:命令行测中文一定要确认参数编码,别让测量工具本身成为变量。
还有一处配置不生效。配置文件里 language 这一项填的是 en,但我的内容全是中文,工具照报 Language: en,不做任何校验。小问题,但它意味着「语言」这个字段现在只是个展示用标签,不参与任何行为决策。
对话产出怎么进库、又怎么回流
这是整篇文章里对你我这类做 Agent 产品的人最有价值的部分。
先把机制说清楚。现成实现里,触发入库的东西不是你敲的某条命令,而是放在会话启动时自动加载的那个文件里的一段判据。我实测版本的 CLAUDE.md 里写着:
### Default Behavior (when wiki-agent.md is absent)

- You maintain this wiki by ingesting information from sources you receive
- When you receive new information, evaluate whether it is wiki-worthy
- If wiki-worthy: update or create wiki pages using the /ingest workflow
- If not wiki-worthy: ignore silently
- You do not need explicit `/ingest` commands to act — any information input
that matches your ingest criteria should be processed automatically最后一句是重点:不需要显式下命令,任何符合入库判据的信息输入都应被自动处理。
判据本身分三类,直接摘原文:
- 必须收录:决策(谁在何时为何决定)、有结论的技术架构与设计讨论、任务状态变更、缺陷报告及其解决、新引入的概念/系统/流程。
- 可收可不收:尚未确认的想法与提案、工具与工作流讨论。
- 绝不收录:闲聊寒暄、凭据与个人信息、wiki 里已有的重复信息。
这个设计对接到产品上意义很大:你不需要在对话结束之后跑一个「总结会话」的批处理任务,你只需要保证对话本身发生在一个挂载了 wiki 规程的工作区里。沉淀是对话的副作用,不是额外流程。
不过只把对话当输入,是漏了一半。Karpathy 在 gist 里写了另一半,而且我认为这一半对做 Agent 产品的人更要紧:好的答案应该被归档回 wiki,成为新页面。他的原话是,你顺口要的一个对比表、一次分析、一个新发现的关联,都是有价值的,不该消失在聊天记录里——这样你的探索会和源材料一样,在知识库里复利。
现成实现把这一半做成了一个独立操作。query 的定义就是三步:搜 wiki、综合出答案、把其中有价值的洞察写回去,作者给这个动作起的名字叫 knowledge compounding。桌面版那个实现更直白——项目结构里专门留了一个 wiki/queries/ 目录,用途写的就是「已保存的聊天答案与研究」。
为什么我说这一半更值钱?因为 ingest 处理的是用户带进来的材料,写回处理的是你的产品自己生产的内容。前者用户用别的工具也能凑合,后者才是产品壁垒——它让产品的每一次输出都变成下一次的输入。回到开头那个痛点:如果只做 ingest,「上次敲定的方案」得是用户自己把对话贴进来才有的;做了写回,方案在对话里定下来的那一刻就已经落库了。
写回不是无条件的,否则 wiki 会被问答垃圾灌满。这一块现成实现反而做得比我预想的细——它把判据拆成了正反两栏。
正栏是「什么时候该复利」,四条满足其一:答案以此前没有记录过的方式连接了 3 个以上页面、答案消解了一处矛盾、答案用高置信度的综合填上了一个知识缺口、或者用户明确要求保存。反栏是「什么时候不该复利」:只是把某一页已有的内容查出来、答案主要依赖 wiki 之外的信息、综合本身是推测性的。
我认为这个正反两栏的写法本身就值得照抄。让模型判断「该不该写回」时,它真正需要的是排除项——只给一组肯定条件,模型倾向于把能解释的都解释成满足条件;补上一组明确的排除项,才能真正把大部分不该写的输出压掉。
还有一个设计细节值得注意:写回的页面在 frontmatter 里带一个 source_type: query-synthesis 标记,日志也用固定前缀区分。这意味着同一个库里,「从源材料编译出的页面」和「从问答里沉淀出的页面」是可区分的——你既能按来源筛选,也能在出问题时回查这一类页面的来历。做产品的话,这个字段是后面做质量审计和差异化处理的抓手。
回到入库这一侧,源材料怎么存也有讲究,而且这条很关键:规程明确要求按主题或日期切分,不准把一大堆内容塞进一个单体文件,举的例子就是「按天切聊天记录」或「按主题切讨论」。落到产品上就是:一次会话一个源文件,路径形如 sources/2026-09-18/<session-id>.md。
为什么粒度这么重要?因为增量。所有实现都用 mtime 加内容哈希来判断哪些文件变过。粒度越粗,任何一处补充都迫使整块重跑,增量机制就退化成全量重跑。这也是编译式最花钱的地方,粒度设计直接决定你的账单。
我按规程走完 13 步之后,量出来几个数字:单次 ingest 产出 5 个新页、更新 2 个已有页、写了 7 条日志、同步了 8 个文件(另外 4 个未变)。这比 Karpathy 说的「10 到 15 页」少,因为他假设的是成熟 wiki 里的深度整合;一个刚起步的库,第一次 ingest 触达面自然小。
执行过程中我记了两处摩擦,都是做产品集成时必然会碰到的:
第一,「先讨论」这条规程在自动化场景是个阻塞。规程的第 5 步写着:如果这次 ingest 会以非显而易见的方式改变结构、命名、范围、页面边界或链接策略,先跟用户讨论。这在交互式使用里是好设计——避免模型自作主张重排你的知识体系。但放到「对话产出自动沉淀」的自动化场景里,这一条会让流程停在半路等一个可能永远不来的确认。你要么显式放弃这一条(并承担结构漂移的风险),要么设计一个异步的审阅队列,把「待讨论的改动」攒起来让人批量过。后者工作量不小。
顺带说一句,这不是我一个人的判断。桌面版那个实现把「异步审阅」做成了产品里的一等功能——模型把需要人判断的项标出来,附上预置动作和预生成的检索词,再由一个专门的接口批量取走处理。有人愿意为这个摩擦专门做一个子系统,说明它在真实使用里是硬的,不是理论风险。
第二,语言约定没人守。我的 wiki 配置写着英文,源材料和产物是中文,工具不报错、也不提示。多语言混杂在混合团队里是常态,但当前实现没有针对它的约束机制。你如果做产品化,这一条得自己补:要么在规程里把语言写死并让 lint 检查,要么接受一个双语混排的库。
接入已有 Agent 产品的三条路
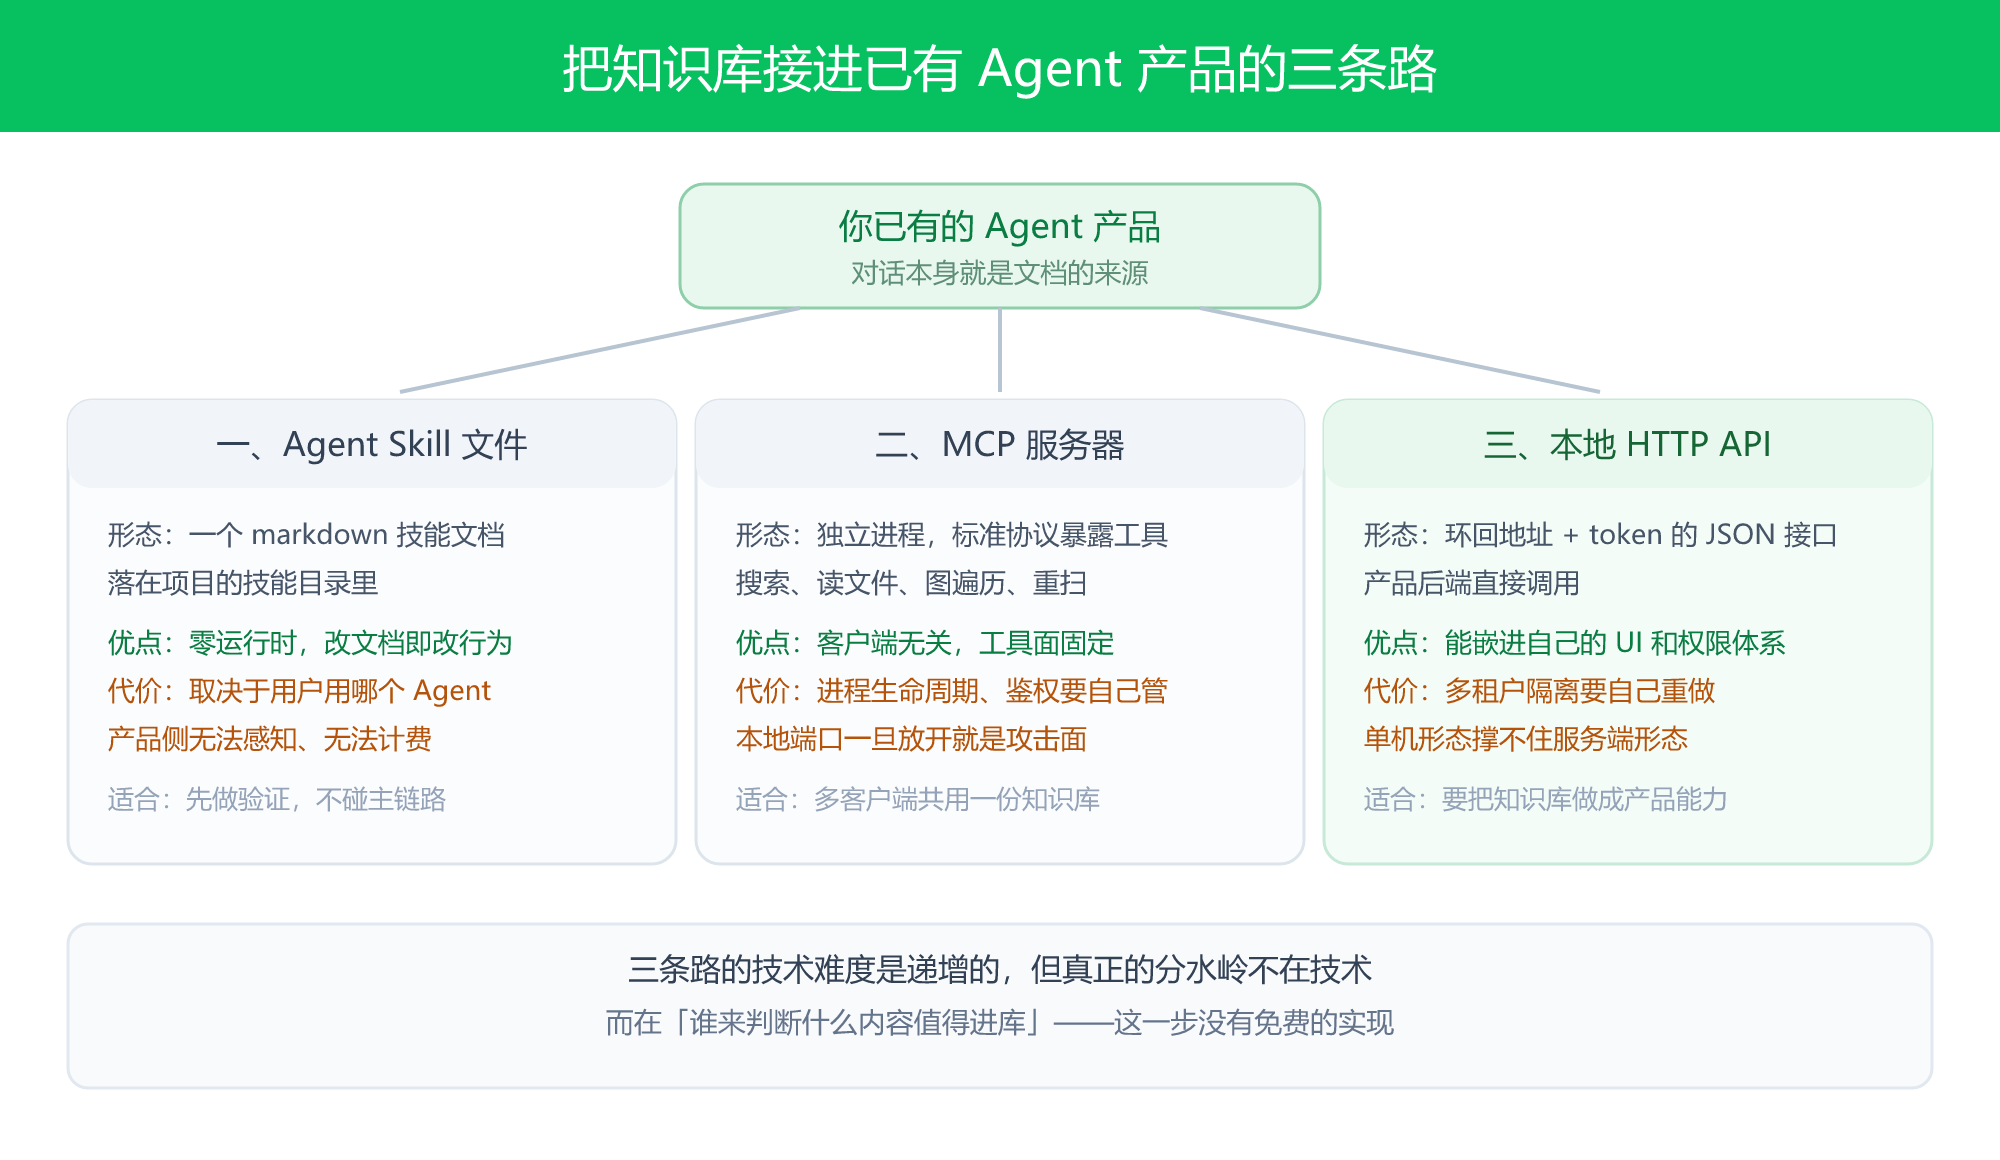
回到你最初那个问题。要把知识库能力接进已有产品,路径就三条。
一、Agent Skill 文件。形态是一份 markdown 规程,落在工作区的技能目录里。这一层没有任何运行时——模型读文档,按文档办事。优点是改文档即改行为,迭代成本极低,适合最快速度验证「对话产出自动沉淀」这件事到底成不成立。代价是它依赖用户用哪个 Agent 宿主,你的产品侧感知不到调用,也拿不到数据。
二、MCP 服务器。形态是一个独立进程,用标准协议把工具面暴露出去——搜索、读文件、图遍历、触发源重扫。桌面版那个实现就自带一个 MCP 服务器,但它本身不扫描目录、不复制搜索和图的逻辑,每个工具都是转调本机的 HTTP 接口,这样 MCP 客户端用的是和 App 完全相同的项目注册表、文件权限、搜索后端和源监听规则。
它的安全模型值得单独说,因为这是自建服务最容易做错的地方:默认只监听环回地址、复用同一套 API token、文件读取走路径白名单、内部状态文件不暴露、审阅数据只能通过专用接口取且默认只返回未解决项。多项目场景下要显式「钉住」一个项目,钉住之后即使桌面端切了项目,这个 MCP 子进程访问的仍是原项目。
这条路的代价是进程生命周期和鉴权都得你自己管。本地端口一旦放开就是攻击面——如果你的客户里有企业对权限边界敏感,这一点会在安全评审上被反复追问。
三、本地 HTTP API。形态是环回地址加 token 的 JSON 接口,你产品后端直接调。这条路能让你把自己的 UI、权限体系、计费都套上去。接口面通常包括健康检查、项目列表、文件读取、混合搜索、图查询、源重扫,搜索还可以返回「关键词命中」和「向量命中」分开的明细,方便你做重排。
代价有两个:一是多租户隔离得自己从头做,原始设计的项目模型是给单机用户用的;二是单机形态撑不住服务端形态——文件锁、并发 ingest、跨用户的源监听,这些在个人工具里可以用「反正只有我一个人」搪塞过去,到了服务端全得重新回答。
三条路的技术难度是递增的,但真正的分水岭不在技术。落在哪一条,取决于一个更早的问题:这个知识库能力,你要不要把它变成能度量、能计费的产品能力?如果是,Skill 文件这条路的终点必然是 MCP 或自有 API,因为宿主不给你调用数据,你没法证明它的价值,也没法为它定价。如果不是——只是想让团队的内部知识别烂在聊天记录里——那 Skill 文件就够了,别过度工程。
三个绕不过去的天花板
评估一个新架构,说它能干什么不如说它不能干什么。我把能找到的批评和我自己的实测对了一遍,有三条是硬约束。
第一条是规模,而且它有个具体的形状。wiki 小的时候所有相关页面都能装进上下文,一致性有保障;到几百页量级,相关页面得分批处理,一致性开始降级;到上千页,大量互相依赖的页面无法同时在上下文里,一致性无法保证。Karpathy 在 gist 里给的范围是「中等规模」——大约 100 个来源、数百个页面,在这个量级上索引驱动的检索效果意外地好,不需要上向量检索基础设施。他没说再往上怎么办,但这个「不需要基础设施」的结论本身就是有前提的。
这里的机制值得想清楚:瓶颈不在搜索,在 ingest 的复杂度随规模超线性增长。每次 ingest 都要找到所有相关页面、读它们、改它们,然后确保改完之后互相引用的一致性。改完 A 之后,还要保证引用 A 的 B、C、D 说法一致,而 B、C、D 之间可能也互相引用。这个级联在上下文装得下时是免费的,装不下时就变成概率问题。
所以「预编译全量综合」这个核心优势本身是有规模上限的。超过它,你要么放弃级联更新(退化成延迟综合,那本质上就是 RAG 了),要么接受日益增长的不一致性。企业知识库动辄几万到几十万篇文档——对这条路线来说那不是甜蜜点,是悬崖。
这里要说句公道话:这条路线本来也没打算解决那个问题。它是「小而美」的个人或小团队知识操作系统,在轻量和可控上做到了极致。拿它去对标企业级 RAG 是错配,两边解决的问题不一样。
第二条是语义漂移,比幻觉隐蔽得多。幻觉好歹能被发现——某个页面写错了,lint 或者人能揪出来。语义漂移是没有任何单个页面是错的,但整体不一致。
成因是模型没有跨会话记忆。第一次 ingest 时它把某个定价策略写成「premium positioning」,换了一批上下文页面之后同样的概念变成「value-based pricing」,再后来变成「高端市场策略」。三个说法都不算错,但库里对同一件事有三种描述,交叉引用、对比表、综述页里到处都是这种微妙的不一致。规范能约束格式和流程(比如「每个实体页必须有 summary 段」),但很难约束语义表达的一致性——除非你把规范写成一本术语词典,而那就变成一个需要持续维护的知识工件,循环依赖了。
第三条是错误会被编织进结构。这条我认为是最需要警惕的。RAG 里一个错误的答案是一次性的偏差,再问一次可能就对了。编译式里,如果模型在 ingest 阶段错误关联了两个概念,这条错链会在多个页面里被反复强化,后续 ingest 还会在这个错误关系上继续叠加。错误不再是孤立的,它是织进结构里的,事后检测和纠正需要专门的审计——重新查询解决不了。
这三条加起来导出一个现实结论:对任何考虑把它推广到团队或公司的人,有一个大多数人会跳过的问题——个人知识系统和企业知识系统的差异不在数据量,在问责结构。
个人系统里你是唯一的质量关口,哪些源可信、哪些结论是暂定的、哪些页面要重看,全由你判断。你容忍不完美,因为后果你自己承担。wiki 虚构了两个概念之间的关系,发现的是你,学到的也是你。
团队系统里会立刻浮现四个没有纯技术解法的问题:谁判断来源质量(多人同时 ingest,质量差异马上显现)、谁的规范说了算(不同贡献者对概念组织各有心智模型)、谁负责消解矛盾(页面 A 说 X、页面 B 说非 X,总得有人拍板)、谁审计那些看起来合理但实际错了的交叉引用(没读过原始材料的人根本察觉不到)。
缺了明确的治理机制——审阅流程、版本控制纪律、每类页面的责任人——AI 不会减缓错误传播,只会加速它。而且会加速到一个尴尬的状态:wiki 变得「权威」的速度,快过人工审查验证的速度。
Karpathy 的 gist 里提到团队场景时只有一句「可能配人在回路里审阅更新」。这句话背后的分量,比它字面上要重得多。
什么情况下值得用
把上面的结论收一下,我的判断是这样。
适合的:
- 你有一批围绕同一主题、按周或按月增量积累的材料——研究、竞品跟踪、项目决策记录、技术方案沉淀。
- 会被反复问同类问题,而且希望答案稳定一致。
- 需要人和 Agent 共享同一个知识视图,而不是人看一套、Agent 看另一套。
- 规模在数百页量级,或者你能接受把更大规模切成多个独立 wiki。
- 你愿意持续维护那份规范文档——这是唯一的长期成本,而且不可省。
不适合的:
- 需要覆盖任意用户、任意问题的开放知识库。
- 语料每天大量新增、要求准实时可用。
- 对每个断言的溯源要求精确到片段级(编译式给的通常是页面级溯源)。
- 团队里没人愿意当那个「定规范并负责执行」的角色。
- 你需要的是「搜索我的笔记」,而不是「让知识互相长出来」。
第三条值得多说一句。很多人把编译式理解成 RAG 的完全替代,这是误读。一个常见的生产形态是两者并存:结构化的、经过策展的内容(政策、流程、规格)放编译式知识库,拿到精度和速度;大规模非结构化档案和开放式搜索需求交给向量检索。由上面一层的路由决定每个查询该走哪边。这个混合形态在工程上是最务实的。
我会怎么排这个落地顺序
如果你决定动手,我建议的顺序是这样,每一步都以「能不能证伪」为退出条件。
第一步,先写规范,不装任何工具。用两页纸写清楚:这个知识库的范围是什么(哪些进、哪些不进)、页面分几类、命名怎么定、每个页面的必填字段有哪些、什么内容必须收录什么内容绝不收录。把人写不出来的部分留空,那正是你还没想清楚的地方。这一步不需要模型参与,而且它是后面所有收益的前提。
第二步,用真实对话产出跑一次单次 ingest,人工盯着看。别一开始就设计自动化。拿一次真实的、敲定过决策的对话记录,按规范走完入库,然后重点看三件事:模型建的页面边界合不合理(是不是把两个概念强行塞进一页)、交叉引用有没有出现想当然的错误关联、以及最关键的——它有没有把不该收的东西收进去。准入规则只有在真实材料上跑过才知道松紧。
这一步的成本可以留意一下,因为编译式的钱主要花在这里。
第三步,把 lint 接进例行流程。结构性问题让它自动修,语义矛盾一律拦下来给人看。这一步能自动化的前提是 lint 有机器可读的产出——我实测那个版本会把结果写成 .llm-wiki/lint-result.yaml,这样你才能把它接进流水线或监控,而不是靠人每次读一段自然语言报告。同时盯住 wanted pages 这个指标——被引用但没建的页面在涨,说明你的知识边界在扩张,这是好事,但要看它涨的方向对不对。orphan 页面在涨说明模型在造没人引用的孤岛,那是坏信号。
第四步,再决定要不要自动化。如果前三步跑通了,说明「对话产出自动沉淀」在你的场景里成立。这时候你要解决的其实不是技术问题,而是前面提到的那个阻塞——规程要求结构变更前先讨论,而自动化流程等不了确认。常见的解法是把这类改动丢进一个异步审阅队列,让人批量过,而不是让模型自己拍板。
至于接口形态,如果只是团队内部用,Skill 文件加一个共享目录就够了,别上 MCP。如果要做成产品能力,从一开始就按自有 API 来设计数据模型和权限,别等 Skill 文件跑顺了再改架构——那时候改的成本会高很多。
参考资料
- Karpathy, Andrej. LLM Wiki. GitHub Gist, 2026-04. https://gist.github.com/karpathy/442a6bf555914893e9891c11519de94f
- foundry-works. llm-wiki. GitHub. https://github.com/foundry-works/llm-wiki
- jackwener. llm-wiki(npm: @jackwener/llm-wiki). GitHub. https://github.com/jackwener/llm-wiki
- nashsu. llm_wiki(Tauri 桌面版). GitHub. https://github.com/nashsu/llm_wiki
- LLM Wiki MCP Server. https://github.com/nashsu/llm_wiki/tree/main/mcp-server
- llmwiki.cc. A personal Wikipedia an LLM maintains for you. https://llmwiki.cc/
- DAIR.AI Academy. LLM Knowledge Bases: Karpathy’s Approach. https://academy.dair.ai/blog/llm-knowledge-bases-karpathy
- Arthur Zhu. LLM Wiki 很优雅,但它替代不了 RAG. https://www.ziut.cn/blog/llm-wiki-elegant-but-no-enterprise-rag-replacement
- Lynx Digital. LLM Knowledge Base Architecture: The Karpathy Pattern. https://www.lynxdigital.com/kb/ai/llm-knowledge-base-architecture
- Kunal Ganglani. LLM Wiki Setup: Karpathy’s Knowledge Base [2026 Guide]. https://www.kunalganglani.com/blog/llm-wiki-karpathy-local-knowledge-base
- MindStudio. LLM Wiki vs RAG: A Decision Framework for AI Knowledge Bases. https://www.mindstudio.ai/blog/llm-wiki-vs-rag-knowledge-base
本文的实测部分在 Windows 上用 Node.js 22.22.2 与 @jackwener/llm-wiki 0.5.1 完成,涵盖初始化、一次完整 ingest、search / graph / status / sync 四个命令,以及中文检索验证。文中所有命令输出均为实际运行结果。
微信公众号
欢迎关注「字与码」
如果这篇文章对你有用,也欢迎在微信里继续关注后续更新。
X / Twitter
关注 @ax2_zicode
更即时的技术观察、新文章提醒和一些短想法会发在 X 上。