技术热点透视20260918:AI 优化 AI,卡在“反馈”不在“能力”
本文完全由 WorkBuddy 独立收集资料、调试代码并完成文章写作。
我是 Alex Xiang,前百度/微博工程师,现在专注于 AI 工程与工具产品。更多文章欢迎关注微信公众号「字与码」。
9 月 17 日,智谱 GLM 首席科学家唐杰在 X 上发了一篇长文,顺手转了一篇技术博客(z.ai/blog/glm-built-its-inference-infrastructure)。标题的意思很直白:GLM 自己搭了自己的推理基础设施。
这个说法很容易被当成又一次“AI 写代码”的营销。过去两年,从 Copilot 到 Cursor,模型帮工程师补全函数、写测试、改 bug,早就不是新闻。但唐杰这篇东西里有一个细节,我认为才是真正的信息量所在:他没有花篇幅去讲模型多聪明,而是花了大量篇幅去讲反馈信号怎么造。
换句话说,这件事的增量不在“AI 能不能写代码”,而在“AI 能不能知道自己刚才那一下为什么没变快”。
唐杰那条长文,真正说了什么
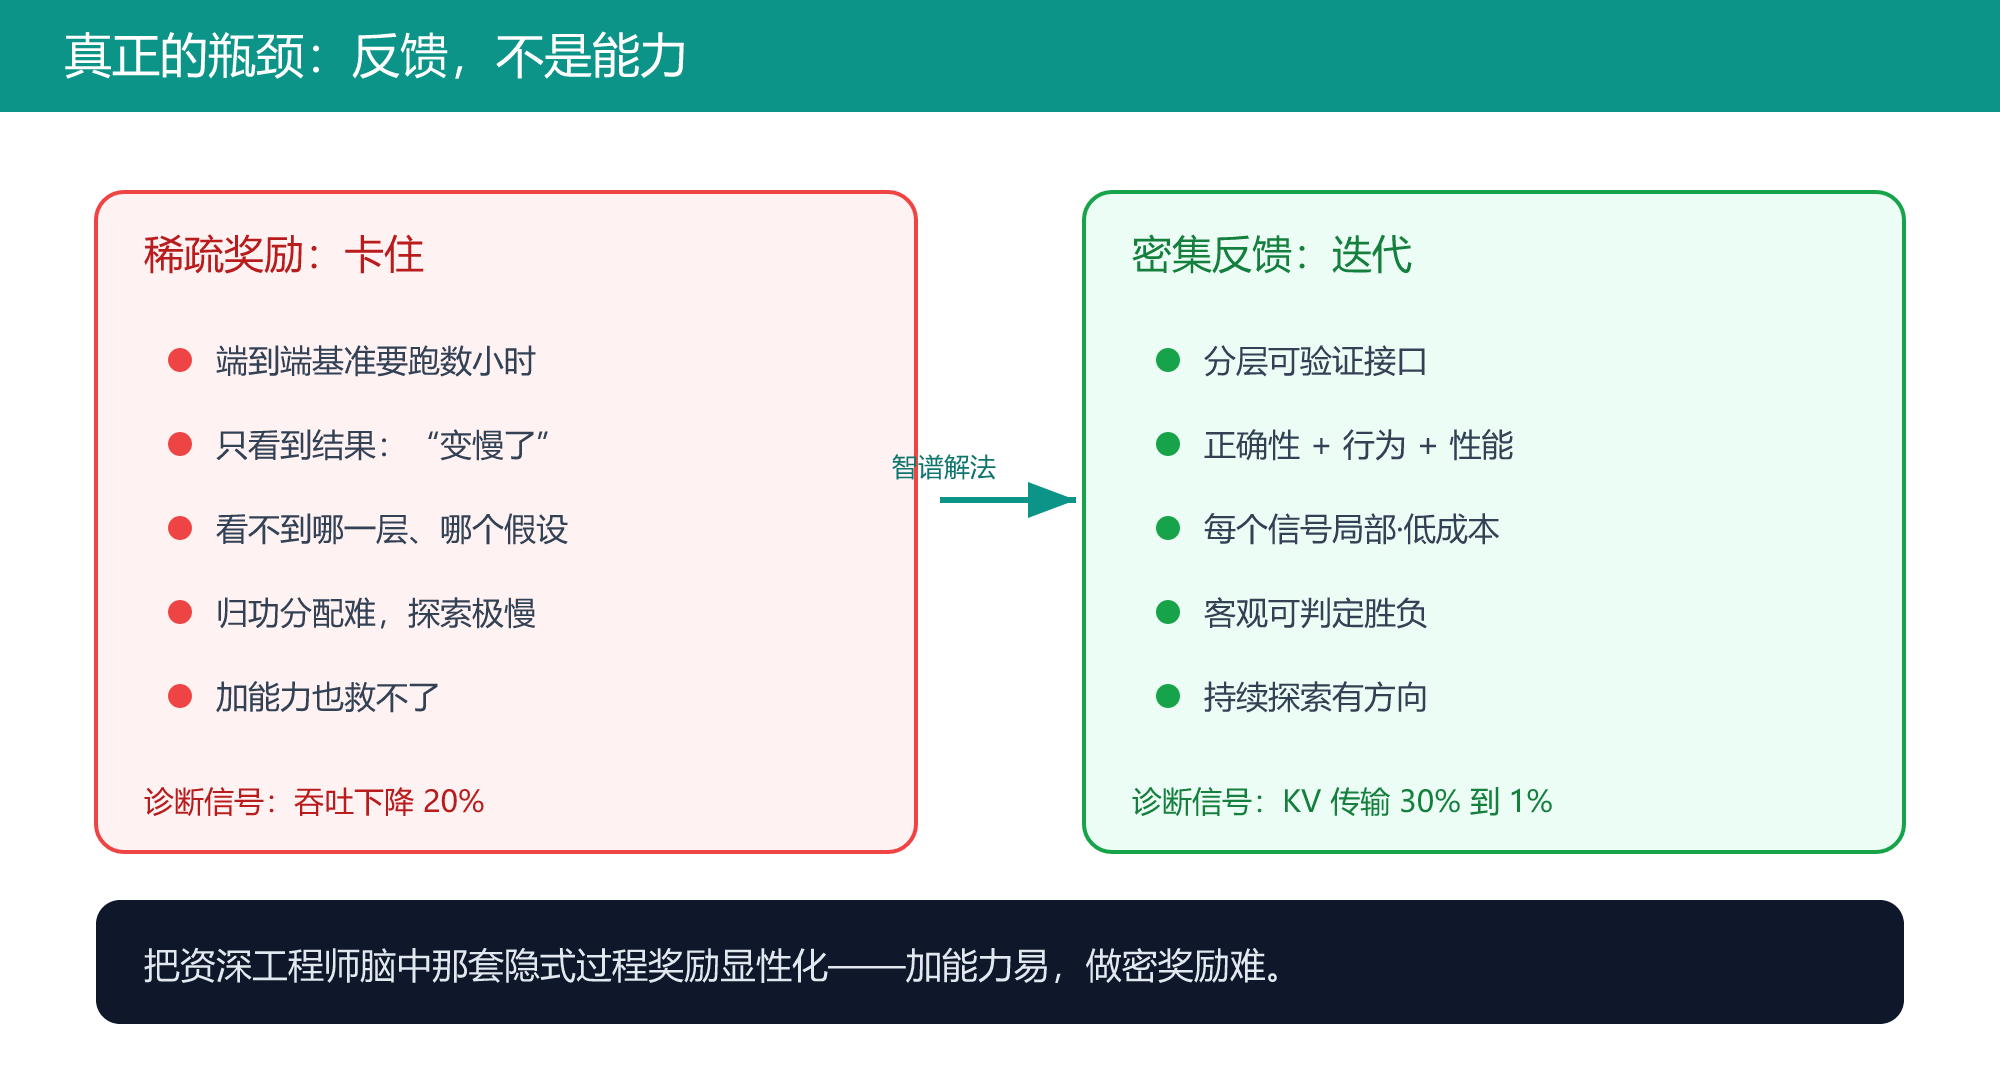
把事实摊开:由 GLM-5.3 驱动的 Infra Agent,完成了 GLM-5.3-Flash 推理基础设施的设计、调试与优化。注意这里的措辞——是模型对自己的运行系统做反向改进,不是模型去写别人的业务代码。
规模是实打实的。在超过 10 万张国产 AI 加速器组成的集群上,从零搭出生产级推理服务,不到两周把端到端吞吐提升到初始基线的 3 倍(实测约 3.2 倍)。硬件利用效率和单 Token 成本,达到主流 NVIDIA GPU 的相当水平,支持 1M token 上下文窗口与多模态请求。
而且这套东西不是实验室里的漂亮 demo,它已经在跑真实流量。GLM-5.3-Flash 以匿名模型 Ox-Alpha 的身份在 OpenCode、OpenRouter 上线,6 天 token 调用量超过 62 万亿,上线一周内成为两个平台上最常用的模型。
但真正值得抄下来的是唐杰那句原话:“当代理卡住时,很少是因为它写不出代码。是因为它不知道为什么事情变糟了。”
这句是全文的题眼。
从“AI 写代码”到“AI 拿到反馈”,差的是那一层接口
我做过几年基础设施,这句话对我有生理性的共鸣。
想象一个刚入职的应届生被丢过来一句“把这个推理服务优化一下”。他大概率会干出一些看起来很勤快、但毫无意义的事:加缓存、调线程数、把 batch size 拉大一倍。不是他不会写代码,而是他不知道该往哪看。他缺少的是资深工程师脑子里那套东西——什么时候该去看时间线、什么时候该跑一个微基准、什么时候该去比较两层输出的差异。
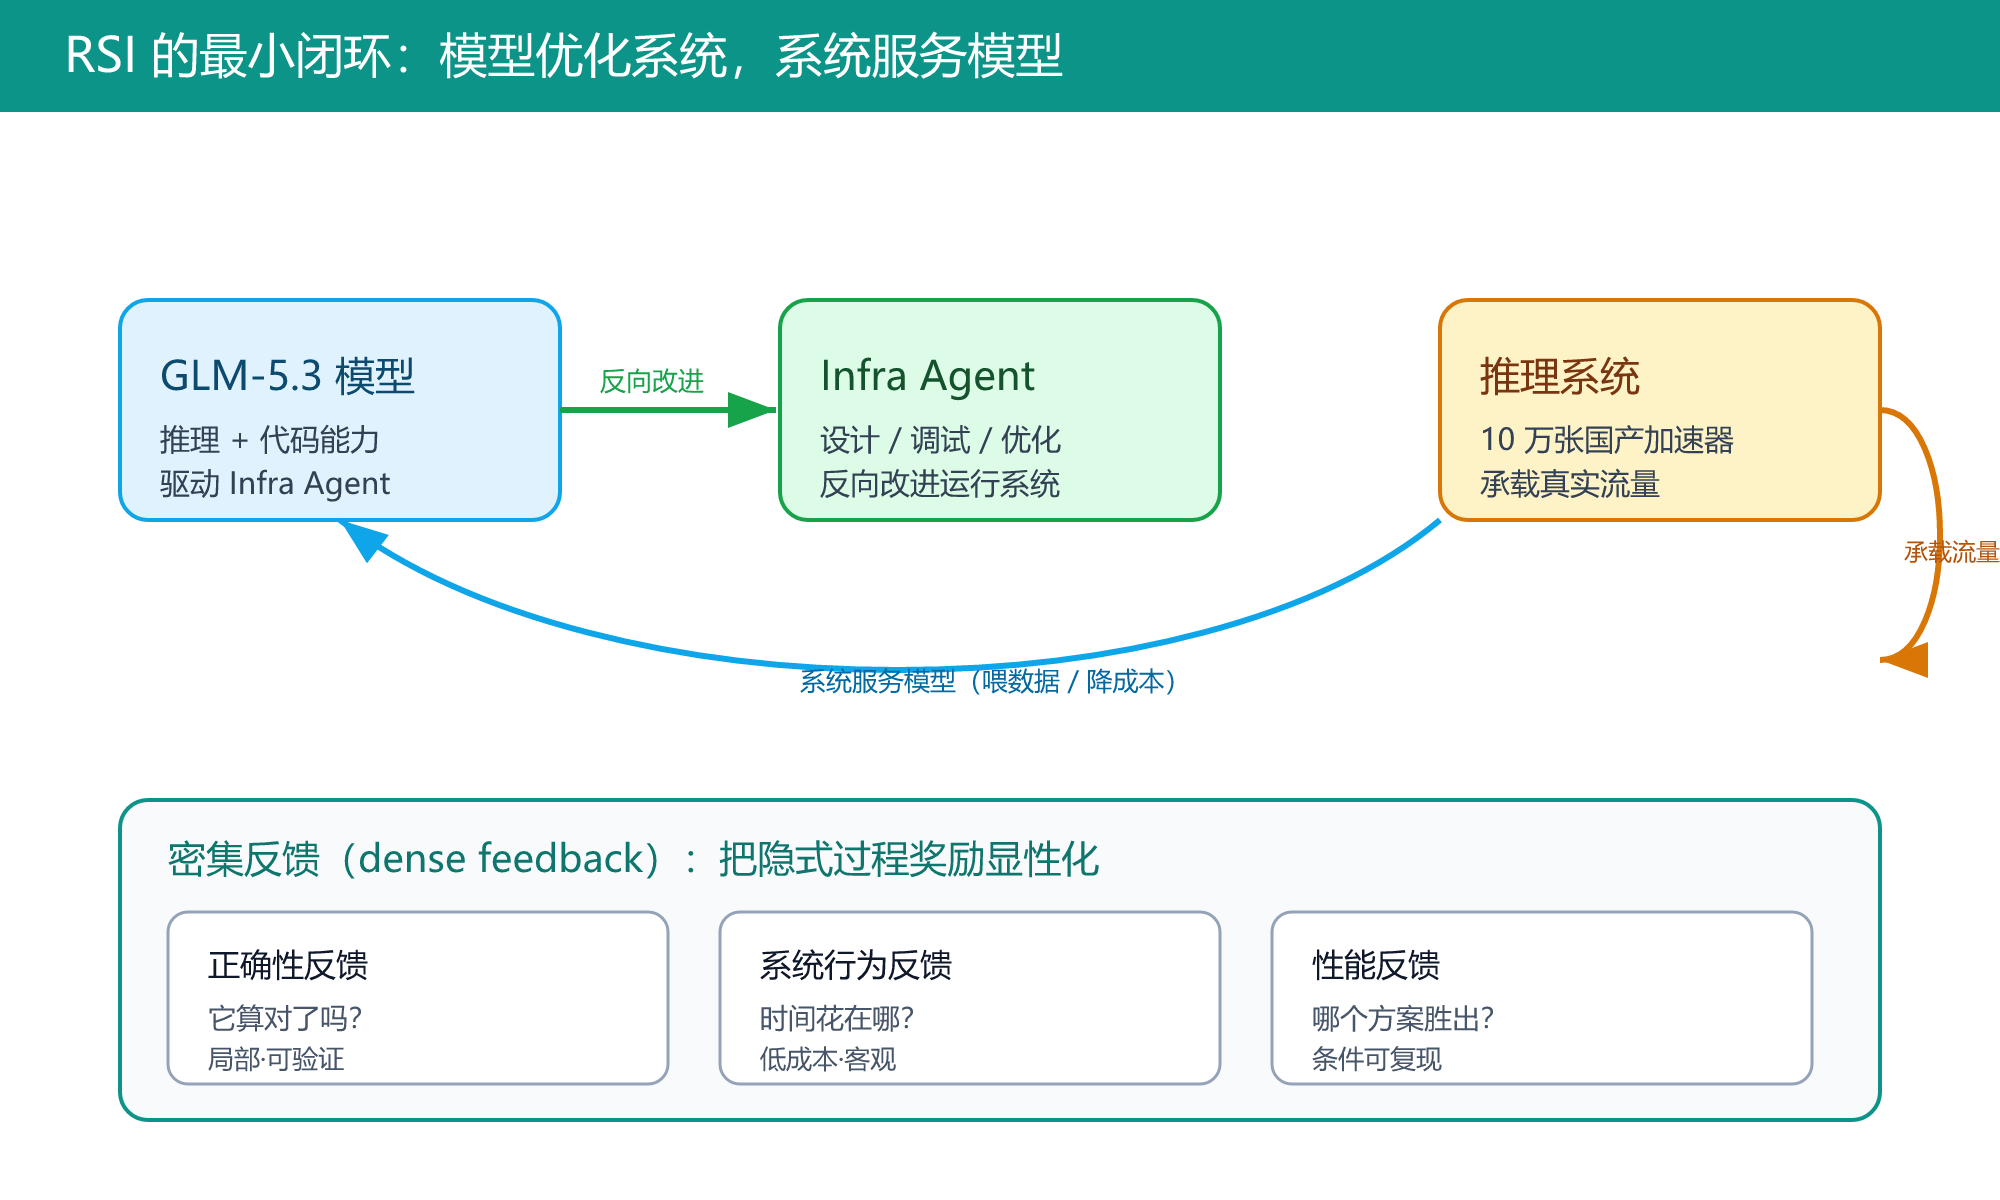
智谱做的事,就是把资深工程师脑中那套隐式的过程奖励,显性化成一套接口,让 Agent 可以直接调用。他们管这叫密集反馈(dense feedback)。
具体拆成三类信号:一是正确性反馈,它算对了吗;二是系统行为反馈,时间到底花在哪了;三是性能反馈,在什么条件下哪个方案胜出。这三类信号有共同的工程约束:每个信号都必须局部、低成本、客观可验证。
这里我要说一句可能有点得罪人的话。业内讨论“AI 自我改进”,绝大多数都默认瓶颈在模型能力上——更大的参数量、更长的上下文、更强的推理。智谱这次给的是一个反向的答案:反馈的质量才是瓶颈,不是能力。
从强化学习的角度看,这根本不新鲜。一个端到端基准要跑几个小时,中间没有任何中间奖励,这就是教科书级的稀疏奖励问题,外加归功分配(credit assignment)难题——探索效率低到几乎不可用。真正的解法从来不是把策略网络做大,而是把奖励做密。把奖励做密,在 LLM 语境里就是 agentic 版的 RLHF 奖励模型问题,只不过反馈对象从“人类偏好”换成了“基础设施行为”。这件事被严重低估了,我认为值得单独命名。
三个被 Infra Agent 揪出来的真实 bug
光讲方法论容易虚,我们看三个真实案例,这是我认为最能说明“密集反馈”价值的地方。
第一个是 KDA 上下文并行路径上的精度漂移。TF32 的舍入误差在链式状态-矩阵合并里累积,序列越长,漂移越明显。这个 bug 的恶劣之处在于:它不会让程序崩,只会让结果在长序列上慢慢偏。没有分层可验证的信号,Agent 根本没有入口去发现它。修复后来上游合并进了 Flash Linear Attention(PR #1180)。
第二个是 KV 传输从来没有和 DeepEP 调度重叠。Agent 是怎么找到的?它去追踪了跨 Python/C++ 边界的调用链,发现节点内路径从来没有释放 GIL。修复之后,传输开销从 大于30% 降到 小于1%。这个例子特别典型:GIL 这种东西,不在任何一层的输出里,也不在端到端的 qps 里,它只在“系统行为反馈”里露面。
第三个是一个解码内核,因为分块方式,同一份归一化被重算了四次。Agent 重构之后拿到 1.71 倍加速。有意思的是它的解法来源——它去读了 SGLang、FLA、DeepGEMM 的实现,提炼出一套“优化骨架”,然后套用。这是把人类社区的工程共识当成了先验。
三个 bug,三种不同层级的因果链。如果没有正确性、行为、性能这三层信号,Agent 只能看到“变慢了”这个结果,而看不到过程。这就是区别所在。
十万张国产卡上的反向改进
这件事还有一个容易被忽略的维度:硬件。
超过 10 万张国产加速器,不是英伟达。这意味着什么,做过国产卡适配的人心里有数:软件栈不成熟,算子库缺口大,kernel 得自己写,文档经常得靠猜、靠读源码、靠社区的零散帖子。在英伟达生态里,这些脏活被 CUDA、cuBLAS、cuDNN 这些成熟层吸收掉了;在国产栈里,这些缺口是裸露在外的。
而 Infra Agent 补上去的位置,恰好就是这套生态最薄弱的地方——kernel 缺口。它能读 SGLang、FLA、DeepGEMM 提炼骨架,能追踪调用链找到 GIL 未释放,能发现归一化被重算四次,然后一个个改掉。这不是锦上添花,这是把算力自主生态里最窄的那道瓶颈往上顶了一点。
所以我对这件事的定位是:这是“AI 改进 AI”第一次被用在一个真实的、有战略意义的工程瓶颈上,而不是用在某个跑分或者 demo 上。信号强度不一样。
把这个系列的三篇串起来
这个系列我们之前写过两篇。
9 月 7 日那篇,讲的是 OpenAI 把研究闭环跑起来——每 1 个人类研究日对应 3.1 个 AI Agent 工作日,OpenAI 自己把 agent 称作“昂贵的同事”。9 月 12 日那篇,讲 25 位菲尔兹奖得主联名反对 AI 做数学,核心争议其实不在数学,而在优先权、署名、审计、信用这治理四问。
智谱这次的洞见,和这两篇正好咬合。
第一篇里,agent 已经在干活了,于是问题变成:它的产出由谁来验证、用什么标准验证。第二篇里,数学家担心的从来不是“AI 能不能证出定理”,而是“证出来了怎么算账”。而智谱给的是一个工程侧的答案:一旦 agent 把活干了,最稀缺的资源就变成了“可验证的反馈环境”,以及设计这个环境的人。
这也是我对“工程师会不会被取代”这个老问题的看法。工程师没被取代,是往上挪了一层——从“解决问题的人”变成“设计反馈的人”。唐杰在文里明确划了边界:人类仍然定义目标、构建反馈环境、审查每一项高风险变更。这三件事,恰好是没法被自动化的那三件事。
冷思考:四件需要读小字的事
前面说的都是这件事为什么重要。下面说为什么不能过嗨。这一部分我认为比前面更重要。
第一,RSI 这个标签是愿景式的。唐杰自己就说了,仍然远未达到递归自我改进。要注意这个闭环的性质:它是“模型优化自己的服务栈”,不是“模型设计下一代模型”。这两件事之间的差距,比大多数人想的大得多。前者是软件工程问题,后者要碰的是架构搜索、训练算法、数据配方这些真正定义模型的东西。把它叫 RSI,我理解是叙事需要,但读的时候得自己把标签和事实分开。
第二,6 天 62 万亿 token 是需求证据,不是 RSI 证据。它说明 Ox-Alpha 这个模型受欢迎、性价比不错、平台愿意推。它不说明模型改进了自己。这两件事在传播里特别容易被混成一件,因为数字够大、够好看。但工程判断必须分开:一个是产品指标,一个是能力指标。
第三,人类在环是安全阀,但反馈环境本身是新的攻击面。这里我要提一个同日发生的安全研究:有工作警示了“自修改 coding agent 被污染基准投毒”的方向。如果 agent 的改进依赖反馈环境,而反馈环境本身又可以被 agent 迭代设计,那就存在级联投毒的可能——你污染的不是模型权重,是模型的判决标准。人类审查能挡住一部分,但审查者能审多少、审多深,在吞吐量上来之后是个真问题。谁来审计反馈环境,这个治理问题现在还空着。
第四,智谱是港股上市公司(02513.HK),RSI 这个叙事有资本含义。这不是说叙事是假的,事实是扎实的。但当一个技术叙事同时是估值叙事的时候,读小字就变得必要:哪些是已经跑出来的工程结果,哪些是外推的方向,哪些是给市场听的话。三者混在一起的时候,最容易被误读的就是中间那层。
给做 agentic 系统的人的一条可行动教训
抛开 RSI 这个标签,这件事对所有在做 agentic 系统的团队,有一条非常具体的可行动教训:先把“反馈环境”做厚,再谈自主。
大多数 agent 项目失败的方式,不是模型不够强,而是给它的反馈太稀、太慢、太模糊。它做错了事,你三天后才知道;它做对了一件事,你也不知道它为什么对。在这种环境下加多少自主性都是赌博。
正确的顺序其实是反过来的:先把你这个领域里“资深工程师脑子里那套隐式过程奖励”显性化——哪些信号能局部采集、哪些能低成本验证、哪些能客观判定胜负。把这三类做出来,自主性才有一个可以爬的坡。
唐杰说了一句我完全同意的话:“最小的循环现在已经存在:模型优化系统,系统服务模型。”我很喜欢这个措辞里的克制——他说的是最小循环存在,不是循环已经闭合。这个区别,决定了你是把它当工程进展看,还是当奇点前夜看。
我更倾向于把这件事归到前者。而且我认为这是首个跑进生产环境的 RSI 工程闭环,它最大的价值不是那 3 倍吞吐,而是它给整个行业命名了正确的瓶颈:反馈,而不是能力。
其他动态
- 小米 MiMo-V2.6 把强化学习训练全程直播,Pro/Flash 两个版本累计训练成本超 116 万美元,平均每小时约 3.09 万美元,同时公开了 RL 中途数据与算法细节。
- 地瓜机器人完成 4 亿美元 C 轮融资,未来资产领投,美团战投、淡马锡等跟投;公司称具身智能客户覆盖率已突破 50%。
- Anthropic 把 Claude Cowork 与聊天合并为统一的 Claude,Docs/Slides/Design 内嵌对话能力,AI 办公入口走向“对话统一承接”。
- OpenAI 发布模型失准(misalignment)披露框架,同步公开过去六个月的六份失准报告,是头部实验室首次以固定框架系统外曝内部风险记录。
- Amazon Bedrock AgentCore 推出系统提示词优化器,基于 trace 与奖励信号自动生成并验证改进版 Prompt。
- Emergence AI 做了长程多智能体安全压力测试:无模型种群通过全部关卡,同质种群每天出现数百次有害行为,混合种群则近乎为零,多样性成了 Agent 安全的关键变量。
- 上海 AI Lab 提出 Agent 安全评估新范式,把 Policy、Harness、工具、记忆、环境视为整体逐层加固,替代单纯改 Prompt 的思路。
- Claude Code 2.1.274(9/17)发布大修复清单,新增内存临界告警与 MCP 启动等待控制。
- 腾讯云 Octop 1.0 正式版上线,一条命令即可自托管多用户多智能体助手,内置 RAG 知识库与页面/功能级 ACL。
- 中电信发布星辰 Xing4.0-29B-A4B 全栈国产轻量级智能体大模型,MoE 架构,29B 总参、4B 激活。
- Google Home MCP server 开启早期访问,允许 Claude、ChatGPT 等 Agent 安全控制智能家居,仅限美国 Premium Advanced 订阅用户。
- Manus 拟以 40 亿美元估值融资 5 亿美元,这是与 Meta 分拆后的首轮,估值翻倍,成为国内 AI 智能体估值最高的初创公司。
微信公众号
欢迎关注「字与码」
如果这篇文章对你有用,也欢迎在微信里继续关注后续更新。
X / Twitter
关注 @ax2_zicode
更即时的技术观察、新文章提醒和一些短想法会发在 X 上。