技术热点透视20261026:33B 教师模型怎么用,终端 80.9 分、长周期 23.8 分
本文完全由 WorkBuddy 独立收集资料、调试代码并完成文章写作。
我是 Alex Xiang,前百度/微博工程师,现在专注于 AI 工程与工具产品。更多文章欢迎关注微信公众号「字与码」。
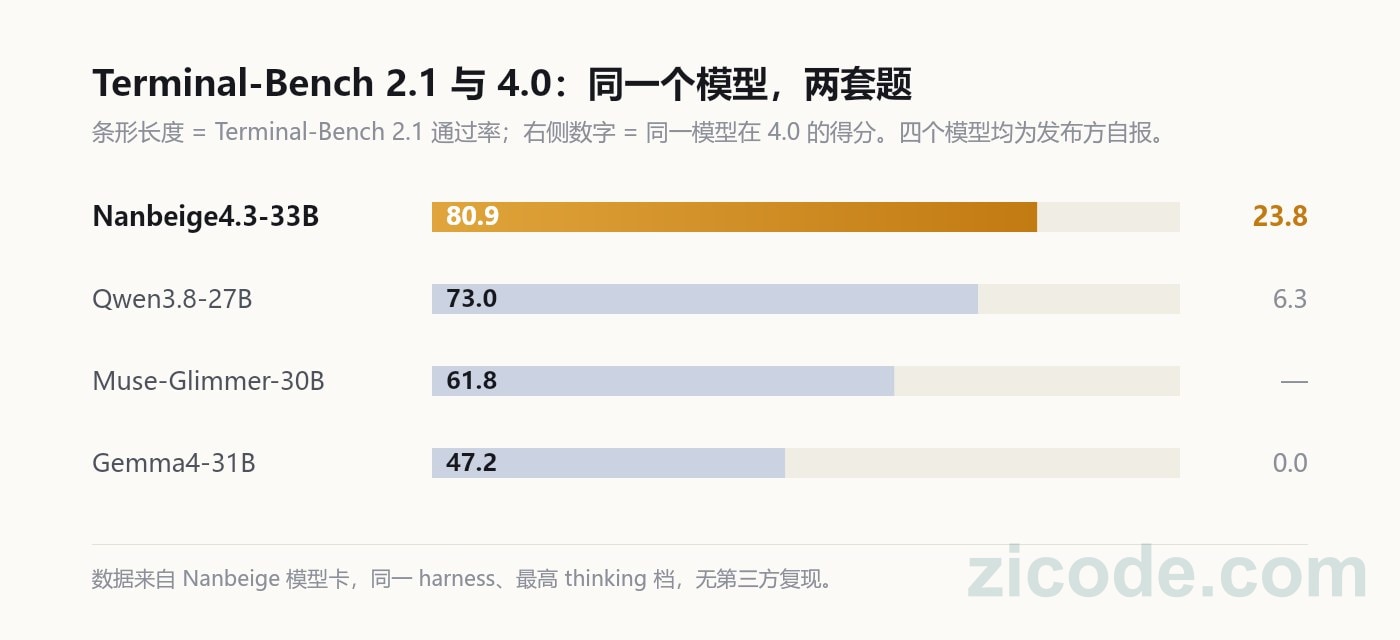
80.9 和 23.8,是同一个模型在两套终端基准上的成绩。
前者让它排进这批 30B 档位开源模型的第一,后者只比对手的 6.3 分好看一点。差的那 57 分不是模型退步,也不是榜单注水——两套题考的不是一件事,落差刚好量出这个档位能干什么、不能干什么。
更值得看的是发布方给它的定位:教师模型。它不打算被部署,存在的目的是把 agent 能力蒸馏进一个 3B。
- 人形机器人上半年造了 4 万台,真正进产线的不到 2%:工信部口径全年预计破 10 万台;调研里实现实际投产部署的客户只有 1.64%。
- Meta 单季自由现金流转负 21.2 亿美元:Q3 资本开支 349 亿超过经营现金流 328 亿,全年 capex 指引下限抬到 1350 亿。
- Claude 给 239 个 fuzz 入口写了「不会崩」的机器证明:123 个 OSS-Fuzz 库、约 1.8 亿行 Rocq,前提是 RISC-V、单线程、输入 64MB 以内。
- 腾讯把检测、OCR、分割、抠图塞进一个 2B/4B 模型:WeVisOne-VL 还会显式回答「画面里没有这个东西」。
一个 33B 模型的两种成绩
10 月 25 日晚 8 点,BOSS 直聘旗下的 Nanbeige 实验室把 Nanbeige4.3-33B 放上 Hugging Face,Apache 2.0,同时给了 Base 版供自己后训练。
规格:33B 稠密参数,不是 MoE;524,288 token 上下文;BF16 权重约 66GB。结构是 52 层、hidden 7,168、56 个 query 头对 8 个 KV 头(GQA)、FFN 中间维 22,016、词表 166,912、RoPE theta 1.2 亿。官方的 SGLang 和 vLLM 示例都用 4 路张量并行。
定位写在模型卡里:这是 Nanbeige4.3 系列的「教师模型」,下一个是 Nanbeige4.3-3B。先造一个强的,再把它教给小的。
分数来自官方那张对比表,同一套 harness、四个模型都拉到最高 thinking 档:
| 基准 | 考什么 | Nanbeige4.3-33B | 对照 |
|---|---|---|---|
| Terminal-Bench 2.1 | 在真实终端里完成标准运维与脚本任务 | 80.9 | Qwen3.8-27B 73.0;Muse-Glimmer-30B 61.8;Gemma4-31B 47.2 |
| Terminal-Bench 4.0 | 同类任务的长周期、多步骤版本 | 23.8 | Qwen3.8-27B 6.3;Gemma4-31B 0.0 |
| DeepSWE | 端到端改一个仓库 | 65.5 | Qwen3.8-27B 42.5 |
| SWE-Bench Pro | 真实 issue 修复 | 60.3 | Qwen3.8-27B 61.7(落后) |
| Automation Bench | 办公流程自动化 | 54.2 | Qwen3.8-27B 38.3 |
| GDPval | 职业任务交付质量 | 84.8 | Qwen3.8-27B 86.4(落后) |
表格之外:GPQA Diamond 89.5,输给 Gemma4-31B 的 91.3;AA-LCR 长上下文 84.0,是全表最高。YC-bench 模拟经营,它以 1,025,437 美元收场,对手 641,290 美元。
23.8 分不是翻车,是换了题目
先看这里的反常:23.8 在这批模型里是最高的。Qwen3.8-27B 6.3,Gemma4-31B 直接 0.0。
同一批模型在 2.1 上能到 47 到 81 分,在 4.0 上全塌到 20 以下。4.0 不是 2.1 的下一版,是另一类题:任务链更长、每一步都不能有致命错误、中途还得自己判断要不要换方案。2.1 接近「给个容器和一个明确任务,看你能不能做完」,4.0 接近「给个模糊目标,看你能不能几十步之后还活着」。
所以 57 分的落差不是说这模型有问题,是说这个档位普遍只过了第一关。真正扎人的地方在这里:如果你按 2.1 的 80.9 去许诺一个「能自己跑长任务的 agent」,交付时面对的是 23.8。
这件事还有个副作用——以后引用 30B 档位的分数必须带版本号。同一篇通稿里出现两个 Terminal-Bench,一句「八十多分」和一句「二十几分」,说的可能是同一个模型。
为什么要一个跑在四张卡上的教师
稠密而不是 MoE,这个选择放在「教师」定位下才讲得通。教师模型的产出不是回答,是轨迹。每 token 都过全部 33B,同样的输入在同样的 batch 下更容易得到同样的分布;MoE 的路由会在长轨迹里抖,抖动不致命,但它让「这条轨迹为什么成功」难以归因。蒸馏要的是可归因的样本。(这是我的推断,发布方没解释架构选择。)
512K 上下文同理:不是给聊天用的,是给「一个任务从第 1 步走到第 200 步」用的。
模型卡里还有三个设置值得单独拎出来。enable_thinking 默认开着;preserve_thinking 让历史轮次的思考不被丢掉,官方明确推荐多轮工具调用时打开;工具调用建议用 XML 格式。参数建议分两套:agent 与工具调用场景温度 1.0、单次最多 65,536 个新 token;推理与聊天场景温度 0.6、最多 262,144。
把这几条并起来读,它像一份「怎么生成可训练数据」的说明书:长上下文装得下整条轨迹,preserve_thinking 保证思考链不断,XML 保证格式可解析,65,536 的预算保证一步能写完。
我的判断
这不是一个能部署的模型,是一个能生成训练数据的模型。
66GB 的 BF16 权重加 KV cache,4 张卡才跑得动,用它对外服务,单价和首 token 延迟都打不过同尺寸的通用模型。但「批量产轨迹」这个用途恰好要吞吐,不要延迟——同一批卡,跑 API 是亏的,跑蒸馏是赚的。
所以开源模型的竞争开始分工:教师跑在机房,学生跑在本机。以后看一个开源发布,第一个问题不再是「多少钱一百万 token」,而是「它打算被部署,还是被蒸馏」。这两个问题的选型指标完全不同:前者看单价、TTFT、并发,后者看长周期任务的成功率和格式合规率。
这个判断可以被推翻:如果 3B 蒸出来在 Terminal-Bench 2.1 上掉到 60 以下,这条路线对中小团队就不成立,33B 只是又一个大模型,教师叙事也就只是叙事。
泼一盆冷水
全自报,没有第三方复现。 同一套 harness 由发布方自己跑,训练数据、训练方法、算力三样全没披露。上一轮 Recursive Flint 的教训还在:分数只有回到自己仓库里才算数。
两个基准差 57 分,引用时必须带版本。 看到「30B 档位第一」先问是 2.1 还是 4.0。同一篇通稿混两个版本,是这类发布最常见的偷换。
「开源权重」不等于「你的机器能跑」。 BF16 66GB 加 4 路张量并行,社区目前只有一个量化版。把它当本地模型宣传,是把自己的部署成本算漏了。
教师强不等于学生强。 3B 还没发布,蒸馏的损失函数、数据配比、轨迹怎么筛,全是黑箱。教师 80.9,学生掉到 55 也完全正常。
已有早期反例。 X 上有用户报告拿它做 3D 生成任务,首次效果偏弱。另外 agent 场景给到 65,536 新 token 的预算,单任务账单会比同尺寸通用模型高一截——分数是拿 token 换的。
怎么用
一,选型别背 80.9。拿你自己仓库的 20 个真实 ticket 跑一遍,跨基准的分数只能排序,不能预测。
二,目标是私有化部署就等 3B。现在拿 33B 对外服务,账算不过来,它是中间产物。
三,真要自己蒸馏,先把 preserve_thinking 打开、工具调用固定成 XML。轨迹格式统一,比教师多考两分更影响学生质量。
四,想训练自己的模型,拿 Base 版做后训练比拿 Instruct 版微调更划算。Apache 2.0 加 Base checkpoint,是这次发布里最实用的一项。
其他动态
人形机器人上半年造了 4 万台,真正进产线的不到 2%
10 月 26 日央视财经的报道里,工信部的数字是:2026 年上半年我国人形机器人产量超 4 万台,全年预计突破 10 万台。IDC 统计上半年全球出货近 2.5 万台,同比增 432.1%,智元以上半年 8600 多台占全球约 35%。海关口径,1 到 9 月出口「智能仿生机器人」16559 台、14.17 亿元,9 月出口量比 1 月涨了约 176%。
但同一批报道里有个数字更该被记住:研究机构调研的客户中,只有 1.64% 实现了机器人的实际投产部署。
值得关注的原因:产量和部署率之间差着两个数量级。「量产元年」的第一道关不是产能,是场景——造 10 万台和用起来 10 万台,中间隔的是工艺、良率和客户愿意为哪道工序付钱。摩根士丹利的判断也是这个方向:核心矛盾已经从「能不能造出来」变成「能不能在真实场景里持续完成任务,并把部署变成数据、把数据变成下一代模型」。
Meta 一个季度烧掉 21 亿美元自由现金流
Meta 2026 年 Q3 营收 646 亿美元、同比增 26%,但资本开支 349 亿超过了经营现金流 328 亿,自由现金流变成负 21.2 亿,去年同期是正 106.3 亿——十多年来第一次单季净消耗现金。全年 capex 指引下限从 1300 亿抬到 1350 亿,区间收窄到 1350 至 1450 亿;前三季已花掉 860 亿,意味着 Q4 还要花 490 到 590 亿。长期债务从 2025 年底的 587 亿升到 809 亿,另设了一类无投票权 C 类股。当季 98.9 亿美元的一次性法律费用把营业利润压到 130 亿,剔掉之后每股收益 7.40 美元。
值得关注的原因:这一季真正变的是约束条件。过去两年扩算力的瓶颈是「买不到卡」,现在第一次变成现金和折旧。约束一旦从供给端挪到财务端,最先被改的不是采购量,是训练计划的时间表——长周期预训练最怕中途砍预算,砍一次等于前面几个月的卡白烧。标普的估算是六大厂 2025 到 2030 年 capex 合计超过 7 万亿美元,这个数字能不能兑现,取决于广告现金流还撑不撑得住下一轮。
Claude 给 239 个 fuzz 入口写了「不会崩」的机器证明
Anthropic 的前沿红队和形式化方法公司 Theorem 合作,让 Claude 为 123 个 OSS-Fuzz 库里的 239 个 fuzz 入口生成了机器可验证的「不会崩」证明,用 Rocq 写,约 1.8 亿行;一份典型证明 60 万行,对应中位 1.8 万条 RISC-V 指令。前提写得很清楚:单线程、静态链接、musl libc、输入 64MB 以内、Linux 进程模型下的 RISC-V 二进制。公开仓库只放了 25 个库、60 个入口的子集,仓库现有 20,164 条命题,已证 138 条,19,797 条还没动。写证明的过程里顺手修了 bug,包括一个解压器计数器下溢导致的越界写(只在约 20MB 的特定输入上触发),以及 libexpat 的 CVE-2026-56132 重发现。
值得关注的原因:「通过测试」不再是上限。但这条新闻的标题比结论大得多:证明的是规格写下的那条性质,不是「这个库没 bug」。而 138 比 19,797 的比例说明,真正贵的环节已经从「写证明」挪到「写规格、选边界、判断这个边界是否覆盖你实际承担的风险」。seL4 那笔账还在:2 人年实现,20 人年验证。
腾讯把检测、OCR、分割、抠图塞进一个 2B 模型
腾讯开源 WeVisOne-VL,2B 和 4B 两个尺寸,一个模型同时做目标检测、计数、OCR、分割和抠图,论文 10 月 22 日提交。
值得关注的原因:视觉侧过去是一条流水线——检测一个模型、分割一个模型、OCR 再一个,串起来误差逐级放大。收进一个 VLM 之后,误差不再沿流水线累积。更值得看的是它支持显式回答「画面里没有这个目标」,而不是永远给一个位置。这是感知模型最常见的自欺,也是下游系统最难兜的错。
顺带一提
- Axon Body 5 执法记录仪把 AI 算力提到上一代的 25 倍、续航增 20%,冲突预警仍要人工复核。
- Ollama 0.40.11 让 macOS 支持流式语音生成,并把 2B、4B、9B、27B 的 d3 决策模型装进了本地运行时。
- Cloudflare 的 Matthew Prince 说,10 月新披露的漏洞约占今年已知漏洞总数的 3%,未来几年可能每周一次危机。
参考资料
- Nanbeige4.3-33B 模型卡与 Nanbeige4.3-33B-Base,Hugging Face,2026-10-25
- Nanbeige 官方 X 公告,2026-10-25 12:11 UTC
- AI Chat Daily:Nanbeige opens a 33B agent model,2026-10-25
- 央视财经、中国经济网:人形机器人量产与部署调研,2026-10-26
- 国盛通信:Meta 与 SpaceX 2026 年 Q3 财报拆解,2026-10-25
- Anthropic Frontier Red Team × Theorem:LLMs are making formal software verification feasible at a much larger scale,2026-10-22
- Theorem OSS Verify 证明仓库与 Rocq 检查器说明,2026-10
- 腾讯 WeVisOne-VL 项目仓库与论文,2026-10-22
微信公众号
欢迎关注「字与码」
如果这篇文章对你有用,也欢迎在微信里继续关注后续更新。
X / Twitter
关注 @ax2_zicode
更即时的技术观察、新文章提醒和一些短想法会发在 X 上。