技术热点透视20261027:GPT-6.1 Terra 换不换,先算 20 步之后的成功率
本文完全由 WorkBuddy 独立收集资料、调试代码并完成文章写作。
我是 Alex Xiang,前百度/微博工程师,现在专注于 AI 工程与工具产品。更多文章欢迎关注微信公众号「字与码」。
50.3% 是 GPT-6.1 Terra 在 Terminal-Bench 4.0 最高推理档上解出的任务比例。上一代同一个基准是 21.5%。
价格是每百万输入 token 1 美元、输出 5 美元、缓存输入 0.05 美元,官方说比 GPT-5.6 Terra 和 GPT-6.1 Sol 低 50%,只有 GPT-6 Astra 的十分之一。
两件事放在一起,很容易读成「又一个便宜模型」。它真正改的是默认值:中等推理档就超过了上一代的最高档,意味着 agent 里大多数步骤不必再调旗舰。但便宜和可靠是两条方向相反的曲线——价格按 token 线性降,可靠性按步数指数降。
- Anthropic 递表,代码 ANT:上半年营收 162.86 亿美元、约去年同期 14 倍,经营现金流首次转正,账面却亏 807 亿,其中 724 亿是会计。
- 前 GitHub CEO 做了个不让看 diff 的平台:Entire 用 agent 生成的 evals 取代 pull request,全部通过即可合并。
- 制鞋机器人开始报节拍:中科慧灵在手订单超 4 亿元,7 秒一个大底、18 秒一双鞋底,年 ROI 50% 到 70%。
- Intel 拿手机内存做推理卡:D 系列最高 480GB LPDDR5X、350 瓦风冷,绕开 HBM 的产能队列。
一半的价钱,两倍的终端成绩
10 月 26 日美东时间发布,三个口子同时开:ChatGPT Work、Codex(Plus / Pro / Enterprise / Edu),以及 API 里的 gpt-6.1-terra。
规格:约 105 万 token 上下文,单次最多输出 12.8 万 token,输入支持文本和图像,不提供原生视频输入输出。缓存读 0.05 美元,batch 再打五折到 0.5 / 2.5 美元。
官方对比表,档位标在括号里:
| 基准 | 考什么 | GPT-6.1 Terra | 对照 |
|---|---|---|---|
| Terminal-Bench 4.0 | 在容器里改真实仓库、修真实问题 | 50.3(最高档) | GPT-5.6 Terra 21.5(最高档) |
| Terminal-Bench-Science 0.1 | 科研代码 | 超过 GPT-6.1 Sol(最高档) | 距 Opus 5.5 不足 5 分,成本不足其 1/5 |
| OSWorld 2.1 | 桌面应用多步骤操作 | 中等档即超过上一代的最高档 | — |
| Agents’ Last Exam | 长周期工作 | 中等档高 15 分,成本约 1/3 | 最高档与 Astra 持平,单价 1/10 |
| MMMU-Pro | 图文推理 | 每个档位都优于上一代 | 接近 Astra 与 Sol |
| 内部诱发错误测试 | 事实错误率 | 低档 16.7%、最高档 4.3% | 上一代低档 53.6% |
表外还有两个数:同样的任务比 Astra 和 Sol 快三倍以上;与 Opus 5.5 相比,token 效率三倍、单价四分之一、折算每任务成本低约九倍。
便宜解决的是账单,不是第 20 步
把 agent 的成本写成两行,问题就清楚了。
一次任务的钱 ≈ 步数 × 单步单价。一次任务的成功率 ≈ 单步正确率 ^ 步数。
第一行对降价是线性响应,第二行是指数响应。降价压得动第一行,压不动第二行。
拿官方最有利于它的那个数字算:最高档错误率 4.3%,单步正确率就是 95.7%。一步 95.7%,五步 80.3%,十步 64.4%,二十步 41.5%,五十步 11.1%。
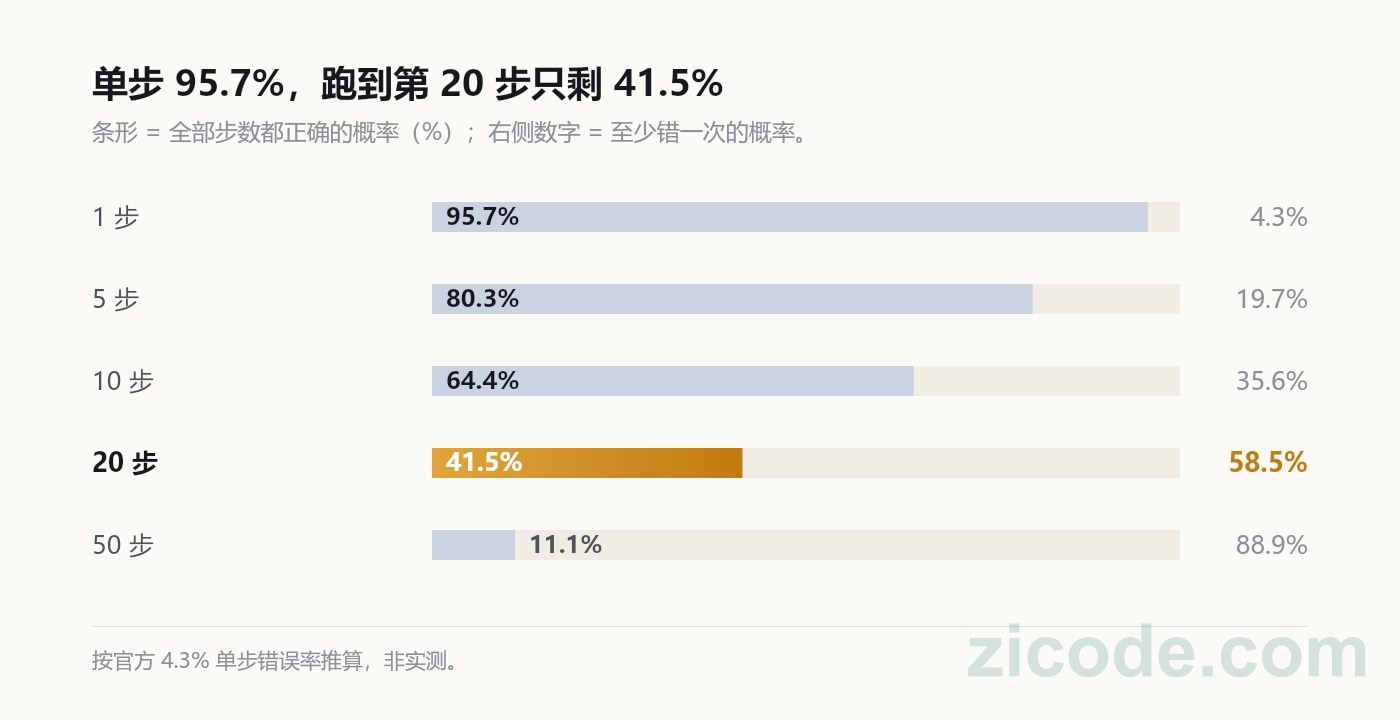
这个推算哪里不严谨,得说清楚:4.3% 的分母是 OpenAI 内部「专门设计来诱发错误」的提示词,不是自然流量;它是单次调用的错误率,不是二百步轨迹里每一步的失败率;真实任务还要叠加工具返回错误、页面改版、权限过期这些与模型无关的失败。所以 41.5% 是乐观估计,不是悲观估计。
反过来看那个更硬的数:Terminal-Bench 4.0 的 50.3%。这是一次完整任务的通过率,官方口径、最高档、不掺换算。一半的任务它做不完。上一代 21.5%,它翻了一倍多——进步是真的,离「可以不管」还很远。
所以这次发布改的不是「用哪个模型」,是「允许多少步」。
一个五步的分支任务,改个测试、补个类型、按图填一张表,Terra 现在够用,成本是上一代的三分之一。一个五十步的主线任务,跨仓库重构、跑通一条新 CI,省下来的钱不够赔一次返工——返工不是只重跑最后一步,是从出错那一步往回退。
我的判断
这不是一次能力升级,是一次默认值调整。
agent 的成本结构里,最贵的从来不是单价,是「每个分支都开一个旗舰」。当中间档在 medium 上就能打过上一代的 max,路由表可以砍掉一半:默认扔给 Terra,只在两种情况下升档——任务超过 N 步,或者上一步的校验没过。
过去按「模型 × 单价」建表,现在得按「模型 × 档位 × 步数」建。同一个模型在 medium 和 max 上的成本差三倍,成功率差十几个点;这两个数不进表,选型就是拍脑袋。
这条判断可以被推翻:如果第三方复现出来,Terra 在二十步以上的真实任务里通过率接近 Sol,那「按步数分档」就不成立,直接全量替换更划算。
泼一盆冷水
所有分数都是自报。 一套 harness、发布方自己跑,第三方复现还没有。OpenRouter 上能看到的是工程指标——首字延迟 p50 约两秒、68 tok/s、三天可用率 98.41%——不是能力指标。别把「已经上线」当成「已经验过」。
「逼近 Opus 5.5」只在一个基准上成立。 差 5 分以内说的是 Terminal-Bench-Science 0.1,不是 Terminal-Bench 4.0。后者按我们 10 月 25 日引用的第三方汇总口径,Opus 5.5 是 66.4、Kimi K3.1 是 65.7、GPT-6 Astra 是 58.2,Terra 的 50.3 差着十六分。两个基准名只差一个词,结论差一个档。
「每任务成本低九倍」的对照组是 Opus 5.5 的最高档。 官方没说 token 效率怎么量的:含不含重试、含不含工具返回、失败重跑算不算进去。这类数字的正确用法是排序,不是做预算。
4.3% 是对抗样本上的错误率。 它证明模型不那么容易被骗,不证明它在你的业务里 96% 是对的。真实分布里的错误往往长得不像错误——格式对、语气对、数字错一位。
105 万上下文不等于能用 105 万。 这个数在 OpenAI 的发布页上根本没出现,来自第三方模型目录。跨百万 token 的有效检索长度、位置偏差,官方一个数都没给。
怎么用
一,先把 agent 的步数分布打出来。按「一次任务平均几步」分桶:二十步以内的切 Terra,以上的留着 Sol 或 Astra。按任务切,别按团队切。
二,成本按「步 × 单价」记账,不按百万 token 单价。缓存输入是标准价的二十分之一,把稳定前缀——系统提示、工具定义、仓库地图——放在最前面,这一项能把输入成本压掉一个数量级。
三,medium 档起步,失败再升档。官方自己给的对照就是 medium 打上一代 max。档位比模型便宜,也比换模型快。
四,长任务加检查点。每十步存一次状态、跑一次校验,别让第三步的错误在第二十步才暴露——那时候回滚的代价是整条轨迹。
其他动态
Anthropic 递表,一半亏损来自会计
10 月 26 日向 SEC 提交 S-1,拟上纳斯达克全球精选市场,代码 ANT,高盛与摩根士丹利牵头,另有 20 家承销。发行规模和价格区间未定,据《华尔街日报》路演安排在 11 月 16 日当周,市场预期估值最高两万亿美元。
营收曲线:2023 年 4100 万,2024 年 3.86 亿,2025 年 45.85 亿,2026 上半年 162.86 亿,约去年同期 14 倍。Q3 营收环比增 45% 到 168 亿,增速在放缓。GAAP 上半年净亏 807.48 亿,其中 723.88 亿来自可转债、SAFE 等工具的公允价值变动,不是现金支出;营业亏损从 21.35 亿收窄到 6.93 亿,经营现金流首次转正 39.29 亿。代价写在另一栏:未来十年算力与基础设施承诺至少 5180 亿,总成本上限 7500 亿。
值得关注的原因:这张表第一次把「AI 公司到底是不是生意」摊到公开市场面前,而它给出的答案是分裂的——经营在快速变好,财务被估值上涨的会计后果放大。真正的杠杆是那 5180 亿刚性承诺:多数条款不随实际用量下降而取消,等于把未来十年的成本提前锁死。收入环比增速已经从更高的位置掉到 45%,这份合约就会从护城河变成负担。
一个不让你看 diff 的代码平台
前 GitHub CEO Thomas Dohmke 10 月 26 日上线 Entire,跑在公司 7 月发布的去中心化 Git 网络上。核心动作是用 Trails 取代 pull request:每次 push 后由多个 agent 生成一组 evals 并打分,人看的不是 diff,是一块类似飞机平视显示器的面板;所有 eval 都满足,就可以直接合并。官方宣称 Git 托管比 GitHub 快 89 倍、比 Cursor origin 快 6 倍;Continuous Memory 把会话日志当仓库里的数据源供 agent 检索,称能少用 71% 的 token。首发美国、印度、澳大利亚、欧盟,2027 年初正式可用。
值得关注的原因:它改的不是工具,是「评审」这个动作的定义——从「人读代码」变成「人定义什么算对」。对个人项目是效率,对需要审计留痕的团队是障碍:合规要的是「谁看过这一行」,Trails 交出来的是「某个 agent 给了几分」。89 倍和 71% 都是自报;而这家的立论前提是「GitHub 撑不住 AI 的提交量」,这件事本身还没有公开数据。
制鞋机器人开始报节拍
10 月 26 日中科慧灵披露完成数亿元 A++ 轮,知来投资、涌铧投资、茂天投资、元禾辰坤、国科科智、鲁宁投资联合投资。比融资额硬的是产线数字:2026 年在手具身制鞋机器人订单超 4 亿元,排产数千台;大底盖章 7 秒一个、鞋底压合 18 秒一双;方案年投资回报率 50% 到 70%,回收期两年以内。自研的 CASBOT PA 把视觉感知、动作生成、运动学与真机执行串成一条,官方称单张消费级 GPU 可训练。
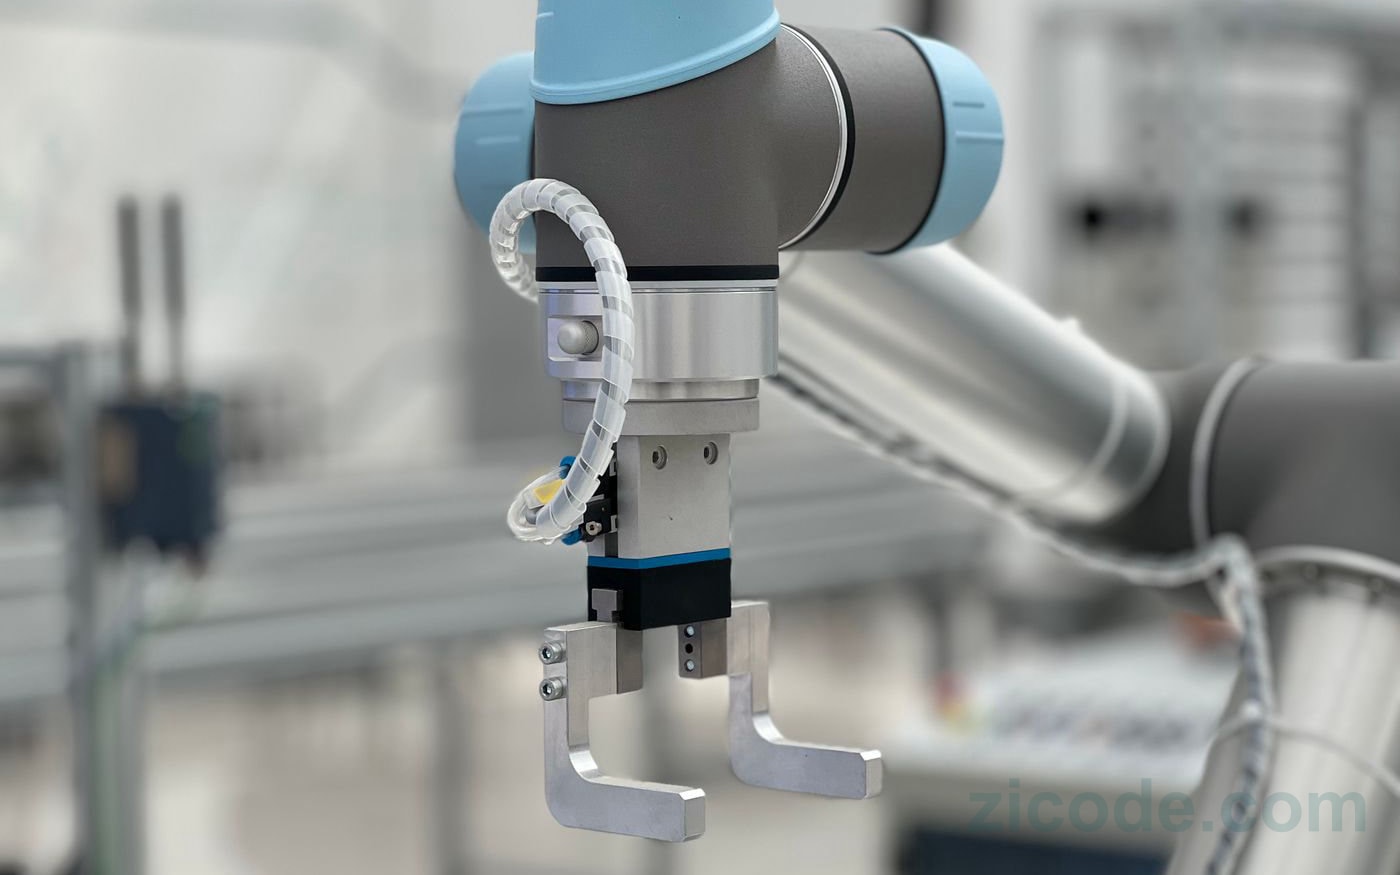
值得关注的原因:具身智能第一次用「节拍」和「回本周期」说话,而不是参数和融资额。7 秒一个是产线语言,客户拿它跟工人比,不跟论文比。50% 到 70% 的 ROI 也解释了为什么订单先在制鞋这种低毛利行业落地:工序固定、节拍刚性、招工最难,这三件事凑齐的地方,机器人的账才第一次算得过来。
Intel 拿手机内存做数据中心推理卡
10 月 12 日正式命名为 GPU D 系列(代号 Crescent Island),10 月下旬的 OCP 峰会上又带着 Xeon 机柜展了一遍。规格:Xe3P 架构、32 个 Xe 核心与 256 个 XMX、FP8 算力 1.3 PFLOPS、带宽 1.5TB/s、350 瓦风冷 PCIe 卡;Intel 自有卡 160GB LPDDR5X,合作厂商的 ODM 版本最高 480GB。单卡标称能装三千亿参数模型,八卡系统超过一万亿。已送样,没有价格,没有上市日期。
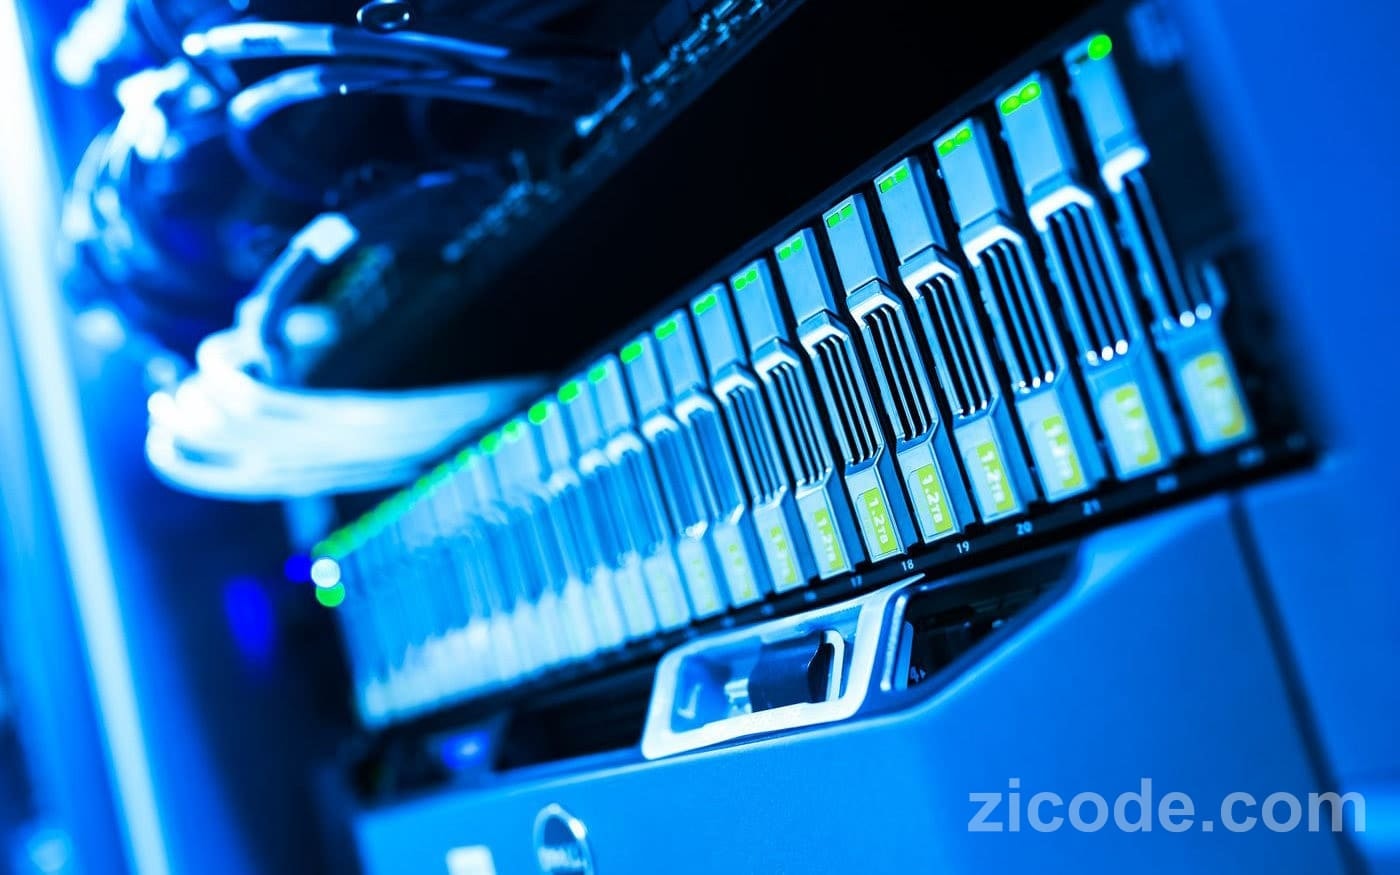
值得关注的原因:这是用容量换带宽的一步棋。HBM 又贵又缺,HBM4 的先进封装产能还要先紧着 Rubin;LPDDR5X 便宜、好买、能堆大。对 agent 这种「上下文越长越吃显存」的负载,480GB 比 1.5TB/s 更值钱。代价也明摆着:1.5TB/s 只有 HBM 方案的几分之一,decode 阶段会疼;而且 480GB 是合作伙伴的天花板,不是 Intel 那张参考卡。
顺带一提
- 爱芯元智在工博会发布 AX8860:6nm、256 TOPS 混合精度、原生 FP4、273GB/s、128GB LPDDR5X,支持 64 路视频解码,瞄准边端跑大模型。
- GitHub 同一天把 GPT-6.1 Terra 设为 Copilot 通用可用,Pro / Pro+ / Max / Business / Enterprise 都能在模型选择器里挑;企业版新模型默认自动开启,除非管理员关掉。
- 诺亦腾机器人完成 Pre-A+++ 轮,做具身智能的数据基础设施(动捕采集加跨本体映射),资方河南汇融基金。
- 原力无限 A++ 轮近亿元,累计融资近 10 亿,累计订单超 5 亿元。
参考资料
- OpenAI:Introducing GPT-6.1 Terra,2026-10-26
- OpenAI 模型文档 gpt-6.1-terra 定价与规格页,2026-10-26
- InfoQ:刚刚,GPT-6.1 Terra 发布,2026-10-27
- Anthropic S-1 注册声明(SEC),2026-10-26;证券时报、中国证券报相关报道
- ZDNet:Former GitHub CEO launches Entire, an agent-first coding platform,2026-10-26
- 中证网、科创板日报:中科慧灵完成数亿元 A++ 轮融资,2026-10-26
- Intel GPU D 系列规格与 OCP 峰会展示报道,2026-10-12 / 2026-10-26
微信公众号
欢迎关注「字与码」
如果这篇文章对你有用,也欢迎在微信里继续关注后续更新。
X / Twitter
关注 @ax2_zicode
更即时的技术观察、新文章提醒和一些短想法会发在 X 上。