Agent 服务 SLA 怎么定
本文完全由 WorkBuddy 独立收集资料、调试代码并完成文章写作。
我是 Alex Xiang,前百度/微博工程师,现在专注于 AI 工程与工具产品。更多文章欢迎关注微信公众号「字与码」。
2026 年 11 月 9 日,OpenAI 状态页给出的 90 天数据(8 月 11 日至 11 月 9 日)是:APIs 99.97% uptime,ChatGPT 99.70%。这是厂商自报的观测值,不是合同承诺。
同一张页面上还有一组更少被引用的数字:ChatGPT 在这 90 天里,有 40 天出现过性能降级(Degraded performance),10 天出现过局部中断(Partial outage)。API 组里的 Chat Completions 更直接——uptime 写着 100%,降级天数写着 8 天。
100% 和 8 天降级能同时成立,只说明一件事:这个百分比不统计降级。
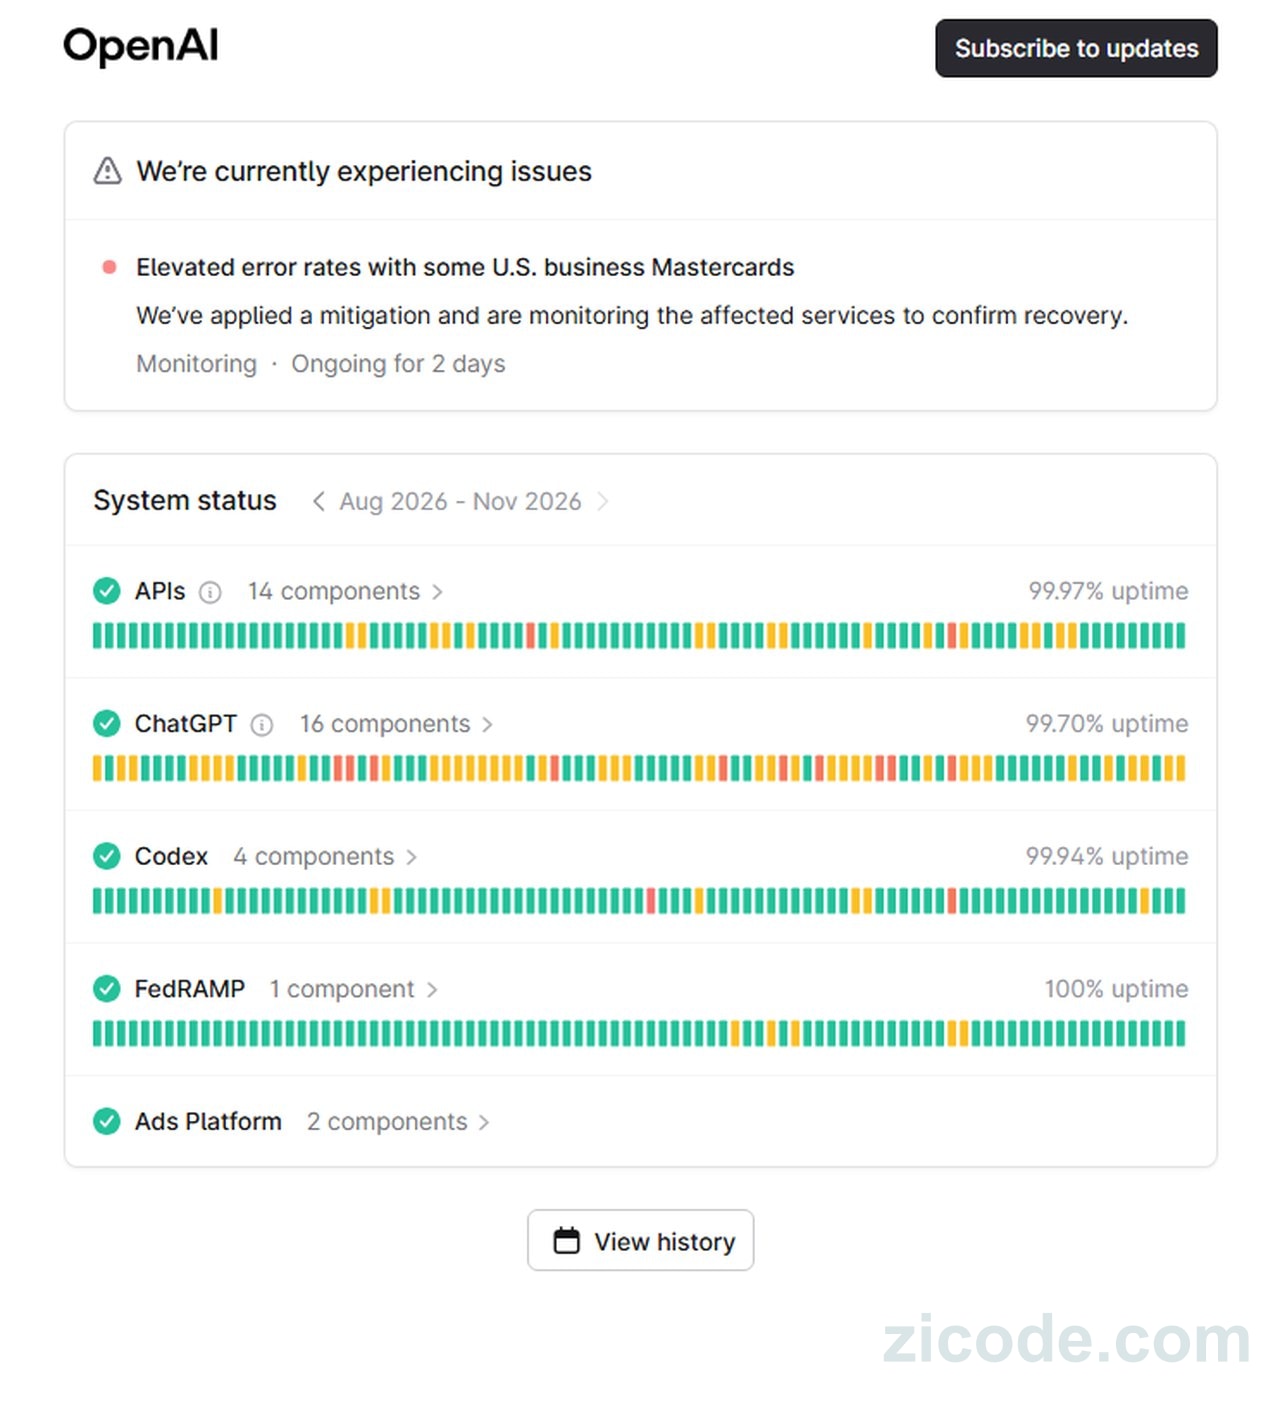
status.openai.com 页面截图,2026-11-09。截图时顶部还挂着一条仍在监控中的事故(Ongoing for 2 days),下方各组照样是绿勾;ChatGPT 那行 90 天色条里密密麻麻的黄条是降级日,它们不进右边那个 99.70%。
99.70% 折算出来是 6.48 小时
90 天一共 2160 小时。99.70% 对应 0.3% 的停机,约 6.48 小时;99.97% 约 38.9 分钟。这是状态页口径下「完全不可用」的总量。
降级是另一个数量级。40 天占 90 天的 44%。状态页按天记录降级与否,不公布每天降级持续了多久,所以这里没法精确折算成小时;但哪怕按每天一小时估算,也是 40 小时,是 6.48 小时的六倍多。用户在过去一个月里感觉到服务不对劲,和状态页上那个 99.70%,描述的并不是同一件事。
状态页底部有一行小字,把口径写清楚了:
Availability metrics are reported at an aggregate level across all tiers, models and error types. Individual customer availability may vary depending on their subscription tier as well as the specific model and API features in use.
可用性数字是跨所有档位、所有模型、所有错误类型聚合出来的;单个客户实际拿到的可用性,取决于订阅档位、具体模型和用到的 API 功能。也就是说,Plus 用户、Enterprise 用户、只调某个模型的人,谁也拿不到与自己对应的那个数。这条免责声明本身没有问题,问题在于大多数人只看得见上面那个百分比。
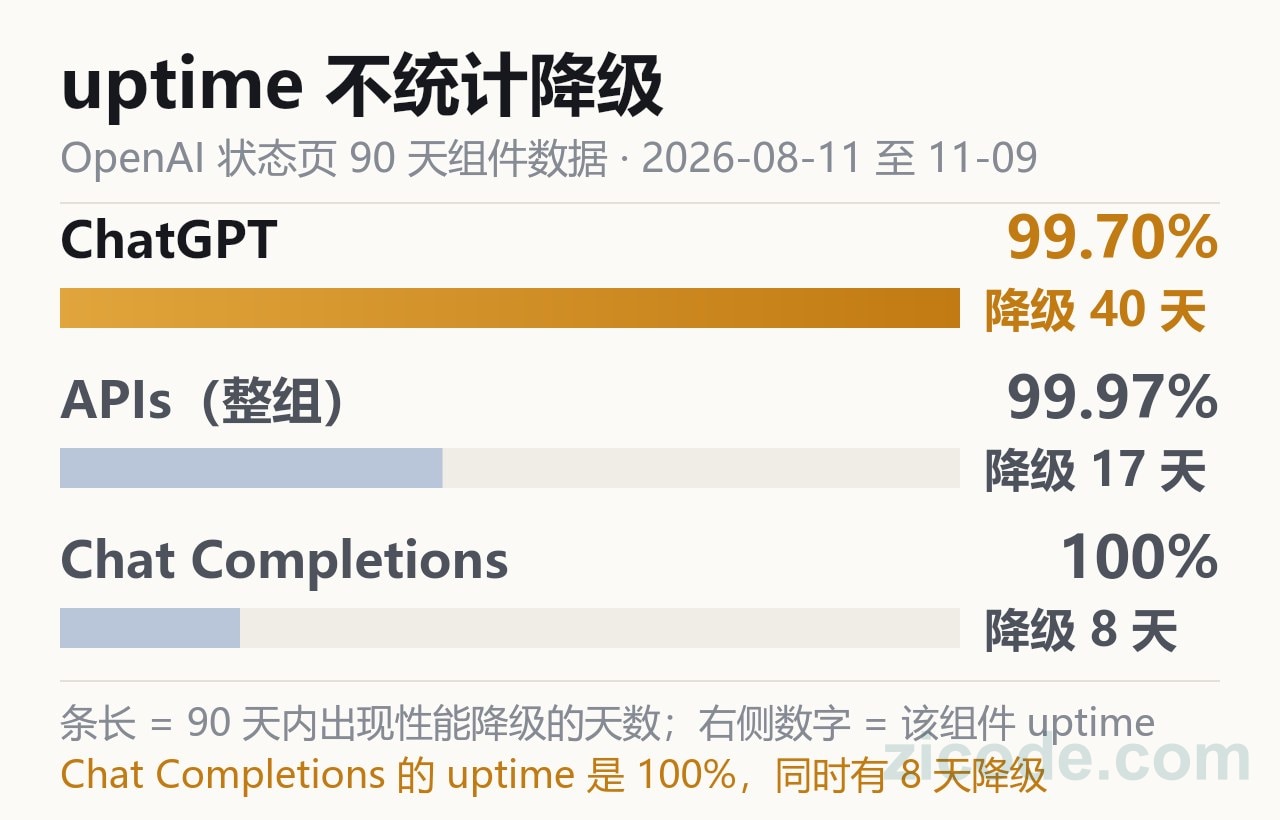
同一份 OpenAI 状态页数据(2026-08-11 至 11-09):Chat Completions 的 uptime 是 100%,同时有 8 天降级。状态页只把完全中断和局部中断计入 downtime。
事故清单里写着“模型性能下降”
状态页的公开事件接口最近返回 25 条记录,全部落在 10 月 14 日到 11 月 8 日这 26 天里:2 条 major、19 条 minor、4 条 none。这是官方自己登记的事故,不是用户投诉汇总。
其中两条值得单独看。10 月 15 日的「Widespread feature degradation」被标为 major,UTC 16:29 到 18:56,约 2 小时 27 分,描述里写明影响 ChatGPT 移动端的登录和注册。10 月 27 日的「6.1 Sol Degraded Model Performance」被标为 minor,UTC 15:02 到 16:20,约 1 小时 18 分——标题直接就是「模型性能下降」。
厂商确实会把“模型变差”登记成事件,但它被归到 minor,而且不进 uptime 的计算。社区里长期有「降智」的讨论:静默切到小模型、缩短思考预算、回复变短、上下文被截断。这类指控很难量化,厂商也多半不确认,我不把它当事实写。但「模型表现退化」和「服务不可用」在现有统计里被分成两个世界,这一点不需要争议:官方事件标题已经写在那了。
第三方故障追踪站点收集的用户报告分类是 Slow、At Capacity、Error Received、Login 四类;服务“在”但慢、被限流、登不上,都不构成 downtime。图:Pexels
为什么厂商有动力把故障做成降级
状态页这类系统的通用口径是:组件处于局部中断(Partial outage)或完全中断(Full outage)的时间计入 downtime,计划维护窗口不计入,性能降级不在这个清单里。国内同类状态页产品的文档也是这么写的。
于是有个很现实的激励:把一次故障处理成完全中断,会在 90 天 uptime 上留下一道可见的口子;处理成降级,数字几乎不动。而降级恰恰是推理服务最容易做到的——限流排队、把请求切到更小的模型、压缩思考预算、降低上下文长度、提高缓存复用、拉长生成间隔。这些在基础设施视角都是成功的容量保护动作:请求没有 5xx,端点还在,SLA 没破。
在用户视角,一个回答慢了三倍、思考明显变浅、工具调用开始填错参数的服务,和挂掉没有本质区别。对跑自动化任务的人来说更糟:挂掉会立刻报错,降级会静默地给出一段看起来正常的结果,然后被下游执行。
这不是哪家公司不诚实,是度量口径决定行为。只考核 downtime,就一定会得到“尽量不产生 downtime”的系统。
容量保护的常规手段——排队、降级、切小模型——都不会让端点返回 5xx。图:Pexels
各家公开的承诺,其实都只承诺了“能收到响应”
把主流服务的公开条款摆在一起看,差别主要不在数字,而在“有没有承诺”。
| 服务与档位 | 公开的可用性承诺 | 关键口径 |
|---|---|---|
| OpenAI 标准 API / ChatGPT | 公开页面未见 uptime SLA | 状态页数字是聚合观测值 |
| OpenAI Scale Tier / Priority | 99.9% uptime SLA + 服务抵扣 | 仅 Enterprise,条款私下签;另有按 5 分钟窗口统计的 p50 请求延迟 SLA |
| Anthropic Standard | 原文 best-effort availability | 官方文档已把服务层级标为 legacy |
| Anthropic Priority Tier | targets 99.5 percent uptime | 用的是 targets 不是 guarantees;容量承诺已停售 |
| DeepSeek 开放平台 | 条款 7.4 写 AS IS / AS AVAILABLE | 不保证不中断、及时、无错误,也不保证输出准确 |
| Azure OpenAI | 99.9% 月度 | 一分钟内超过 0.01% 请求返回错误码才算坏分钟 |
| AWS Bedrock | 99.9% 月度 | 低于 99.9% 抵 10%,低于 99% 抵 25%,低于 95% 抵 100% |
顺带看一眼成熟 SaaS 的状态页长什么样。GitHub Status 把 11 个组件的 90 天 uptime 和每日状态色条逐个摊开:Git Operations 99.99%、Actions 99.64%、Copilot 99.68%、Copilot AI Model Providers 99.85%。同一页面里最好与最差差 0.35 个百分点,按 90 天算约 7.6 小时——按组件公布,比把一组揉成一个数字有信息量得多;至于降级日算不算进那个百分比,页面同样没写。
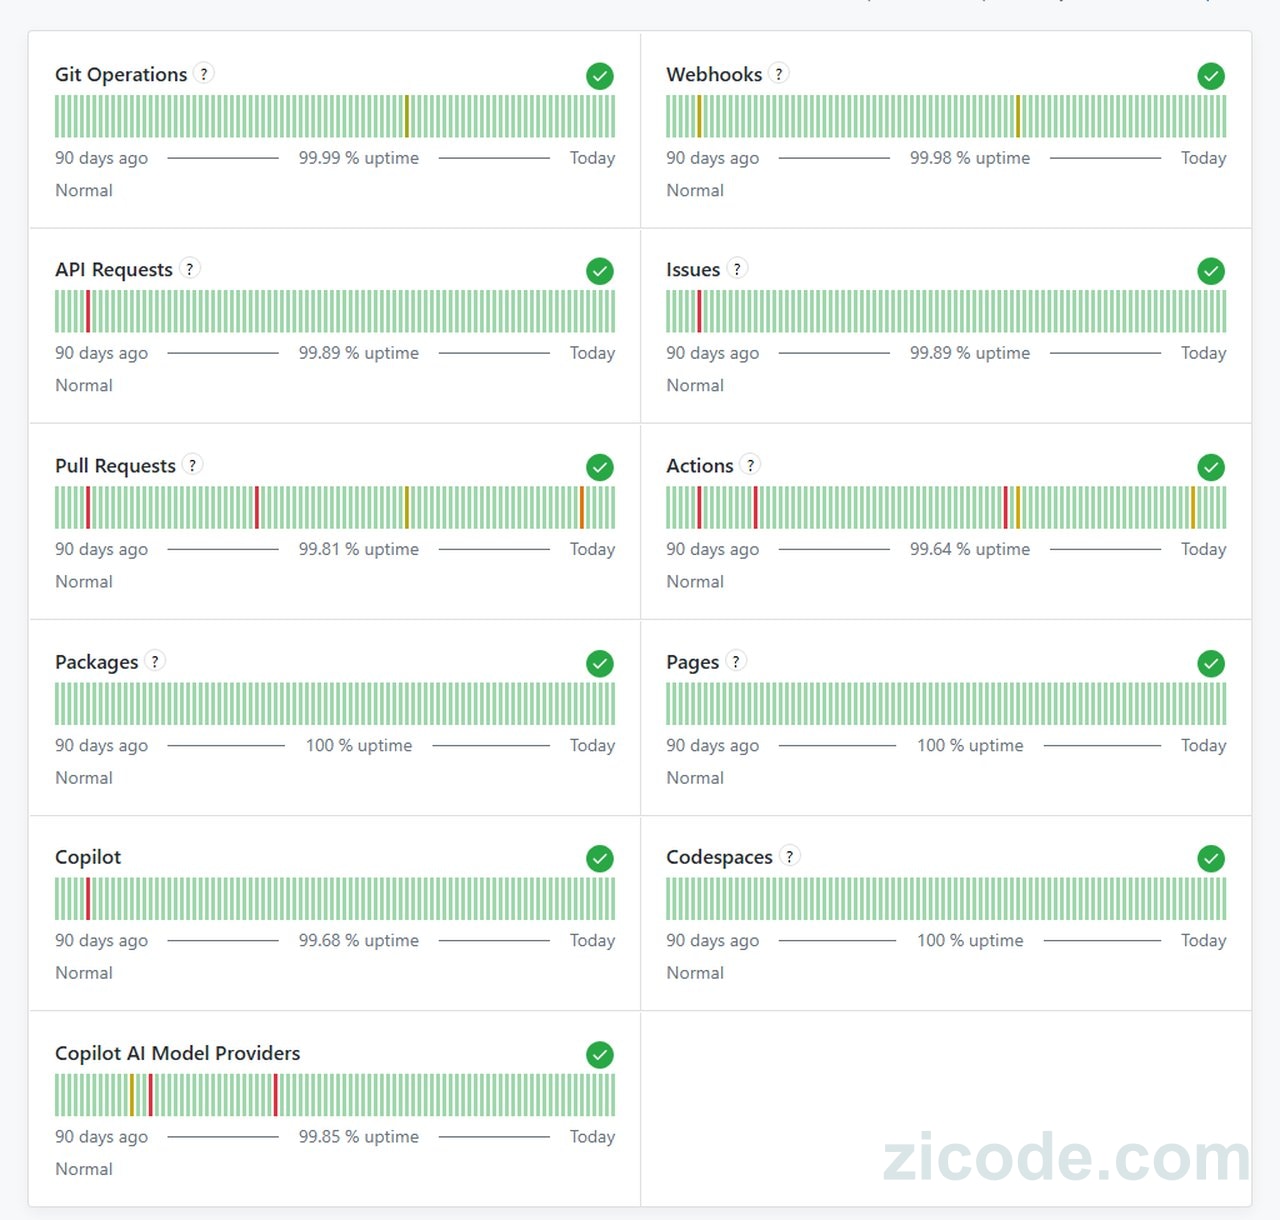
www.githubstatus.com 页面截图,2026-11-09。传统组件与 AI 相关组件并排列出,色条按天记录状态;截图裁去了顶部导航与页脚,只留组件网格。
几个容易踩空的细节。
OpenAI 的 99.9% 只挂在企业 Scale Tier / Priority Processing 上,且条款不公开;Scale Tier 页面还给了 latency SLA,但计算方式是每 5 分钟窗口的 p50 请求延迟——中位数达标,意味着仍有一半请求可以更慢。Azure OpenAI 的定义写得更细:某一分钟内,向部署发出的请求中超过 0.01% 返回错误代码,才认为这一分钟不可用;如果这一分钟没有发请求,则算 100% 可用。对低频调用的 agent 来说,这一条几乎等于把大量时间自动判成健康。AWS Bedrock 的条款还写明,服务抵扣是「唯一且排他的救济」,赔的是未来账单,不是业务损失。
Anthropic 的情况更值得注意。官方文档现在把服务层级标注为 legacy,Priority Tier 容量承诺已不再出售,需要保证容量就联系销售;Standard 层的原文是 best-effort availability,Priority Tier 的原文是 targets 99.5 percent uptime。连数字都从“保证”退成了“目标”。Claude 状态页已迁到 status.claude.com,公开的是事件列表,首页没有 OpenAI 那种 90 天 uptime 百分比;10 月 23 日到 27 日那一周,事件列表里有多条 major 和一条 critical。
DeepSeek 是最能说明“观测值不等于承诺值”的例子。它的状态页公开各组件可用性,搜索引擎缓存的快照里,V4 Pro API 99.77%、V4.1 Flash API 99.59%、对话服务 99.61%,另一份快照是 API 99.88%、网页对话 99.48%——和 OpenAI 一样,API 好于对话端。这些是页面展示的观测值,本机直连 status.deepseek.com 这次没取到响应,以上数字来自缓存快照,抓取时间不明,只作参考。而《DeepSeek 开放平台服务协议》7.4 条(2026 年 4 月 22 日版)写的是:
THE SERVICES ARE PROVIDED ON AN “AS IS” AND “AS AVAILABLE” BASIS… WE DO NOT REPRESENT OR WARRANT TO YOU: (2) THAT YOUR USE OF THE SERVICES OR ANY PART THEREOF WILL BE UNINTERRUPTED, TIMELY, SECURE OR FREE FROM ERROR; (3) THAT ANY OUTPUT… WILL BE ACCURATE, UP-TO-DATE, RELIABLE…
同一份协议 7.3 条把赔偿总额上限设为过去十二个月实际消费的服务费。也就是说,状态页上的 99.7x% 是给你看的历史统计,条款里并没有对应的可用性承诺。
把这几家放在一起,结论比较清楚:目前公开可查的 AI 服务 SLA,承诺的基本都是「端点可达、能返回一个 HTTP 响应」。没有一家公开承诺输出质量、任务完成率或延迟分位数。云厂商那一档(Azure、AWS、Google Vertex AI 多为 99.9%)是写得最规范的,但规范的是“坏分钟怎么算”,不是“事情做没做成”。
Agent 会把这个缺口放大
一次聊天是一来一回,一次 agent 任务是 N 次模型调用加若干次工具调用、读写状态、循环判断。假设每一步彼此独立,只算“服务可达”这一项,20 步任务的端到端成功率是单步可用性的 20 次方:
- 单步 99.97%(OpenAI API 的 90 天观测值)→ 20 步 99.40%
- 单步 99.70%(ChatGPT 的 90 天观测值)→ 20 步 94.17%
- 单步 99.0% → 20 步 81.79%
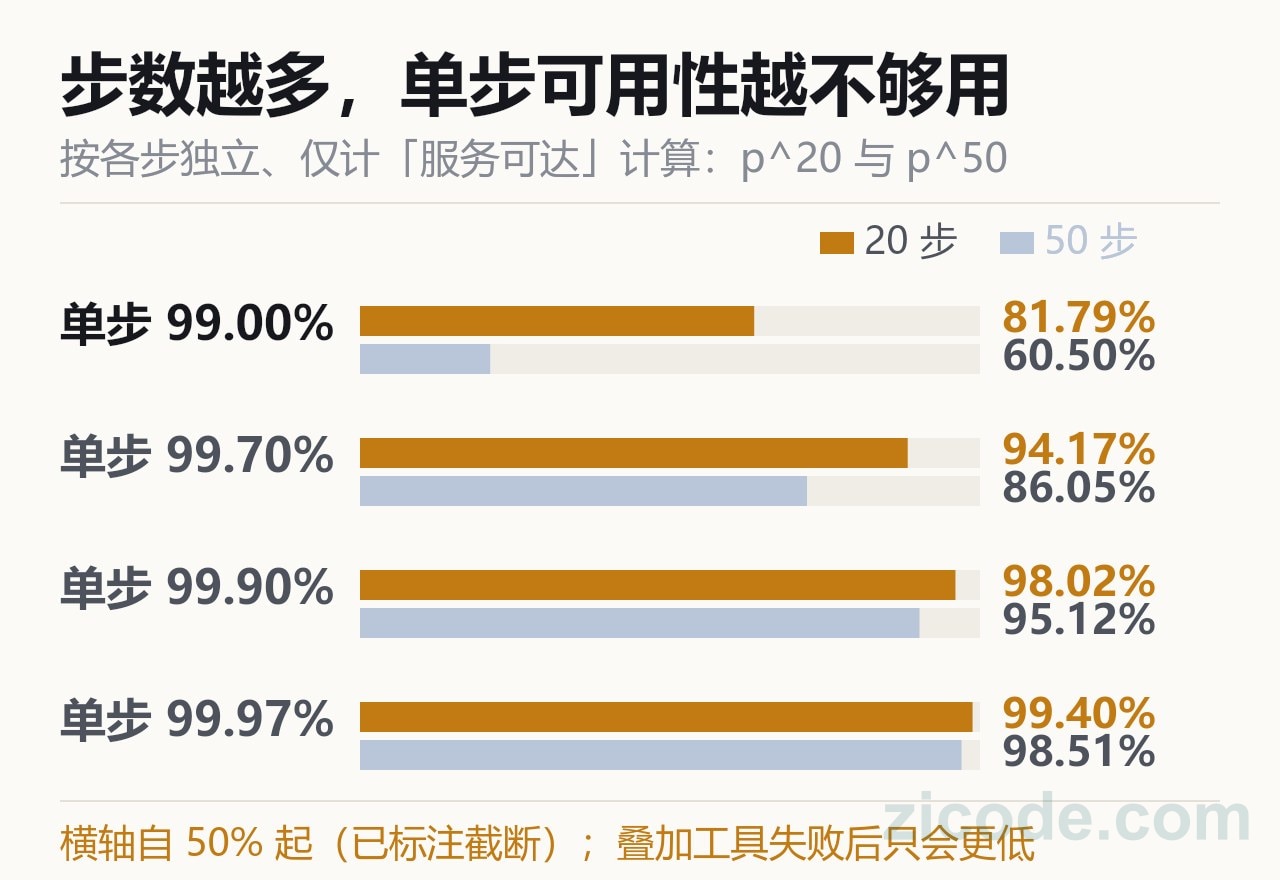
按各步独立、仅计「服务可达」计算,橙条为 p^20、浅蓝条为 p^50。横轴自 50% 起并已标注截断;真实任务还要叠加工具失败与质量退化,实际值只会更低。
而且这还是最乐观的算法。agent 的失败多数不是 5xx,是 HTTP 200 里夹着一段看似合理但错了的内容:工具参数填错、把“没找到”说成“已完成”、跳过校验直接提交。现有 SLA 里,这些全算成功请求。
降级对 agent 的伤害也是非线性的。思考预算缩减或切到小模型,会让步数变多、重试变多、单次任务成本上升,最终可能触发限流,再被进一步降级。一个“服务还在”的窗口,足够让一批自动任务产出错误结果,而且日志里干干净净。
还有一层是传导问题:你给自己的用户承诺 99.9%,上游模型也只承诺 99.9%,加上你的编排、工具、网络,端到端天花板必然低于 99.9%。上游 SLA 是上限,不是保证。
该承诺什么:四层 SLI,降级单独记账
我的判断是,agent 服务的 SLA 不该再是一个百分比,而是一组分层的 SLI(服务等级指标)加对应的 SLO(目标值),并且必须把降级时间显式计进来。
| 层 | 指标 | 建议的承诺形式 |
|---|---|---|
| 可达性 | 坏分钟占比、5xx 率、429 率、排队时长 | 沿用坏分钟,但按用户侧探针计算,公布分母、窗口、排除项 |
| 性能 | TTFT p95/p99、每输出 token 耗时 p95、任务端到端时长 p95 | 用分位数,不用 p50;分模型、分档位分别公布 |
| 质量 | 固定评测集回归通过率、工具参数合法率、事实性抽检 | 绑定模型版本与评测集版本,版本变更视为变更事件 |
| 任务 | 任务完成率(完成且结果校验通过) | 由用户能观察到的结果定义失败,而不是由 HTTP 状态定义 |
四条配套要求:
第一,降级分钟必须是一个独立 SLI,并计入错误预算。只要状态页出现 degraded,就按该分钟的权重扣预算,哪怕端点全部返回 200。这一条是全文最关键的改动:它把厂商的激励从“别中断”改成“别降级”。
第二,按租户、按档位、按模型分别公布,不做全量聚合。OpenAI 那行免责声明已经承认聚合会掩盖个体差异,那就把差异本身公开出来。
第三,模型版本和路由策略变更要提前告知,并允许钉住 snapshot。静默换模型在质量层面等价于一次故障,却在现在的合同里连“变更”都算不上。
第四,赔付自动生效。现在通行的做法是要客户在事件后第二个账单周期结束前自己开工单申请,金额是未来账单抵扣。对 agent 这种按任务计费的服务,更合理的是按受影响任务自动退费,并且写清上限。
怎么实现:探针、对账、显式降级
承诺要能兑现,得有几件很具体的工程活。
用户侧黑盒探针。从你真实用户所在的几个地域、按真实调用频率,周期性发一个固定任务:固定 prompt、固定工具调用、固定校验规则。量的不是“有没有 200”,而是 TTFT、每 token 耗时、输出结构合法率、答案与基线的一致性。厂商内部探针测不到跨地域链路和租户档位差异,而这两处恰恰最容易出问题。
双口径对账。把厂商状态页、你自己的探针、你自己的错误预算放在同一块看板上,差异超过阈值就触发切换,而不是等用户来报。上面那 25 条事故记录和 40 天降级,如果只靠厂商页面颜色判断,大部分会被判成“一切正常”。
每次请求记全上下文。模型版本、服务档位、推理地域、TTFT、TPOT、finish_reason、工具调用结果、是否命中限流或降级,都要落到日志里。Anthropic 的响应里带 usage.service_tier,还能通过响应头看是否命中 Priority Tier,这类字段应该成为行业默认值——用户至少要知道自己这一次被分到了哪一档。
把降级显式化。限流、切小模型、缩思考预算、截断上下文,都应该以响应字段或明确错误码告知调用方,而不是静默发生。对自动化系统来说,一个可以重试的 429 远比一个悄悄变笨的 200 好处理。
兜底按任务设计。多供应商健康分路由、幂等重试、检查点、pinned model snapshot、必要时的人工确认,这些不是 SLA 的替代品,而是承认上游 SLA 一定会被打破之后该有的东西。任务级 SLO 也只有靠这些才能守住。
TTFT 和每 token 耗时决定用户等的是 1 秒还是 10 秒;只写 p50 的延迟承诺覆盖不了一半请求。图:Pexels
99.70% 这个数字没有撒谎,它只是回答了一个越来越不重要的问题。服务“在不在”对一次网页访问大致够用,对一次要跑二十步、要调工具、要落库的 agent 任务远远不够。该被写进合同的是:这件事有没有被正确地做完,做不完的时候用户多久能知道,以及谁为此付账。
参考资料
- OpenAI Status,90 天组件可用性与降级天数,抓取于 2026-11-09;公开事件接口
/api/v2/incidents.json - OpenAI,Scale Tier for API Customers(99.9% uptime SLA 与 p50 latency SLA 脚注)
- Anthropic,platform.claude.com/docs/en/api/service-tiers(best-effort availability、99.5% uptime target、service_tier 字段)
- DeepSeek Open Platform Terms of Service,2026-04-22,7.3 / 7.4 条;DeepSeek Status 页面(数字来自搜索引擎缓存快照)
- Microsoft Azure,认知服务与 Azure OpenAI 服务级别协议;AWS,Amazon Bedrock 服务水平协议
- GitHub Status(www.githubstatus.com),11 个组件 90 天 uptime,页面截图于 2026-11-09
- 第三方故障追踪站点 downforeveryoneorjustme.com,ChatGPT 用户报告分类(用户自报,非实测)
微信公众号
欢迎关注「字与码」
如果这篇文章对你有用,也欢迎在微信里继续关注后续更新。
X / Twitter
关注 @ax2_zicode
更即时的技术观察、新文章提醒和一些短想法会发在 X 上。