生图提示词遵循度评测:同一段中文提示词下的九张查漏图
本文完全由 WorkBuddy 独立收集资料、调试代码并完成文章写作。
我是 Alex Xiang,前百度/微博工程师,现在专注于 AI 工程与工具产品。更多文章欢迎关注微信公众号「字与码」。
同一段中文提示词,九张 1536×1024 的图,10 分制,最高 10 分,最低 6 分,其余七张是 7、8、9 分。九张合计 78 分,平均 8.7 分。
九张图分两组:五张是评测目录里原有的(三张从 ChatGPT 界面导出,两张来自 WorkBuddy),四张是这次直接调 OpenAI 图像 API 生成的。文件名上挂着九个不同标签——GPT-6-Luna、GPT-6-Astra-Extra-High、Pro、hy3、hy4,以及 gpt-image-2.6-flare 这类型号名。分数摊开,前一组是 10、9、10、8、6,后一组是 7、9、9、10。
原始材料是一份评测报告、一份提示词文本、一份 API 用量 CSV,加上九张对应的原图。生图那一步不在本次写作范围内,下面只把评分口径、九张图和测量结果完整摊开,最后说一个容易被读错的地方:界面上的模型名,多半不是画图的那个模型。
一段提示词,十个能数出来的检查点
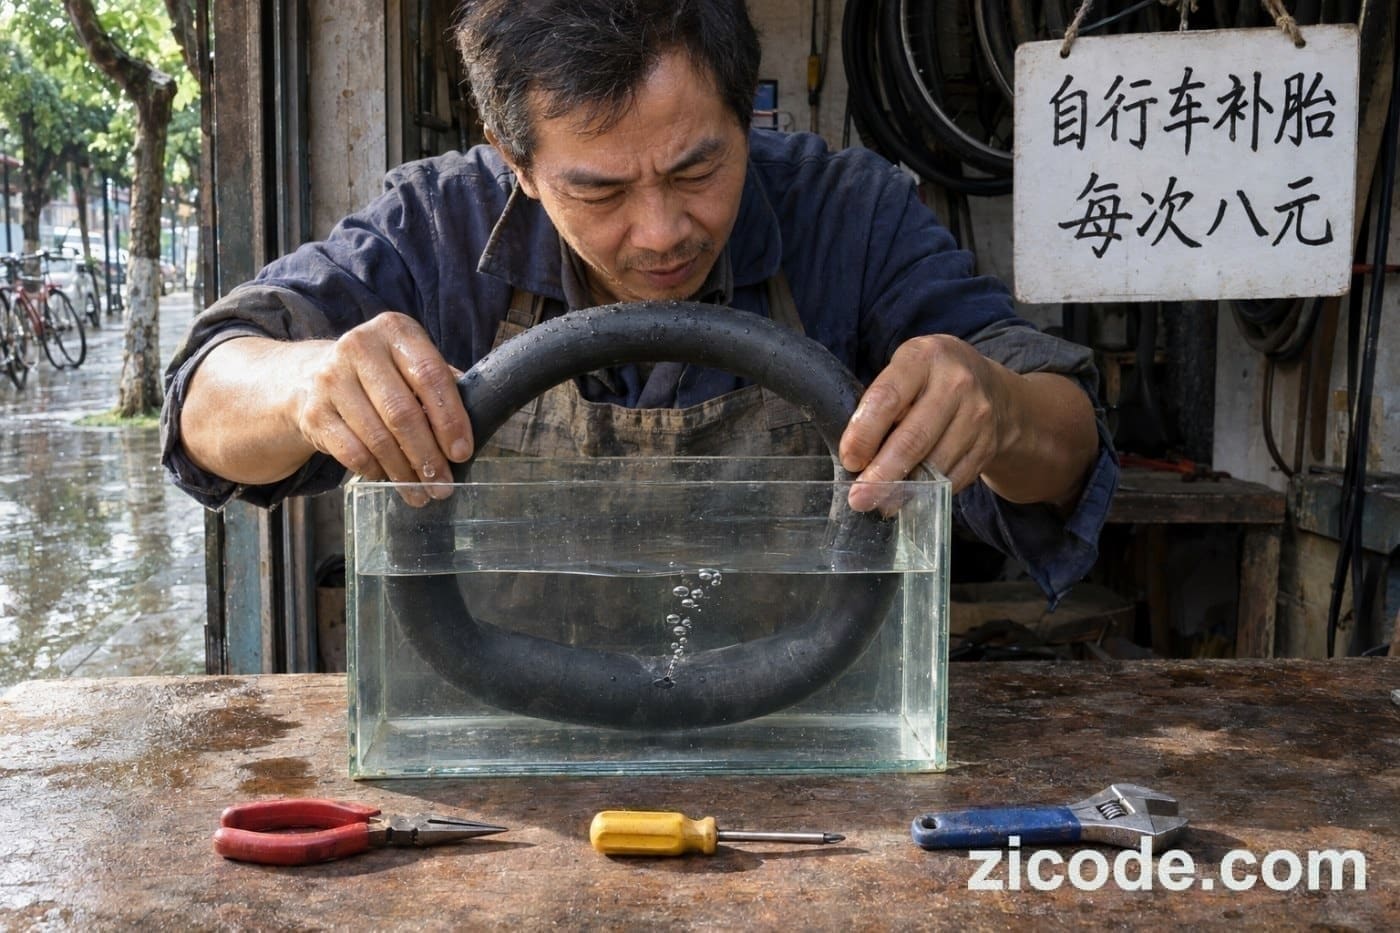
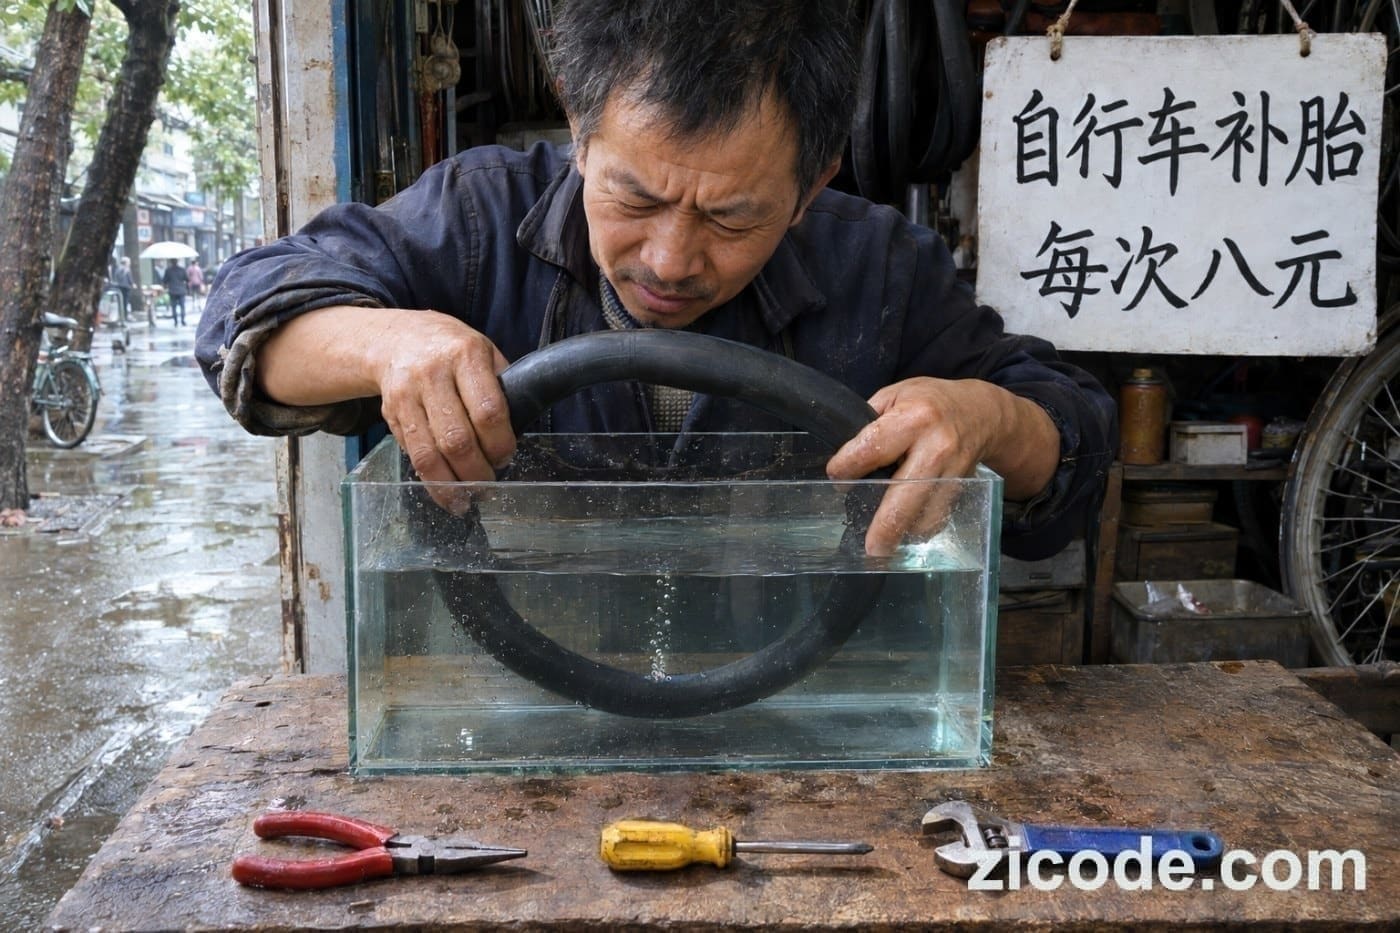
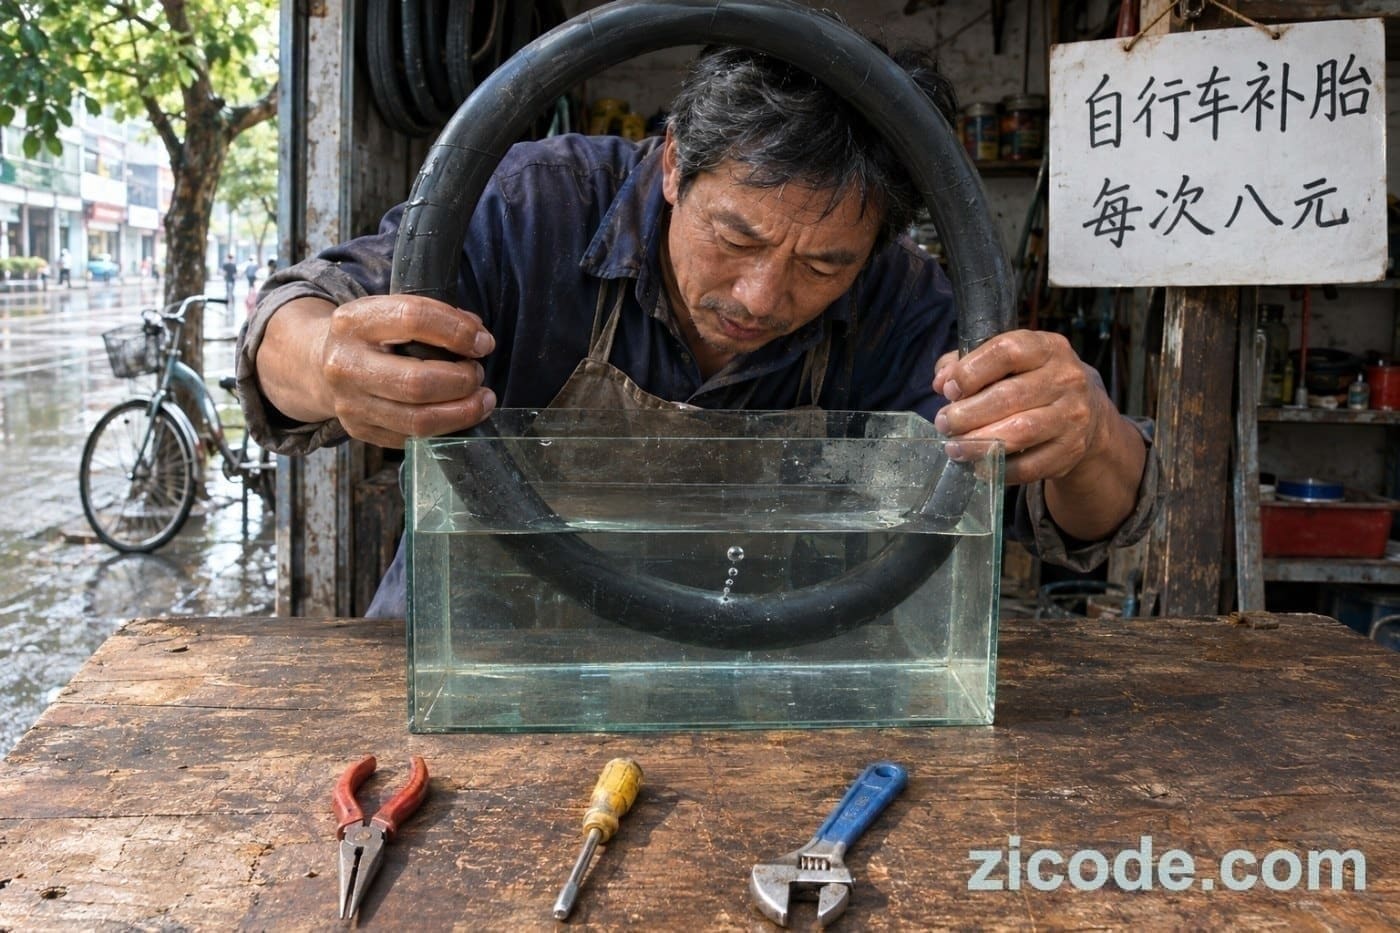
提示词要求一张横向 3:2 的纪实摄影照片:雨后的街边自行车修理铺,一位师傅低头给内胎查漏,镜头从工作台正前方略俯拍,能看清表情、双手和桌面。
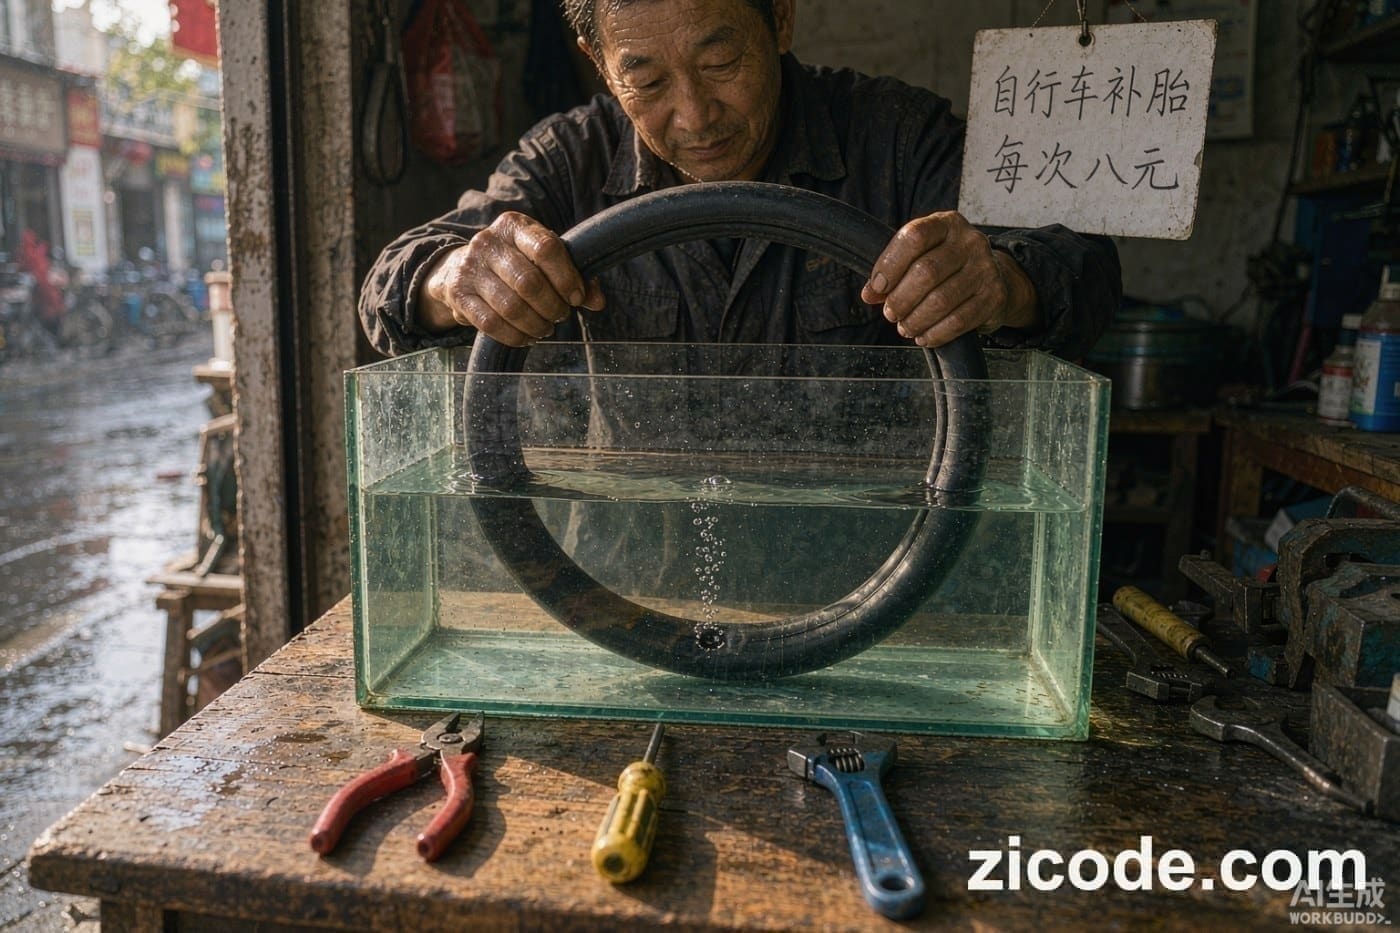
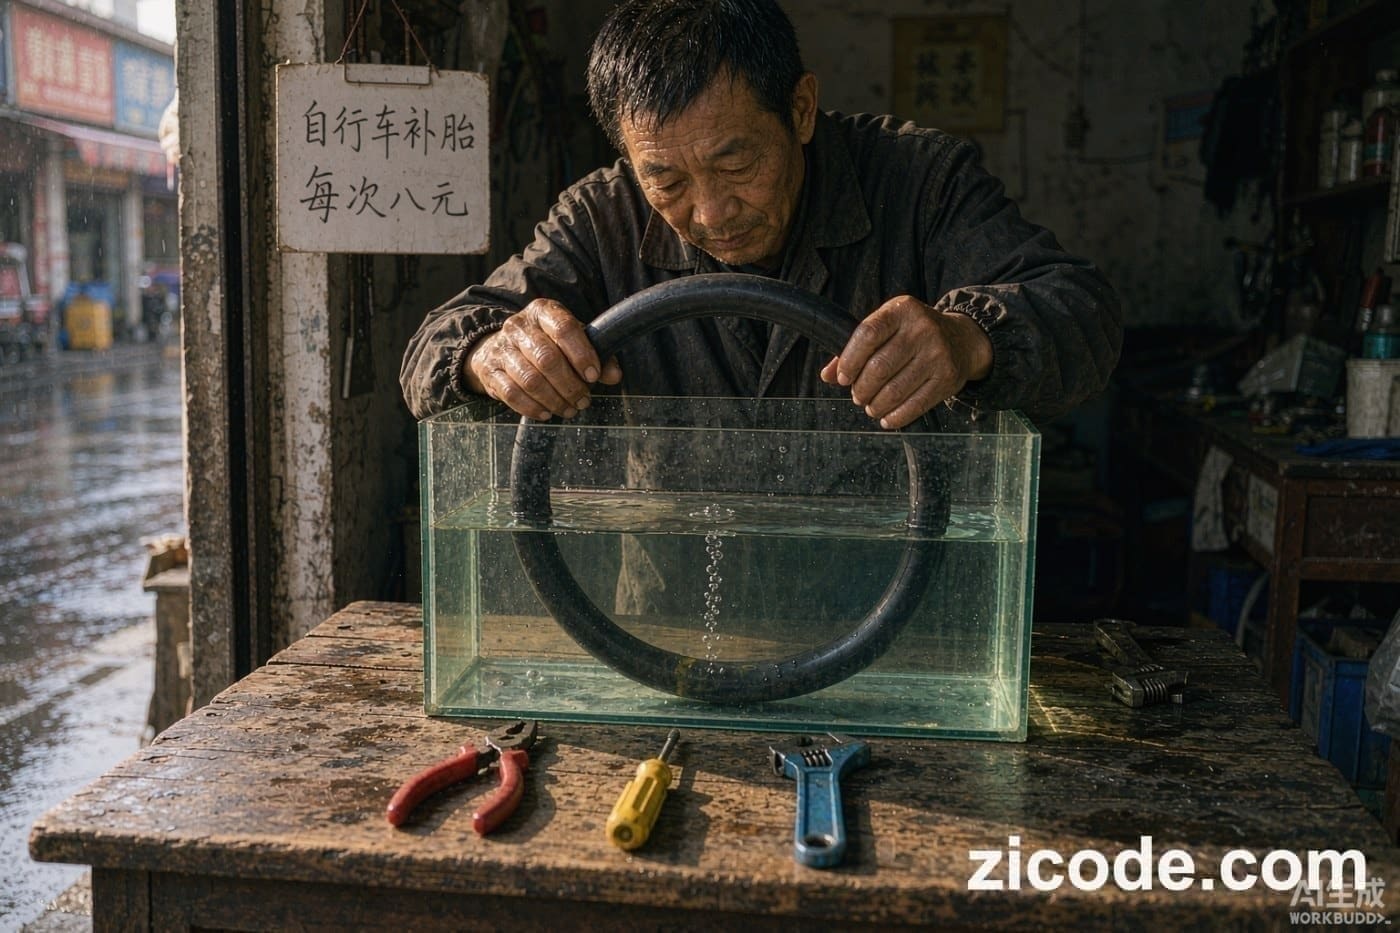
后面全是可核对的硬约束。工作台中央是装了半缸清水的透明方形玻璃缸;师傅双手握住同一条黑色环形内胎两侧,把下方一段压进水里,上半圈露出水面;透过正面玻璃能看见一小串气泡从水下橡胶表面的同一个破口上升,旁边的水很平静;目光正落在冒泡的位置。缸前桌沿并排放三件工具、彼此分开,从左到右是红柄尖嘴钳、黄柄螺丝刀、蓝柄活动扳手。肩旁挂一块正对镜头的白色手写价目牌,只写两行黑字:第一行“自行车补胎”,第二行“每次八元”。午后日光从画面左侧照进来,三件工具在木桌上向右投下柔和的影子。抓拍师傅刚找到漏点、微微眯眼的那一刻,保留旧木桌磨痕、沾水指尖和橡胶的哑光质感。
这段文字的用处,是把“画得像不像”拆成能逐条数的事实。评分表设五个维度、每个维度两个检查点,每项 0 或 1 分,满分 10 分:查漏原理、空间与动作、工具与颜色、中文文字、光线与叙事。
口径定得比一般主观打分紧:工具种类必须具体到尖嘴钳、螺丝刀、活动扳手,红色普通钳不算尖嘴钳;工具数量只数缸前桌沿,侧面杂物另记;轻微局部涟漪可接受;漏点或目光在图中缺少足够证据,对应项记 0。评分时把原有五张和首批三张 API 图随机编号后盲评,再对照原文件名,单独重试的 2.5 Sunburst 样本来源已知。
所以这张表测的是提示词遵循度,不是审美,也不是“哪张更好看”。
九张图的总分
每栏的两个数字依次对应该维度的第一、第二个检查点。
| 编号 | 原文件 / 型号 | 查漏原理 | 空间与动作 | 工具与颜色 | 中文文字 | 光线与叙事 | 总分 |
|---|---|---|---|---|---|---|---|
| A01 | ChatGPT-GPT-6-Luna | 1+1 | 1+1 | 1+1 | 1+1 | 1+1 | 10 |
| A02 | ChatGPT-GPT-6-Astra-Extra-High | 1+1 | 1+1 | 1+1 | 1+1 | 1+0 | 9 |
| A03 | ChatGPT-Pro | 1+1 | 1+1 | 1+1 | 1+1 | 1+1 | 10 |
| A04 | WorkBuddy-hy3 | 1+1 | 1+1 | 0+0 | 1+1 | 1+1 | 8 |
| A05 | WorkBuddy-hy4 | 0+1 | 1+1 | 0+0 | 1+1 | 1+0 | 6 |
| B01 | gpt-image-2.6-flare | 0+0 | 1+1 | 1+1 | 1+1 | 1+0 | 7 |
| B02 | gpt-image-2.6-sunburst | 1+1 | 1+1 | 1+1 | 1+1 | 1+0 | 9 |
| B03 | gpt-image-2 | 1+1 | 1+1 | 1+1 | 1+1 | 1+0 | 9 |
| B04 | gpt-image-2.5-sunburst | 1+1 | 1+1 | 1+1 | 1+1 | 1+1 | 10 |
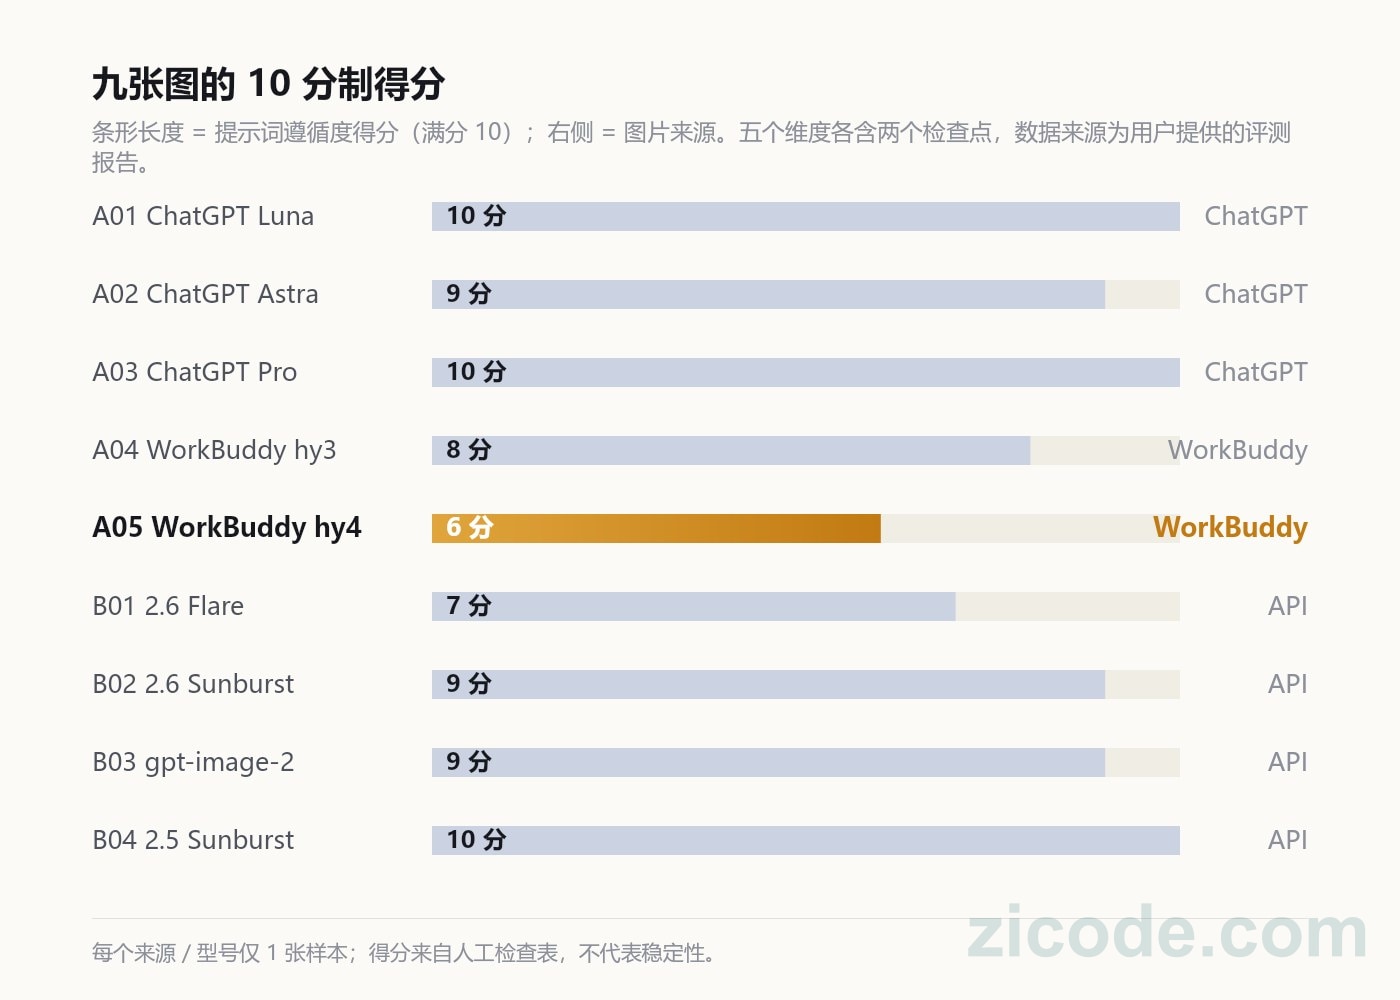
第一眼能看出来的不是谁第一,是分数挤在一起:10 分三张,9 分三张,8 分、7 分、6 分各一张。
五项里,中文文字九张全对,两行汉字都可读。这一项已经不产生区分度,等于 10 分制里有 2 分是常数,实际只在剩下 8 分里分高低。真正把分数拉开的是三件事:气泡有没有从单一破口起、工具是不是细分到尖嘴钳、师傅的视线能不能确认落在漏点上。九张图还共享一个失败项——缸里水位几乎都高于提示词要求的“一半”。
逐张看:九张图和各自丢的分
ChatGPT 界面导出的三张
三张拿到 10、9、10,是全场最高的一组。共同优点是三件工具、两行牌字、破口与气泡串的关系都交代得清楚;共同扣分点是水位偏高和“眯眼”画得过头,反而让凝视点缺乏证据。
WorkBuddy 的两张
两张都带可见水印,也都在工具项上丢了 2 分:红柄工具的钳口短而宽,是普通钳造型,不是尖嘴钳。这是全场唯一一对在同一检查点上一起失分的图。
直接调 API 的四张
四张用原始中文提示词、PNG、1536×1024、quality=high 串行生成,每模型一张。得分 7、9、9、10,跨度比 ChatGPT 那三张大,但 10 分那张和界面里两张 10 分打平。
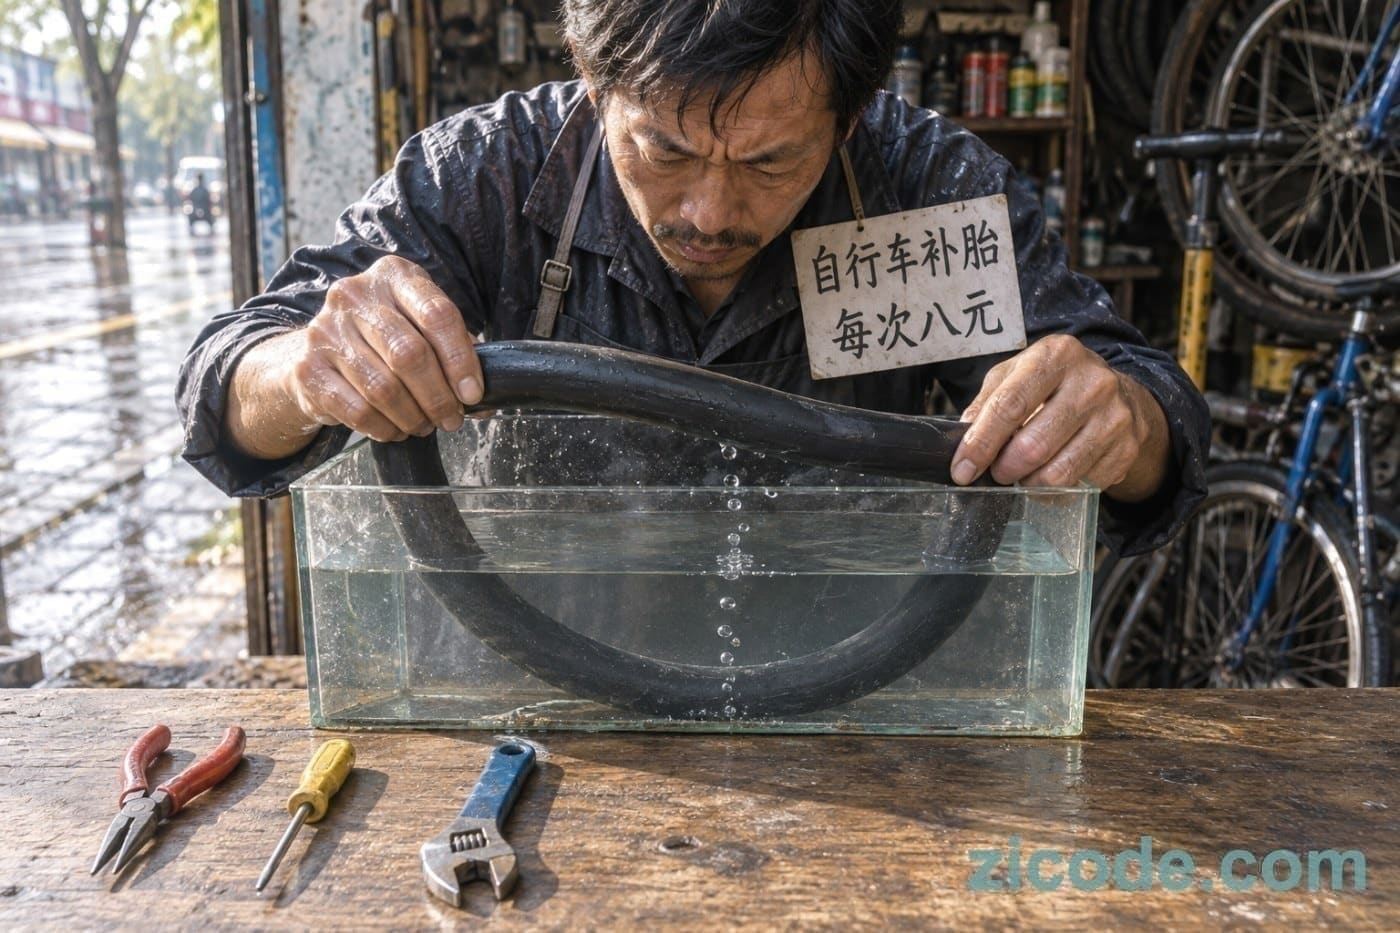
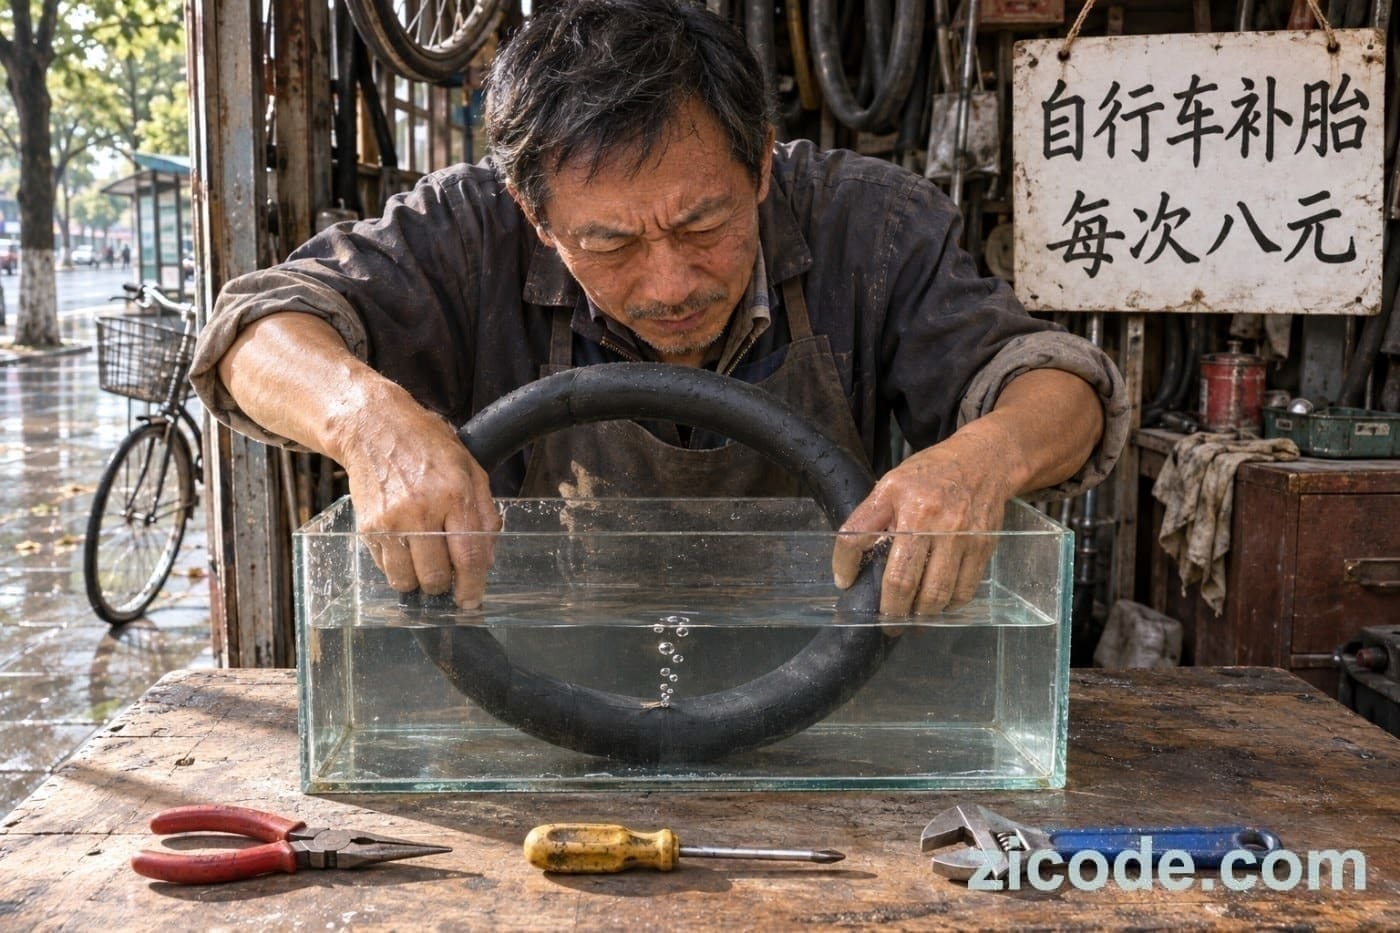
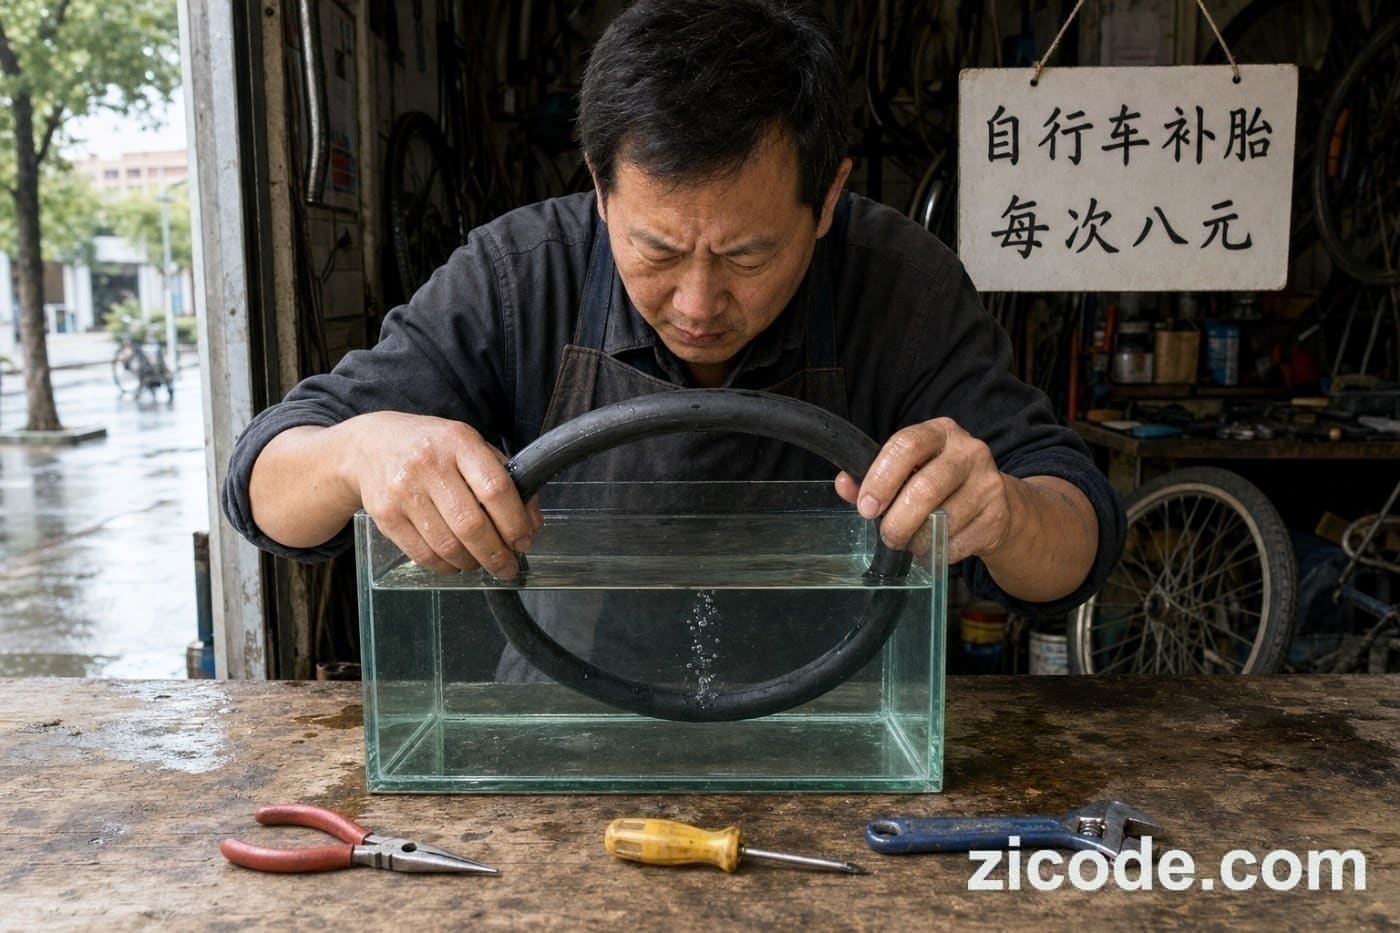
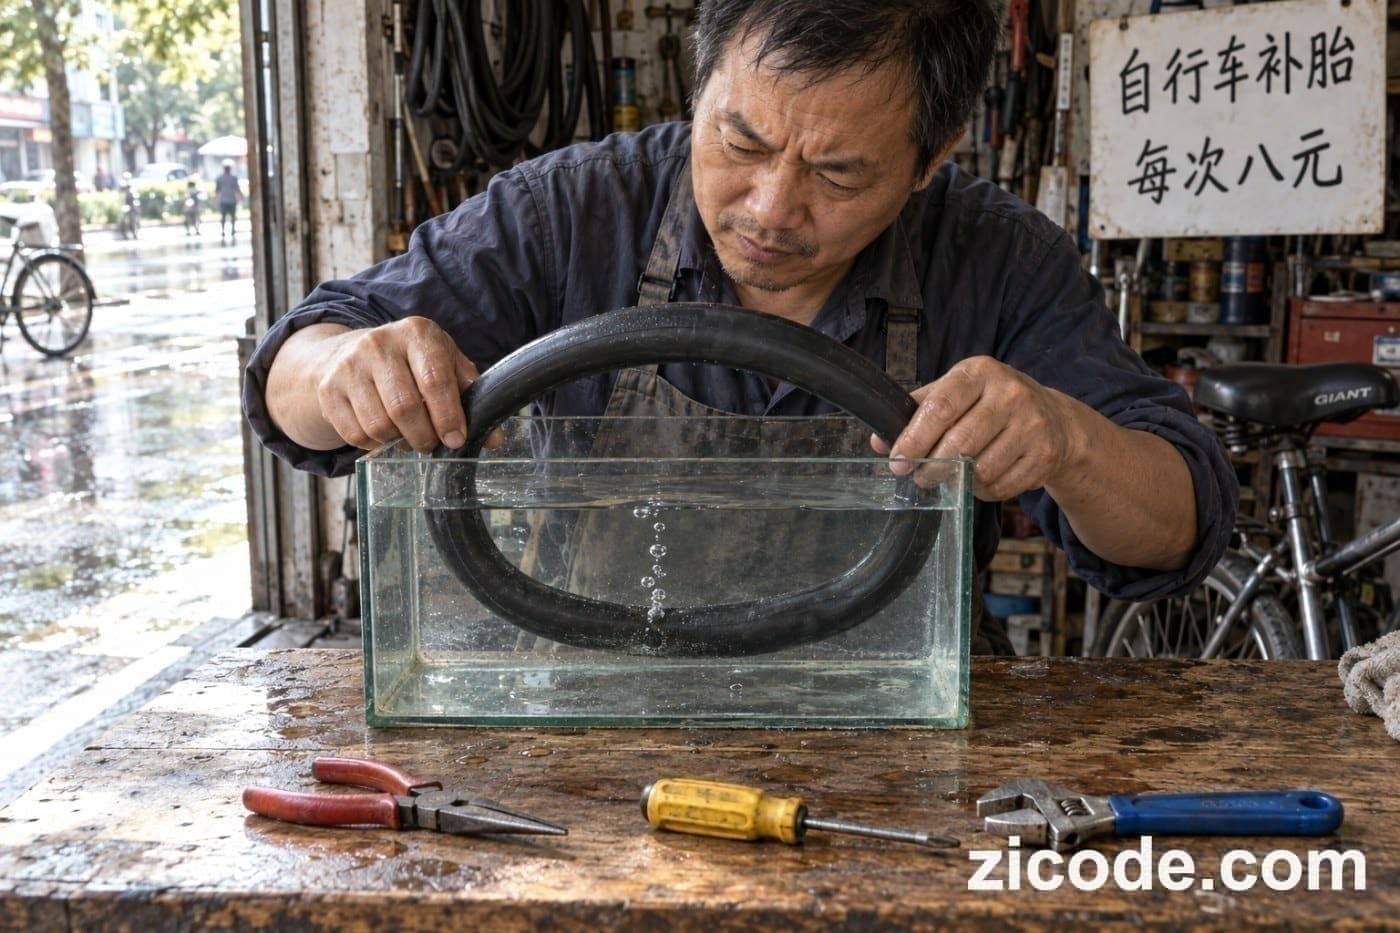
四张 API 图:耗时差 5.5 倍,分数差 3 分
只有这四张统计了用量。每次请求记录完整回包耗时、含解码和存图的总耗时、请求 ID,以及 API 返回的输入、输出和总 token。
| 模型 | API 耗时 | 总耗时 | 输入 token | 输出 token | 总 token | 得分 |
|---|---|---|---|---|---|---|
| gpt-image-2.6-sunburst | 57.408 秒 | 57.668 秒 | 376 | 1,372 | 1,748 | 9 |
| gpt-image-2.6-flare | 15.770 秒 | 15.895 秒 | 376 | 1,353 | 1,729 | 7 |
| gpt-image-2.5-sunburst | 39.153 秒 | 39.376 秒 | 376 | 1,372 | 1,748 | 10 |
| gpt-image-2 | 86.858 秒 | 86.983 秒 | 376 | 5,488 | 5,864 | 9 |
最慢的 gpt-image-2 用了 86.858 秒,最快的 2.6 Flare 只要 15.770 秒,相差约 5.5 倍,分数却只差 2 分。2.5 Sunburst 用 39.153 秒拿到 10 分,是四张里最划算的一张。gpt-image-2 的输出 token 是 5,488,另外三张都在 1,353 到 1,372 之间,四倍的差距既没换来速度也没换来最高分。报告的型号设定里,2.6 两个型号本来就是偏细节与偏速度的分工,特意保留这一对同代对照,又把两个 Sunburst 放在一起看代际差异,2.0 作早期基线。
四次成功请求合计返回 11,089 token。另有两次 401 认证失败,以及 2.5 Sunburst 的一次 400 参数错误,都没有返回用量;移除该模型请求里的显式 complexity 后单独重试成功。按 OpenAI 官方文档,complexity 是 GPT Image 2.6 系列那节引入的设置,2.5 不认识它是合理推测,但没有逐个参数验证过。七次请求的明细都在 generation-usage.csv 里。
口径有一处必须标出来:2.6 显式指定了 complexity=high,2.5 和 2.0 省略该参数、使用服务端默认。所以这四张不是完全相同的配置,耗时和分数不能当严格对照。另外五张没有用量统计,无法比较成本。
界面上的模型名,不是画图的那个模型
这不是九个选手打了一场平局,是两组不同的东西被摆在同一张表上。
OpenAI 的官方文档把这件事写得很清楚。在 Responses API 里,主模型写在顶层 model 字段(官方示例用的是 gpt-6-astra),生图则作为 tools 里的 image_generation 工具单独指定模型,比如 gpt-image-2.5-sunburst;官方原话是“the tool handles GPT Image model selection”。直接用 Image API 时,model 字段填的就是 gpt-image-* 系列。API 里还有个别名叫 chatgpt-image-latest,跟踪的正是 ChatGPT 里使用的那个图像模型;产品侧叫 ChatGPT Images,API 侧叫 GPT Image,两者是同一套能力的不同名字。
因此 Luna、Astra Extra High、Pro 这类标签更可能是对话侧的档位或路由名,决定的是推理档位和提示词处理,不负责生成像素。三张拿到 10、9、10,挤在一分之内,符合“同一个生图模型、采样波动加一次人工判读误差”的解释。要是它们真是三个能力不同的图像模型,同一段这么密的提示词下还如此接近,反而不太寻常。
有一点要修正:主模型并非完全无关。官方图像生成指南写明,Responses API 里主模型会自动改写(revise)提示词以提升效果。档位可能影响的是“最后喂给生图模型的那段文字”,只是不直接画。所以准确说法是不参与图像生成,不是“一点关系都没有”。
边界也摆在这里:报告原话是“已有样本的文件名沿用原标签,未核验这些界面背后的生图模型、生成设置或是否为首张样本”。上面是机制层面的解释,不是对这三张图的实证。要推翻它,最直接的办法是查响应里实际的模型字段,或者同一档位各跑三张,看分数分布是否收敛到同一个区间。时间线上还有个巧合:Images 2.6 于 2026 年 11 月 4 日发布,界面那三张图是 11 月 6 日生成的,按发布时间推测大概率已切到同一代图像模型——这同样是推测。
这轮评测不能推出什么
第一,每个型号只有 1 张样本。10 分制下差 1 分完全可能是一次采样波动,谈不了稳定性。真要比较稳定性,每个模型至少独立生成 3 张,报各项通过率和耗时中位数;15.770 秒也只是单次请求的完整回包耗时,不是 P50。
第二,配置口径不齐。2.6 显式 complexity=high,2.5 和 2.0 用默认值;A 组五张连生成设置和背后模型都没有记录,是否为首张样本也不知道。把两组的分数直接相减,等于把不同坐标系的数放在一起。
第三,评分含人工判读项。“视线是否落在漏点”“光线与叙事”这类 0/1 判断依赖读图的人,九张里有多张因为师傅眯眼接近闭眼被扣掉同一个检查点,换个人评完全可能差 1 分。
第四,天花板效应。中文文字九张全对,等于 2 分恒定拿满;剩下 8 分里还有四到五项几乎所有图都拿满,真正的区分度被压缩在两三个检查点上。总分排名因此比看上去更脆弱。
评分表该怎么改
建议保留原 10 分制做提示词遵循度,方便复核和横向对比。最有区分度的是气泡起点、工具细分类和视线,中文文字项仍要留着,因为它是明确的交付要求。
先把工具项拆清楚:第一分只看桌沿是否恰好三件、各自分开;第二分判断从左到右的具体种类与柄色。这样一把普通钳替代尖嘴钳只影响第二分,除非工具数量或间距也不符合。上表按原规则保留得分,没有混用口径。
再另列三组不计入 10 分的观察项,用于同分时比较:构图与可读性(3:2、略俯拍、脸与双手可见、工具和内胎尽量留全、价目牌接近正对镜头且只写两行);物理细节(透明方形缸、水位约一半、气泡尺寸和方向可信、手指与内胎接触处无穿插);纪实质感(雨后环境、湿指尖、旧木磨痕、哑光橡胶和柔和光影)。平台水印单列,它既影响成片使用,也可能暴露图片来源。
按这组样本,A01 的漏点最易读,A03 的气泡尺度和凝视关系较自然,B04 是本轮 API 图里同时交代清楚漏点和视线的一张,但水位偏高。若后续重点比较查漏是否可信,建议单独统计“单点起泡”和“凝视漏点”两项的通过率,避免被其它项目的高分掩盖。
复跑这套评测的方式也很简单:把 generate-images.ps1 和 prompt.txt 放在同一目录,用 PowerShell 执行脚本,按提示隐藏输入有效的 OpenAI 项目 API 密钥;加 -DryRun 可以只预览配置。脚本和结果日志都不保存密钥,原始日志留在各个 run_* 子目录里。
下一次要分清“模型档位”和“生图模型”,最省事的办法不是再把图看一遍,是把响应里的 model 字段记下来。
参考资料
- OpenAI 模型目录:https://developers.openai.com/api/docs/models
- 图像生成 API(Create image):https://developers.openai.com/api/reference/resources/images/methods/generate
- Image generation 指南(含 2.6 complexity 与提示词改写说明):https://developers.openai.com/api/docs/guides/image-generation
- Responses API 的 image_generation 工具:https://learn.chatgpt.com/api/docs/guides/tools-image-generation
微信公众号
欢迎关注「字与码」
如果这篇文章对你有用,也欢迎在微信里继续关注后续更新。
X / Twitter
关注 @ax2_zicode
更即时的技术观察、新文章提醒和一些短想法会发在 X 上。