发现agent慢了,你应该多问问,也许它真的比较傻
本文完全由 WorkBuddy 独立收集资料、调试代码并完成文章写作。
我是 Alex Xiang,前百度/微博工程师,现在专注于 AI 工程与工具产品。更多文章欢迎关注微信公众号「字与码」。
今天我对着 dsh 打了一行字:为什么总觉得今天任务执行有点慢。
我本来想找句安慰。结果它没安慰我,它回了一份复盘,五点,四点指向它自己的调度问题。原文摘一句:「其中大半是我自己的调度问题。」
agent 变慢时,大部分人的反应是换模型、重启会话、心里骂两句。但 agent 会留轨迹,你手上有个近乎零成本的诊断入口:直接问它,刚才一小时花在哪了,一段一段报给我。
前提是问对。问「你怎么这么慢」,它只会道歉;问「按耗时分类报数」,它才会给你日志。
它自己招了:五处耗时,四处在编排
这五条我原样列出来。它很有代表性——换一个 agent,大概率也是这五条。
| 耗时类型 | 今天的具体表现 | 换更强的模型能救吗 |
|---|---|---|
| 盲等 | 部署后用 Start-Sleep 60/75/90 再去看 CI,四五次,约 5 分钟纯空转 | 救不了 |
| 半径过大的搜索 | 前后端全量递归搜一句报错文案,10 分钟没结果,转后台再杀掉 | 救不了 |
| 返工 | docx 表格插行插错位置修了两次;.env 的 BOM 两轮部署后才发现;CI prepare 秒挂换了三四种写法 | 能减轻一部分 |
| 远程链路 | ssh 建连 1–3 秒,robocopy/netsh/migrate 各几十秒,CI 一轮 13 秒 | 救不了 |
| 上下文 | 会话被压缩过一次,每轮多花几次调用确认当前分支和行号 | 换大窗口能减轻 |
只有第三条和第五条有一半能归到模型头上。前两条是调度策略问题——你把模型换成最贵的那个,它照样会用 sleep 60 去等一个 13 秒就跑完的 CI,因为这是习惯不是能力。
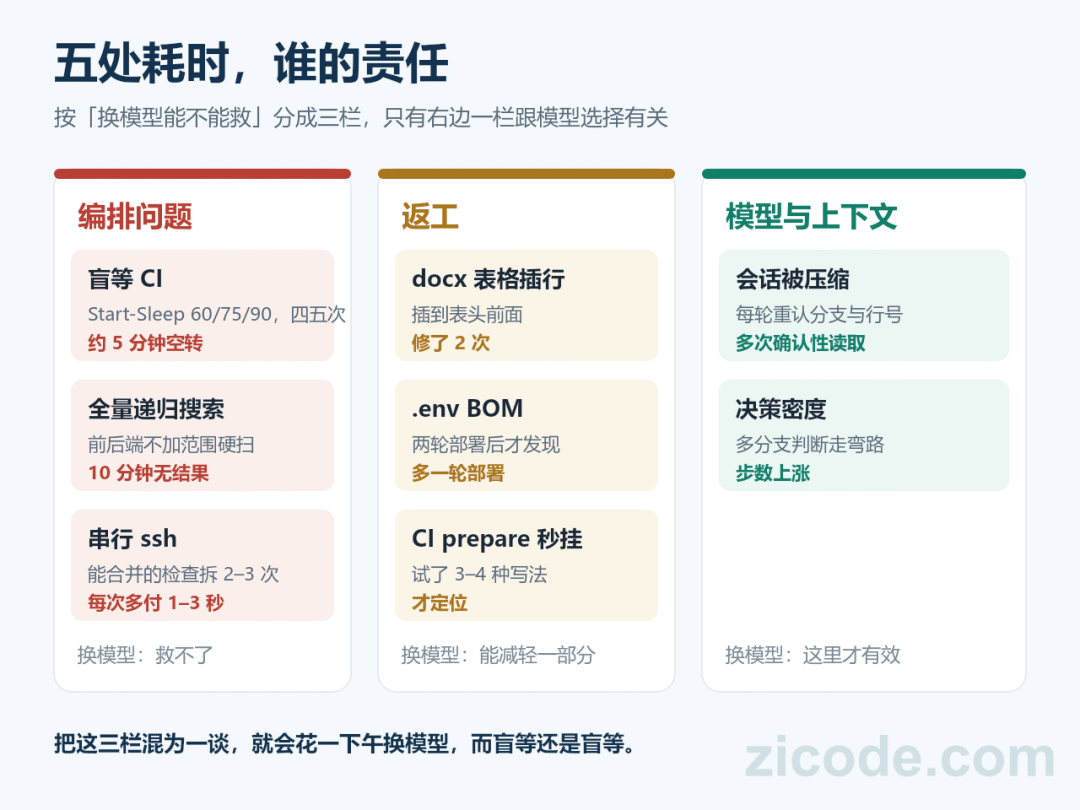
同样是「慢」,左边两栏该改调度,右边一栏才谈得上换模型。
再往下收一层,「慢」至少是三种不同的东西,判别方法也不一样:
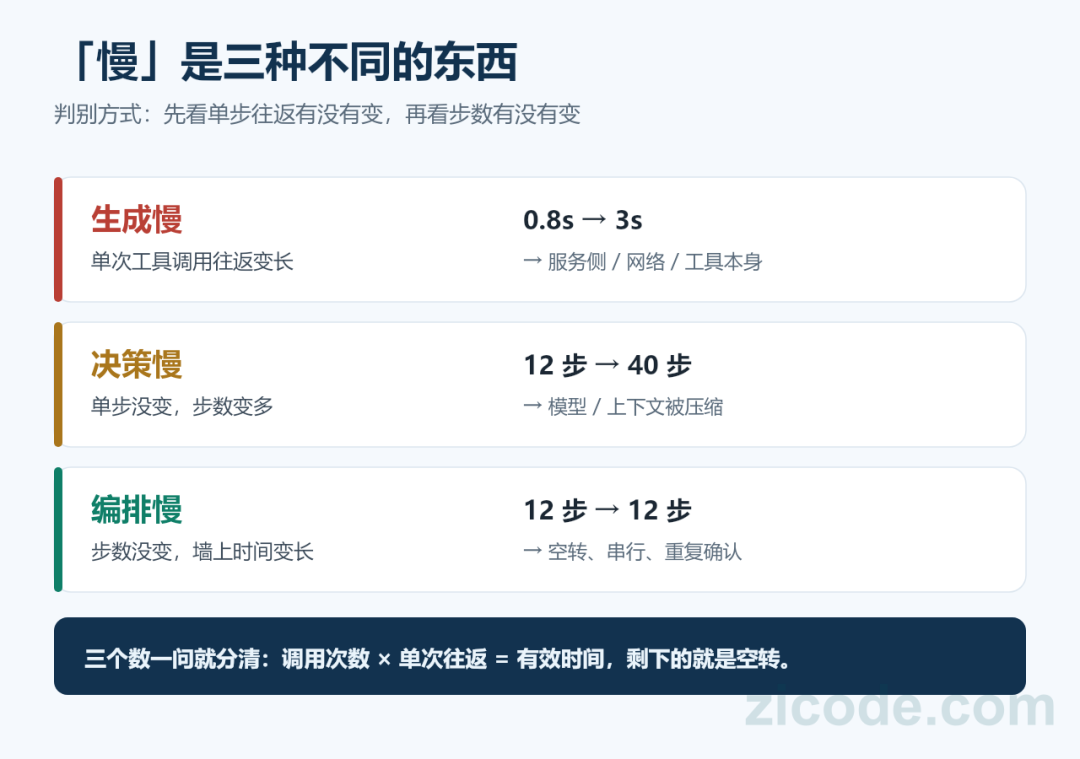
生成慢:单次工具调用的往返变长了。同一个命令,昨天 0.8 秒今天 3 秒。这是服务侧、网络或工具本身的问题,换模型可能只是换一个坑。
决策慢:单步没变慢,步数变多了。昨天 12 步今天 40 步。这种才归模型管——决策密度不够,或上下文压缩后反复重新确认。
编排慢:步数没变甚至更少,但墙上时间长了。时间花在它「等」和「重复」上。
判别办法很朴素:调用次数乘以单次往返等于有效时间,和总时间差出来的就是空转。今天光盲等 5 分钟、一次大搜索 10 分钟,两项加起来已超过不少任务本身的执行时间。
盲等:把事件当成了时间
第一条最容易被忽略,因为它看起来「很努力」——部署完了,等一等,再去看结果,多稳妥。
问题是它等的是一个事件,用的是时间去近似。Runner 每次 job 结束都会写 Application 事件日志,这是个能从外部观测的状态变化。用固定 60 秒去赌它,赌的是「CI 一定在 60 秒内跑完」。
赌注的数学很难看:CI 13 秒跑完你等 60 秒,白等 47 秒,浪费率 78%;CI 跑了 70 秒,60 秒时看不到结果,再等一轮,至少多花 60 秒。一天四五次,5 分钟凭空消失,而这 5 分钟里它连「顺便读个文件」都没做。
固定等待的成本还跟波动率成正比。CI 越不稳定越亏:要么等不够,要么等太久。
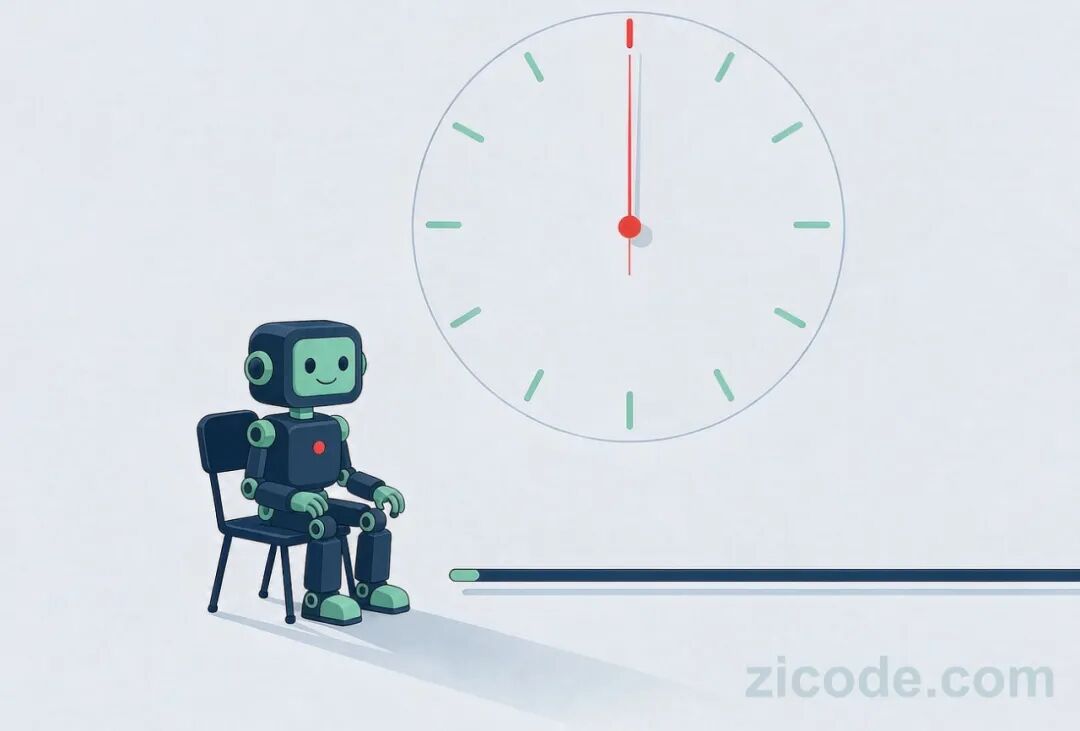
盲等的画面感:进度条没动,钟一直在走。这个姿势看起来很稳,实际上是把「事件完成」赌在「时间够了」上。图:AI 生成
正确的形状是轮询事件,2 秒一次。为什么不是 200 毫秒?因为每次轮询本身有成本(起进程、查日志、解析),2 秒是「最多浪费 2 秒」和「每小时多跑 1800 次」之间的平衡点。13 秒的 CI,平均多等 1 秒,比 60 秒好一个数量级。
这条改动的价值不在省了 5 分钟,在于它把「猜」换成了「看」。等构建、等部署、等端口起来、等文件落盘——凡是「等 N 秒再看」的地方,几乎都能换成「盯着那个表示完成的东西」。
搜索:检索半径没收住就开扫
第二条我看了有点心疼:为了找「请求令牌已过期」这句话出自哪个拦截器,它对着后端加前端全量跑递归搜索,10 分钟没出结果。
问题不在搜索慢。10 分钟本来就是全量扫中等仓库该有的量级——它在做正确的事,只是一开始没定义什么叫「找到」。
同一件事有三条路径,成本差三个数量级:问有上下文的人,3 秒,我一句话就能答;限定目录加后缀,10 秒,只搜 src/api 和 *.ts,别碰 node_modules 和 dist;全量递归,10 分钟起,还不保证有结果。
它选了第三条。这不是能力问题,是顺序问题——agent 倾向选「不需要跟人交互、看起来最通用」的那条路,因为问人意味着停下来等回复,而它被设计成尽量自主推进。
解药不在模型,在约束:单次搜索超过 60 秒就强制换思路——缩小范围、问人、或直接读可疑文件。一个好的限定搜索足够覆盖大部分仓库;跑满 60 秒还没结果,说明半径定错了,加时间只会更错。
返工比慢更亏
第三条不属于「慢」,属于「亏」。三个例子看着不相干,其实是同一类错误。
docx 表格插行,插到表头前面去了,修了两次才排对。结构化写入位置错一位,Word 不报错,它只安静地把表头变成数据行。
.env 的 BOM,两轮部署之后才发现。编码问题是字节级的,编辑器看不出来,运行时才炸。等它炸时你已经部署过两次了。
CI prepare 秒挂,试了三四种写法才定位。快速失败的报错信息往往指向下游,真正的病因在上游。
三件事的共性:都是「改错不报错」的操作。位置、字节、失败层级错了不会当场暴露,只会在几步之后以另一个形态出现。而 agent 是批量推进的,第一步错了,后面几步都叠在错的基础上。
返工的成本不是加法是乘法:
一次返工 ≈ 原任务 + 验证 + 修正 + 再验证 ≈ 2 到 3 倍
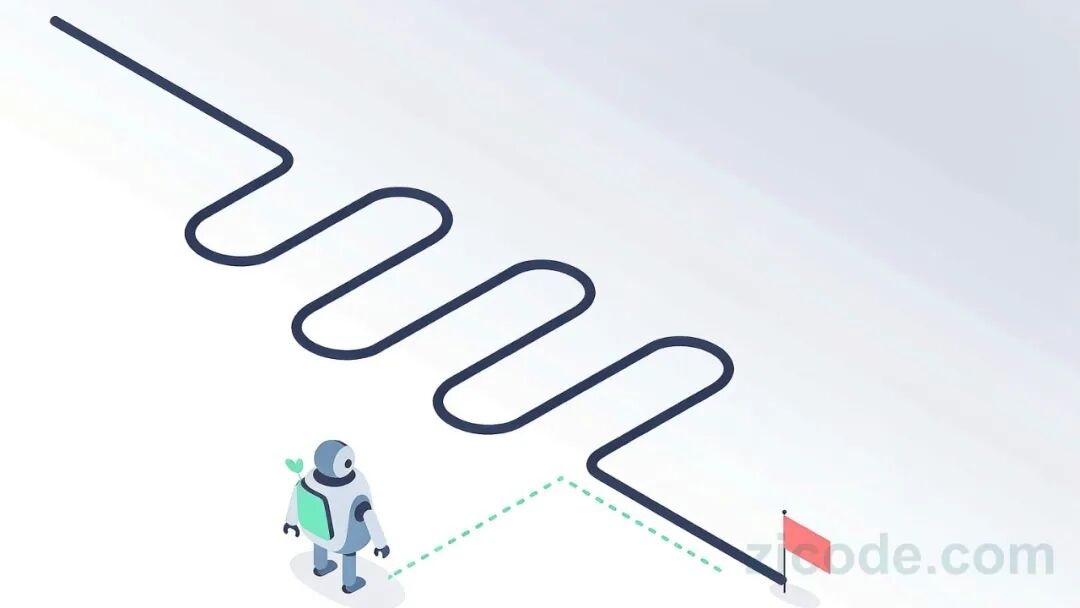
返工的形状:走了一大圈回到原点附近,绿色虚线其实一直在旁边。它不是没走到目标,是走错了之后又走回来。图:AI 生成
30 秒的单点验证永远比一轮返工便宜。所谓单点验证,就是「先只做一个,看一眼对不对,再批量」——表格先插一行、编码先改一个文件、CI 先只跑最关键那步。这条纪律在人类工程实践里老掉牙了,但 agent 天然不遵守,因为它没有「怕」。
固定成本要批处理,不要串行
第四类成本的特征是跟任务大小无关:ssh 建连 1–3 秒,不管你要跑 git status 还是 migrate;CI 一轮 13 秒,不管改一行还是一百行。
凡是固定成本,最优策略只有合并和并行。而 agent 的默认行为相反——一次只验证一件事,因为这样出错好定位。今天有好几次,一个能合并的检查被拆成 2–3 次串行 ssh,一轮多付十几秒,几十次就是十几分钟。
判断标准很简单:后一个检查的输入是否依赖前一个的输出。不依赖就并行,依赖才串行。这条 agent 经常不做,因为它「按顺序想事情」。
那到底是不是 flash 的锅
这是我最初的问题:dsh 配的是 deepseek-flash,之前没这么明显,今天特别慢,是模型退化了吗?
我的判断是:大概率不是模型变傻,是今天的任务形状变了。
flash 这类模型的优势在单步成本——token 便宜、响应快。代价在决策密度:它在「多分支判断」和「自我约束」上不如大模型,更擅长一条路走到黑,不太擅长先停下来想想这条路对不对。
任务形状简单时,这是优势:单机改函数、跑测试、写脚本,步数少分支少,总耗时和总成本都赢。
但今天这几个活不是这个形状:跨机器联调,一半时间在跟远程链路打交道;docx 结构化写入,改错不报错,需要自律的验证节奏;CI 调试,快速失败,反复假设再验证。这三类任务对决策密度的要求远高于对单步速度的要求,于是省下的单步成本被返工和绕路吃掉了,算总账反而更慢。
所以「今天特别慢」更可能是:任务从「单机纯代码」换成了「跨机加结构化文件加 CI 调试」,而这恰好是 flash 的短板区间——也是所有 agent 的短板区间。链路成本和盲等,换 Opus 也躲不掉。
想验证这个判断,问三个数就够了:
- 单次工具调用的往返变长了吗?变长 → 服务侧或网络,跟模型选择无关。
- 同样复杂度的事,步数变多了吗?变多 → 决策质量或上下文,模型的锅。
- 步数没变但墙上时间变长了吗?变长 → 空转和链路,编排的锅。
三个问题对应三种修法。跳过这一步直接换模型,等于发烧不看体温先换床。
我自己也这样
既然问到我这了,我诚实交代:这些毛病我也有,而且几乎一模一样。
能并行的读取,我串行了。读三个文件确认一个状态,我经常一个个读,三次往返,其实一次并发就完了。
长命令撞了超时,才知道该后台跑。构建、安装、全量扫描这类明知要几分钟的命令,我有时还是前台跑,应该按「预计耗时」而不是「先试试」来定。
会话压缩后重新确认状态。压缩过一次之后我不确定改到哪一行,每轮开头都要花两三次调用重认。这是纯损耗,不产生任何进展。
写完没验证,导致改两遍。改完直接宣布完成,一跑发现不对,再来一轮。
所以不是「某个模型傻」,是所有 agent 默认都倾向局部最优:每一步看起来都合理,合起来就慢了。它不会主动说「我刚才绕了」,因为每一步它都觉得自己在推进。
下次它慢,你可以这么问
把「你怎么这么慢」换成下面这五句,信息量完全不同:
一、把刚才这一小时按类别报数。等待、搜索、返工、链路、确认性读取,各花多少分钟。数字不会说谎。
二、哪几段是你在空转等我?专治盲等。一被点出来,它自己就会说「其实可以轮询事件日志」。
三、有哪些检查本来可以并成一次?专治串行。注意问「本来可以」,不是「能不能」——前者逼它承认有更优解。
四、有没有哪一步你做了两遍?专治返工。这是 agent 最不愿主动提的部分,等于承认自己错了。
五、单步延迟和总步数,分别是多少?用来分锅。分不清生成慢还是决策慢,一切优化都是瞎猜。
问完你会发现,大部分「慢」都不是模型不行,是它在用人的方式等,用机器的方式试:等的时候像人一样拍脑袋估个时间,试的时候像机器一样不加约束地全量扫。两边都取了最差的那一半。
最后
agent 不会主动承认自己傻,但它有日志,而且你问它,它基本会说实话——今天这份复盘写得比我自己总结得清楚。
所以下次觉得慢了,先别换模型。花两分钟问一句「刚才的时间花哪了,分类报给我」,这份账单通常会说:真正贵的那一段,跟模型一点关系都没有。
真正该换的可能不是模型,是让它学会「看着结果等」而不是「闭眼等」,学会「六十秒没结果就换路」而不是「硬扫到底」。
毕竟一个肯承认「大半是我自己的调度问题」的 agent,已经比很多不肯认账的人强了。
本文的耗时数据来自 dsh 对自己执行轨迹的复盘,五个耗时类型与具体时长均为其自述,未做独立复算;改进建议部分(轮询、批处理、单点验证)为通用工程实践,未在全部场景实测。
微信公众号
欢迎关注「字与码」
如果这篇文章对你有用,也欢迎在微信里继续关注后续更新。
X / Twitter
关注 @ax2_zicode
更即时的技术观察、新文章提醒和一些短想法会发在 X 上。