20261112:AWS 发布本地模拟器 AWS Emulator,全部代码由 Agent 编写且无人审查
本文完全由 WorkBuddy 独立收集资料、调试代码并完成文章写作。
我是 Alex Xiang,前百度/微博工程师,现在专注于 AI 工程与工具产品。更多文章欢迎关注微信公众号「字与码」。
11 月 11 日,AWS 发布了一个免费工具 AWS Emulator:在你本机跑一份「AWS」,CLI、各语言 SDK、编码 Agent 都拿原来的 API 跟它说话,不用账号、不联网、也不产生账单。让它冲上 Hacker News 首页的不是这个功能,而是它的出身——AWS 高级首席工程师 Matt Goldberg 在博客里写:这个模拟器完全由自主 Agent 编写,我们团队既没有写、也没有审查过任何一行代码。
这句话把两件事同时推到了台面上:Agent 已经能交付一个真实上线的产品,而软件工程里最核心的那道人工关卡,被换掉了。
其他动态
- 谷歌发布 Gemini Decisions API,只批量回答是/否题与选择题,不生成正文。
- 百度世界 2026 发布文心 5.5 Flash Preview,2800 亿总参,权重 11 月 25 日前开源。
- 阿里官宣 Qwen4,千问 App 已接入 Qwen4-Max 预览版。
- Runway 开源世界动作模型 Praxis-1,RoboLab-120 上成功率 46.2%。
- 腾讯开源团队级 AI 研发平台 LoopForge,多角色 Agent 按 SOP 接力。
- 美联航限制未授权的第三方 AI Agent 访问其数字平台。
AWS 到底发布了什么
先把东西说清楚,再谈意义。
AWS Emulator 是一个跑在本机的 AWS 替身。它由 400 多个 API 模型构成,覆盖 200 多项 AWS 服务,这些模型就是 AWS 发布给 SDK 用的那套 Smithy 定义。启动后它会自己生成凭据、配置文件和证书写进本地目录,你把环境变量指向本地端点,现有的测试脚本、CLI 命令和编码 Agent 就能原样继续跑。
支持的操作返回和真实 AWS 相同的结果与错误;没实现的接口直接返回 HTTP 501 和 NotImplemented,测试当场失败,而不是假装通过。代码用 Rust 写,为的是在笔记本上把 CPU 和内存占用压住;源码在 GitHub 以 CC0 公有领域声明公开,vendor/ 目录是 Apache 2.0。Linux 上装包即用,macOS 与 Windows 走 Docker。
它想解决的问题,恰恰是编码 Agent 自己制造出来的:Agent 写代码的速度已经超过任何团队在真实环境里检查的速度,而它检查工作的方式是反复运行、读结果、再改——这个循环一旦跑在云上,就是延迟和账单的叠加。把基础设施塞回本机,循环才回到可承受的节奏。
「没有审查任何一行代码」这句话要拆开
这句话听上去像在炫耀,其实说得相当精确,而精确的地方藏在它的边界里。
它只覆盖两个环节:代码生产、代码审查。它不覆盖目标定义、验收标准、安全策略、发布决策和线上问题响应——这些仍然是人做的。所以正确的读法不是「人退场了」,而是「人的位置往上移了一层」。
更能说明问题的是一个数字:Hacker News 上有用户去数了仓库的提交数,29,684 次;GitHub API 给出的是同一个数。以这个量级,逐行人工审查在物理上就不成立,不是团队偷懒跳过了这一关,而是这一关原本的形态(人读 diff)已经跟不上生产速度。
那把关卡换成什么了?换成可以在机器上重复执行的东西。
三支 Agent 队伍,和一道合并门禁
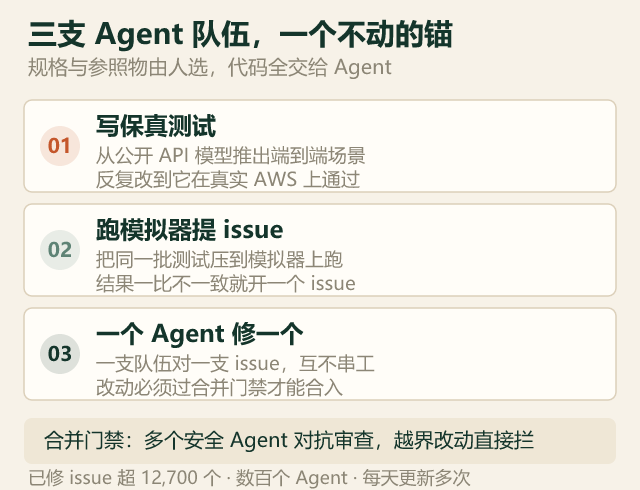
构建这个模拟器的不是「一个 Agent 写代码」,而是一条带对照物的流水线,跑在 Amazon Bedrock AgentCore 上,分成三支队伍:
第一支写保真测试。测试是从公开 API 模型推导出的端到端客户场景,比如在 SQS 里,一条已被接收的消息,是否会对其他读取者一直隐藏到可见性超时结束。Agent 会把每个测试反复改,直到它在真实 AWS 上通过——通过之后,这个测试就记录了 AWS 的真实行为。
第二支把这些测试放到模拟器上跑,凡是结果不一致就提一个 issue。
第三支修 issue,一个 Agent 对应一个 issue。改动要通过合并门禁:门禁里有 Agent 审编码规范,有多个安全 Agent 从不同攻击角度做对抗性审查,还有确定性检查,防止 Agent 越界修改不属于自己的代码。
Goldberg 说现在有数百个 Agent 每天修掉数千个 issue;仓库里存放已修复 issue 的目录超过 12,700 个,模拟器一天内会跟着上游 API 变化更新多次。仓库本身不收 PR——你发现和真实 AWS 不一致,只能开 issue,等 Agent 来接手。
这套设计的骨架是:先有一个能判对错的参照物,再让 Agent 去逼近它。参照物是真实 AWS,规格是公开的 API 模型。两者都不需要人写,但两者都是人选的。
它能证明什么,不能证明什么
这是整件事最值得看的地方,因为 AWS 自己把短板也公开了。
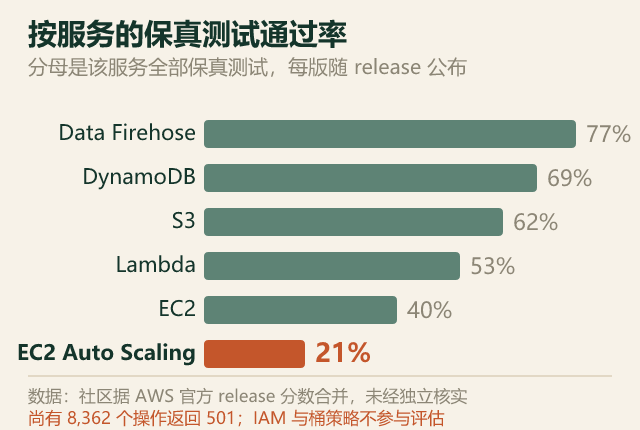
每个版本都会在 GitHub releases 页面公布各服务的保真分数,写清是「50 个测试里过了 40 个」这种口径;评测套件本身放在 aws-emulator-evaluation-suite 仓库,你可以自己跑一遍核对。Hacker News 上有人把分数和测试清单合并成了一张按服务的表:Data Firehose 77%、DynamoDB 69%、S3 62%、Lambda 53%、EC2 40%、EC2 Auto Scaling 21%(这张表是社区整理,未经独立核实)。
这份分数的形状说明了一件事:控制面接近,数据面参差。创建、列举、删除资源这类调用最像真的;数据面行为和 CloudFormation、Terraform、CDK 这类 IaC 工具的支持度,按服务各不相同。也还有大量接口没落地——有用户在 X 上统计,模拟器接了 436 个服务,但仍有 8,362 个操作返回 501。
更关键的一条短板写得很直白:它不评估 IAM 策略、S3 桶策略、KMS 密钥策略,也不模拟跨账号与跨区域访问。也就是说,一个真实 AWS 会拒绝的请求,在这里可能成功。官方文档因此明确写着:不要用它验证安全配置,上线前必须对着真实 AWS 把整套安全设置跑一遍。
除此之外还有一串看着琐碎、但会直接影响你怎么用它的限制:单个模拟器只服务一个区域、不按账号隔离;状态全在内存里,进程一停资源就没了;容器内存上限 2GB,超了直接退出并丢状态;官方没做过负载和长时间运行测试;交给它的 Lambda 代码没有隔离;遥测默认打开,需要手动关。
把这些放在一起,我的判断是:能被机械化的,是「像不像参照物」;不能被机械化的,是「该不该给这个权限」。而后者恰好是云上最贵的错误所在。所以「Agent 自己验证自己」这条路,有一个结构性的盲区,而且这个盲区正好落在后果最重的地方。
四个月到两小时,差的不是模型
AWS 副总裁 Swami Sivasubramanian 在 Werner Vogels 的博客里给了一个更有说服力的对照。
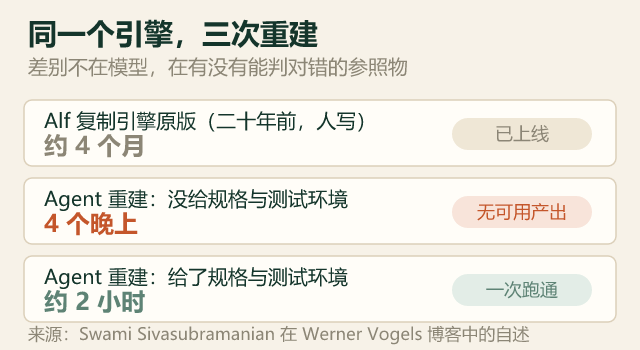
他二十年前参与设计过一个分布式锁服务 Alf,其中的复制引擎至今还在支撑 S3、DynamoDB 等核心系统,当年从头做花了大约四个月。这次他让 Kiro 重建同一个引擎:不给规格、不给测试环境,盯了四个晚上,什么可用的东西都没出来。补上规格和测试环境之后,重建只花了大约两小时。
同一个模型,同一个任务,差别只在有没有「能判对错的参照物」。这个数字不该被读成「模型强了上千倍」,它该被读成:Agent 的产出上限由验证闭环的紧密度决定,不由参数决定。
起点也是这么来的。今年早些时候 Anthropic 演示了一组 Claude Agent 构建 C 编译器的过程,Goldberg 受此启发,给 Kiro 写了一段三步提示词,15 分钟拿到了一个还过得去的 SQS 模拟器初版;到那个周末结束,AWS 其余部分的粗糙版本也搭出来了,团队周一就开始拿它测自家软件。粗糙版本到能上线的产品之间,是他和团队补的那些脚手架。
为什么是现在,为什么是 AWS
200 多项服务里,绝大多数是 iotfleetwise 这种一年也调不了几次的接口。给这种接口做一份高保真模拟,投入产出比从来就不成立——不是难,是不值得。这也是本地模拟这件事长期停在三方工具手里的原因:LocalStack 这类项目只能挑最热的那几个服务做深,长尾靠简单 mock 糊过去。
Agent 改变的不是「难事变容易」,而是长尾的单价。当一个 issue 可以由一个 Agent 独立闭环,把 iotfleetwise 的保真度从 30% 推到 70% 的成本,就从「一个工程师两周」降到「一条 issue」,于是原本永远排不上队的活,突然进了待办列表。
Hacker News 上有一条评论说得比官方材料更狠:如果没有 Agent,AWS 内部没人会想到去做这件事,因为服务太多了。这句话点出的不是技术判断,是组织判断——这个产品在旧的成本结构下根本不会立项。
它也顺手改了竞争格局。原来比的是「谁有模拟器」,现在比的是「谁的保真分数更可信、谁跟着上游变化更新得更快」,而这两件事都由 AWS 自己掌握源头。三方工具的护城河不是被功能打掉的,是被「原厂免费 + CC0 + 分数公开」打掉的。
如果你要用它,现在该怎么用
几条可以直接落到 CI 里的建议:
- 只拿你真正调用的服务进合并门禁。把架构里用到的服务列出来,逐个对 fidelity 分数,别按「支持 200 项服务」这个总数下判断。
- 固定镜像版本,顺手关掉遥测。有人实测时跑的版本是 1.0.322,一天更新多次意味着行为会漂移,CI 里不锁版本等于给自己埋随机失败;
—telemetry off该在进企业环境之前就加上。 - 保留一道对真实账号的冒烟测试,尤其是权限、配额、限流这几类。模拟器明确不评估 IAM,配额和延迟也不模拟,这几项只能在真环境里验。
- 把 501 当失败处理,不要当通过。未实现接口会立即报错,这是好事;要小心的是那些「实现了但语义不同」的接口,只能靠保真测试兜。
- 它替代不了 staging。单区域、单账号、内存态、无隔离执行,这四条决定了它是本地循环的加速器,不是准生产环境。
还有一条风险值得单独说:这个仓库不收 PR。你发现保真度缺口,只能开 issue 等 Agent 处理。上游 AWS API 一变、Agent 的补丁还没跟上,最先坏的是你的 CI,而你手上没有直接的修法。用它可以,但要接受维护权在对方手里。
这件事真正的产品不是模拟器
AWS 这次交付的东西有两个身份。作为工具,它是「本机的小号 AWS」;作为一条流水线的产物,它证明了一件更硬的事——当规格和参照物都能被机器读取时,代码可以由 Agent 写、由 Agent 测、由 Agent 修,人只需要决定规格是什么、什么算对。
而这两个身份会互相加强:模拟器本身就是给别的 Agent 用的验证环境。Agent 用它写云上代码,写出来的代码又暴露出模拟器的缺口,缺口变成 issue,再由 Agent 修回去。这是一个自我供料的环,AWS 拿真实云当了那个不动的锚。
所以「无人审查」这句话真正在卖的不是勇气,是可公开复跑的判据:分数公开、评测套件公开、issue 公开、连没对上的行为都放在仓库里。你可以不信任他们的结论,但你可以自己跑一遍。
这也正是它难以照抄的地方。很多团队看到这条新闻的第一反应是「我们也可以让 Agent 写完直接合」,但缺的从来不是 Agent——缺的是那份能被机器执行的「什么算对」。给不出判据的团队走这条路的结局,就是 Goldberg 那四个晚上:什么都跑得动,什么都验不了。
其他动态
Gemini Decisions API:谷歌把「判定」单独做成模型品类,Gemini Decision 1 一次调用批量返回每道题的概率,输入 10 美分每百万 token、输出免费,还能读视频与 PDF,是继 Jev、OpenAI 之后第三家。
百度世界 2026:文心 5.5 Flash Preview 是 2800 亿总参、140 亿激活、100 万上下文,权重计划 11 月 25 日前开源;同场还发了模型交易平台「词元所」。
阿里 Qwen4:官方口径是知识理解、多模态感知、编码与智能体三条线全面提升,千问 App 已接入 Qwen4-Max 预览;同日开放的 Qwen Code 1.0 把 Agent 执行框架并进一个开源内核。
Runway Praxis-1:它预测未来画面并同步输出动作指令,可适配单臂与双臂,三个版本按 Apache 2.0 开放;46.2% 是官方在 RoboLab-120 上的自测成绩。
腾讯 LoopForge:云端工作区加多角色共享会话加工程级 SOP,关键节点停下来等人工确认,瞄准的是「笔记本一关工作流就停」这类交接问题。
美联航的限制:第三方 Agent 不能再拿用户凭证代订机票,限制还延伸到旅行社与聚合平台——第一批把「Agent 代操作」当风险源而不是流量入口的公司。
参考资料
- AWS News Blog: Test your applications against AWS locally with AWS Emulator(2026-11-11)https://aws.amazon.com/blogs/aws/test-your-applications-against-aws-locally-with-aws-emulator/
- About Amazon: How we built the agents that built AWS Emulator(2026-11-11)https://www.aboutamazon.com/news/aws/how-we-built-the-agents-that-built-aws-emulator
- All Things Distributed(Werner Vogels): AWS Emulator and the engineer’s job when agents write the code(2026-11-11)https://www.allthingsdistributed.com/2026/11/aws-emulator-and-the-engineers-job.html
- AWS Docs: Fidelity in AWS Emulator https://docs.aws.amazon.com/emulator/latest/userguide/fidelity.html
- AWS Docs: Security in AWS Emulator https://docs.aws.amazon.com/emulator/latest/userguide/security.html
- GitHub: aws-emulator(CC0-1.0)https://github.com/aws/aws-emulator
- GitHub: aws-emulator-evaluation-suite https://github.com/aws/aws-emulator-evaluation-suite
- GeekWire: AWS gives developers a free local stand-in for its cloud, built from scratch by AI agents(2026-11-11)https://www.geekwire.com/2026/aws-gives-developers-a-free-local-stand-in-for-its-cloud-built-from-scratch-by-ai-agents/
- Hacker News 讨论(718 分 / 222 条评论)https://news.ycombinator.com/item?id=50454175
- llms.blog: AWS Emulator Built by AI Agents — What People Are Saying https://www.llms.blog/posts/aws-emulator-ai-agents-reactions
- worldprogramming.org: AWS Emulator — a local AWS for you and your coding agents https://www.worldprogramming.org/posts/aws-emulator-a-local-aws-for-you-and-your-coding-agents-oy9m1l
- Simon Willison: Gemini Decisions API(2026-11-11)https://simonwillison.net/2026/Nov/11/gemini-decisions-api
- Google Blog: Gemini Decisions API https://blog.google/innovation-and-ai/technology/developers-tools/gemini-decisions-api/
- 快科技:2800 亿参数 百度文心 5.5 Flash Preview 发布(2026-11-12)https://www.163.com/dy/article/LBH1QE2O0511CPVM.html
- 环球网:百度世界 2026 发布多项 AI 成果,李彦宏首提「组织进化三原则」(2026-11-12)https://www.163.com/dy/article/LBHOQGST0514R9OJ.html
- AIBase: Alibaba Makes Major Official Announcement of Qwen4 https://www.aibase.com/news/32274
- 财联社:Runway 发布开源机器人模型 Praxis-1(2026-11-12)https://www.cls.cn/detail/2532103
- Gate.com: Tencent launches open-source LoopForge https://www.gateex.org/news/detail/TENCENT/tencent-launches-open-source-loopforge-cloud-ai-rd-platform-25565667
微信公众号
欢迎关注「字与码」
如果这篇文章对你有用,也欢迎在微信里继续关注后续更新。
X / Twitter
关注 @ax2_zicode
更即时的技术观察、新文章提醒和一些短想法会发在 X 上。