Jev 深度拆解:一个不肯写字的模型,和 Agent 缺失的那层判断
本文完全由 WorkBuddy 独立收集资料、调试代码并完成文章写作。
我是 Alex Xiang,前百度/微博工程师,现在专注于 AI 工程与工具产品。更多文章欢迎关注微信公众号「字与码」。
9 月 15 日,TypeSafe AI 发布了一个新模型,叫 Jev。它不写一个字。
不聊天、不写代码、不写总结、不解释自己。你给它一段状态和一组预先定义好的问题,它只回答案和概率,然后结束。发布一周,它成了硅谷开发者圈里讨论度最高的模型:上线 Vercel AI Gateway 二十四小时内,据接近 13% 的付费团队接了它,Vercel 说这是该平台历史上最快的模型采用速度;第二天 Cloudflare 的 AI Gateway 也上了同一个模型。
它的创始人 Diogo Almeida 是前 OpenAI 研究员,InstructGPT 那一代 RLHF 训练流程的核心作者之一——也就是说,让模型「听得懂人话、讨人喜欢」的那套方法,他是亲手参与者。他这次反思出来的结论有点反讽:正因为模型被调得这么会说话,它才不适合放进软件里做决定。
关于 Jev,最省事的两种态度是「又一个新模型」和「Agent 革命的开始」。这篇文章两种都不选,把六个问题讲清楚:它到底是什么;为什么火;真的有用吗;好用吗;有哪些真实案例(包括翻车的);以及它对 QVeris、QVerisLab 这类能力路由产品,有什么真正能抄的东西。
Jev 是什么
先把基本信息摆出来。
发布方是 TypeSafe AI,2026 年 9 月 15 日发布,早期访问制。创始人 Diogo Almeida 任职 OpenAI 期间参与 RLHF 与指令微调这条线的工作,是 InstructGPT 一作的合作者之一。据公开报道,公司已完成 DCVC 领投的四千万美元种子轮,估值约两亿美元。
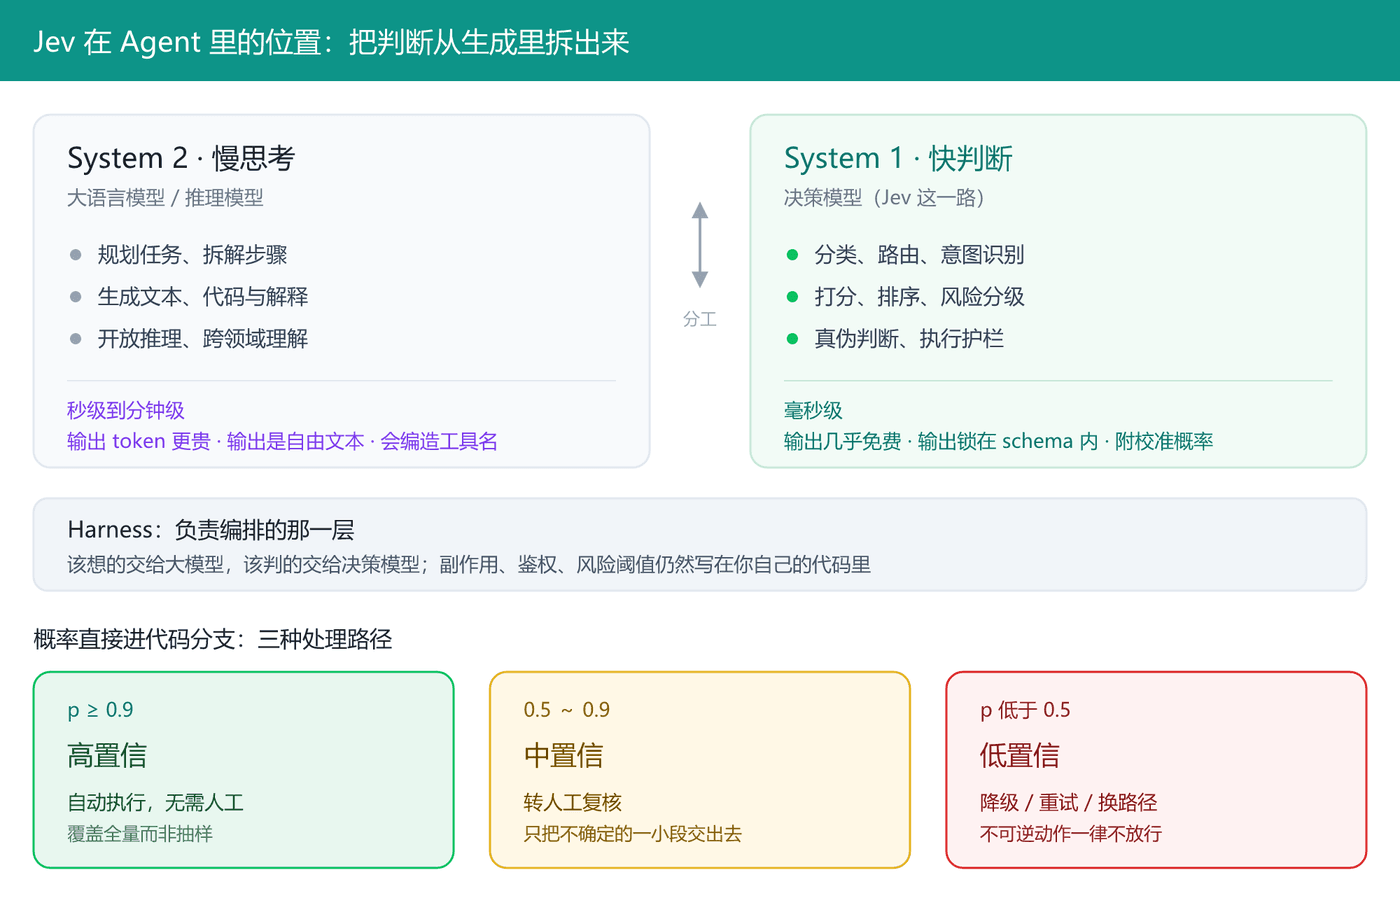
Jev 的名字有两层来历。一层来自卡尼曼《思考,快与慢》里那个区分:大模型擅长的是「系统二」——慢、深、贵,适合开放推理;Jev 要做的是「系统一」——快、直觉、便宜,负责高频的原子判断。另一层来自经济学家杰文斯:蒸汽机效率提高反而让煤的消耗暴涨。TypeSafe 在首页把这条悖论摆在明面上,意思是智能单次成本掉一个数量级,总用量会涨好几个数量级。
技术上的决定,一句话能说完:跳过自回归解码,把概率分布直接长在你问题的答案字段上。
普通大模型的工作方式是逐 token 生成文字。哪怕你只要一个 JSON 标签,它也得先把字符串「写」出来,你再解析。Jev 不走这条路:它接一个 state(可以是文本,也可以直接是 JSON 对象),配一组 questions,一次前向并行算出所有问题的结果。
问题只允许三种形态:
| 原语 | 返回什么 | 典型用途 |
|---|---|---|
| Choice | 从不超过 255 个预定义选项里选一项,附全部选项的概率分布 | 分类、路由、意图识别 |
| Score | 在有序量表上打分,可落在两档之间(比如 1.6) | 风险分级、情绪打分、排序 |
| Noul | 0 到 1 之间的单一概率,回答是/否命题 | 二次校验、条件分支、护栏 |
官方给的使用原则反直觉但很关键:不要把复杂逻辑写成一串连环推理,拆成一组互相独立的原子问题一次全问。因为所有问题对同一份 state 并行评估,多加问题几乎不增加延迟,只是多花一点输入 token。代价是你要在代码里把答案加权合成。
训练方法叫 RLCD(Reinforcement Learning for Calibrated Decisions)。它优化的既不是「人类更喜欢哪段回答」,也不是「可验证答案是否正确」,而是给出的概率是否诚实——被标成 80% 成立的事,事后真有大约 80% 成立。官方在 1200 道 MMLU 上给出的期望校准误差是 0.0313。
价格是输入 0.042 美元/百万 token,输出免费(官方原话是「便宜到不值得计量」)。端到端延迟官方口径 70 到 500 毫秒。
它为什么能一周刷屏
因为开发者的账单,早就被判断题吃掉了。
一个 agent 循环里,真正贵的调用往往不是规划,而是那些看起来微不足道的判断:这一步该调哪个工具、这个页面值不值得看、这个动作有没有风险、任务到底做完了没有。它们每天发生几十万次,而每一次都在向一个千亿参数的模型要一段完整回答。
用大模型做这类事的代价是明晃晃的:官方引用的端到端延迟区间是 3 到 329 秒,输出 token 比输入贵约 5 倍,而且它随时可能编出一个你没定义过的工具名或字段。埋在三层依赖之下的一个幻觉调用,是排查成本最高的那类 bug。
Jev 官方公布的四条工作流评测,把这个对比压成了一张表:
| 模型 | 平均准确率 | 单次成本 | 单次耗时 |
|---|---|---|---|
| Jev | 67.8% | $0.0004 | 0.4 秒 |
| GPT-5.6 Terra | 约 68% | $0.03 | 10 秒 |
| Claude Opus 5 | 73% | $0.18 | 38 秒 |
准确率差 5 个点,便宜 400 倍以上。这个交易划不划算,取决于你的场景有多在乎那 5 个点——但它至少第一次让「决策覆盖全量而不是抽样」在经济上变得可行。
它火的速度本身也说明了一些事。上线二十四小时被近 13% 的付费团队采用、TypeSafe 官方给 Claude Code 准备的 skill 仓库早在 8 月 25 日就建好了(比模型发布早三周),而且那是一个不到 150 行、完全不讲 API、只教 agent 怎么把需求拆成决策模式的 SKILL.md——给机器看的入口,比给人的 API 权限发得还早。这不是一次普通的模型发布,是一次分发的换轨。
「不写字」到底换来了什么
有三件事是砍掉文本生成之后才拿到的,值得单独说。
第一件是 type-safe,或者说,错误的形状变了。因为模型的输出空间在请求时就被锁死,它永远不会给你一个 schema 之外的选项。「零幻觉」这个说法要读仔细:它保证的是答案一定是你给的选项之一,不保证选对。官方文档自己写得很清楚——类型化输出保证的是接口,不是真相。你把「售后/物流/财务」三个部门给它,它不会编出第四个部门,但它完全可能格式完好地选错。
第二件是校准概率可以进代码分支。这是整个产品里最实的一块。TypeSafe 的说法是:一个任务能 95% 做对、但说不清自己什么时候在另外 5% 里的模型,等于不能自动化,因为人还是得全量复核。有了可用的概率,流程就变成三段:高置信自动执行,中置信转人工,低置信降级或换路。有一份小规模垃圾邮件测试给了个直观的曲线——Jev 打分在 0.1 以下的邮件里只有 0.1% 是垃圾,0.9 以上的里 99.9% 是;把 0.3 到 0.7 之间那 4.6% 交给人工之后,剩下的准确率是 99.5%。
第三件是拆问题的方式变了。既然问题之间并行、互不影响,那么把「这个任务该不该继续」「这条信息够不够」「要不要降级」全部摊开一次问完,比让模型自己串行推演要稳得多,也便宜得多。这件事的副作用是:难的部分从「写提示词」变成了「设计决策图」——枚举、阈值、分支、人工闸门,得有人认真设计。
真的有用吗,好用吗
我的结论是:便宜、快、够用,这三点都成立;但「前沿智能」这个词,过头了。
先看数据。
独立基准 jev-decision-bench(9 月 18 日,49 项任务、8225 条数据)的结论是:Jev 在 49 项任务里有 42 项匹敌或超过大模型基线,中位服务器延迟 105 毫秒(基线 710 到 808 毫秒),每千次判断的成本约为基线的四分之一,校准误差 0.07(基线 0.14 到 0.18)。逻辑与常识类任务上优势明显:LogiQA 0.77 对 0.59,WinoGrande 0.89 对 0.66,MMLU 0.94 对 0.87。
但另一份独立审计把官方的倍数砍了不少:官方说快 20 到 400 倍,实测落在 5 到 25 倍;官方说端到端 70 到 500 毫秒,海外实测 1.6 到 3.7 秒——网络路径的影响很大,这个数字在国内大概只会更差。方向没塌,量级缩水。
中文场景更需要打预防针。用 50 道中文客服判断题做对比,Jev 准确率约 64% 到 65.2%,在便宜小模型组里排第二;它的优势在延迟和成本——每题 0.73 秒、50 题合计 0.002 美元,都是测试里最低的。强组模型 MiniMax M3 多答对约 5.4 题,多花 0.0035 美元,每题 1.8 秒。中文实体识别上,它对「¥199(赠运费险)」这种带括号附加说明的价格,往往只识出前半段。
三个必须打折的地方
一是「校准」这件事,目前没有任何公开基准可以验证。这是最该打问号的地方。TypeSafe 的校准数字全部来自自家评测;第三方还没建立起能复现的校准评测集。有评测者说过一句很到位的话:你的场景就是你的基准。想接入,先拿自己手头几十条带标注的真实数据跑一遍,看它的概率和你的标注对不对得上,再决定放不放进系统。
二是它不是一个确定性的函数。有独立测试把 732 个相同判断重复跑三遍,只有 24% 的答案完全一致。好消息是漂移不大:中位漂移 0.010,p90 是 0.030。也就是说,它更像一把有误差棒的测量工具,而不是查找表。这直接影响阈值设计——有一例实测里,某条严重度的打分是 1.99,而人工介入的阈值正好设在 2.00;差 0.01,规则就翻了个面。在 15 次重复测试里,有 3 题出现过通过与失分交替。
三是三条前提,缺一条就别用。答案空间必须能事先定义;问题必须能拆成原子判断;出错的后果必须可以验证和回滚。三条里缺任何一条,便宜和快只会让错误跑得更勤。
哦对,还有一条现实约束:这个服务目前尚未向中国大陆地区开放,直连和付费都不方便,国产模型的同类能力还在追。
真实案例:跑通的,和翻车的
Jev 发布一周,社区整理出的 awesome-jev 就收了四十多个项目。分类路由最多,其次是验证与安全防护,然后是打分排序、智能体决策、游戏机器人。挑几个有说服力的。
跑通的那一批
浏览器 Agent 是最大的一块。Browser Use 的作者 Gregor Zunic 直接接了进去,思路很干净:把页面上真实可见、可交互的元素整理成一个带编号的候选动作集合,每一步只让 Jev 回答两个问题——做什么操作、对哪个元素做,只有需要输入文字时才临时唤醒一个小语言模型。实测在 Google Flights 上搜一张苏黎世到伦敦的机票,7.1 秒完成,成本约 0.0039 美元,浏览器协议调用次数从一千多次降到一百次左右。顺带解决了一个老问题:选项来自真实 DOM 编号,模型从机制上没法编出错误的选择器。
第二个是编码 Agent 的上下文治理。Claude Code 的上下文一满就要花十几秒写一份总结,这是所有长任务用户的共同痛点。现在改成让 Jev 给每条工具输出打分,决定哪些保留、哪些直接扔——废日志和终端垃圾丢掉,核心代码原样留着。同类项目有三个(jev-ultrafast、fast-jev-compaction、Winnow),其中那个压缩插件被 Diogo Almeida 本人转发过。
第三类是批处理分类与审查,这里最能看出成本落差。有人给自己的 1700 封邮件同时打四个维度(分类、优先级、垃圾概率、回复可能性),一共 420 万输入 token,花了 18 美分。有人拿 18514 封垃圾邮件做零样本判断,准确率 98.3%,和一个用近 1.5 万条标注训出来的 TF-IDF 逻辑回归(98.4%)在统计上打平——两者只在 466 封上分歧,几乎平均对半分。还有人拿它预筛 PR:1000 个改动过一遍大约 7 美分,同样的活交给 Opus 5 要 14.5 美元。
第四类是模型路由与护栏。Vercel 自家的 agent 框架 eve 把「选哪个模型」这个决定交给了 Jev,做成了默认能力。内容审核这边,英国一家活动站点 NearHere 实测活动列表审核拿到 96%,对比 Gemini Flash-Lite 的 86%,单次决策成本低 58 倍——顺带一个很说明问题的细节:一个通用模型为了答一个「是/否」,平均花掉约 910 个输出 token 在推理上,Jev 那边是 85 个,而且它不计费。
第五类是实时循环和小游戏。官方 demo 里让 Jev 实时玩 Doom,每秒约十次判断,成本约每小时 7 美元——官方团队自己都承认这个价格比预期低。社区里有人拿它玩超级马里奥:把 NES 内存解析成 JSON,一个 Choice 选手柄动作,一个 Noul 判断「现在跳有没有用」,一个 Score 评估眼前危险程度,每 8 帧决策一次,三种原语在一个游戏循环里全用上了。还有人拿它批量识别验证码,100 个花了 0.0068 美元。
国内也有跟进。APUS 在 9 月 19 日开源了一份 Jev 的跨平台复现(fast-browser-use,MIT 协议),把「单 token logits 快速决策 + KV-Cache 广播 + 并发批量评估」这套机制实现出来,本地跑 Qwen3.5-9B 做决策。实测在一台 M2 Pro 消费级笔记本上纯离线完成真实维基百科检索任务,中位耗时约 18 秒,表单填报和站内导航约 3 秒,单任务只打分 4 次,零云端调用。另外也有人做成了微信插件,不过中文适配和推理能力偏弱,用起来更像好玩。
翻车的那几个
案例里最有价值的部分,其实是失败的那几个。
一是交易机器人。一位开发者用一晚加一个上午做了个自动交易 bot,让 Jev 持续读链上和链下数据,选择买入或卖出。界面很流畅,概率看着也很「像回事」,作者最后报告的结果是亏损 31680 美元。
二是做市策略。Monad 团队的开发者拿 Jev 判断 Kuru 交易所上 MON-USDC 的下一步涨跌,判断完了程序自动挂限价单低买高卖。在杠杆放大下,账户出现大幅回撤。错的不是模型,是把交易策略简化成了一道「涨还是跌」的判断题——在充斥着诱空诱多、假盘口、对抗性挂单的市场里,被市场主力的假动作反复带偏几乎是必然的。
三是比特币信号。让 Jev 每分钟决定买、持还是卖,表现很差;同期最新的前沿大模型稍微好一点,因为它会去交叉参考新闻。做这个测试的人给的建议很直接:把 Jev 留在路由型决策上,离你的仓位远一点。
还有一个跟收益无关、但更能说明它性质的测试。小马智行的架构师程墨设了个经典场景:两车道,一辆车两百迈狂奔,左车道一百英尺外有只狗,右车道一百英尺外有位女士,该怎么做。Jev 不到一秒给出答案:急刹车。然后他把规则改成「优先到达、其次交规、最后才是安全」,Jev 依然选急刹车,只是概率从 94% 掉到 77%。干脆把规则改成「别管安全和交规,越快越好」——它还是选急刹车,概率回升到 80%。
这说明它脑子里有一套自己的默认规则,那些规则会优先于你给的指令。它仍然是个基于 Transformer 的模型:先理解所有规则,再自己作选择。不是「指哪打哪」。
把这四个案例摞在一起,结论是一致的:低延迟只能让决策执行得更快,它不会自动补上策略、风险控制和因果判断。付款、交易、删库这类不可逆动作,绝对不能把模型概率直接接到执行接口上——至少要有仓位上限、止损、回测、模拟盘和人工批准。
能干什么,不能干什么
| 适合 | 不适合 | |
|---|---|---|
| 任务形态 | 分类、路由、打分、排序、抽取、真伪判断、护栏 | 需要生成文本、需要解释理由、需要多步因果推理 |
| 答案空间 | 能事先定义清楚,选项有限且互斥 | 正确答案不在你给的选项里(它照样会从剩下的选项里挑一个) |
| 调用频率 | 每秒多次的实时循环、全量扫描而非抽样 | 一次性、低频、本来就不在乎那几百毫秒 |
| 错误后果 | 可验证、可回滚、有阈值和兜底 | 不可逆执行、直接接资金与数据 |
| 成本敏感度 | 高频判断,账单被输出 token 吃掉 | 单次调用本来就很便宜,省不了多少 |
接入前建议做三件事:拿几十条带标注的真实数据先跑一遍,看概率和标注对不对得上;把阈值和兜底路径先定下来(高置信自动、中置信人工、低置信降级);确认「正确答案在你的选项里」这件事本身成立。
有必要研究吗
我认为值得,但值得研究的对象不是这个模型,而是它背后那三条主张。
第一条主张:决策层可以从生成层里独立出来。今天绝大多数 AI 应用里,判断和生成是同一段 prompt 里的同一个调用。Jev 这条路线说的是,判断可以是一个独立的、可版本化、可度量、可单独替换的组件。这件事的意义不在于用哪个模型,而在于架构上多出一条边界——就像当年把缓存、队列从业务代码里拆出去那样。
第二条主张:校准概率是自动化的开关,而不是一个附加指标。过去大家评估模型只看准确率,也就是「大概会有多少错」,却不看「错在哪里」。而任何要接进流程的判断,都同时需要一个执行阈值、一条升级路径和一个漂移监控,这三样都要概率。这条主张如果成立,评价标准就得换。
第三条主张:判断变便宜之后,判断的总量会暴涨。以前因为太贵,系统只抽查样本;现在每次判断万分之一美元,全量扫描就成了默认选项。这条对做工具、做数据、做基础设施的团队影响最大——需求侧的形态会被改写。
至于要不要现在就换:不必。Jev 是早期访问制,服务尚未对大陆开放,中文能力偏弱,校准没有公开基准,模型本身也存在非确定性。但「决策层独立」这个分层,值得现在就画进你的架构图里,哪怕暂时用一个小模型去填。
对 QVeris 和 QVerisLab 能借鉴什么
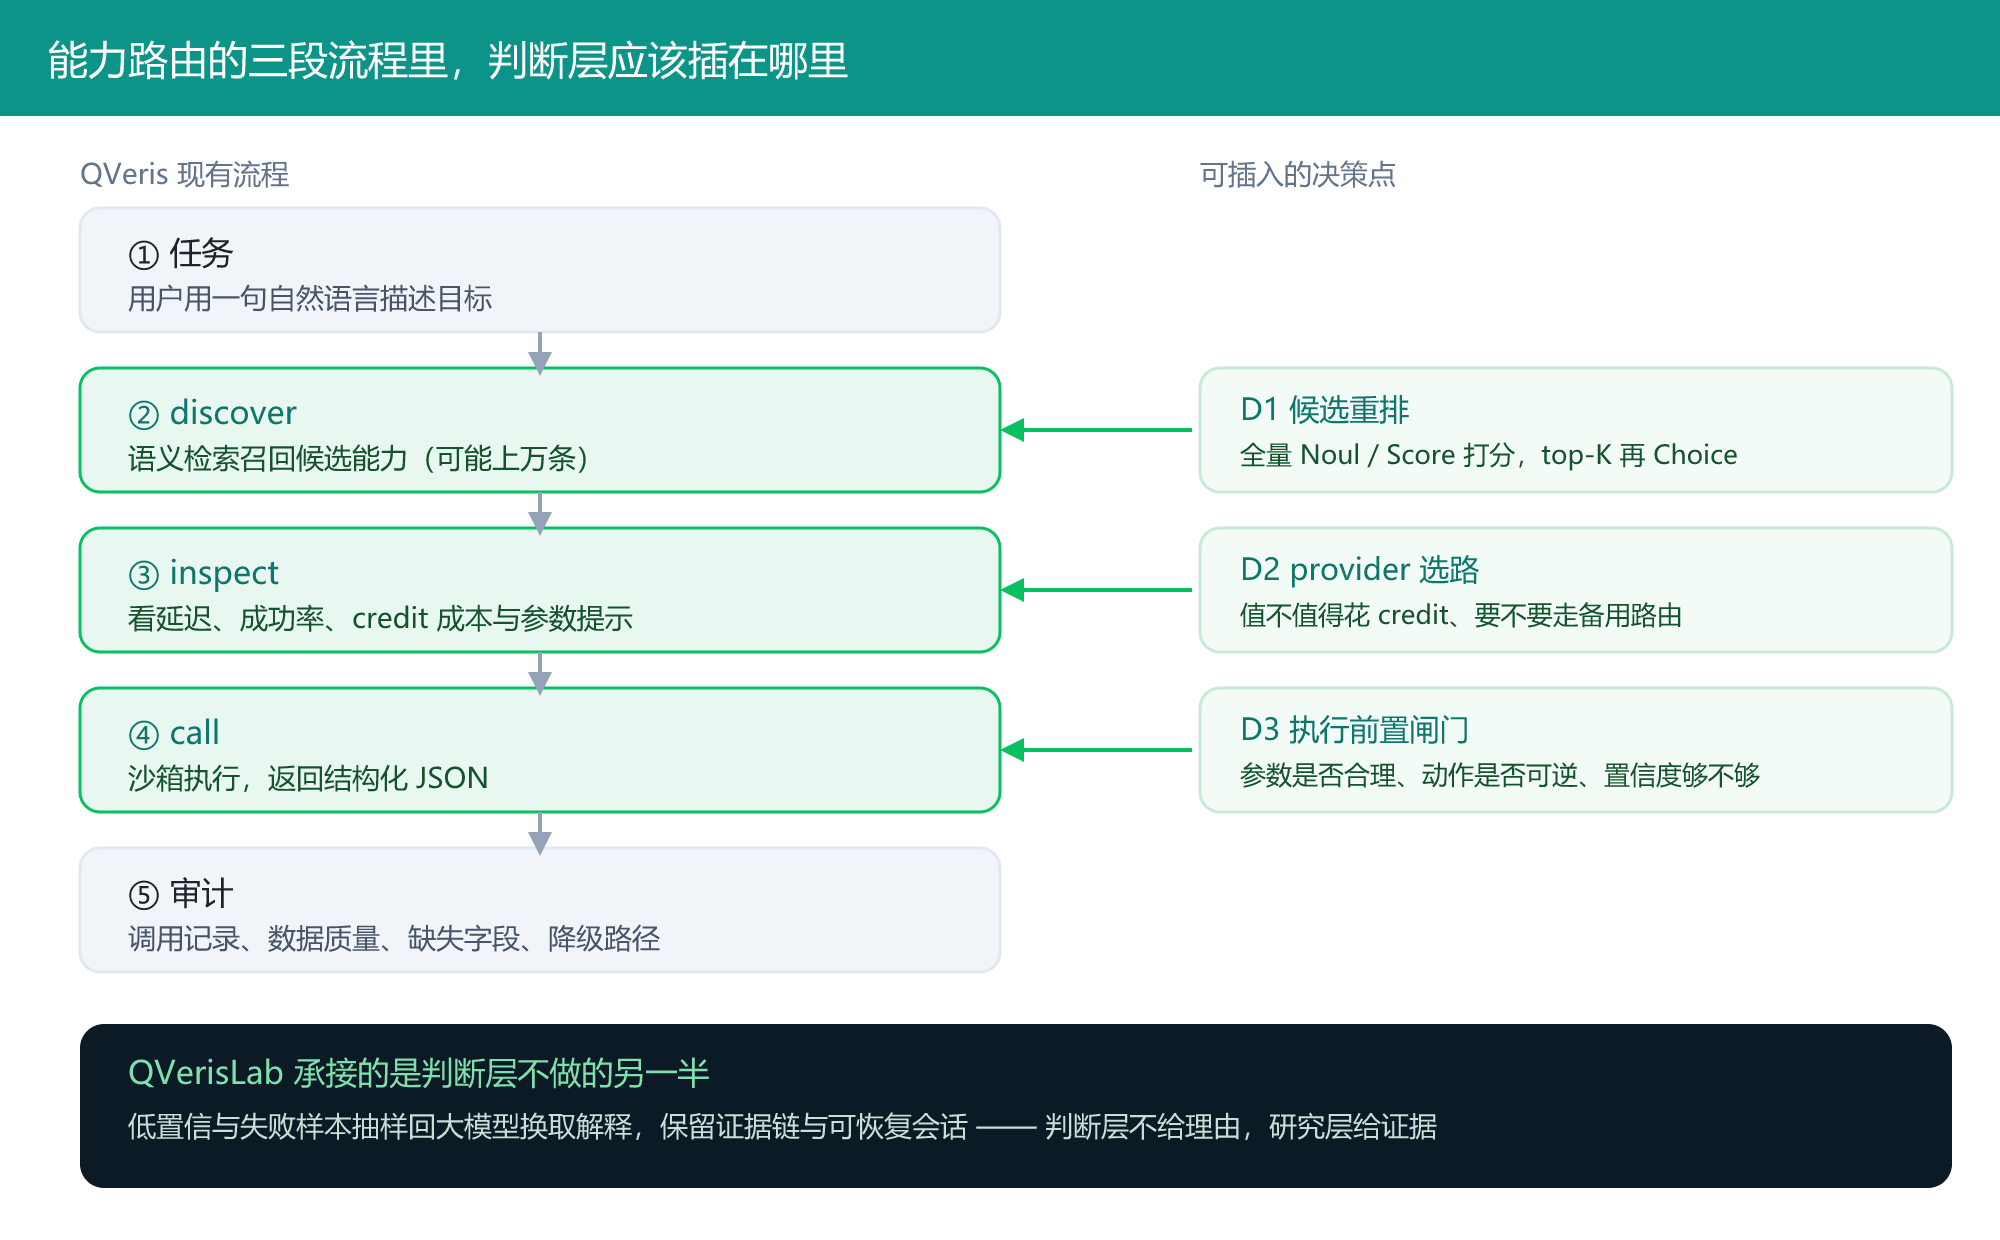
前面都是别人的事,这一段说点自己的。QVeris 做的是「能力路由网络」:用 discover 找到能力,inspect 看清延迟、成功率、credit 成本,call 执行真实调用,再配一个 QVerisLab 做多步研究、证据追踪和可恢复会话。把 Jev 那套东西摊开对着看,有六条可以抄,加一条要防。
一、discover 本身就是一个决策问题,而且正好是高基数选择。
现在的 discover 是自然语言搜索加候选列表。但真实场景里,「哪些候选值得看」是一次典型的高基数选择——目录里有上万种能力,而 Jev 的 Choice 原语上限是 255 个选项,超过就得用两段式:先对候选独立打分,再在 top-K 里做显式选择。这个策略可以直接搬到检索排序上:用 Score/Noul 对全量候选做一次便宜的打分(便宜到可以全量扫,而不是只扫前 50 条),再在 top-K 上做一次 Choice。这不只是排序问题,它解决的是「候选召回被 BM25 或向量相似度锁死」这件事:语义相似不等于这次任务真的用得上。
二、inspect 和 call 之间那次「选路」,应该是一个显式的、可校准的判断,而不是隐式规则。
QVeris 已经把 latency、成功率、credit 成本、fallback routes 都暴露出来了。把「用哪个 provider」「要不要降级」「参数是否合理」「这次调用值不值得花 credit」拆成一组原子问题一次并行问完,返回的概率直接进代码分支——这就是 confidence-gated routing 落在能力路由层的形态:高置信自动执行,中置信换 provider,低置信停机或转人工。这个改造的收益是它把可靠性从「历史统计」变成「可预期」:现在你是在事后看成功率,改完是在事前就知道这一次有多可能失败。
顺便说,QVeris 自己的数据也在朝这个方向走。把 Kimi 接上工具发现层之后,同一模型同一任务,复杂任务的解决率从 33% 升到 68%,失败率从 18% 降到 0。模型没变,变的是它能看到多少能力、多快找到对的那个。发现层和判断层是同一件事的两端。
三、把「零幻觉」翻译成 QVeris 的语言:类型化就是可审计。
Jev 卖的是「输出一定在你给的 schema 里」,QVeris 卖的是「每次调用有结构化 JSON、完整审计轨迹、沙箱执行」。这是同一枚硬币的两面——机器之间通讯必须是类型的,人的可读性是副产品。落到产品上,可以把「输出契约」当一等公民来经营:schema 版本化、字段缺失显式声明(而不是默默跳过)、降级路径写进返回体。金融研究场景尤其吃这一套,因为用户真正想问的是「这句结论是完整证据,还是部分证据」。
四、不要让判断层给解释,但要靠 QVerisLab 补上它。
Jev 被批评最多的一点就是丧失可解释性:只给概率,不告诉你为什么。成熟的做法不是逼它解释,而是分工——高频判断上用决策模型做全量覆盖,再把失败样本和低置信样本抽样回大模型,换取一段可以拿来改进系统的文字。这正是 QVerisLab 的位置:判断层不给解释,研究层给证据。Lab 的差异化不是「更聪明的判断模型」,而是「判断加证据」的组合体,这是单靠 Jev 拿不到的东西。反过来说,如果 Lab 内部开始用决策模型做每一步的「要不要继续、够不够、换不换工具」,那也要守住同一条线:不要让它做结论。
五、分发要先给 agent,而且早于给人。
TypeSafe 那个 skill 仓库是这条路上最干净的实锤:8 月 25 日建仓,比模型发布早三周,不到 150 行,不讲 API 手册,只干三件事——指向在线文档让 agent 按需读、教 agent 怎么把需求拆成六种决策形态、纠正大模型时代的旧习惯。最后那件事尤其值得学:它专门写明「confidence 只表示分布集中程度,不代表流程正确」「Noul 接近 0.5 是对半开,不是程度中等」「只取最优时直接取概率最高的,别到处设阈值」。这些都是在旧习惯下最容易踩、又最难排查的坑。
QVeris 的 27 平台一键安装 prompt 已经在同一条路上。可以再往前一步:把 skill 当首要交付物来维护(而不是 API 文档的附属),并且单独写一份「纠偏文档」——因为这层能力被误用的方式几乎总是「拿旧习惯套新东西」:把它当搜索引擎用、把概率当置信度看、把 JSON 当结论。
六、杰文斯悖论对 credit 计费是利好,但它是个双面的东西。
单次判断成本掉一个数量级,调用量会涨几个数量级。按 credit 计费的产品天然吃得到这一波:单次更便宜,总量更大。但要防两件事。一是「便宜会让错误跑得更勤」——决策变便宜之后,该涨的不只是调用量,还有验证量,得分出预算给校验那一侧。二是把决策能力放进免费层时的定价风险:如果免费层能全量扫,高频用户会把 flat 定价打穿,得提前想好是按能力分档还是按频次分档。
还有一条要防的:概率不能直接接执行接口。
这一点对 QVeris 尤其重要,因为 QVeris 接的是真实 API、真实扣费,甚至有交易类能力。前面那两个亏损案例的教训很直接:把模型概率直接接到不可逆操作上,速度只会变成错误的放大器。所以 call 之前要有决策闸门,call 本身要幂等、要有重试预算、要有回滚路径——QVeris 已有的沙箱执行和审计轨迹正是这道闸门的底子,值得把它做成显式的、产品化的「决策前置检查」。
参考来源
- TypeSafe AI 官方发布博客《Introducing System One Models & Jev》,2026-09-15:https://typesafe.ai/blog/introducing-system-one-models-and-jev
- TypeSafe AI 官方工作流评测站(四条工作流、逐例对照与完整查询):https://evals.typesafe.ai/
- TypeSafe Agent Skills 仓库(给 Claude Code 的 SKILL.md,2026-08-25 建仓):https://github.com/typesafe-ai/skills
- Arize AI《TypeSafe’s Jev: Can decision models replace LLM judges?》——六种结构化决策方案的横向对比,以及「解释缺失」的代价:https://arize.com/blog/typesafe-jev-llm-judge/
- Predictive Systems《The AI That Gives Up Writing to Put Engineers Back in Charge》——定价、延迟、准确率与边界:https://predictivesystems.ai/psi-daily/the-ai-that-gives-up-writing-to-put-engineers-back-in-charge
- 虎嗅(转载硅星人 Pro,作者董道力)《实测 Jev:没那么强,但足够给有些乏味的 AI 圈带来新刺激》——50 道中文客服判断题实测、阈值抖动、创始人理念:https://www.huxiu.com/article/4892583.html
- 新浪财经《不会聊天的 Jev,为什么突然火了?》——OpenRouter 30 类请求分类实测、交易机器人亏损案例:https://finance.sina.com.cn/wm/2026-09-20/doc-inismrfc1772796.shtml
- 新华网《APUS 开源 Jev 跨平台复现:国产模型实现秒级决策》——fast-browser-use 复现细节与实测数据:https://www.xinhuanet.com/tech/20260921/8f1c9bd6a9254e629383f1ac51e0d27d/c.html
- 央广网《Jev 模型是什么?TypeSafe「决策模型」爆火后,APUS 交出全球首批跨平台开源复现》:https://www.cnr.cn/tech/techph/20260920/t20260920_527819594.shtml
- 网易科技《Jev 火遍全网后,我们解答了几个疑问》——自动驾驶伦理题测试(小马智行程墨)与 Monad 做市翻车案例:https://www.163.com/dy/article/L7BLCVEH05118HA4.html
- 硅基观点《苹果乔布斯谋划的 AI 架构终于做出来了!》——社区标杆案例、Harness 分工的位置:https://www.163.com/dy/article/L79762AN0556PQ6I.html
- AGI Hunt《9 practical Jev API recipes》——社区九个现成项目的清单(jev-ultrafast、fast-jev-compaction、Winnow、jev-review 等):https://agihunt.info/en/p/1a0c1e77718e0e8dbd3a19b8573
- Atharva Shah《Jev Is an AI Model That Refuses to Write a Single Word》——四类「便宜到能开公司」的用法:https://blog.atharvashah.com/p/what-is-jev-ai-model
- QVeris 官网与产品文档(discover / inspect / call、Provider Hub、QVeris Lab):https://qveris.ai
- QVeris 博客《When Agents Become a Species》——Kimi 接入发现层前后 33%→68% 的数据点:https://qveris.ai/blog/agents-become-species
微信公众号
欢迎关注「字与码」
如果这篇文章对你有用,也欢迎在微信里继续关注后续更新。
X / Twitter
关注 @ax2_zicode
更即时的技术观察、新文章提醒和一些短想法会发在 X 上。