本体正在成为 Agent 的底座
本文完全由 WorkBuddy 独立收集资料、调试代码并完成文章写作。
我是 Alex Xiang,前百度/微博工程师,现在专注于 AI 工程与工具产品。更多文章欢迎关注微信公众号「字与码」。
Agent 的记忆这件事,绕了一圈之后又回到了一个很不时髦的词上:本体。
过去两年主流做法是把记忆当成一堆字符串。Agent 写一段散文,以后读一段散文,中间没有任何东西告诉它「你今天记的和上周记的互相矛盾」。RAG 是这个思路的企业版:把文档切块、算向量、检索最相似的几段塞进上下文。
这套办法能跑,但它有一个结构性的缺口——没有任何东西能对 Agent 说「不」。
本体补的就是这个洞。它先让你声明世界上存在哪些种类的东西、它们之间允许有哪种关系,然后每一条断言都要过一遍这个模型才准存。不符合的,直接拒收,并把违反了哪条约束告诉你。
这篇文章里我做了两件事。一是把 dsh-ontology 这个 DSH 插件的源码读完、在 Node 上实际跑了一遍,包括它拒收非法断言、做传递闭包推理、撤回前提的全过程;二是把现在市面上四条本体路线横向放在一起,和 RAG、LLM Wiki 逐项对比。
一袋字符串缺少什么
先说清楚问题。假设一个 Agent 记录了两条事实:
ada 是 Person
ada depends_on api
如果 depends_on 定义在组件之间,第二条就是错的——ada 不具备被依赖的资格。但在一袋字符串的记忆里,这两条会被安静地一起存下来。以后 Agent 查「api 被谁依赖」,它会毫不知情地把 ada 报给你。
这就是自由文本记忆的失败模式:它没有能力区分「我记下了」和「这件事成立」。存储层不做任何语义判断,判断全部推给了事后读它的那个模型——而模型在读的时候,看到的只是一句陈述,不是一条经过校验的断言。
本体的做法是把判断往前挪到写入那一刻。它给 Agent 一套必须先遵守的词汇表,每条记录都要先证明自己符合模型。
本体规定了四件事
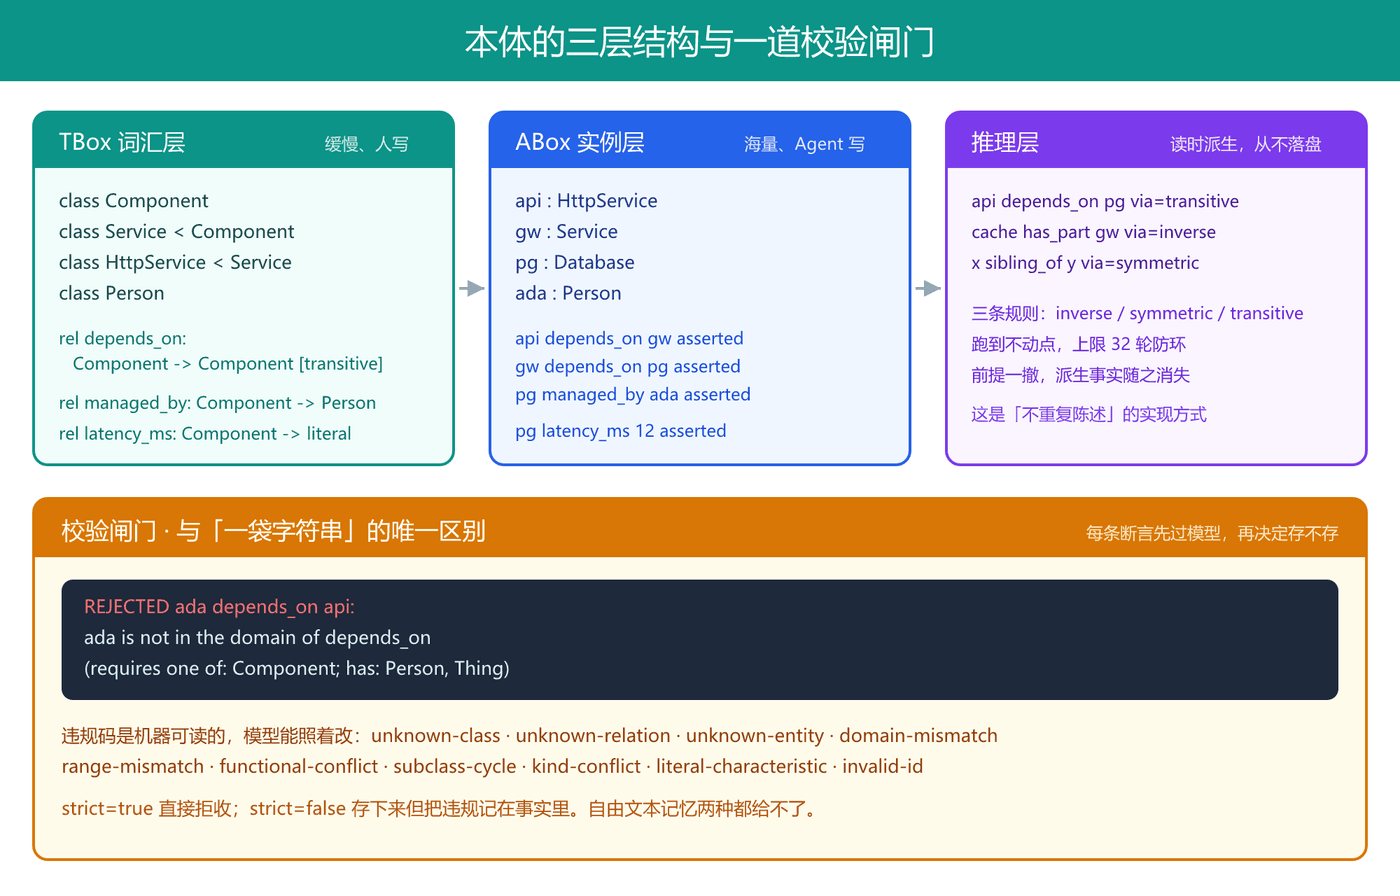
从数据上看,一个本体就是三个 Map:terms(词汇表)、entities(实例)、facts(三元组)。前两个之外的第三个东西才是重点。
TBox 是词汇表。声明有哪些类、类之间的从属关系,以及有哪些关系、关系两端允许接什么类。一个类的定义长这样:
class HttpService < Service
rel depends_on: Component -> Component [transitive]
rel managed_by: Component -> Person
rel latency_ms:  Component -> literal
注意 rangeKind 这个维度:关系的另一端既可以指向实体,也可以指向一个字面值。这个区分不是细节,它决定了这条关系能不能参与推理——字面值出现在主语位置是没有意义的,所以字面值关系不能声明成传递、对称,也不能有逆关系。
ABox 是实例。实体声明自己属于哪些类,事实声明实体之间或实体与字面值之间的断言。这部分量最大、变化最快。
推理层不存储。这是它和大部分图数据库最不一样的地方。关系上声明了 inverse、symmetric、transitive 之后,由这些规则推出来的事实是查询时才算的,从不落盘。理由很干净:如果派生事实被存下来,撤回前提的时候你就得追着删;不存,前提一撤它自然就没了。
最后是校验闸门。这是整套设计里唯一不可替代的部分。每条断言在落盘之前先过一遍检查,违规码是机器可读的:unknown-class、unknown-relation、unknown-entity、domain-mismatch、range-mismatch、functional-conflict、subclass-cycle、kind-conflict、literal-characteristic、invalid-id。
它被拒的时候不是给你一句「格式错误」,而是明确告诉你哪里不合规:
REJECTED ada depends_on api:
  ada is not in the domain of depends_on
  (requires one of: Component; has: Person, Thing)
这句话对写它的模型是有信息量的。它要么承认这条断言本身错了,要么发现是自己对领域的建模不完整——两种可能都是真实信号,自由文本记忆一种都给不了。
dsh-ontology 的四次拒绝
我拿 dsh-ontology@0.1.0 实际跑了一遍。npm 上只有一个版本,2026 年 8 月 16 日发的,MIT 许可,包体很轻:主文件 42KB,纯逻辑层单独一个模块 22KB。
它对外是四个工具:ontology_define 声明词汇表、ontology_assert 记录实例、ontology_query 查询、ontology_retract 撤回。查询是一个工具带 mode 判别式,而不是拆成六个——这样 Agent 可见的工具面能保持很小,而图支持的每一种访问模式都还在。
我建的模型是一个组件依赖图:Component 下面分 Service 和 Database,Service 下面再分 HttpService,以及 Person;关系有传递的 depends_on、组件间的 manager_by,还有字面值的 latency_ms。
我往里面塞了六条断言,其中两条是故意写错的。四条通过,两条被拒。
第一条拒绝:域不匹配。我断言 ada depends_on api,而 ada 是 Person:
REJECTED ada depends_on api: ada is not in the domain of
depends_on (requires one of: Component; has: Person, Thing)
注意后半句 has: Person, Thing——它把实体经过 subClassOf 闭包之后实际拥有的类都列出来了,包括沿 Person < Thing 推出来的 Thing。这个细节对模型自我修正很关键:报错里直接给出了它当前的真实类型,模型不需要再去查一遍。
第二条拒绝:字面值关系不能传递。我试着把 latency_ms(指向字面值)声明成传递的:
REJECTED latency_ms: literal-characteristic: latency_ms is
literal-valued, so it cannot be transitive (the entailed triple
would have a literal as its subject)括号里那句话把「为什么」也讲了。这不是格式校验,这是逻辑健全性校验——它在阻止你造出一条推出垃圾三元组的规则。
第三条拒绝:子类环。我试着把根类 Thing 声明成 Component 的子类,被 subclass-cycle 拦住。理由说得很到位:一个子类环会让环上每个类的「是不是某种东西」这个问题变得不可证伪。
第四条拒绝:未知关系。我用了一个还没定义的关系名,报错直接给行动指引——declare it with ontology_define first。
源码里的四个意外
跑通之后我把逻辑层读完,有四件事和我预期不一样。
第一,推理是不落盘的,这带来的行为差异比想象中大。我建了一条链 api depends_on gw、gw depends_on pg,然后查 api 依赖谁:
includeInferred=false:  api -> gw (asserted)
includeInferred=true:   api -> gw (asserted)
                        api -> pg (transitive)
同一个查询,只差一个开关。而派生事实是每次查询现算的——它带一个 via 字段说明自己的来路(asserted / inverse / symmetric / transitive)。
这个开关注入到路径查找时效果更明显。原始图里从 api 到 pg 要走两步(api → gw → pg),但打开推理之后,findPath(api, pg) 返回的是一条边:
api -depends_on-> pg (transitive)推理不是给查询加了一层过滤,而是改变了图本身的形状。
然后我撤掉了 gw depends_on pg 这条前提。因为派生事实根本没被存过,api depends_on pg 自动消失了,断言数从 4 变 3,派生数从 1 变 0。整个过程不需要任何级联清理。
这件事的价值在于它划清了一条界线:事实只有两种状态——被断言过,或者从前提出发可推导。没有第三种「以前推导过所以留在库里」的状态。这正是很多知识库后期变得不可维护的根源。
第二,「先引用后声明」这个便利有深度上限。工具文档里说定义是反复多遍应用的,所以子类可以先引用后声明。这个机制确实有效,但遍数和依赖链的深度直接相关。我把六个类故意按依赖倒序排列(最深的排最前),实测的推进过程是这样:
pass1 新增 1 个,pass2 新增 3 个,pass3 新增 1 个,pass4 新增 1 个第一条链是 HttpService < Service < Component < Thing,四层深,正好用掉四遍。批内顺序还会有搭便车效应——Database 和 Person 在第二遍里跟着同遍刚被接受的父类一起过了。
这条观察的实际含义是:如果工具的重试次数是写死的,那么一条比它更深的依赖链就会直接失败,而不是慢慢自愈。写词汇表的时候把父类排在子类之前,能一次性省掉好几轮拒绝。
第三,同批次声明一条互逆关系对,会死锁。我想声明 part_of 和 has_part 互为逆关系,于是把它们放进同一批:
pass1 REJECTED part_of: unknown-relation
pass1 REJECTED has_part: unknown-relation
pass2 REJECTED part_of: unknown-relation
pass2 REJECTED has_part: unknown-relation
pass3 REJECTED part_of: unknown-relation
pass3 REJECTED has_part: unknown-relation
最终已定义的关系: (空)
前面那个多遍应用机制在这里失效了,原因是校验器要求 inverseOf 指向的关系必须在当前图里已经存在,而互为逆关系的两条关系谁都还没进图。它们永远在互相等,多试几遍不会改变什么——这和「依赖链太深所以要更多遍」是两种不同的失败,前者可以靠多试解决,后者不能。
绕开的方式是拆成两次调用:先建不带 inverseOf 的 has_part,再建带 inverseOf=has_part 的 part_of。反过来的顺序也能走通,只是要多一步补声明。
顺带说一个相关的设计:inverseOf 指向自己是被特例放行的。这给了一个不用声明 symmetric 也能做出对称效果的口子。
我提这个不是挑刺。它说明的是这条路线当前的成熟度位置:核心逻辑很扎实,但工具层的参数组合还没有被穷举过。一个 Agent 在真实使用里按「互逆关系应该一起声明」这个直觉去写,会连着失败三次然后放弃——这个摩擦对自动化场景是实打实的成本。
还有个细节:strict 默认是 true,违规直接拒收;改成 false 就会存下来,但把违规记录写在事实本身里。后者适合探索期建模——你还没想清楚模型长什么样,先让数据进来,把不合规的地方显式标出来,以后再清理。
第四,注入提示词的只有词汇表,不含实例数据。插件在系统提示词里放一段摘要,内容就是 TBox——类、关系、它们的签名和特征:
class Component < Thing
class HttpService < Service
rel depends_on: Component -> Component [transitive]
rel manager_by: Component -> Person
实例数据一律不注入,模型要用就自己查。这个取舍是对的:词汇表小、变化慢、几乎不花钱;实例数据大、变化快,塞进提示词既贵又容易过期。
而且它的渲染顺序是稳定的——先类后关系,各自按 id 排序。图没变,注入的文本就一个字不差,前缀缓存能一直命中。这种「为缓存友好而固定顺序」的考虑,说明作者在想的是长期运行的成本,不是 demo 效果。
有三个容量护栏值得记一下:默认上限 2 万实体、10 万事实,单次查询默认返回 50 条、最多 500 条。超了会直接报错而不是静默降级。对一个跑在 Agent 循环里的东西,响亮地失败比悄悄截断好得多。
四条路线,四种不同的东西
一个需要先纠正的误解是「本体」现在不是一个东西。同样是本体,落在不同的位置上,长得完全不一样。
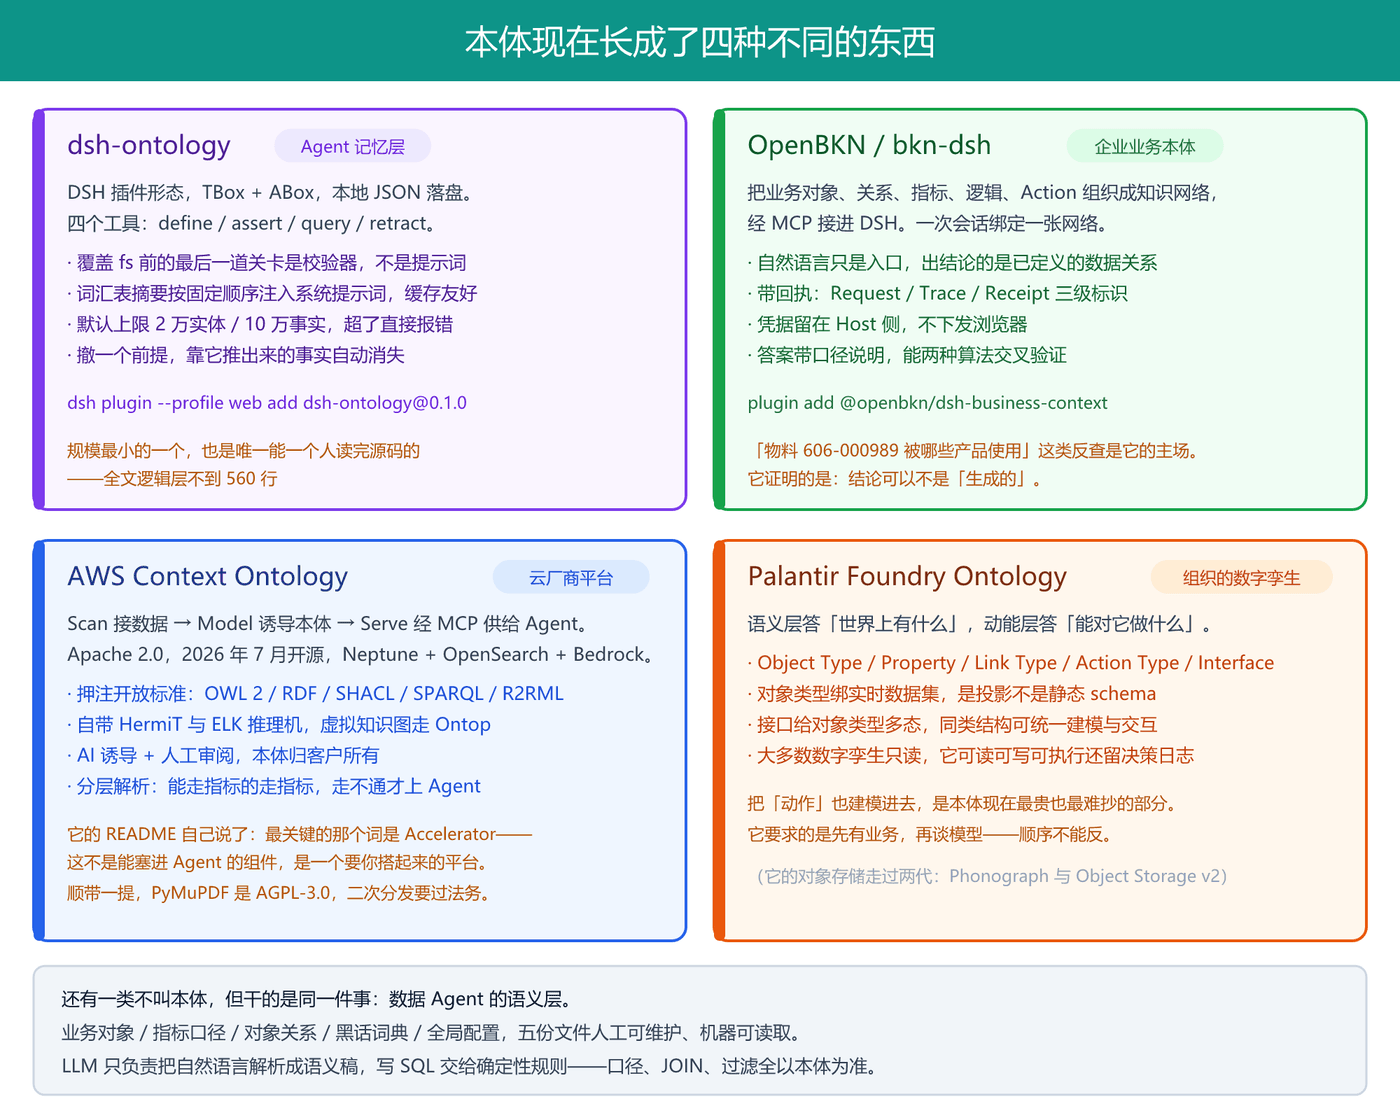
dsh-ontology 是 Agent 的记忆层。规模最小,一个人能读完源码,逻辑层不到 560 行。它的价值不在于推理能力有多强(其实只有 inverse / symmetric / transitive 三条规则),而在于它把「约束」这个动作放到了落盘之前的最后一道关卡上。
OpenBKN 是企业业务本体。它把业务对象、关系、指标、业务逻辑和 Action 组织成一张知识网络,通过 MCP 接进 Agent,一次会话绑定一张网络。它的公开演示里有个细节很能说明设计取向:Agent 回答「物料 606-000989 被哪些产品使用」时,不是凭语言概率生成产品编码,而是调用供应链平台里已经定义好的「物料反查产品」能力去查 BOM 数据——自然语言只是入口,产生结论的是知识网络里经过定义的数据关系和函数。
它的答案同时说明口径:分别用「含替代料分支」和「仅主 BOM」两种方式验证,结果一致。而且带回执——每次工具调用都有 Request / Trace / Receipt 三级标识,可以在「业务溯源」里逐条查看。凭据留在 Host 侧,不下发浏览器。
AWS Context Ontology Accelerator 是云厂商的平台。2026 年 7 月 28 日开源,Apache 2.0,架构是 Scan(接数据源、发现 schema、摄入文档)→ Model(AI 诱导本体草稿、领域专家审阅、定义受治理的指标)→ Serve(SPARQL 联邦查询虚拟知识图、经 MCP 供给 Agent)。
它押的是开放标准:OWL 2、RDF、SHACL、SPARQL 1.1、R2RML,自带 HermiT 和 ELK 两个推理机,虚拟知识图走 Ontop。技术上这是一套 2000 年代就开始沉淀的栈,AWS 做的是把它和 MCP 接起来。
要提醒一点:它的 README 里说「AI 辅助诱导 + 人工审阅」,但真正花时间的部分——谁有资格定义本体、不同部门对同一个概念的冲突说法怎么裁——它没解决。项目的名字里最关键的一个词是 Accelerator。这不是一个能塞进 Agent 的组件,是一个要你搭起来、配 CDK、带控制面和 RBAC 的平台。另外 PyMuPDF 是 AGPL-3.0、owlready2 是 LGPL-3.0,做二次分发的话这两个是要过法务的。
Palantir Foundry 是组织的数字孪生。它比前面三个都多一层:语义层回答「世界上存在什么」(对象类型、属性、关联类型、接口),动能层回答「能对它做什么」(Action 类型、函数、动态权限)。对象类型绑定实时数据集,每个对象是底层数据的实时投影,不是静态 schema。
它和其他三个最本质的区别在这里:大多数数字孪生是只读的,而 Foundry 的本体可读、可写、可执行,还记录决策。把「动作」也建模进本体,是这套东西现在最贵、也最难被抄走的部分。它要求的是先有业务、再谈模型,顺序反过来做不成。
还一类不叫本体,但干的是同一件事:数据 Agent 里的语义层。有团队把它拆成五份结构化文件——业务对象、指标口径、对象关系、黑话词典、全局配置——人工可维护、机器可读取。整个链路里 LLM 只负责把自然语言解析成一份业务语义稿,写 SQL 交给确定性规则。口径、JOIN 键、过滤条件全部以本体为准,任何模块都不许自己发明。语义稿里一旦出现物理表名或字段名,直接判格式错误拒掉。这套做法的收益很直接:换业务主题只替换那五份文件,引擎代码零改动。
与 RAG 的对比,差别在成本落在哪一刻
很多人把本体理解成 RAG 的升级版。这个理解是错的。它们的核心差异在成本落在哪个阶段,以及失败时是什么样子。
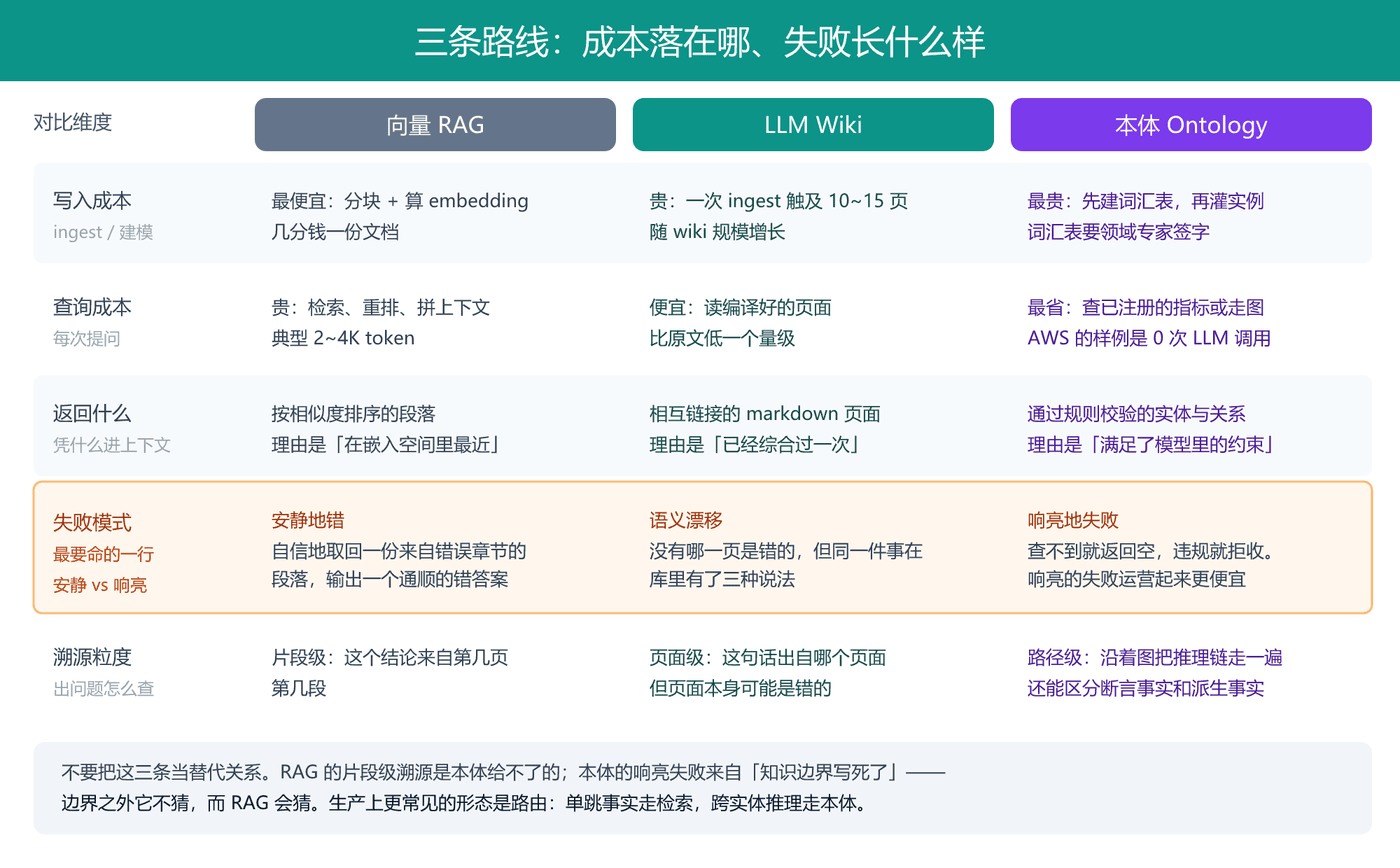
RAG 把成本放在查询侧。写入极便宜——分块、算 embedding、进索引;代价是每次提问都要重新检索、重排、拼上下文。本体的成本结构完全反过来:建模阶段极贵(要人来定义词汇表、画关系、写口径),查询阶段极省。
省到什么程度可以看 AWS 的公开例子:查一个受治理的偿付能力指标,路径是「0 次 LLM 调用、14 毫秒、确定性来源」。这不是营销话术,是因为这个查询根本不需要模型——它已经被编译成一条确定性 SQL 了。
但真正值得琢磨的不是成本,是失败模式。
RAG 失败的时候是安静的。它按相似度取回一段来自错误章节的文本,模型据此写出一段通顺的错答案。整条链路上没有任何一个环节发出声音。
本体失败的时候是响亮的。查不到关系就返回空,违规就当场拒收。它不会给你一个「看起来还行」的答案。
响亮的失败运营起来便宜得多,这是把语义层垫在 Agent 下面最强的一条理由——尤其是当这个 Agent 碰到钱或合同的时候。
这条优点的来源同时也是它最大的缺点:本体之所以不猜,是因为它的知识边界被写死了。边界之外的东西它答不了,而 RAG 会猜一个。同一个机制,从两个方向看就是优点和缺点。
需要一起看的还有反方证据。这条路线不是无脑赢的。GraphRAG-Bench(ICLR 2026)测出基于图的检索在 Natural Questions 上比普通 RAG 低 13.4%,时间敏感的查询低 16.6%;上下文相关性一项,图方法落在 36.86%~54.61%,而普通 RAG 是 62.87%。MultiHop-RAG 上更硬的一条:只有约 65.8% 的答案实体真的出现在构建出来的图里——图建漏了三分之一,后面再怎么优化遍历都找不回来。
性能反超的案例同样存在,而且数字很硬。微软的 OG-RAG 把领域本体做成超图来约束检索,事实召回比标准 RAG 高 55%,答案正确性高 40%,跨四个模型都成立,同时归因速度快 30%;苹果的 ODKE+ 用本体片段约束开放域抽取,幻觉抽取下降 35%,精度从 91% 提到 98.8%;还有一项临床信息学的 2026 年研究,用本体约束的 RDF 图加 SPARQL 问答,把幻觉降低了 61%。
把这些放一起,能看出一条很清楚的规律:本体在有强 schema 的领域赢,在开放域上输。前者的知识关系是稳定的、可枚举的;后者你连该建哪些类都说不清楚。
业界的做法也在往中间收。现在比较一致的共识是路由——单跳的事实查询走检索,跨实体的推理查询走图,用一层轻量分类器按查询类型分发。arXiv 上 2025 年的一项系统评测给出两种混合策略(按类型选择、双路并行再融合),都稳定优于任何单独一种。还有一条 2026 年的行业分析值得引用:72% 到 80% 的企业 RAG 实现没能走到生产,图构建开销是其中一个反复出现的贡献因素——抽取流水线会产出幻觉出来的实体和关系,而那些错误结构需要昂贵的人工修正。
与 LLM Wiki 的对比
LLM Wiki 这条路线我在上一篇文章里详细测过。它和本体的差别,用一句话说就是约束的强度差了好几个量级。
LLM Wiki 让模型把源材料编译成互相链接的 markdown 页面,靠一份写在 CLAUDE.md 里的规程来约束行为。这份规程能让模型成为一个有纪律的 wiki 维护者,但它终究是建议。模型这一轮决定把某个概念建到 A 页,下一轮换了一批上下文页面,同样的概念可能建到 B 页去了。规程里写着「每个实体页必须有 summary 段」,模型可能遵守;规程里写着「不要在定价策略上出现三种说法」,这条没法机械检查,模型也无从知道自己违反了。
本体的约束是另一回事:它是代码。类没声明过,ontology_define 之前的引用一律拒收;关系的域不匹配,报错直接把实体的有效类列表打出来。fs 之前的最后一道关卡是校验器,不是提示词——提示词是请求模型配合,校验器是直接不让过。
这个差别的实际影响体现在三件事上。
第一,错误能不能被拦住。LLM Wiki 里模型在 ingest 阶段错误关联了两个概念,这条错链会在多个页面被反复强化,后续 ingest 还会在错误关系上继续叠加——错误是织进结构里的,事后只能靠专门审计去捞。本体里同样的错误根本进不去库。
第二,矛盾能不能被发现。LLM Wiki 有个我自己实测到的硬伤叫语义漂移:没有哪一页是错的,但同一件事在库里有了三种说法。本体天然不会有这个问题——如果你把「一个实体只能有一个归属」声明成 functional 关系,第二次赋不同的值会直接被拒:
functional-conflict: X 是 functional 的,且已有 Y;
retract that fact first第三,撤回干不干净。LLM Wiki 里删掉一个概念,引用它的那些页面会留下悬空链接(它的 lint 会报 broken wikilink,但那只是提示,不会替你改)。本体里撤一个实体,所有提到它的三元组一起走;撤一个类,如果还有实体属于它或者有关系的签名里用到它,撤回动作会被拒,要求你先清依赖。
但本体相对 LLM Wiki 也有实打实的劣势,而且不是工程问题:
人写不了。LLM Wiki 的产物是 markdown,任何人打开就能读能改能立刻看到效果。本体的产物是一份词汇表,改它需要理解域、值域、基数和关系特征——这是数据建模的技能,不是写文档的技能。
它不能容纳模糊。真实世界里有大量「大概是这样」「看情况」的知识。LLM Wiki 可以把这些留在页面里并标注为待确认,本体只能把它们排除在外或者勉强建模——而勉强建模出来的东西比不建模更糟。
它对演进不友好。LLM Wiki 加一个新主题就是加一个新页面;本体加一个新类可能要回头检查所有已有关系的签名。Cyc 项目四十年前就掉进过这个坑。
本体的真正成本
要理解本体的成本,绕不开 Cyc。
1984 年,Doug Lenat 启动了这个项目,目标是把人类的常识一条条编码进一个逻辑数据库。团队用自己发明的 CycL 语言,几十年里输入了上百万条断言。他们撞上的那堵墙,每个做数据的人最后都会撞上:矛盾。
如果他们写一条「人不能同时出现在两个地方」,这对工资系统成立,但对「旅行的逻辑」或者「虚构作品」的模型就崩了。每一次他们想立一条「全局真理」,就会打破一些「局部真理」。最后的解法是发明 micro-theories——把大脑的不同部分隔开,不再追求全局一致。
这个教训今天还在生效,只是换了个形式。有位数据从业者说得比大多数论文都准:语义是相对你的数据模型定义的,本体讲的却是真实世界。真实世界有超出定义之外的复杂性。
具体到落地,你会在四个地方被人问到,而它们都没有纯技术解法:
谁有权定义。本体一旦成为 Agent 的事实来源,定义本体就是在分配权力。同一个词在销售、财务、法务嘴里是三件事——「营收」在销售那里是下单金额,在财务那里要等收款、退货、取消都结束。你选哪个作为标准口径,另外两个部门的报表就会出现解释不了的差距。
谁来消解矛盾。两个部门按各自的理解往同一个本体里加类,早晚会出现语义冲突。谁拍板?
谁来审计。非法断言会被校验器拦住,但合法而错误的断言拦不住。如果 depends_on 的域和值域都声明对了,你断言了两个其实没有依赖关系的组件,本体无法发现。这是和 LLM Wiki 一样的病,只是发作得慢一些。
谁能跟上变化。业务变了,本体要跟着改;本体改了,已经断言的事实要重新校验;重新校验完,可能发现一批历史数据不合规了。
AWS 那个项目想解决的问题是「人写本体太慢」,所以用 AI 诱导草稿、人来审。这个方向是对的,但它解决的是速度,不是权力。它对「谁有权定义」的答案是「平台管理员 + 数据管家 + 命名空间隔离」——这是个技术方案,真实的组织问题还是在组织里解决。
还有一条成本容易被忽略:边界外一定存在真实问题。Cyc 时期的批评到现在依然准确——如果一个问题涉及的概念在词汇表里不存在,你会得不到任何返回,然后你得退回去用一个文档检索工具,跟以前一样。本体的能力强依赖于你知道自己会遇到什么问题。
什么场景该用、什么场景别用
把上面的结论收成两张清单。
值得上的场景:
- 领域关系稳定、可枚举,而且跨文档连接本来就是必需的(供应链上下游、BOM、组织架构、设备台账、合同与条款)。
- 错误的代价不对称——答错比答不出贵得多:合规、风控、医疗决策支持、财务口径。
- 需要回答「为什么是这个答案」,而且要把推理链走给人看。
- 同一个人高频重复问同类问题,且必须每次答案一致。
- 你已经有数据治理的组织能力,有人能承担「定义本体」这个角色。
别上的场景:
- 开放域问答、面向任意用户的搜索。你连该建什么类都说不出。
- 语料每天大量新增、要求准实时可用。本体要求你先建模再灌数据,顺序反了做不成。
- 查询以单跳事实为主。这类查询普通 RAG 持平或更好,图只会增加延迟和 token。
- 需要的是「把我的笔记搜出来」,不是「让知识之间长出关系」。
- 团队里没人愿意当那个定标准并负责执行的人。缺了这个角色,本体只会变成又一个没人维护的文档。
还有一条容易被忽略的:LLM Wiki 那篇文章里我列的天花板——规模和语义漂移——本体也躲不掉,只是换了个形态。规模问题变成了「词汇表膨胀到没人能整体理解」,漂移问题变成了「同一个概念被不同的人反复重定义」。这些都是组织问题披着技术问题的外衣。
怎么落地
如果决定动手,我建议的顺序是这样,每一步都以「能不能证伪」为退出条件。
第一步,只建词汇表,不灌任何实例数据。拿出两页纸,把类、关系、关系的域和值域写清楚——用自然语言写也行,关键是让领域里的人能读懂并反驳你。这一步不写一行代码,但它决定了后面所有收益的上限。写完请业务方看一遍:如果他们指着某个类问「那个东西为什么不算」,你就找到了建模的边界。
第二步,故意往里面塞错数据。这是我认为最被低估的一步。拿你写好的词汇表,手工构造一批应该被拒的断言:域不匹配的、指向未定义实体的、违反基数的。看校验器是不是真的拦住了,报错信息是不是能让一个模型自己改对。如果报错只说「不合法」不说「哪里不合法」,这套东西在 Agent 循环里就用不起来——模型没法自我修正。
我做 dsh-ontology 实测的时候专门做了这件事,四条故意写错的断言全部被拦,而且每条都给出了修正方向。这一步应该成为选型时的硬指标。
第三步,只接一条链路,而且是查得最频繁的那条。别一上来就想着给整个企业建本体。选一个具体问题——「某个零件被哪些产品用到」这种——把它端到端打通:数据接进来、词汇表覆盖它、Agent 能查、答案带口径说明。跑通了再想扩。
判断跑通的标准是两条:答案对不对,以及出错的时候你知不知道它错了。第二条比第一条重要。
第四步,把「谁来改词汇表」定下来。前面三步都是技术活,这一步是组织活,而且它决定这套东西能活多久。最小可行的做法:词汇表的变更走代码评审,每条变更必须有一个责任人,变更记录和理由留档。听着很重,但比起两年后没人说得清某个类为什么这么设计,这点流程成本是便宜的。
关于选型。如果是给单个 Agent 做记忆,dsh-ontology 这种轻量插件是对的起点——几十 KB 的包,逻辑层不到 560 行,装完就能用,没有基础设施。要注意它目前在插件验证体系里 L5 运行时那一栏是没过(duplicate loader entry id、HTTP 端点没起起来),L1–L4 是过的,所以集成前最好自己在目标版本上装一遍确认。另外互逆关系要拆成两次调用声明,这个坑我上面写了。
如果需要的是企业业务语义,看 OpenBKN 这类——它已经把业务对象、指标、Action 和溯源做进去了,接的是 MCP,Agent 侧几乎不用改。
如果准备长期投入并且要跨系统的可移植性,AWS COA 那条开放标准的路子值得评估,但要清楚你买的是一个平台:CDK 堆栈、控制面、RBAC,还有两个 copyleft 依赖要过法务。
如果是组织的整体数字孪生、而且连「动作」也要建模,那就只有 Foundry 这一档的选择——代价是要先有业务,再谈模型。
最后一句判断。本体不是 RAG 的替代品,也不是 LLM Wiki 的替代品——它们固定知识的时刻根本不在同一个位置。RAG 从不定,查询时才判断相关性;LLM Wiki 在写入时综合,但结构是自由的;本体在建模时就固定了「允许存在什么」。三者的成本、失败模式、能回答的问题类型都不一样,混着用、按查询路由,比选一个更接近正确的答案。
参考资料
- tancheng33. dsh-ontology. npm / GitHub, 2026-08. https://www.npmjs.com/package/dsh-ontology
- dsh.so. dsh-ontology 验证与兼容性记录. https://www.dsh.so/artifact/dsh-ontology
- 0xsline. Awesome DeepSeek Harness. GitHub. https://github.com/0xsline/awesome-deepseek-harness
- OpenBKN. bkn-dsh:把业务本体带进 DeepSeek Harness. https://github.com/openbkn-ai/bkn-dsh
- OpenBKN. bkn-foundry. GitHub. https://github.com/openbkn-ai/bkn-foundry
- Amazon Web Services. Context Ontology Accelerator. GitHub, Apache-2.0, 2026-07-28. https://github.com/aws/context-ontology-accelerator
- AWS. Amazon Web Services now introduces Context Ontology Accelerator. What’s New, 2026-07. https://aws.amazon.com/about-aws/whats-new/2026/07/aws-context—ontology-accelarator-generally-available
- Palantir. Ontology architecture. https://www.palantir.com/docs/foundry/object-backend/overview
- Palantir. Foundry Ontology 核心概念. https://palantirfoundation.org/docs/foundry/ontology/core-concepts
- Sharma, K., Kumar, P., Li, Y. OG-RAG: Ontology-Grounded Retrieval-Augmented Generation for Large Language Models. arXiv:2412.15235, Microsoft Research, 2024.
- Apple. ODKE+: Ontology-grounded open-domain knowledge extraction. arXiv:2509.04696, 2025.
- GraphRAG-Bench. ICLR 2026.(图检索在单跳与时间敏感查询上的劣势数据)
- RAG vs GraphRAG: a systematic evaluation. arXiv, 2025.(混合检索策略的对比)
- Huzard, D. After the knowledge graph — ontology-grounded LLMs, GraphRAG, and statistical discovery. Neuronautix, 2026-05. https://neuronautix.com/presentations/2026-05-after-the-knowledge-graph
- What Is an Ontology? From Aristotle to Enterprise AI. Tesseract Academy. https://tesseract.academy/courses/ontology-training-knowledge-graphs-complete-course
- dlthub. So you vibe coded a data stack, now what?(关于语义与本体之别、Cyc 的回溯) https://dlthub.com/blog/unvibe
- Knowledge Graphs Are Back: Why RAG Teams Are Adding Structure to Their Retrieval. 2026-04. https://tianpan.co/blog/2026/04/13/knowledge-graphs-are-back-why-rag-teams-are-adding-structure
- NATO STO. Custom Ontologies for Expanded Network Analysis. RTO-MP-IST-063.(大规模本体的维护与查询退化问题)
- 本博客前一篇:LLM Wiki 深度评测. https://www.zicode.com/
本文的实测部分在 Windows 上用 Node.js 22.22.2 与
dsh-ontology@0.1.0完成。该插件的运行依赖 DSH 运行时(Cordis、dsh-storage、dsh-tools 等),所以我做了拆分:只取包内独立导出的纯逻辑层模块(不依赖任何运行时依赖),用一份手工构造的 GraphView 喂给它,跑通十项用例——TBox 类声明(含先引用后声明的多遍推进)、互逆关系的分步声明、字面值关系健全性校验、子类环检测、ABox 实体与事实断言、域/值域越界拒收、传递闭包推理、子类感知查询(双向闭包)、邻域遍历与最短路径、前提撤回与派生事实自动消失,外加 TBox 摘要渲染与统计。有一点值得单独说明:我第一版脚本只重试三遍就宣布「多遍应用能自愈先引用后声明」,结果
HttpService没建成,后续依赖它的用例全部连锁失败,邻域和路径都返回空。把重试次数提到八遍并记录逐遍推进情况之后,才拿到干净结果,也才发现遍数其实由依赖链深度决定。文中所有拒绝信息、推理输出、查询结果均为修正后的实际运行结果。插件的工具层——四个工具的参数解析、持久化、系统提示词注入——依据其源码与包内
cordis.patch.yml配置说明,未在 DSH 里实际安装执行。
微信公众号
欢迎关注「字与码」
如果这篇文章对你有用,也欢迎在微信里继续关注后续更新。
X / Twitter
关注 @ax2_zicode
更即时的技术观察、新文章提醒和一些短想法会发在 X 上。