开源大模型全景:六个场景、五档硬件
本文完全由 WorkBuddy 独立收集资料、调试代码并完成文章写作。
我是 Alex Xiang,前百度/微博工程师,现在专注于 AI 工程与工具产品。更多文章欢迎关注微信公众号「字与码」。
2026 年 10 月的开源权重榜,前十名全部来自中国机构:小米、DeepSeek、智谱、月之暗面、阶跃、阿里。Meta 用 Muse Spark Open 把美国开源的最好成绩推到 38.9 分,仍比第一名低 7.4 分。
但排行榜只回答「谁最聪明」,不回答「我能不能用」。同一份榜单上,最贵的开源模型每任务 2 美元,最便宜的 0.13 美元,差 15 倍;能装进 24GB 显卡的和要 16 张 H200 的,也在这同一张表里。
所以这篇按另外三条线重排一遍:它能干什么活、它多大、它跑在哪台机器上。
先说清楚「开源」在 2026 年是什么意思
今年的「开源」已经分裂成三层,选型第一步不是看榜,是把许可证读完。
第一层是真许可。MIT 有 DeepSeek V4.1-Flash、MiMo-V2.6-Pro、GLM-5.3-Flash、GLM-OCR;Apache 2.0 有 Qwen3.8-27B、Gemma 4、gpt-oss、Wan 2.2、Kokoro-82M、PaddleOCR-VL。这一层的商用条件最干净。
第二层是社区许可,权重能下,但绑了条件。GLM-5.3 用的是自家条款,年营收超过 100 亿美元的「模型即服务」厂商要先把安全审查过一遍;Kimi K3 是带条件的 Modified MIT;Meta 的 Muse Model License 更具体——产品里必须显示「Built with Muse Spark Open」,把它当托管服务卖且年营收超 2000 万美元,得提前通知并单独签约。
第三层是研究专用,下了权重也不能进产品。Qwen-Image 2.1 Turbo 的许可证第一行就写着「FOR NON-COMMERCIAL PURPOSES ONLY」,自部署商用要单独谈;FLUX.2-klein-9B 同样是非商用。
还有个反向的极端:Ai2 的 Olmo 3.1 把训练数据、代码、checkpoint 全公开了,这种在 2026 年反而成了少数派。
通用与编程:差距集中在最难的题
按 Artificial Analysis 智能指数 v4.3.2(10 月 20 日口径),开源前四名是 MiMo-V2.6-Pro 46.3、DeepSeek V4.1-Flash 45、GLM-5.3 44.8、Kimi K3 43.6;闭源那边 GPT-6 Astra 53、Claude Opus 5.5 57.6。
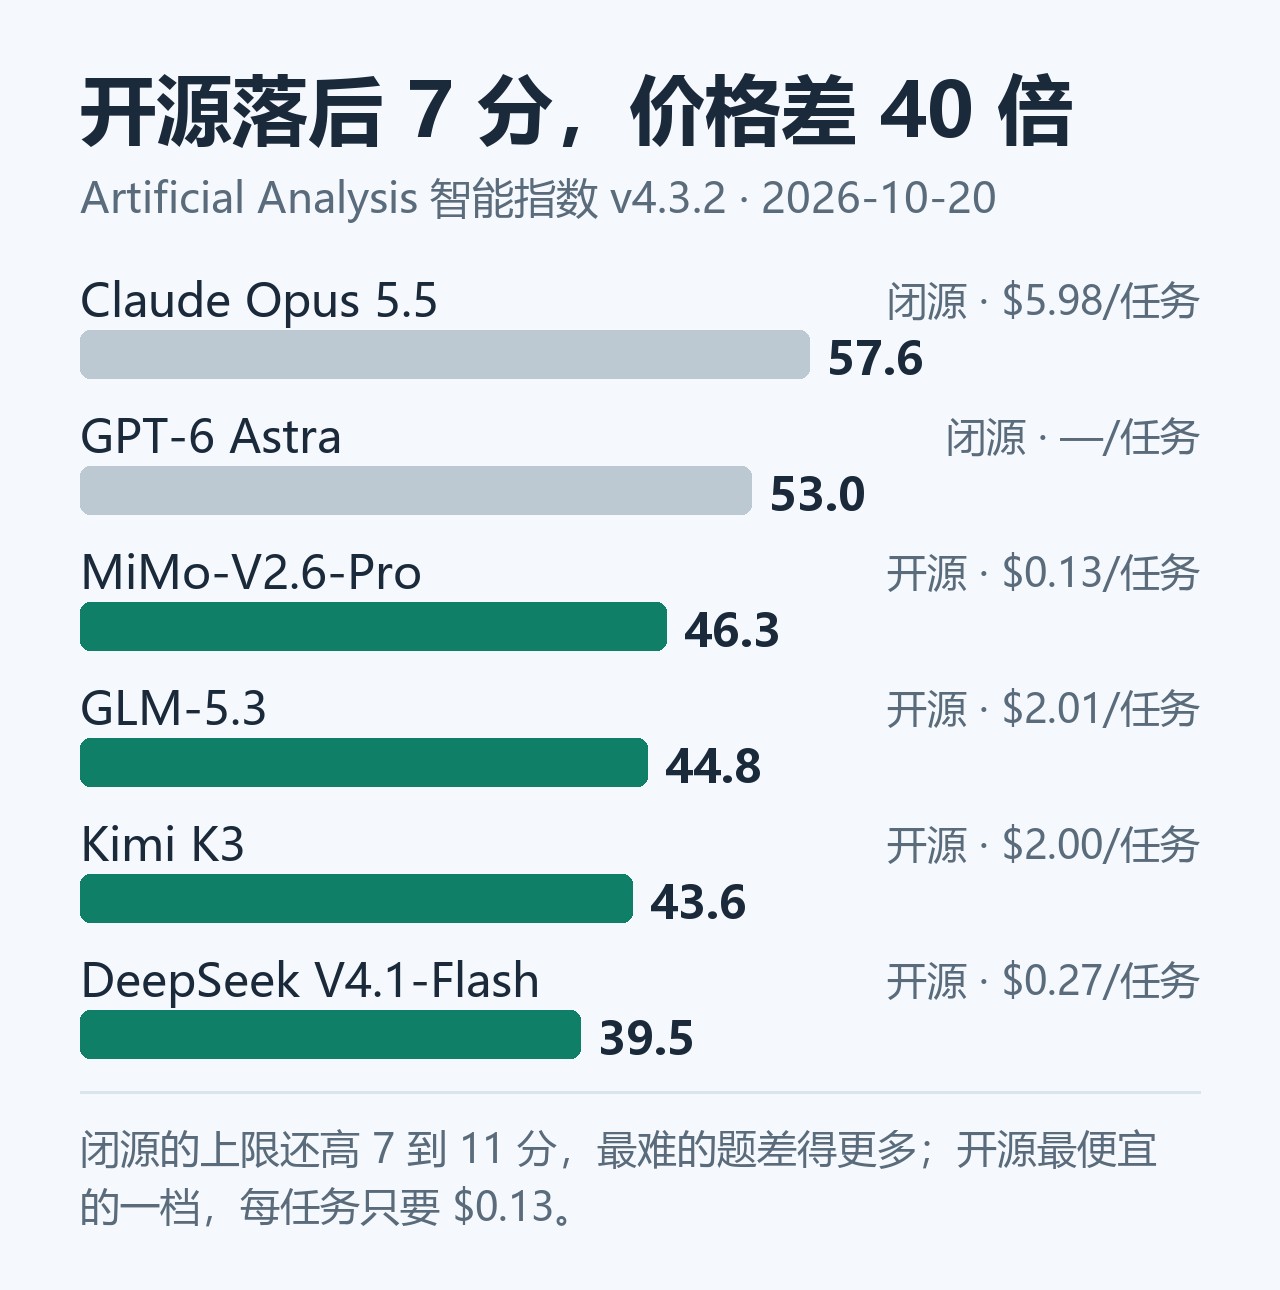
7 分的差距看起来不大,但拆到分项就露馅了。「人类最后的考试」开源头部 34% 到 36%,闭源 44% 到 45%;研究级物理推理 CritPt,开源头部 4% 到 12%,闭源旗舰拿过 27%。越是需要长链推理的题,差得越开。
有人做过一次更细的复核:把 18 项基准逐一重算,两年来的平均差距稳定在 5 个月左右,几乎没收窄。综合曲线看起来在追平,是编程一项突飞猛进把整条线拉上去的。
编程确实是开源最接近前沿的一格。Kimi K3 在 Vals AI 独立测的 SWE-Bench Verified 上解掉 93.4% 的 issue,Claude Opus 5.5 是 97.0%,4 个点;Terminal-Bench 2.1 拿到 80.90%。GLM-5.3 把 DeepSWE v1.1 的成绩从 46.2 推到 66.9,只用了两个月。DeepSeek V4.1-Flash 在 Arena WebDev 是开源第一,Agent Arena 上开源第一、总榜第 11,每任务中位成本 0.20 美元。
性价比这条线开源赢得更彻底:帕累托前沿上的 13 个模型,开源占 9 席,同等智能水平下价格是闭源的六分之一到一半。MiMo-V2.6-Pro 每任务 0.13 美元,Opus 5.5 是 5.98 美元。
图像与视频:许可证比参数更能决定能不能用
图像这一层,10 月刚换过一轮牌。
Black Forest Labs 的 FLUX 3 Image Klein 是 5.6B,10 月 15 日放出,主打原生 4K、坐标框排版、十张参考图,INT8 在 8GB 消费卡上能跑。阿里 10 月 9 日的 Qwen-Image 2.1 Turbo 参数更多(7B)、步数更少(8 步)、还支持生成透明 RGBA,规格表上几乎项项赢。
但许可证反过来:Klein 是 FLUX Kommunity License,年营收 500 万美元以下的个人和公司可以直接商用;Qwen-Image 2.1 Turbo 的权重只能用于研究和评估。对一个独立开发者,这一条比参数表决定得更早。
视频也一样。Wan 2.2 是 Apache 2.0——27B MoE、14B 激活,5B 的 TI2V 版本能在 24GB 的 4090 上跑 720p 24fps,是唯一没有附加条件的全能选择。腾讯的 HunyuanVideo 1.5 硬件门槛最低,8.3B 配 3D 因果 VAE,14GB 消费卡就能出 480p 或 720p、121 帧,但它的社区许可把欧盟、英国、韩国排除在外。Lightricks 的 LTX-2.3 是唯一在模型内部同步生成音频的(22B),商用门槛设在年营收 1000 万美元。
一句话:这一层「能下到权重」和「能拿它做生意」是两件事。
音频与文档:两个小模型赢大模型的样板
音频是开源最不用纠结的领域,因为前沿模型的优势在这个尺寸上根本展不开。
语音识别,Qwen3-ASR-1.7B 在八套英文测试上平均词错 5.76%,覆盖 52 种语言和方言,Apache 2.0;NVIDIA 的 Parakeet TDT 0.6B v3 是 6.32%,但实时因子 3333——一张卡一秒能转完一小时音频。Whisper large-v3 在英文上已经被大约十个开源模型超过,可它有 99 种语言和 MIT,仍然是多语种场景的默认答案。
语音合成更极端。Kokoro-82M 只有 8200 万参数,首字延迟 120 毫秒,笔记本 CPU 就能跑。Qwen3-TTS 的韵律明显更好,首字延迟 2621 毫秒。对语音助手来说,120 毫秒还在人类觉得「它在想」的范围内,2.6 秒就是「坏了」——这个数字比任何榜单排名都重要。
文档解析是今年最反直觉的一格。
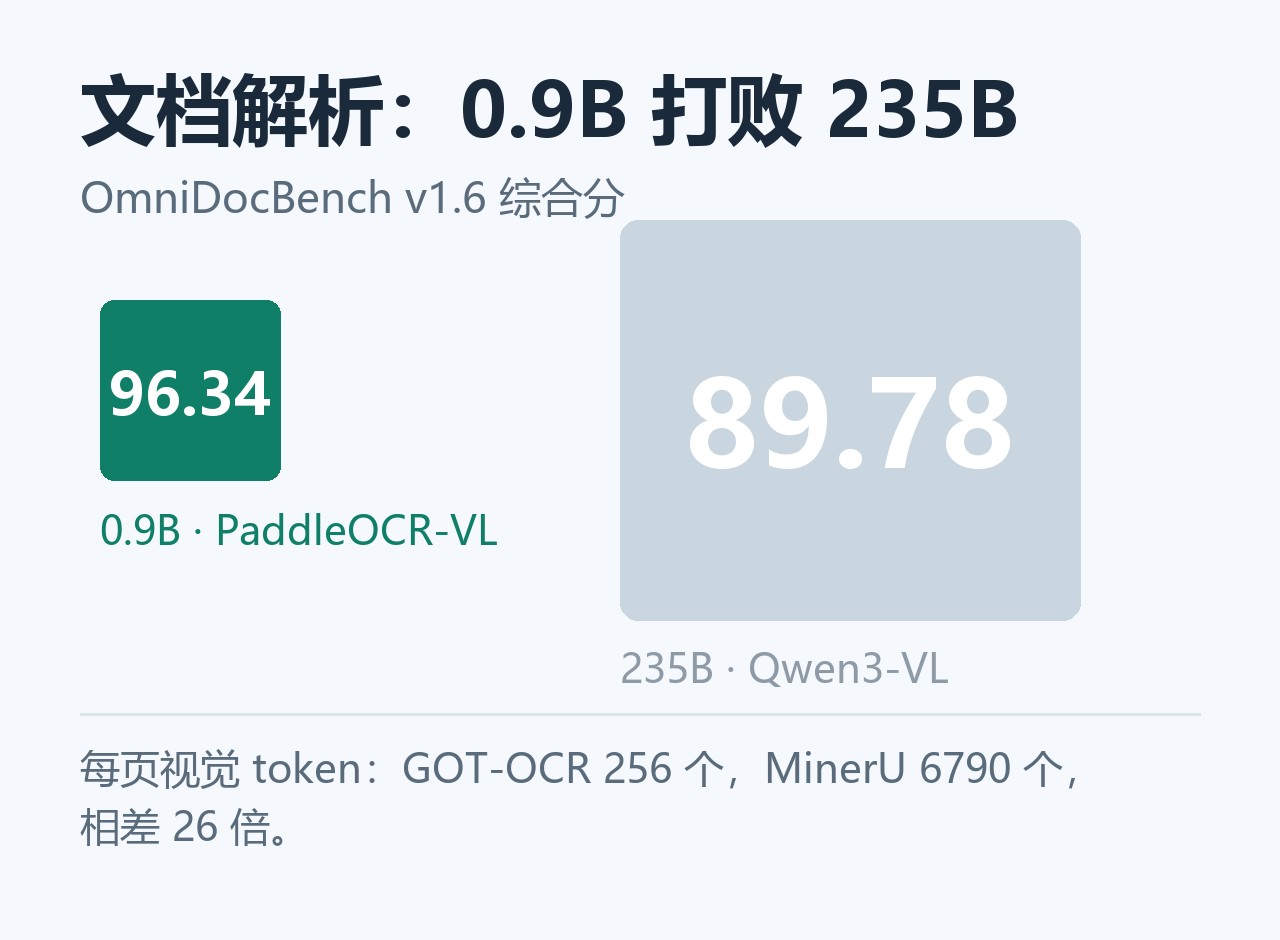
百度 PaddleOCR-VL 1.6 只有 9 亿参数,在 OmniDocBench v1.6 上拿 96.34,Apache 2.0;上海 AI 实验室的 MinerU 2.5-Pro 是 1.2B、95.75,但权重是 AGPL-3.0,接进 SaaS 产品要过法务;智谱 GLM-OCR 0.9B、95.22。而通用的 Qwen3-VL-235B 在同一个榜上是 89.78——参数多 260 倍,分数低 6.5 分。
代价藏在别处。每页纸的视觉 token,GOT-OCR2.0 固定 256 个,MinerU 2.5 平均 6790 个,差 26 倍。这些 token 会占满上下文、吃满 KV cache、决定一张卡能塞几页。批一万页文档时,这个倍数直接换算成你要买几张卡、跑一晚还是跑三天。
看这类分数还得留个心眼:OmniDocBench 有 v1.0、v1.5、论文版、v1.6 好几个版本,页数和题型都不同,把它们排进一张表会排出假名次。引用前先问三句:哪个版本、多少页、谁测的。
规模与设备:从 2.6GB 到 1.5TB
这一节是最容易踩坑的地方,因为「参数」和「显存」之间的关系被 MoE 搞乱了。
手机和嵌入式这一档,看的是 Gemma 4 的两个小号:E2B 在 LiteRT-LM 里 2.58GB,E4B 3.65GB。实测数据挺能说明问题——Galaxy S26 Ultra 上 prefill 约 3808 token/s、decode 约 52 token/s;iPhone 17 Pro 是 2878 和 56;到了树莓派 5,prefill 掉到 133、decode 只剩 8。同一份权重,设备换了,体验差 20 倍。国内这条线有阿里的 MNN,3.6.1 加了高通 Hexagon DSP 后端,骁龙 8 Elite 上跑 Qwen3-0.6B 的 W4 量化,prefill 到 2667 token/s。
普通电脑这一档,今年终于有了像样的选择。Meta 的 Muse Glimmer 30B 是 29.6B 稠密模型,Apache 2.0,4-bit 之后约 17GB,一张 24GB 消费卡就够,带图像输入和多步工具调用。
单卡工作站的天花板是 Qwen3.8-27B。稠密 27B、262K 上下文、Apache 2.0,FP8 权重 28.8GB,48GB 卡能装下。有人在 L40S 上实测:18.6 token/s 单流、可用上下文定在 172K;RTX 3090 上换 INT4 能到 38.4 token/s。再往上,gpt-oss-120b 是 117B / 5.1B 激活,单张 80GB 的 H100 能跑完。
小服务器这一档开始进入「双卡」的领域:DeepSeek V4.1-Flash 是 552B / 16B 激活,4-bit 约 155GB;GLM-5.3-Flash 320B / 18B,约 160GB;MiMo-V2.6-Flash 309B / 15B,约 170GB。都要两张 80GB 或者一台大内存统一内存机器。
集群这一档,数字变得不太像消费级产品:MiMo-V2.6-Pro 1.02T / 42B 激活,4-bit 约 560GB,四张 B200;GLM-5.3 753B,约 400GB,四张 H200;Kimi K3 2.8T / 104B,官方 MXFP4 checkpoint 1560GB,16 张 H200,租用价每小时 91.2 美元。
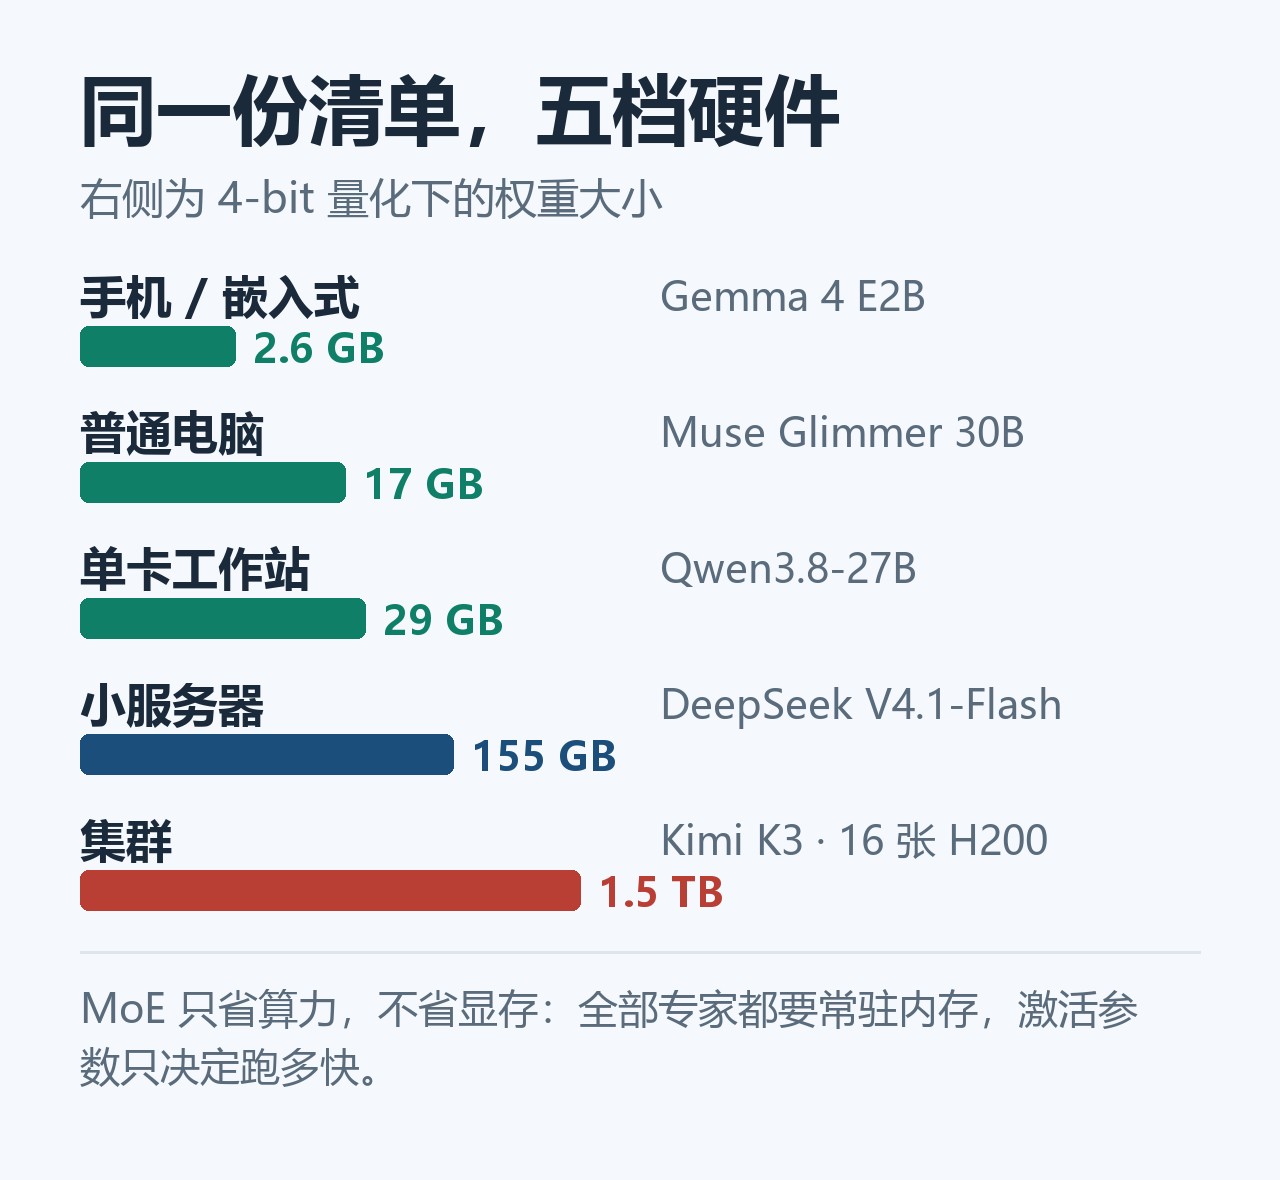
这里有个必须说清的事实:MoE 只省算力,不省显存。 稀疏激活让每个 token 只用一小部分专家,速度上去了,但全部专家的权重仍然要常驻内存。Kimi K3 的 Q4_K_M 文件是 1508.67GB,加上 4K 上下文的 KV cache 是 1522GB。你手上的 512GB Mac Studio 装不下——连 1-bit 的 IQ1_S(567GB)都差 55GB。能塞进去的只有砍掉 80% 专家的 REAP80 版本(350GB),那已经是另一个模型了。
量化也不是免费的。2-bit UVMAX 是 817GB,Q2_K 是 929GB,每降一档都在拿质量换容量。而且解码头是带宽瓶颈:双路 EPYC 7532 的 341GB/s 带宽,在 Q2_K 下理论天花板只有约 9 token/s。买得起容量,不等于跑得动。
按场景的选型表
| 场景 | 首选 | 许可证 | 最低硬件 |
|---|---|---|---|
| 通用 Agent | MiMo-V2.6-Pro | MIT | 约 560GB,多卡 |
| 编程主力 | DeepSeek V4.1-Flash | MIT | 约 155GB,双 80G |
| 长程 Agent | Kimi K3 | 自定义 | 1.5TB,16 张 H200 |
| 单卡自建 | Qwen3.8-27B | Apache 2.0 | 48GB |
| 消费卡本地 | Muse Glimmer 30B | Apache 2.0 | 24GB |
| 手机 / 嵌入式 | Gemma 4 E2B | Apache 2.0 | 3GB |
| 图像生成 | FLUX 3 Image Klein | 社区许可,营收 500 万美元以下可商用 | 8GB |
| 视频生成 | Wan 2.2-5B | Apache 2.0 | 24GB |
| 语音识别 | Qwen3-ASR-1.7B | Apache 2.0 | 单卡或 CPU |
| 语音合成 | Kokoro-82M | Apache 2.0 | CPU |
| 文档解析 | PaddleOCR-VL 1.6 | Apache 2.0 | 8GB |
把这张表和排行榜放在一起看,会发现它们几乎不重叠。
榜单前十里有七个模型,普通开发者在自己的机器上一个都跑不起来。而真正能被大多数人用上的那几个——Gemma 4 E2B、Qwen3.8-27B、Muse Glimmer、Kokoro、PaddleOCR-VL——在智能指数上排得很靠后,甚至根本没进榜。
这不是说榜没用,是说选型的顺序应该是:先读许可证,再看自己有什么机器,最后才看分数。倒过来做,你会花两周时间下载一个 1.5TB 的权重,然后发现那张卡装不下。
参考资料
- Artificial Analysis,开源权重智能指数 v4.3.2(2026-10-20 口径),https://artificialanalysis.ai/
- Taskade,10 Best Open-Source LLMs October 2026,https://www.taskade.com/blog/open-source-llms
- AI Magazine,Best Open-Source LLMs 2026,https://ai-magazine.com/best-open-source-llms
- Uvik,Best Open-Source LLMs for Enterprise 2026(10-13 数据),https://uvik.net/blog/best-open-source-llms
- Preuve,AI Coding Models Statistics 2026,https://preuve.ai/blog/ai-coding-models-statistics-2026
- Progressive Robot,Meta Unveils New ‘Open’ AI Model(Muse Spark Open 与许可证条件),https://www.progressiverobot.com/2026/10/16/meta-open-model-rival-chinese-open-weight-models
- Modelfit,Kimi K3 Weights Are Out: What It Takes to Run Them(权重文件实测大小),https://modelfit.io/blog/can-you-run-kimi-k3-locally/
- LocalModel.run,Kimi K3 requirements(Q4/Q8 显存与 KV cache 拆解),https://localmodel.run/model/kimi-k3
- Vantaige,LLM VRAM Calculator(各模型 4-bit 显存与单卡可行性),https://vantaige.io/zh/blog/vantaige-launches-the-llm-vram-calculator
- OrcaRouter,FLUX 3 Image Klein 对 Qwen-Image 2.1 Turbo(许可证与规格对比),https://www.orcarouter.ai/zh-TW/blog/flux-3-image-klein-vs-qwen-image-2-1-turbo
- AI in Context,Alibaba’s Qwen Releases 8-Step Image Model,https://aiincontext.com/articles/alibaba-s-qwen-releases-8-step-image-model-5x-faster-than-base-bedeaa84
- Techiehub,Best Open Source AI Video Generator(Wan 2.2 / HunyuanVideo 1.5 / LTX-2.3 许可与显存),https://techiehub.blog/best-open-source-ai-video-generator/
- Koncile,10 Best Open Source OCR Tools in 2026(OmniDocBench v1.6 榜单),https://www.koncile.ai/en/ressources/10-open-source-ocr-tools-you-should-know-about
- 六款开源 OCR 模型横评(每页视觉 token 与许可证),https://mp.weixin.qq.com/s?__biz=MzA3MTI3NzU4OQ==&mid=2454183690&idx=3&sn=b66cb9e81867cd8d6255f71f94fb9495
- Fora Soft,On-Device AI on Android: 2026 Build Guide(Gemma 4 体积与端侧运行时),https://www.forasoft.com/blog/article/neural-networks-on-android-369
- Learn AI,LiteRT-LM(手机、Mac、树莓派实测吞吐),https://ai.miraheze.org/wiki/LiteRT-LM
- 阿里 MNN 手机端大模型实践(骁龙 8 Elite 上 Qwen3-0.6B 的 prefill 数据),https://m.toutiao.com/article/7694201337847792155
- 声网,开发者搭一套实时语音 Agent 的开源工具,https://www.shengwang.cn/blog/blogdetail/voice-ai-stack-tools-2026/
- Local AI Zone,Text to speech & speech to text(开源 TTS/ASR 许可与延迟),https://local-ai-zone.github.io/blog/local-voice-models-2026.html
- Mihup,ASR Models: A Practical Guide 2026(八套英文测试的词错率),https://mihup.ai/blog/asr-models-guide
微信公众号
欢迎关注「字与码」
如果这篇文章对你有用,也欢迎在微信里继续关注后续更新。
X / Twitter
关注 @ax2_zicode
更即时的技术观察、新文章提醒和一些短想法会发在 X 上。