
在 Windows 上用 Unix 工作流:把 grep、管道和脚本带回日常
用一个排查线上日志和批量整理文件的真实流程,讲清楚如何在 WSL 里把 rg、jq、awk、fzf、make、cron/systemd timer 和 Windows 工具连成稳定工作流。
第 10 页。归档页按时间倒序展示,每页只加载一组文章封面,减少首屏压力。
用一个排查线上日志和批量整理文件的真实流程,讲清楚如何在 WSL 里把 rg、jq、awk、fzf、make、cron/systemd timer 和 Windows 工具连成稳定工作流。

从 xeyes、gedit 和一个远程窗口的例子讲起,拆开 X11、Wayland、XWayland、Weston 和 RDP 在 WSLg 里的分工,顺便解释为什么旧教程里的 DISPLAY 配置现在经常是反效果。

从一条 fim image.png 命令说起,拆一下 WSLg 为什么能把 Linux 图形程序直接显示到 Windows 桌面,以及它在图片预览、图像开发、X11 小工具里的日常用法。

一次在测试机上对 gemma4:12b 音频输入能力的实测记录:模型元数据声明支持 audio,但 Ollama 原生 /api/chat 不能可靠接收音频;真正可用的是 OpenAI 兼容接口里的 input_audio。

一次从官方资料到本地实测的记录:Gemma 4 12B 具备帧序列视频理解能力,但 Ollama 当前不能直接接收 MP4,稳定做法是先抽帧再多图输入。
A/B test 不只是前端页面实验。接口服务里的策略、排序、限流、供应商选择和成本控制同样需要实验纪律:稳定分桶、真实曝光、跨请求归因、护栏指标和实验收尾。

世界杯预测不是让大模型猜一个冠军。更靠谱的做法,是把历史赛果、球队强弱、进球分布、赛程模拟和临场信息放进同一套概率框架里,再诚实地展示不确定性。

浏览器 Agent 从能看网页走到能点按钮、填表单、提交操作,产品价值变大了,误操作和越权风险也同步变大。守护栏要比自动化能力先成熟。

Agent 系统不再只是写一段提示词。真正决定效果的,是如何选择、裁剪、排序和验证上下文,让模型在每一步拿到刚好够用的信息。

AI 产品比普通产品更依赖数据口径。数据契约不是多写一份文档,而是把字段、语义、质量、血缘和变更责任放进工程流程。

LLM 推理不是普通 HTTP 流量。GPU 资源、上下文长度、流式响应、队列延迟和模型版本,会让传统网关的负载均衡策略很快失效。

端侧 AI 不是云端大模型的缩小版。它关心的是延迟、功耗、隐私、缓存和产品边界,也需要开发者重新适应一套更贴近设备的工程约束。
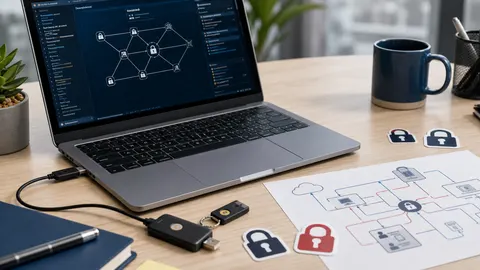
MCP 让 AI 应用接工具变得统一,但工具一旦能读文件、查数据库、发请求,安全问题就从接口规范变成了权限、身份、审计和供应链问题。
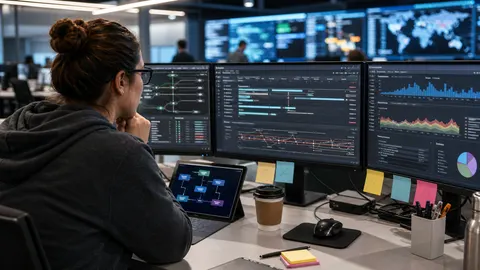
Agent 系统出错时,最终回答往往看不出原因。要调试生产 Agent,必须记录任务、工具、上下文、成本、重试和每一步证据。
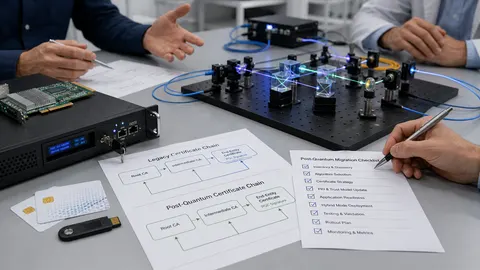
NIST 标准发布以后,后量子密码不再只是研究话题。真正困难的是资产盘点、协议兼容、供应商协调和长期的密码敏捷性。
RAG 系统上线后,关键不在能不能答,而在什么时候答错、为什么答错、错得有没有边界。评估要拆开检索、证据、生成和拒答。
插件系统最怕依赖地狱和权限失控。Wasm Component Model 把接口、能力和运行时边界标准化,为多语言插件和边缘运行提供了新的工程选择。
从 Codex app-server 的协议边界讲起,分析它适合嵌入哪些产品与工程场景,也比较 Claude Code、Cursor 在脚本化、云端 Agent 和自定义集成上的相近能力。