AI 辅助编程工具怎么选:补全、agent、云端三层评估
本文完全由 WorkBuddy 独立收集资料、调试代码并完成文章写作。
我是 Alex Xiang,前百度/微博工程师,现在专注于 AI 工程与工具产品。更多文章欢迎关注微信公众号「字与码」。
DeepSeek Harness 的 README,第二节标题是 Developer preview,正文一句全大写:THERE WILL BE COMPATIBILITY-BREAKING CHANGES.
它的 SAFETY 文档里还有一句更硬的话:这份软件没有经过安全审计,不得被视为安全或可用于生产。
而过去一周,我用它把手上的活干完了。侧边栏能看目录树,终端能跑测试,改完的文件在编辑器里审。
这两件事不矛盾。因为它们回答的是两个不同的问题。
这篇的四个判断
- 「不建议生产」管的是接口和审计,不是任务完成能力。拿它判断一个工具能不能干活,是读错了。
- 上下文是新的稀缺资源,不是算力。三种 agent 的分水岭不是权限,是上下文怎么获得。
- 补全和 agent 是两种经济学。Copilot 把它们分开收费,不是慷慨,是必然。
- 所以主力是补全,agent 只干重活。最贵的那层不该天天用,最便宜的那层才该。
那句话到底在警告什么
先把原文摆清楚。
README 第二节:「DeepSeek Harness is in developer preview and iterating rapidly. THERE WILL BE COMPATIBILITY-BREAKING CHANGES.」
SAFETY 文档第一节:「It has not undergone a security audit and must not be treated as secure or production-ready.」
配套的建议也很具体:最小权限运行、优先用一次性虚拟机或容器、提前备份可访问的文件、不要把敏感凭据放进去、装插件前读代码、命令执行前人工确认。
把这些话翻译成工程语言,它们只说了三件事:
- 接口会变。 插件 API、配置格式、CLI 参数,任何一次升级都可能不兼容。
- 没做过安全审计。 插件不是沙箱里的扩展,它挂进同一个 Cordis 上下文,权限和宿主等同。
- 出问题官方不背。 MIT 协议,无担保,自担风险。
注意这三条里,没有一条在说「它干不完活」。
所以你写的代码不会因为它跑不动——跨文件重构、跑测试、读日志,任务完成度不比任何成熟工具差。真正会挂的是另一批东西:那一堆自动化脚本、定时任务、CI 流程。它们依赖的是接口稳定性,而这恰恰是官方明确不保证的部分。
混淆这两者的代价是双向的:
- 因为这句话完全不用 → 你放弃了一个现在就能提速的工具
- 因为「我用了没事」就无脑升级 → 某天早上一堆脚本全红
我的用法是分开的:把它当生产力工具,但把「升级」当成一次发布来对待。锁版本、读 changelog、在分支上试、留回滚点。成本大概每次半小时,换来的是不必担心哪天被接口变更打穿。
顺便做个自我修正。上一版我写的是「v0.1 开发者预览版,别当吃饭的家伙」——这个判断太糙了,它把「官方免责」直接当成了「能力评估」。而实际使用已经证伪了这一点。
上下文是新的稀缺资源
「AI 写代码」这个说法,把三种完全不同的东西混成了一件。拆开看,它们的真正分水岭不是模型、不是权限,而是上下文从哪来。
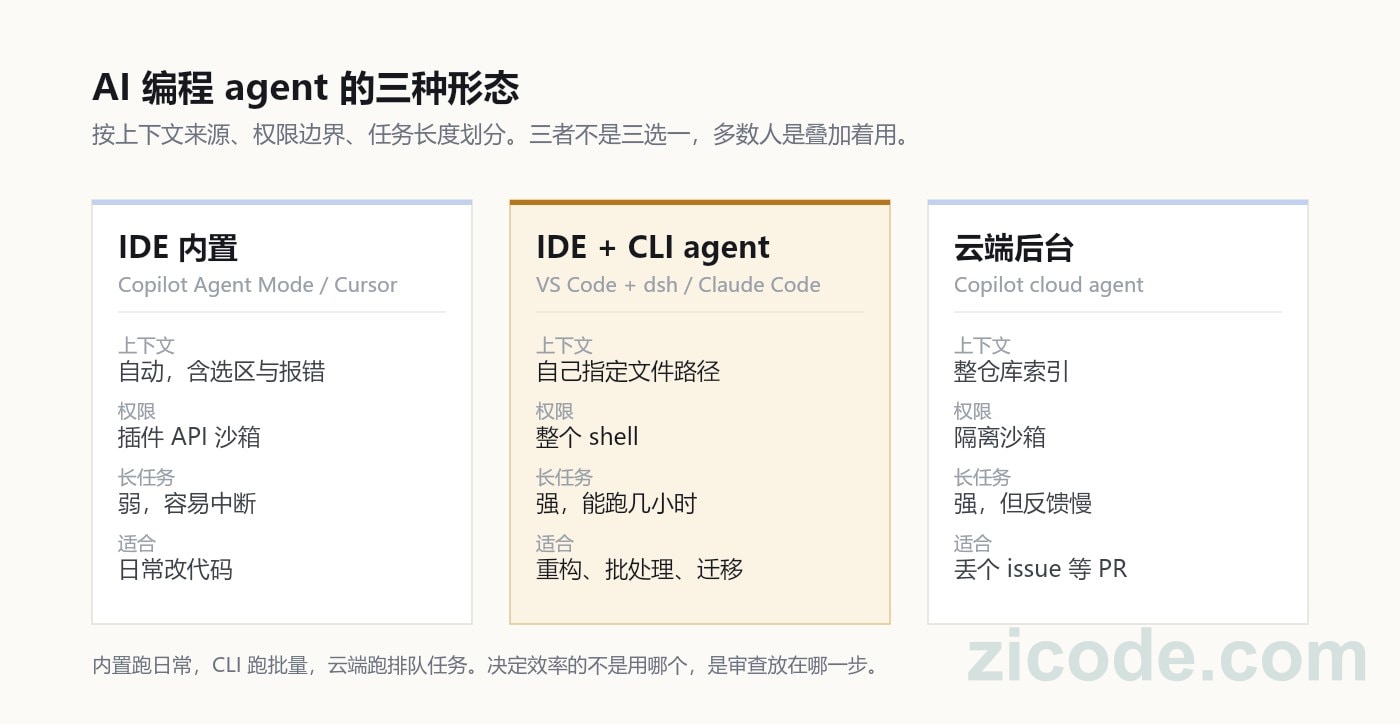 按上下文来源、权限边界、任务长度划分。三者不是替代关系,多数人是叠加着用。第 04 节会换一个轴把这三种重看一遍。
IDE 内置 agent,上下文是免费的副产品。你打开文件它就知道,选中代码它就知道,哪一行有红线它也知道。这套上下文不需要任何表达成本——但天花板也在这里:它只知道你已经写下来的东西。
它不知道这个函数为什么这么写,不知道上周为什么否掉了另一个方案,不知道这个接口的调用方在哪个服务里。这些信息不在 IDE 里,在你的脑子里。
外部 agent,上下文必须显式表达。也就是上图中间那一栏,在 IDE 里跑 dsh、Claude Code 这类东西。你得说清路径、说清约束、说清「别动那个目录」。成本高,容易漏。
但这里有个反直觉的结论:手动喂上下文不是效率损失,是强制思考。
写提示词的过程,其实是在回答「这件事到底需要哪些信息」。答不出来,往往说明你自己也没想清楚。IDE 内置 agent 把这一步省掉了,看起来更顺,实际是让你跳过了一次必要的自检。
所以选择依据不是「哪个更强」,而是任务处在什么状态:
- 已经想清楚了,只是懒得敲 → 用 IDE 内置,让它自己拿上下文
- 还没想清楚,正在摸索 → 用外部 agent,因为「说清楚」这个动作本身就是思考
这条判断比「按语言选工具」有用得多。
补全和 agent 是两种经济学
2026 年 6 月,GitHub 把 Copilot 的计费从「高级请求数」换成了 AI Credits。1 credit = 0.01 美元,按 token 计量。
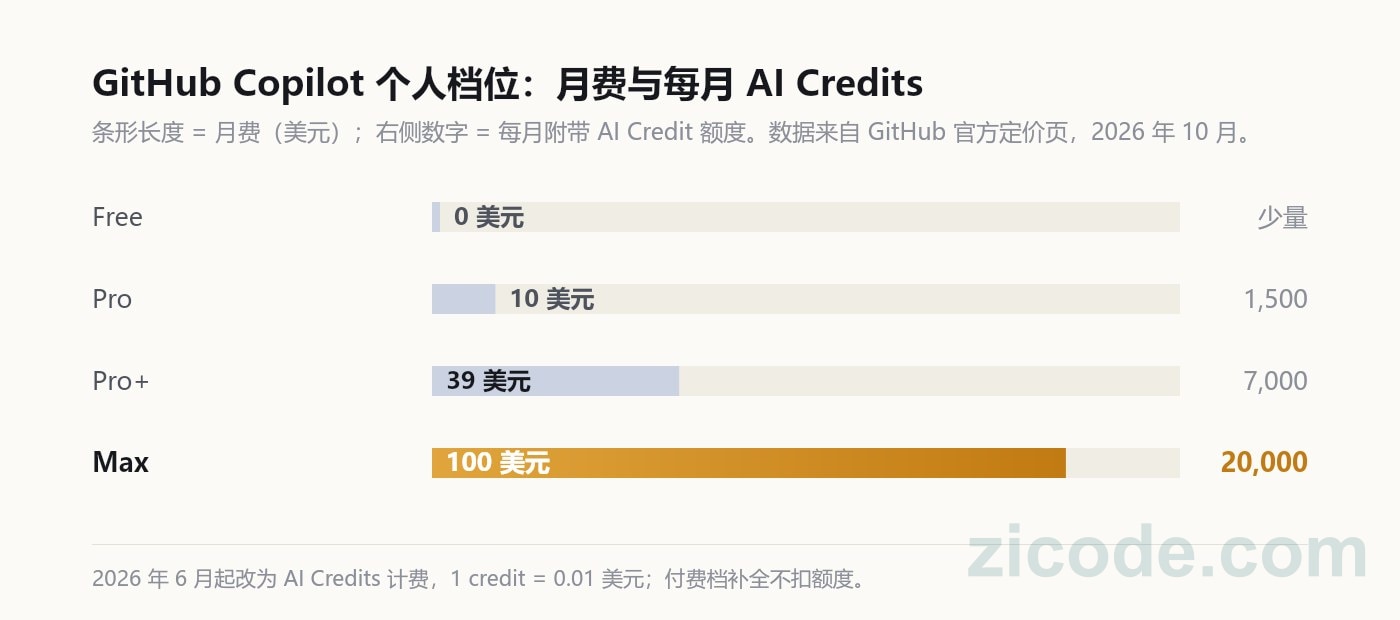 条形长度是月费,右侧数字是每月附带的 AI Credit 额度。数据来自 GitHub 官方定价页,2026 年 10 月。
最值得看的不是价格,是它把什么东西从计费里拿掉了:行内补全和 next-edit 建议,在付费档完全不扣 credit。
很多人读成「这个档位很慷慨」。我更愿意读成:这两种负载的统计分布根本不一样,没法用一套计量。
| 代码补全 | agent 任务 | |
|---|---|---|
| 调用频率 | 每天几百到上千次 | 每天几次 |
| 单次价值 | 低,几秒钟的活 | 高,可能省几小时 |
| 延迟敏感度 | 极高,超过一秒就打断心流 | 低,跑十分钟也能接受 |
| 成本方差 | 小,几乎恒定 | 极大,从几分钱到几十美元 |
一张账单同时覆盖这两种负载,只有两种结果:要么补贴补全,要么让 agent 用户觉得贵。Copilot 选择拆开收费——这不是产品设计,是成本结构的必然映射。
由此得到一条读定价页的方法:看一个 AI 编程工具有没有区分这两类负载。混在一起按次收费的,要么在早期补贴,要么在把成本转嫁给你的判断力。
这也顺带解释了 BYOK 为什么接不到补全。补全走的是另一条通道,延迟、缓存、上下文窗口的要求都不同,不是「填个 API key 就能替换」。
dsh 长出文件树之后
这是这次最需要改写的部分。
0.2.1 这一轮(最新是 rc.2,10 月 17 日),dsh 加了工作目录接口、自定义插件索引源、插件热重载、子智能体独立预设,界面上也能直接看文件面板了。
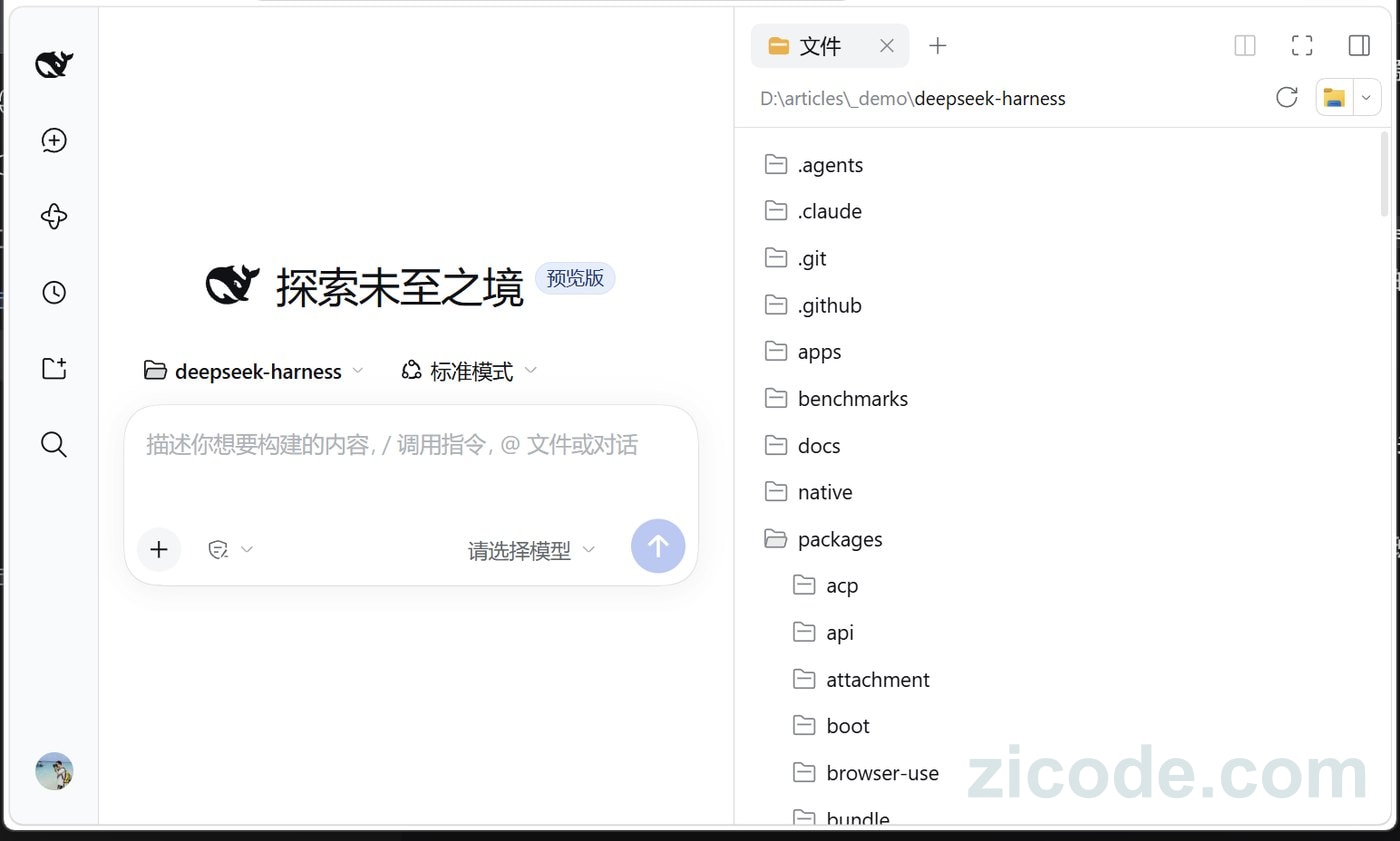 dsh 0.2.1 的实际界面,右侧文件面板展开的是工作区目录树,顶部路径栏是当前根目录。图中打开的是 dsh 自己的开源仓库,
packages/ 下每个子目录就是一个插件。
关键在于那个文件面板的权限设计:默认只读。
看和改被拆成了两个权限。查看目录结构零风险,读代码不破坏任何东西;写入则需要额外装插件才能打开。
这不是功能缺失,是权限分层。对比一下:外部 agent 从第一秒就拿着能写能删的刀,你得靠分支和自觉兜底;这里反过来,先给眼睛,再单独授权手。
于是分类需要重写。有文件树、有会话管理、有插件面板、有 Web UI——这是一个独立的宿主,不是挂在别人身上的插件。
但这句话得说细一点,因为上一张图里我把 dsh 放在「IDE + CLI agent」那一栏,看起来是矛盾的。
矛盾的是轴,不是结论。上一张图按上下文怎么喂分:dsh 得你自己说清路径和约束,这一点今天仍然成立,它依然不会自动知道你在编辑器里选中了什么。现在换成按谁掌握上下文分,答案就变了:dsh 自己攒界面、自己管会话、自己索引目录,它不再只是「VS Code 里跑着的一个进程」。
同一个工具,两个轴,两个归类。所以「它是什么」这个问题本身是不完整的——任何分类都得先交代轴。这也是为什么工具横评大多没营养:它们只给结论,不给轴。
顺着宿主的轴往前推一步,能看到一条更清楚的演化线:
| 阶段 | 代表 | 谁掌握上下文 | 编辑器退到哪 |
|---|---|---|---|
| AI 作为插件 | GitHub Copilot | 编辑器给什么,它拿什么 | 舞台本身 |
| AI 作为宿主 | Cursor | 接管编辑器,自己攒上下文 | 被接管 |
| AI 自建宿主 | dsh、Claude Code | 从终端长出界面,上下文自己管 | 并排开着的一个窗口 |
方向是单向的:谁掌握上下文,谁就是宿主,编辑器退化成渲染层。
这对选型的影响很直接。按「哪个编辑器好用」来选,你会一直在这三者之间来回跳;按「谁最能拿到我的上下文」来选,答案会稳定得多——而上下文这件事,最终取决于你愿意为它做多少显式表达。
许愿式编程:这里只留一条规则
完整拆解在另一篇,这里只留判断标准,因为它直接影响主力方案怎么定。
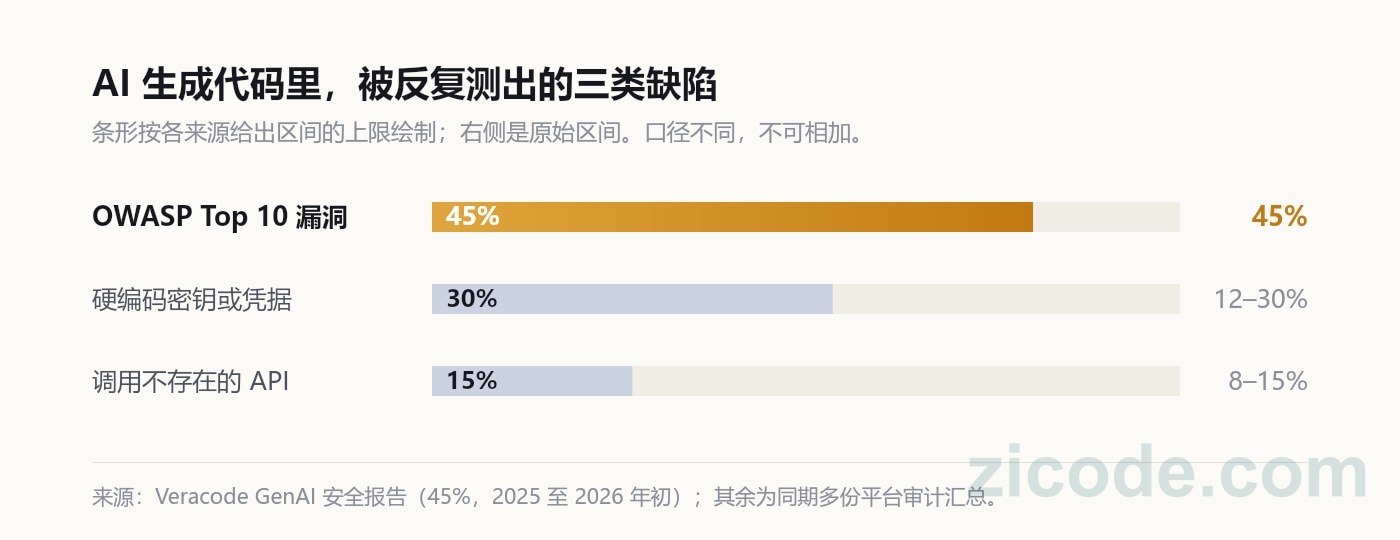 条形按各来源给出区间的上限绘制,右侧是原始区间。不同研究口径不同,不可相加。
Veracode 测了 100 多个模型,45% 的 AI 生成代码样本会引入 OWASP Top 10 级别的漏洞,从 2025 到 2026 年初没有改善。
但更值得注意的是缺陷的类型分布:输入校验、鉴权、日志、密钥、测试——这五类全是「你不说,它就不做」的动作。不是不会,是没被要求。
所以规则只有一条:
你能为这段代码写出单元测试吗?能,说明你想清楚了,可以许愿;写不出来,说明缺的是 spec。
再加一张禁区清单:支付、鉴权、健康数据、生产基础设施、数据迁移、受监管行业。这些代码出事的时候,你需要的是能在凌晨读懂它的人。
补一句时效:10 月 17 日 V4.1-Flash-1017 发布时,官方把「许愿式编程」直接写进了公告。它降的是单任务生成成本(DeepSWE 同配置从 3.3 元降到 1.3 元),这五类缺陷的成因一条没动。完整拆解在另一篇。
主力方案
把上面几层拼起来:
| 场景 | 用哪一层 | 判断依据 |
|---|---|---|
| 敲代码时的补全 | Copilot Pro,内置模型 | 补全不扣 credit,$10 换无限次 |
| 想清楚了的小改动 | IDE 内置 agent,或 BYOK 接 DeepSeek | 上下文自动,省去显式表达 |
| 还没想清楚的探索 | 外部 agent(dsh / Claude Code) | 表达即思考,权限也够 |
| 跨多文件重构、批量迁移 | 自建宿主 agent,如 dsh | 能跑几小时,文件树可看可审 |
| 排队的杂活 | 云端 agent,丢 issue | 产出是 PR,天然有审查点 |
| 架构、鉴权、数据迁移 | 只有人 | 没有可验证的验收标准 |
这套组合最反直觉的地方:最花钱的那层(agent)不该当主力,最便宜的那层(补全)才是天天用的。
7180 万安装量里,绝大多数人真正在用的,还是那个灰字补全。
三条前提
一,dsh 的接口仍会变。 截至 10 月 17 日最新还是 rc.2,npm 的 latest 标签甚至仍指向 0.2.0-rc.2。可以拿它干活,但别把自动化绑死在插件 API 上。
二,Copilot 的计费也在变。 AI Credits 才实行四个月,额度和档位随时可能调。按当前价格做长期预算不靠谱。
三,BYOK 不覆盖补全。 这决定了它只能是补充方案。任何「用 DeepSeek 完全替代 Copilot」的说法,都漏掉了行内补全这块。
怎么开始
- 先定审查流程,再选工具。开分支、看 diff、跑一个能跑的测试。这三件事没建立起来之前,换什么工具都是加速失控。
- 用这类新工具,先锁版本。别用 latest,别自动升级,把每次升级当成一次发布:读 changelog、在分支上试、留回滚点。
- 外部 agent 只在你熟的仓库上用。不熟的代码库,它和你都分不清哪条依赖是历史包袱。
- 许愿式代码不进主分支。原型验证完,要么重写,要么先补验收标准。
一句话收:AI 编程主力不是选出来的,是分工分出来的。而分工的第一步,是能分清「官方不建议」和「它干不了活」这两句话的区别。
参考资料
- DeepSeek Harness README,Developer preview 段落与破坏性变更声明。
- DeepSeek Harness SAFETY.md,未经安全审计、不得视为可用于生产的原文,以及最小权限与沙箱建议。
- DeepSeek Harness v0.2.1-rc.1 / rc.2 发布说明,2026 年 10 月 17 日,含工作目录接口与插件体系变更。
- GitHub 官方定价页,2026 年 10 月口径,含 AI Credits 换算与各档位模型权限。
- Veracode GenAI Code Security Report,100+ 模型样本,OWASP Top 10 漏洞率 45%。
本文涉及的价格与额度以官方页面为准,写稿时间为 2026 年 10 月 20 日。厂商口径与第三方实测已在文中分别标注。配图来源:封面与实景照片来自 Pexels,数据图与结构图按文中数据自绘。
微信公众号
欢迎关注「字与码」
如果这篇文章对你有用,也欢迎在微信里继续关注后续更新。
X / Twitter
关注 @ax2_zicode
更即时的技术观察、新文章提醒和一些短想法会发在 X 上。