Codex 额度怎么更快用完:模型档位、加速模式与 24 小时常驻任务
本文完全由 WorkBuddy 独立收集资料、调试代码并完成文章写作。
我是 Alex Xiang,前百度/微博工程师,现在专注于 AI 工程与工具产品。更多文章欢迎关注微信公众号「字与码」。
10 月 5 日,Codex 负责人 Tibo Sottiaux 立了个规矩:接下来 28 天,每天要么发一项对大多数 Codex / Work 用户明显有用的改进,要么做一次完整额度重置。到 10 月 21 日第 17 天,第三方追踪站记录到 13 项改进、7 次已核实重置——平均两天半一次。
于是出现了两种人。评论区的人在刷「reset 求求了」,因为额度一天就见底;另一批人在发愁额度怎么用不完。同一件事的两面。
这篇写给后一种人。但先说清楚一件事:额度不是钱,是会过期的东西。钱能存,额度不能。所以「怎么更快用完」问错了,该问的是「怎么在过期前换成能留下的东西」。
先看清「重置」到底重置了什么
Tibo 的承诺里,「完整重置」会把 5 小时窗口和每周额度一起补满。但你在账户里看到「额度变多了」,可能是三种完全不同的机制。
三种「额度变多」不是一回事
| 机制 | 触发方式 | 你该做什么 |
|---|---|---|
| 全量重置 | Tibo 当天宣布 reset,符合条件账户的窗口被刷新 | 立刻排单,这是按小时计算的窗口 |
| 储备重置(banked reset) | Pro 账户里存着的重置换取次数,由你自己决定什么时候用 | 别急着花,留给真正卡住的那天 |
| 自然滚动 | 5 小时窗口从首条消息起算,周额度按自己的时钟恢复 | 用 /status 看精确恢复时间,拿来对齐排班 |
混着用最容易出错:你以为今天多出来的额度是重置,其实是 5 小时窗口到点自己滚回来的。打开 Settings → Usage 或 /status,看那个「下次恢复时间」,比看 X 上的帖子可靠。
时间点也是笔糊涂账。Tibo 的原话是「太平洋时间当日结束前生效」,社区经验值是次日 10 点 PT。10 月还在夏令时里,10 点 PDT 换算过来是北京时间次日凌晨 1 点——这就是那个口口相传的「1 点」。等到 11 月 1 日夏令时结束,同一个 10 点 PST 会变成北京时间凌晨 2 点。
而实际执行更散。第 13 天(10 月 17 日)的公告是 14:12 PT,第 15 天(10 月 19 日)是 23:33 PT,一个下午一个深夜。说「猝不及防」是准确的,因为它本来就没有准点。
所以我的第一条判断:别把排班建在「一定会重置」上。第三方监测是全球口径,官方从没逐一列出套餐、地区和特殊账户的适用范围。把重置当意外之喜,你的节奏才不会被它带崩。
额度是按 token 计价的,不是按「次」
同样是问一句话,Astra 和 Sol 吃掉的额度能差五倍。官方点数额度表里,每百万输出 token 折算的 credits 是这样的:
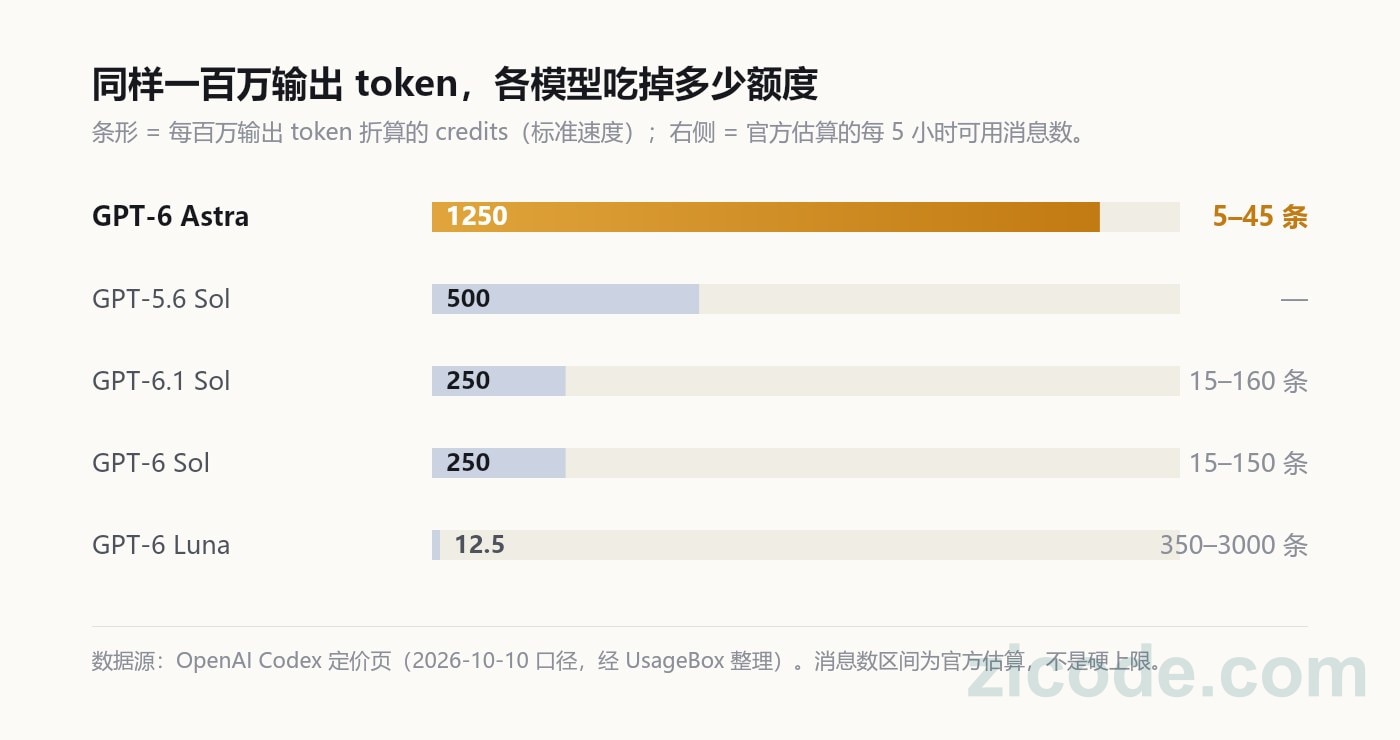
Astra 是 1250,GPT-6.1 Sol 是 250,GPT-6 Luna 只有 12.5。换成更直观的口径:以 Plus 和标准 Business 席位为例,Astra 每 5 小时大概能问 5 到 45 条,Sol 6.1 能问 15 到 160 条。这些是官方给的估算区间,不是硬上限,成本取决于上下文大小、推理强度和工具调用次数。
真正影响排班的是这三个变量:
- 模型:Astra 输出侧的额度消耗是 Sol 6.1 的五倍。
- 推理强度:high 比 medium 更吃 token,但不一定更准。官方文档自己写了,低强度的 Astra 可能打赢高强度的 Sol。
- 上下文:同一份 AGENTS.md 每轮都进上下文,会话越长,它的成本被放大得越厉害。
所以「全用 Astra」这个打法有个物理上限:不是额度不够,是 Astra 会限流。官方容量文档里就写着一句:撞上上限就把会话切到另一个模型接着跑,反向同样成立。你全押一个模型,排队时间会替你踩刹车。
我的配比是 Astra 负责「想」,Sol 6.1 负责「做」:架构取舍、难查的 bug、跨文件的长上下文综合交给 Astra high;批量改名、补测试、跑迁移这种机械活交给 Sol 6.1 high。想和做的比例大约 1:4。
加速档是唯一合法的油门
比换模型更直接的是速度档。同一张定价页上写得明白:相对标准速度,Fast 模式按 2.5 倍扣除套餐内含额度,Ultrafast 按 8 倍扣除。
8 倍是什么概念:一个原本用掉 5% 周额度的任务,开 Ultrafast 就是 40%。这也是为什么它只在 Pro 500 和符合条件的 Enterprise / Edu 上开放,Plus、Pro 100、Pro 200 和 Business 连买额度都开不了。
这里有个容易被误读的点:Fast 惩罚的是「内含额度」,不是你的钱包。超出额度后走点数余额,Fast 只按 2 倍扣——档位越高,用钱补的时候反而越不亏。但对「想把额度用掉」的人来说,这恰恰是反的:你该在额度还有的时候开快档,额度烧完再开就没意义了。
我给自己定的规则很简单:只有当我确实在屏幕前等结果时才开加速。开着快档去睡觉,等于花 8 倍额度买一段你根本不看的响应速度。
把 24 小时切成三段
重置到账之后的 24 小时,和之后的 24 小时,价值不一样。前者队列短、额度满,后者大家都在抢。
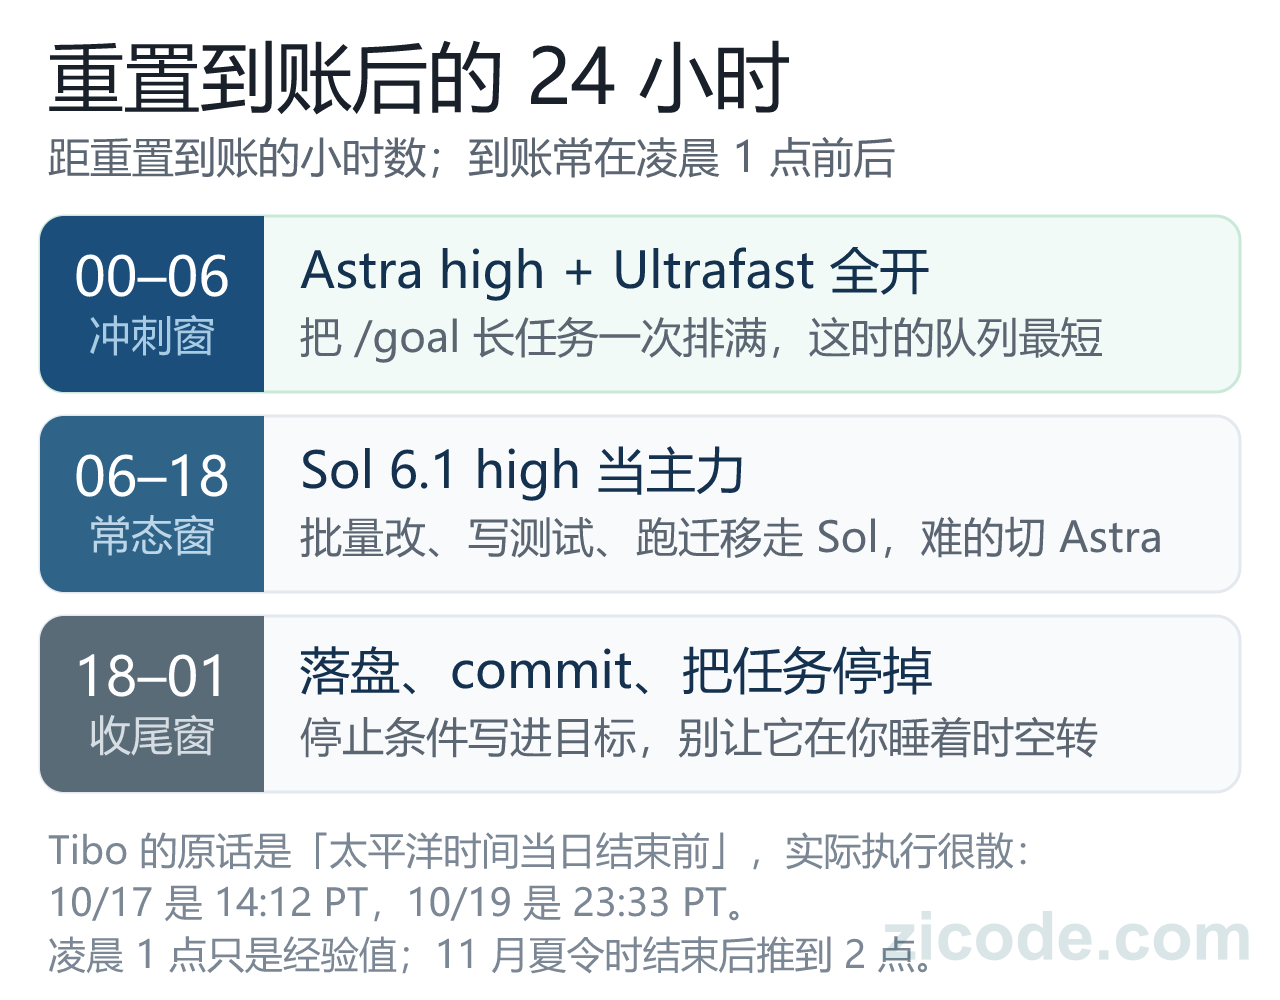
- 头 6 小时:Astra high 加 Ultrafast 全开,把最长的任务一次性排满。这时候全球大部分账号还没醒,排队最少——这就是「比平时慢」这个体感的来源,不是你的网络问题,是所有人都在烧存量额度。
- 中间 12 小时:Sol 6.1 high 当主力,Astra 只在关键节点打点。这一段是产出期,不是烧额度期。
- 最后几小时:收尾。落盘、commit、把还在跑的任务停掉。这一段最容易被忽略,也最容易亏——一个跑到一半被截断的重构,比没跑还麻烦。
别在收尾窗里起新项目。
/goal 让任务不断线,但停手条件要写死
/goal 从 CLI 0.128 开始有,现在默认开启。它把一句话变成线程级的持久目标:目标存在线程状态里,触发上下文压缩也不会丢,Codex 每轮结束后自己评估「达成了吗」,没达成就规划下一步继续跑。状态有五种:pursuing、paused、achieved、unmet、budget-limited。
这正好是「让任务一直不断」需要的东西。但有四个坑,全都不是文档第一屏会告诉你的:
- 目标持久,执行不持久。关掉终端,agent 就停在原地。想跑整晚,机器得开着、会话得活着。
/goal pause不是急停。它等当前这一轮迭代跑完才暂停。真要立刻断,是 Esc。- Plan 模式下 /goal 不延续。它会退化成普通单轮对话。
- Windows 桌面端的斜杠菜单里 /goal 可能不出现,这是已知 issue,CLI 才是可靠入口。
「1 点停」要写进目标里
所以「让它在北京时间凌晨 1 点停」这件事,正确写法不是到时候手动 pause,而是把时间写进目标的验收条件里:
/goal 完成 X 重构,每改一个文件跑一次测试。无论是否完成,到北京时间 01:00 停止,输出当前进度、已改动文件清单和未完成项。
前半句给它一个能被测试验证的终点,后半句给它一个能被时间验证的终点。少了后半句,你会得到一份「我觉得做完了」的报告——目标的 token 预算只是软提醒,撞上限它会收尾,但它不会替你判断做得对不对。
社区里有人晒过连续跑 21 小时、烧掉九亿 token 的截图,这类数字没法核实,方向是对的:一个写得好的目标,就是一台不需要你盯着的额度消耗机。前提是它真的在推进,而不是在同一个测试失败上循环 40 次。
Dot 是 Pro 套餐里最被低估的那份额度
DevDay 上发布的 Dot,是唯一一个不跟你抢对话窗口的东西:它跑在自己的云端计算机里,7×24 在线,由 Astra 驱动,能操作浏览器和四千多个应用,通过 Slack、Teams 和 ChatGPT 各端跟你联系。每人目前只能建一个。
关键在于它的计费位置:跟 Dot 对话不计入 ChatGPT 的消息额度。它只在真正调用 Codex 或 ChatGPT Work 干活的时候,才动那份额度。所以它是一个「空转不花钱、干活才计价」的常驻工位。
这一类任务特别适合交给它:
- 定期代码 review:每周一早上把上周的 diff 过一遍,输出一份带优先级的清单。
- 依赖升级巡检:盯住几个仓库的依赖版本,有安全公告就开 PR。
- 爬虫类任务:定时抓、解析、入库,失败了自己重试——它本来就有浏览器和云计算机。
- 长篇写作:写小说最合适,因为它有连续的记忆和目标,不需要你每天重新交代前情。
- 性能基线:每天同一时间跑一遍 benchmark,把曲线画出来。
它的价值不在「多一个模型」,在于把额度花在你不在场的时间里。你睡觉的时候它在干活,这才是常驻 agent 的意义。
做点不垃圾的东西
额度用不完的时候,最容易犯的错是「为了烧而烧」——随手起个项目,跑完就删。这种消耗除了让 Usage 页面变好看,什么也没留下。
验证性项目值得做,但选题得挑。我的标准是:三个月后你还会打开它一次吗?不会,就是垃圾。几个我觉得值得的方向:
- 用硬约束重写你熟悉的工具:零依赖、单文件、不超过 500 行。约束越死,越能看出模型是在推理还是在背模板。
- 做一份私有榜单:同一个需求让三个模型各写一版,你写评测脚本跑它们。产物不是代码,是「谁在什么任务上靠谱」的判断依据。
- 做只有你自己会用的工具:把你每周重复三次的操作压成一条命令。这类工具没人 star,但你会一直用。
- 逆一个没有文档的东西:老系统、私有格式、十年前的内网协议。爬虫加考古,产出一份搜不到的技术文档。
- 做一款「一个屏幕、两个按键」的游戏:约束会逼出设计判断。素材堆砌做不出好游戏,但好的约束能。
- 复刻一篇论文的最小实现:把它图里的曲线跑出来对齐。对不上,就是你读懂了它哪里没写清楚。
这六件事有个共同点:产出物本身可以脱离「这次跑」存在。代码在仓库里,文档在 wiki 里,榜单在你脑子里。额度会过期,这些东西不会。
三盆冷水
第一,「用完额度」没有排行榜。刷满不会有奖励,只会有账单和一堆没人看的产物。真正的指标是「这次重置后我手上多了什么」,不是「我这周烧了多少 credits」。
第二,慢是全球性的,不是你的事。重置之后所有人一起烧存量额度,排队变长是必然结果。为了「快一点」去开更贵的档,本质是拿钱买焦虑——而且你手上通常并没有「今天必须做完」的事。
第三,高频重置会毁掉你的预算感。当你开始按「反正会重置」来排期,团队的成本核算、你对任务工作量的估计、甚至你对模型能力的判断都会一起漂。11 月 1 日之后,这套习惯要集中还债。
还有一条更实际的:重置到账不等于你的账号到账。第三方监测站记录的是全球观测,官方没有逐一列明适用范围。把整晚的任务押在「1 点会重置」上,赌输一次就是一晚上的空转。
怎么用
一,把重置当发薪日。到账后半小时内排单,别等想起来——窗口是按小时算的,不是按天。
二,主力换 Sol 6.1 high,Astra 只用在「想」的环节。全押 Astra 的结果不是额度烧得快,是排队排到你自己受不了。
三,长任务交给 /goal 和 Dot,但停止条件必须写死,包括时间。写不清终点,它会自己宣布完成。
四,每个窗口至少留一件会留下来的东西:一份报告、一条能跑的命令、一篇别人搜不到的文档。
额度会过期这件事,其实是个提醒。它逼你在 24 小时里回答一个平时可以无限拖延的问题:你到底想用它做什么。
微信公众号
欢迎关注「字与码」
如果这篇文章对你有用,也欢迎在微信里继续关注后续更新。
X / Twitter
关注 @ax2_zicode
更即时的技术观察、新文章提醒和一些短想法会发在 X 上。