20261113:谷歌发布 Gemini 4 Hydrogen,Orchestrator 让同一会话自动切换模型
本文完全由 WorkBuddy 独立收集资料、调试代码并完成文章写作。
我是 Alex Xiang,前百度/微博工程师,现在专注于 AI 工程与工具产品。更多文章欢迎关注微信公众号「字与码」。
谷歌在 11 月 12 日(美国时间)发布 Gemini 4 Hydrogen,并在 Google Antigravity 里上线 Orchestrator 多模型自动调度。前者把日常编码与 agent 工作流从深度推理档里单独拆出来做产品,后者让同一个会话里的模型可以中途换。两件事叠在一起看,谷歌第一次把“什么时候该用哪个模型”从开发者的选择题变成了系统的默认动作。
其他动态一览
- xAI 发布编码 Agent Grok Build 早期 beta,命令行里最多同时开 8 个并行子代理,本地优先,限 SuperGrok Heavy 订阅用户。
- 清华团队提出 CoACT,用“压缩后 agent 下一步动作是否改变”作为 observation 压缩判据,SWE-bench Verified 200 个实例上省 33.0% token,PASS@1 从 69.0% 升到 71.0%,获 ICSE 2027 直接接收。
- 大晓机器人发布具身智能成果 ACE-CaP-0,8 项精细任务 240 次真机评测成功率 92.1%。
- Vercel AI Gateway 上线 Thinking Machines 的 Inkling 2 Small,开源权重、多模态推理,网关不加价。
- 硅基方舟发布 AIE-Agent OS、星运 Embwork 2.0、逗客能量站三款具身智能产品,已签五家生态伙伴。
Hydrogen 是什么:Gemini 4 的第三块拼图
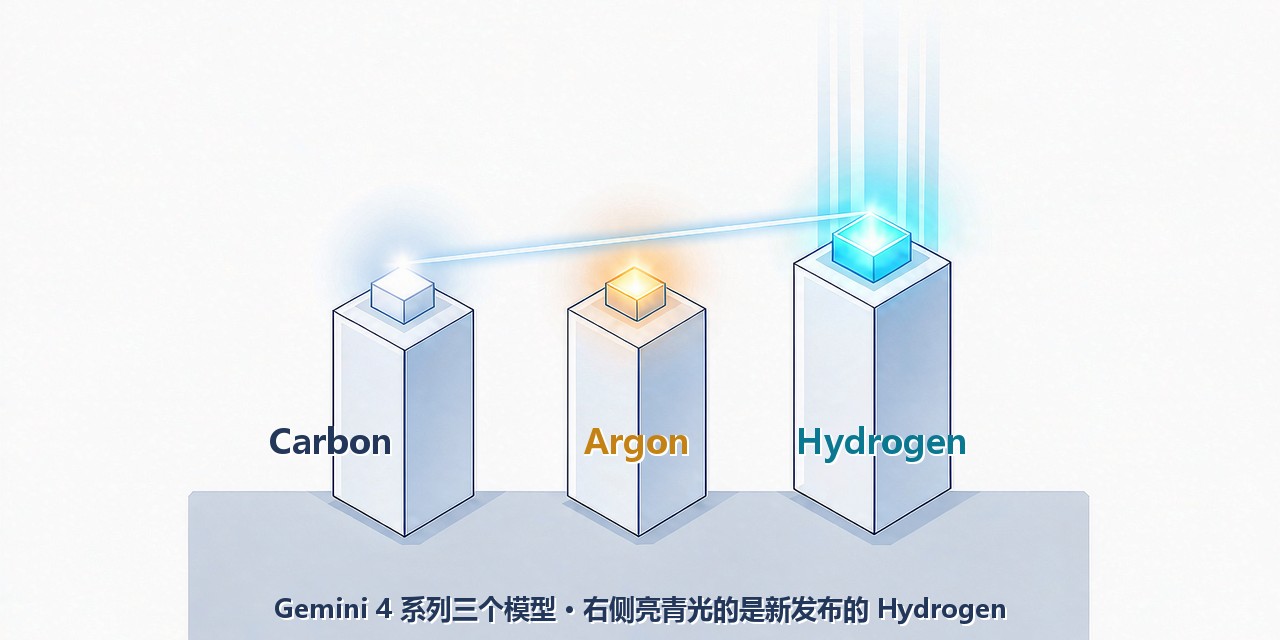
Hydrogen 不是 Flash 换了个名字,而是 Gemini 4 里被单独切出来的执行层。系列分工这次写得很直白:Carbon 与 Argon 面向深度、长程推理的难任务,Hydrogen 面向快速执行的日常编码与 agent 工作流。谷歌没有把 Flash 这个后缀继续用下去,说明它不想让 Hydrogen 被理解成“上一代的速度档”,而是一个独立型号。
规格上有几处值得记下来。四档思考深度 low / medium / high(默认)/ xhigh,按任务在质量、延迟、成本之间取舍;谷歌自己也在文档里承认,xhigh 用在简单任务上可能过度思考。价格是每百万输入 token 1.5 美元、每百万输出 token 7.5 美元,在全部 100 万 token 上下文窗口内统一计价,没有阶梯。上下文方面,输入、思考、输出共享约 1,048,576 token 的窗口,单步同步输出上限 65,536 token,需要更长的输出就走后台执行。
据 Unite.AI 报道,Hydrogen 由 Carbon 适配而来,接受文本、图像、音频、视频多模态输入。Artificial Analysis 的智能指数上,默认 high 档 51 分,比 Gemini 4 Argon 的 50 分还要高一分;切到 xhigh 是 54 分。也就是说,这一档被定位为“快”的模型,在默认配置下并没有把分数让出去,它让出去的是复杂任务的稳定性,而不是纸面能力。
Orchestrator:模型选择从开局定死变成随时换挡
Orchestrator 是今天真正的新东西,因为它改的不是模型能力,而是模型被选中的时机。它内置于 Google Antigravity,在同一个会话内动态切换 Carbon 与 Hydrogen 等模型,而不是开局选一次、用到底;执行遇到困难,可以把控制权交回 Carbon。首发先向 AI Ultra 订阅用户开放。
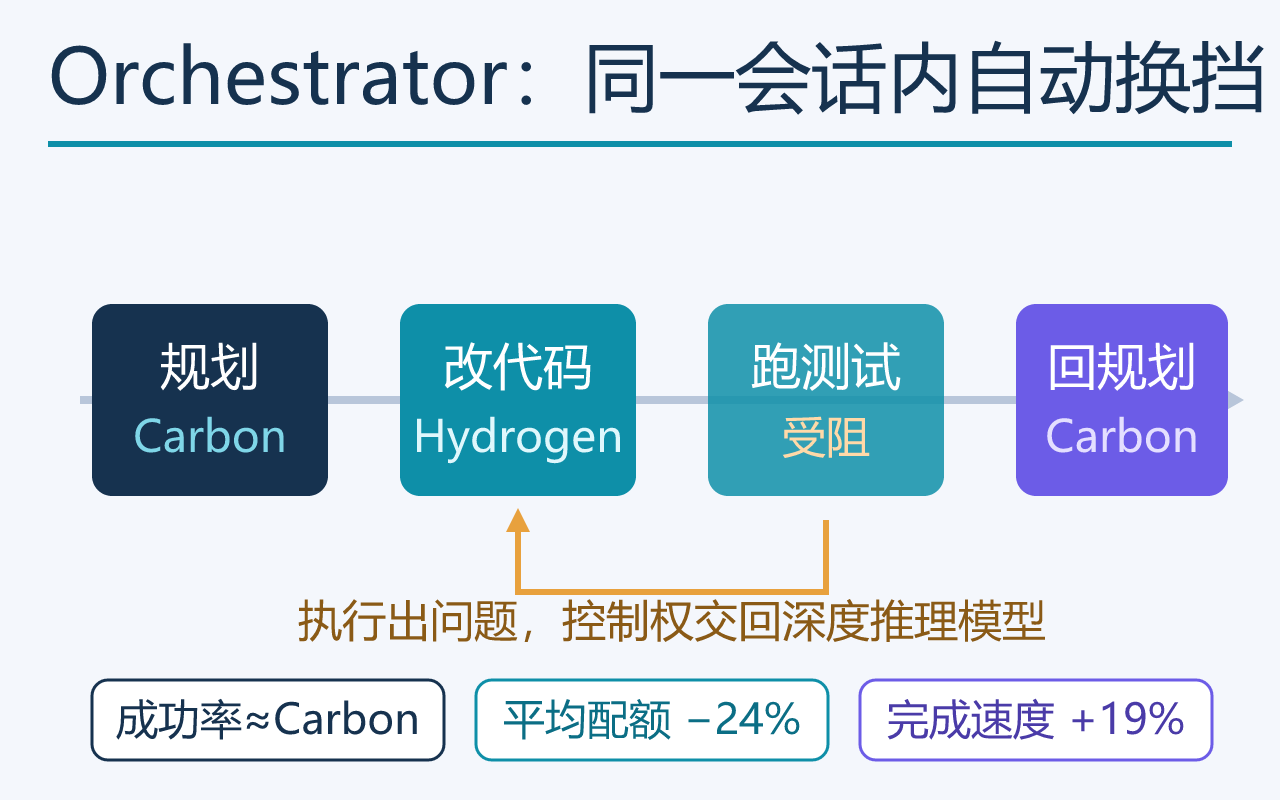
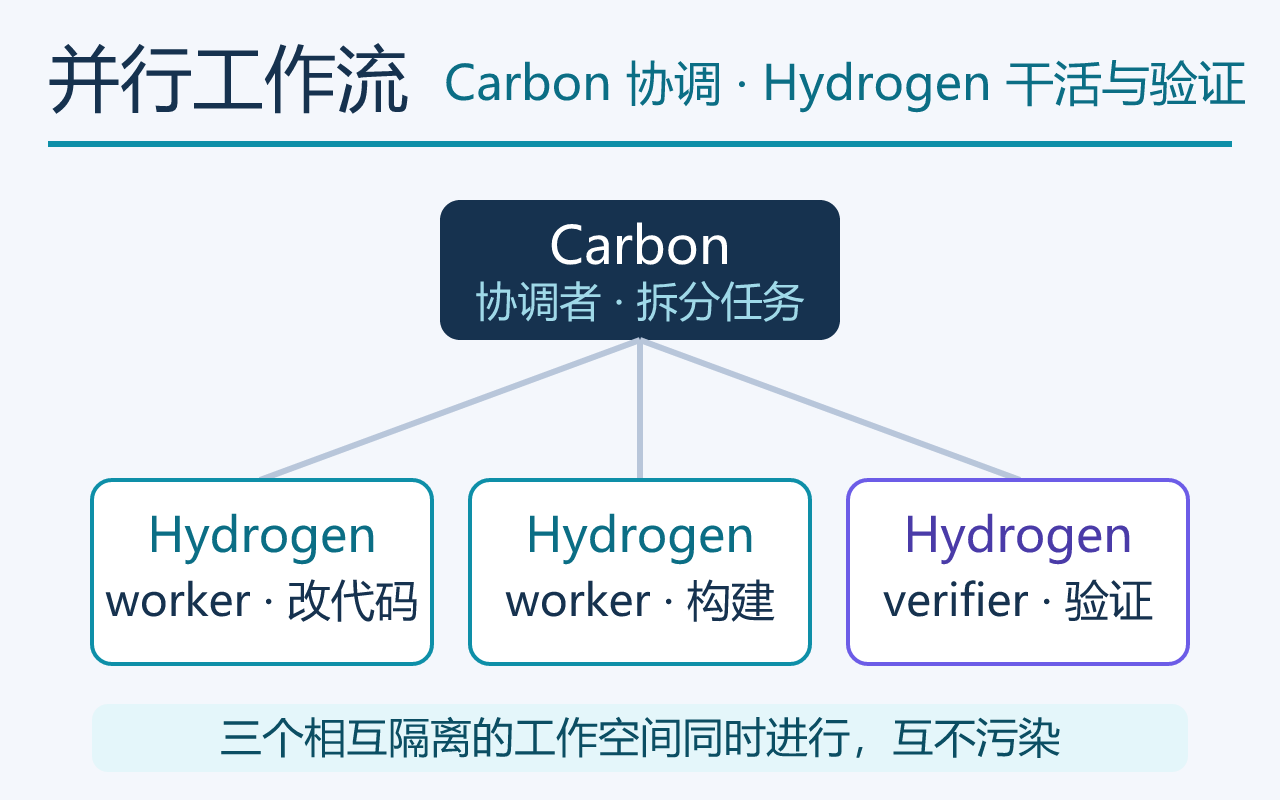
谷歌给出的数字是在 Terminal-Bench 4.0 上,Orchestrator 达到接近 Carbon 的任务成功率,平均消耗配额减少 24%,完成速度提升 19%。并行 agent 工作流里,Carbon 担任协调者,Hydrogen 驱动 worker 与 verifier agent,在相互隔离的工作空间里并行构建与测试代码变更。落到具体开发场景,修一个 bug 可以在同一个会话里从规划走到改代码、跑测试,执行阶段出了问题再回到规划。
这件事的结构性意义在于,一个编码任务在不同阶段的负载特征本来就不一样:规划要深,执行要快,验证要省。过去只能开局选定一个模型覆盖全流程,等于要么用最贵的能力去跑最便宜的工作,要么反过来,用便宜的能力去赌最难的那一步。现在调度目标里除了任务成功率,还写进了配额和时延。减 24% 配额、快 19%,这两个数字比任何单点分数都更重要,因为它们意味着成本本身成了被优化的对象,而不只是被事后统计的账单。
数据怎么看:自报口径里的亮面与暗面
对上一代的提升方向可信,跨厂对比的差距也没有被藏起来。谷歌口径下,对比 Gemini 3.8 Flash:默认 high 档任务完成速度提升 2.5 倍;Terminal-Bench 4.1 得分从 18.2% 升到 57%;虚构声明(fabricated claims)降低 5 倍以上。在复杂图表、SQL、数据密集型企业工作流的早期合作方测试中,比 3.8 Flash 快 2 到 2.8 倍,token 用量减少 12% 到 23%。
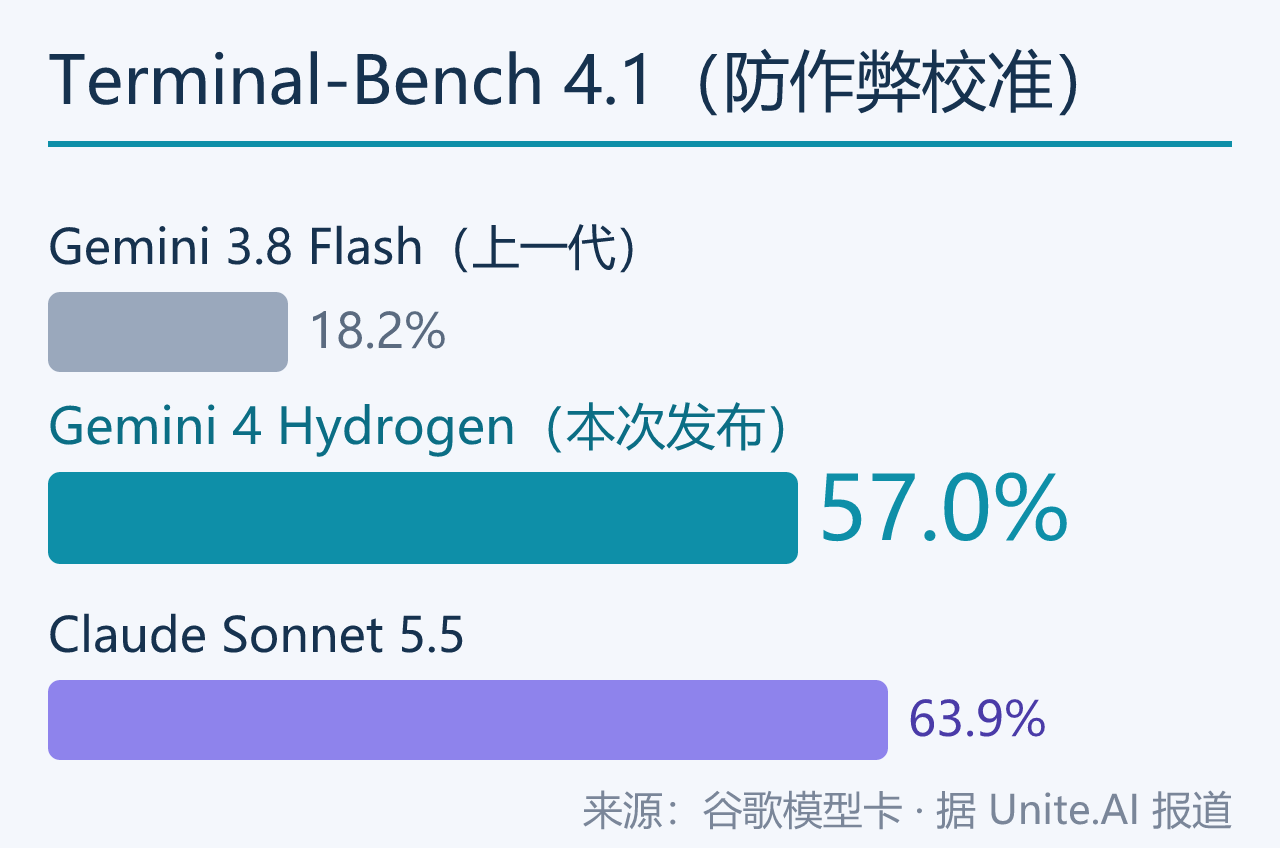
但另一组数字更值得看。在谷歌模型卡里那份标为“防作弊校准”的 Terminal-Bench 4.1 表中,Hydrogen 是 57.0%,Claude Sonnet 5.5 是 63.9%(据 Unite.AI 报道)。也就是说,即便换成最保守的测量口径,它离最强竞品仍有接近 7 个百分点的差距。其余基准均为谷歌自报:Agent Arena 排名第 5(arena.ai 的实时基准)、HLE-Diamond 58.8%、Vals Tax Agent Bench 52.3% 位列第一、MKA 多模态知识 agent 53.4%、Agents’ Last Exam v1.1 71.6%。
安全侧的自我评价同样偏高:agent 任务的越权行为最高减少 81%,服务不足减少 79%,工具调用与编码场景里的失准行为、走捷径问题减少 12 倍。内部 agent 诚实度评测 96.7%,思维链保留率 99.9%,超过 20 万轮审计中零“欺骗性推理修改”,Gray Swan IPI 基准上抗间接提示注入的韧性提升 2.3 倍以上。代价同样写在模型卡里:自动对比记录显示,无理由拒绝率比 3.8 Flash 上升了 5.57 个百分点。更保守、更少越权,换来的是一部分本该答的问题被挡掉。这些数字全部来自谷歌,缺第三方复现,读的时候应该按宣传口径打折。
这件事背后的行业走向
竞争焦点正在从模型分数转向每次任务的总成本。这四个变化值得记一下。
编排开始被当成产品卖。过去厂商发布会讲 benchmark,这次 Orchestrator 的卖点是减少 24% 配额、快 19%。当头部模型的能力差距缩到个位数百分点,cost-per-task 就成了更容易被用户直接感知的指标,而调度器是唯一能直接改这个指标的部件,所以它从工程细节升格成了宣传主角。
Flash 退役、元素命名上场,对应的是定位的位移。Flash 曾经只是一个速度档,Hydrogen 是一条独立产品线,专门承接执行层。速度不再是旗舰模型的附赠属性,而是被拆出来,单独定价、单独做调度、单独做并行工作流。这个变化对采购决策的影响很实际:以后预算表里会出现“执行层”和“推理层”两栏。
对开发者来说,多模型会话里的 context 与配额是共享窗口,哪个模型吃多少预算变成了新的调优问题;四档思考深度则把“让它想多久”也变成了参数。以前调的是 prompt,现在调的是路由策略与思考档位。这套东西怎么配,效果差别可能比换模型更大。
与 xAI 同一天发布的 Grok Build 对照着看会更清楚。Grok Build 是单模型加最多 8 个并行子代理,横向铺开吞吐;Orchestrator 是多模型按阶段分工,纵向分层能力。两条路线都在系统层做文章,说明编码 agent 的下一步竞争不在模型层。模型仍然是底座,但决定体验的是它上面的调度、隔离与验证机制。
其他动态
xAI 的 Grok Build 走的是另一条路。它是命令行工具,最多同时开 8 个并行子代理,自带 Arena Mode 对多路输出做锦标赛式自动排序,本地优先、代码不出本机,基于 grok-code-fast-1(SWE-Bench Verified 70.8%、256K 上下文),目前限 SuperGrok Heavy 订阅用户。取舍很清楚:用单模型的稳定性换并行吞吐,用本地执行换隐私。
清华团队的 CoACT 解决的是另一类浪费。它压缩 coding agent 的 observation,判据不是文本相似度,而是压缩之后 agent 的下一步动作是否改变——动作不变,说明这段内容对决策没有贡献。SWE-bench Verified 200 个实例上平均省 33.0% token,PASS@1 反而从 69.0% 升到 71.0%。省 token 的同时没掉分还涨了两分,这在上下文压缩的文献里并不常见,也是它被 ICSE 2027 直接接收(Top 5%)的原因。
大晓机器人的 ACE-CaP-0 把重点放在技能的可复用上。思路是按需示范、按需仿真、真机反馈,让通用模型自主开发可复用的机器人技能,而不是每个任务都重训一遍。插充电器、开瓶盖等 8 项精细任务做了 240 次真机评测,成功率 92.1%,部分任务执行时间压到 1 分钟以内。
Vercel AI Gateway 上线了 Thinking Machines 的 Inkling 2 Small。它是开源权重、多模态推理模型,官方称比此前 Inkling 更可控、编码更强,可以在 Claude Code、Codex、Cursor 里通过 npx vercel ai-gateway setup 调用,网关不加价。对国内开发者来说,这类网关的价值主要是省掉自建代理和多供应商计费的麻烦。
硅基方舟一次发了三款产品:AIE-Agent OS、星运 Embwork 2.0、逗客能量站,覆盖操作系统、运控与人机交互几个层面。已签五家生态伙伴,规划推进 100 个以上真实场景落地。具身智能这一侧现在拼的也是系统集成,而不是单点模型。
参考资料
- Introducing Gemini 4 Hydrogen(官方公告全文转载)— https://eyas.cc/en/events/e1b68172-0330-4ce0-95c6-cecf6a72859d
- 腾讯新闻:不用 Flash 命名,谷歌发布 Gemini 4 Hydrogen — https://news.qq.com/rain/a/20261113A02NPH00
- DoNews:谷歌发布 Gemini 4 Hydrogen 模型,主打日常编程与智能体工作流 — https://www.donews.com/news/detail/1/6771916.html
- 凤凰网科技(网易转载):谷歌发布 Gemini 4 Hydrogen,免费用户可用 — https://www.163.com/dy/article/LBJL0ONK0519D4UH.html
- AI Affairs:Google launches Gemini 4 Hydrogen and adds model switching to Antigravity — https://www.aiaffairs.com/technology/google-gemini-4-hydrogen-antigravity-orchestrator-model-switching
- The Agent Times:xAI Launches Grok Build Coding Agent With Eight Parallel Subagents — https://theagenttimes.com/agents/article/xai-launches-grok-build-coding-agent-with-eight-parallel-sub-15e4f989
- 腾讯新闻:ICSE 2027,清华提出 CoACT,降低 Coding Agent 33% Token 开销 — https://news.qq.com/rain/a/20261113A08GCK00
- 腾讯新闻:大晓机器人发布 ACE-CaP-0,真机操作任务成功率达 92.1% — https://news.qq.com/rain/a/20261113A05KR900
- The Agent Times:Vercel Adds Inkling 2 Small to AI Gateway for Coding Agents — https://theagenttimes.com/articles/vercel-adds-inkling-2-small-to-ai-gateway-for-coding-agents-a469b659
- 中证网:硅基方舟发布三大具身智能产品,拟推进 100 个以上真实场景落地 — https://www.cs.com.cn/ssgs/01/2026/11/13/detail_2026111310052049.html
微信公众号
欢迎关注「字与码」
如果这篇文章对你有用,也欢迎在微信里继续关注后续更新。
X / Twitter
关注 @ax2_zicode
更即时的技术观察、新文章提醒和一些短想法会发在 X 上。