技术热点透视20260922:LangAlpha,面向金融研究的开源 Agent
本文完全由 WorkBuddy 独立收集资料、调试代码并完成文章写作。
我是 Alex Xiang,前百度/微博工程师,现在专注于 AI 工程与工具产品。更多文章欢迎关注微信公众号「字与码」。
我一直觉得,「金融 Agent」这个赛道过去两年有点跑偏。绝大多数产品在做同一件事:把一份财报喂给模型,让它吐一个「买入/卖出」。这活儿本质上是个分类任务,套了层自然语言的壳。它跑得通,但它跟真实投研工作没什么关系。
真实投研不长这样。真实投研是一个人早上打开电脑,先看隔夜发生了什么,翻两份 10-Q,把上一版模型的假设改掉,写一条三句话的 memo 发给 PM,然后被问「你这个毛利率假设凭什么」,回去把同行拆一遍。它是一段持续几周、几十个来回的过程,而且每一轮都在上一轮的结论上叠加。
LangAlpha 是少数几个认真对待这件事的开源项目。它的自我定位是 a vibe investing agent harness——注意 harness 这个词,不是 agent,不是 model,是 harness,脚手架。这个用词选得极其准确,也是理解它的钥匙。
它其实是在复刻 Claude Code
先看仓库的自我描述,一句话:Claude Code for Financial Market。
这不是营销话术,是架构说明。README 里有一段写得很清楚:
Inspired by software engineering: a codebase persists, and every commit builds on what came before. Code agent harnesses like Claude Code and OpenCode succeeded by building agents that embrace this pattern, exploring existing context and building on prior work.
翻译过来就是:Claude Code 之所以能干活,靠的不是模型参数比别人多,而是它有一整套配套设施——能读写的文件系统、能跑代码的沙箱、能在长会话里不崩的上下文管理、能把危险操作拦下来的权限模型。模型只是这套设施里的一环。
LangAlpha 干的事,就是把这套设施一件件搬进投研场景。搬的方式也很直白,一一对应:
| Claude Code 里的东西 | LangAlpha 里的对应物 |
|---|---|
| 一个 repo 持续存在,每次 commit 在前一版之上 | 一个 workspace 映射一个沙箱,agent.md 持续累积 |
| 代码在沙箱里跑,结果不回灌上下文 | PTC:Python 在 Daytona 沙箱里跑,只回传结果 |
| 派 subagent 并行处理独立子任务 | Task() 派发并行子 agent,上下文窗口互相隔离 |
| 会话太长就自动压缩 | 中间件栈的 auto-compaction 与上下文卸载 |
| 编译、测试是天然的裁判 | 没有裁判——这块它另想办法,后面说 |
这套东西堆起来,就形成了一条相当长的链路。我把它画成一张图:
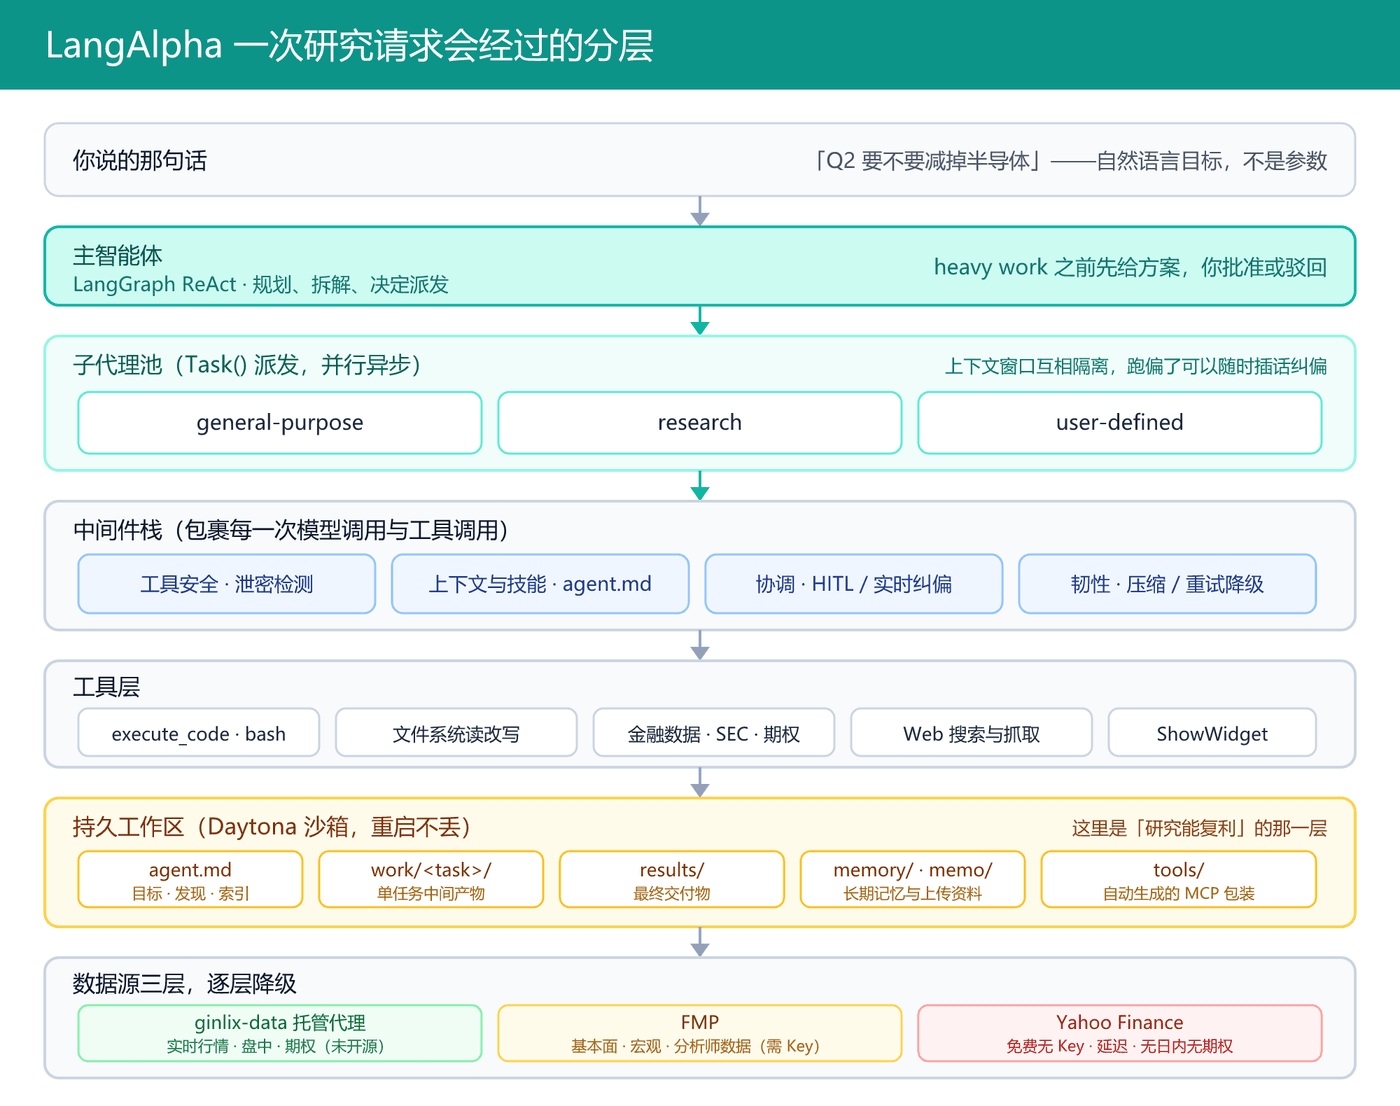
从最上面的自然语言目标,一直到最下面三层可降级的数据源,中间隔了六层。这个复杂度是有代价的,但每一层都有它挡掉的具体问题。下面挑三个最关键的拆。
PTC:把数据挡在上下文窗口之外
Programmatic Tool Calling 是 LangAlpha 最核心的一个设计,也是它跟绝大多数「LLM + 工具调用」方案真正的分水岭。
传统 tool calling 的逻辑是:模型决定调哪个工具 → 工具返回数据 → 数据进上下文 → 模型基于数据决定下一步。听起来没问题,但它的成本结构是 O(调用次数 × 单次数据量)。你要在 500 只股票里筛出毛利率连续三年下滑的那批,模型得看着 500 行数据做筛选;你要读一份完整的 10-K,几万 token 一次性灌进去;等你要读第十份,上下文已经塞满一半了。
PTC 换了个方向:模型不直接处理数据,而是写一段 Python,扔进沙箱执行。沙箱里 import tools.* 就能拿到 MCP 服务器包装好的数据接口,筛选、聚合、画图全在里面完成,只有最终结果回到模型。
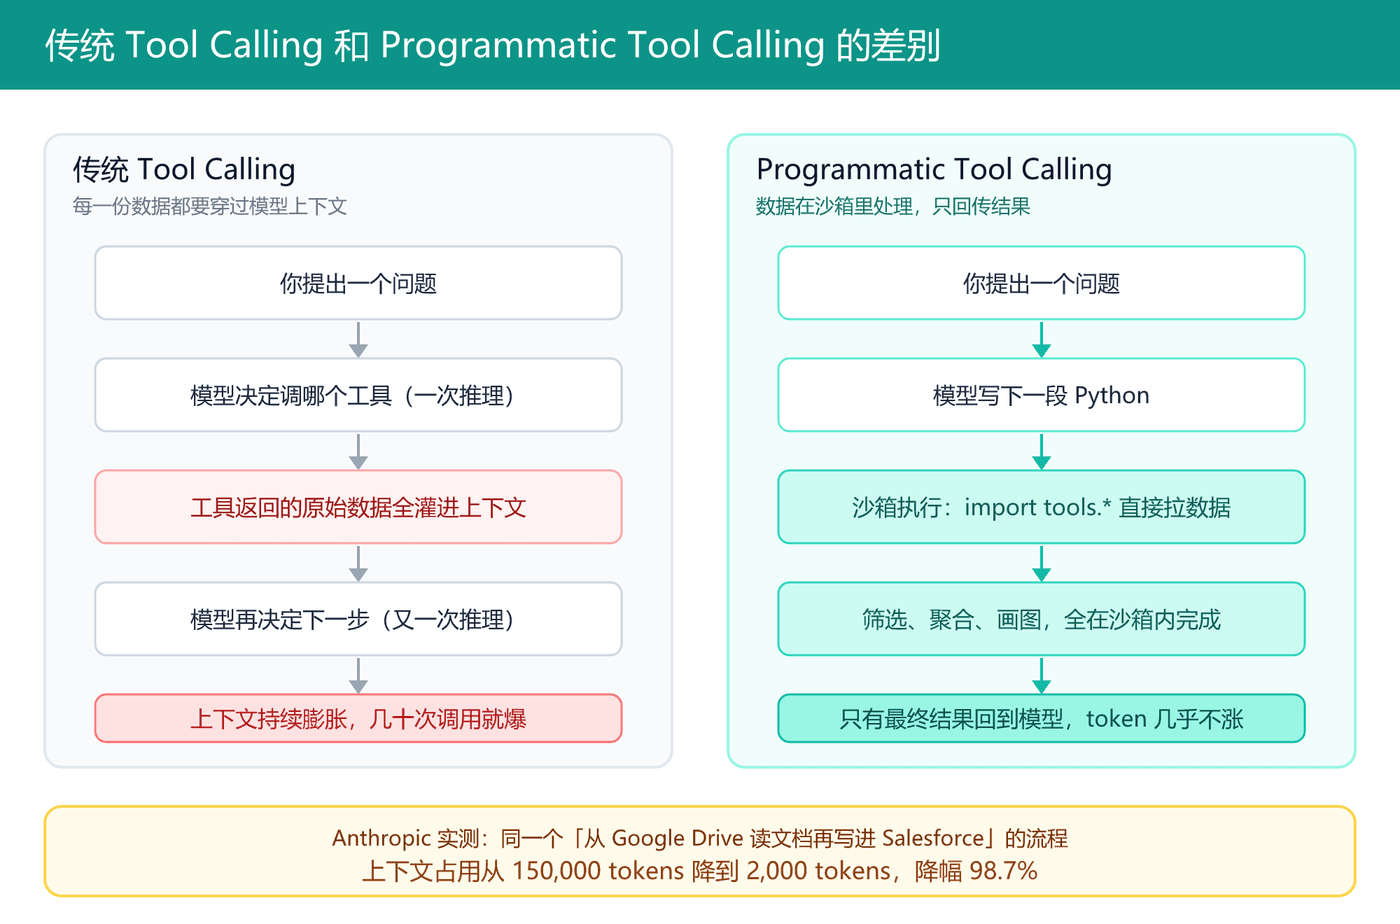
这个思路不是 LangAlpha 独创。Anthropic 在《Code execution with MCP》里讲过同一个模式,给的实测数字是:一个「从 Google Drive 读会议记录再写进 Salesforce」的流程,上下文占用从 150,000 tokens 降到 2,000 tokens,降幅 98.7%。Cloudflare 管这个叫 Code Mode,逻辑一致——LLM 擅长写代码,那就让它写代码,别让它当数据的搬运工。
为什么这在金融场景里格外要紧?因为金融数据的形状天生对上下文不友好。期权链是几万行,收益率曲线是几十年的日频序列,财报表是几十个季度乘几百个字段。这些数据在「人看」的层面是友好的,在「塞进 token 窗口」的层面是灾难。PTC 等于给这些数据开了一条旁路。
这里有个容易忽略的连带收益:数据可以不进模型,也就意味着敏感数据可以不过模型。你从券商 API 拉来的持仓、从内部系统拿到的授信数据,在沙箱里参与计算、只把聚合后的结论送出去。这在合规上是个挺硬的卖点,Anthropic 那篇文章里专门把 privacy-preserving operations 单列了一节。
持久工作区:研究为什么能复利
README 里反复出现一个词,compounds——复利。这是它对「投研该怎么做」这件事的核心判断:
real investing is Bayesian — you start with a thesis, new data arrives daily, and you update your conviction accordingly. It’s an iterative process that unfolds over weeks and months.
基于这个判断,它的用法被设计成:每研究目标开一个 workspace。官方举的例子是「Q2 rebalance」「data center demand deep dive」「energy sector rotation」。第一次进去,agent 会先反过来问你目标、风格、约束,产出第一份交付物,把所有东西写进工作区文件系统。
明天再进来,文件、对话线程、积累的研究全都在。
工作区的目录结构不复杂,但每个位置都有讲究:
| 路径 | 装什么 |
|---|---|
agent.md | 工作区笔记:目标、关键发现、线程索引、文件索引 |
work/<task>/ | 单个任务的中间产物——数据、图表、代码 |
results/ | 定稿的报告 |
data/ | 跨任务共享的数据集 |
tools/ | 自动生成的 MCP 包装模块 |
关键在那份 agent.md。中间件会在每一次模型调用时把它注入上下文,也就是说 agent 不需要重新读文件就知道这个工作区在干什么、之前得出过什么结论。这是个很小的工程决定,但它解决了一个很实际的痛点:传统对话式 AI 里,你换个会话就得把那套背景重新讲一遍。
再往外还有两层:.agents/user/memory/ 和 .agents/workspace/memory/ 存长期记忆,跨沙箱重置仍然保留;.agents/user/memo/ 是你自己上传的 PDF 和 markdown 笔记,服务端做文本抽取、异步生成元数据,agent 可以按主题找到并引用。官方特别点了一句,PDF 的元数据是异步生成的——这个细节说明他们真的在考虑大文件上传时别把主流程卡住。
23 个技能,和实际仓库里的 37 个
技能是它另一块分量很重的东西。23 个预置金融研究技能,按斜杠命令触发或自动识别,覆盖:
| 类别 | 技能 |
|---|---|
| 估值与建模 | DCF、可比公司分析、三表模型、模型更新、模型审计 |
| 股票研究 | 首次覆盖(30–50 页)、财报前瞻、财报分析、论点追踪 |
| 市场情报 | 晨会纪要、催化剂日历、行业概览、竞争分析、想法生成、X 研究 |
| 文档产出 | PDF、DOCX、PPTX、XLSX、HTML 的生成与编辑 |
| 运营 | 投资材料质检、定时任务、用户画像与组合 |
技能的格式遵循 Agent Skills Spec——就是 Anthropic 那套 SKILL.md 规范。你可以往工作区里丢一个 SKILL.md 就扩展一个新技能,不用改框架代码。README 里也很实在地承认了一部分技能改编自 anthropics/financial-services-plugins。
这里我说个拆仓库时发现的细节:README 说 23 个技能,但仓库里实际躺着 37 个 SKILL.md——研究类 20 个、交付类 9 个、服务类 6 个、另类数据 2 个。文档已经落后于代码。这在高速迭代的项目里很常见,但反过来也是个正面信号:它说明功能是真的在往前跑,而不是先写文档再补代码。
顺带一提,Anthropic 自己在 2026 年 9 月也开源了 financial-services 插件(11 个命名 agent,6 个垂直插件)。两边的关系挺有意思:Anthropic 那边是「在 Cowork 里用」,LangAlpha 这边是「自己搭一套跑起来」。同一个 SKILL.md 规范,两种产品形态。
数据层,和它没开源的那一半
这是我在这个项目上最想泼冷水的地方。
LangAlpha 的数据源是三层结构,逐层降级:
| 层级 | 提供方 | 需要 Key | 带来什么 |
|---|---|---|---|
| 1 | ginlix-data(托管代理) | GINLIX_DATA_URL | 实时 WebSocket 行情、盘中数据、盘前盘后、期权数据 |
| 2 | FMP | FMP_API_KEY | 高质量基本面、财报、宏观、分析师数据 |
| 3 | Yahoo Finance | 不需要,免费 | 历史价格、基础基本面、财报、持仓、内部人交易、ESG |
三层默认全开,也能只跑免费层。看起来挺周到,但问题在于第一层。
ginlix-data 是托管代理,GitHub 上没有公开仓库(我实际验证过:ginlix-ai 这个组织下只有 LangAlpha 一个公开仓库,组织本身 2026 年 1 月 17 日才建)。也就是说,你需要实盘级实时行情时,绕不开它们的托管服务。而 price-triggered automation(价格触发任务)这个功能,README 里明说了——beta 期间只在托管平台上可用。
所以「Apache 2.0 开源」这个词得打个折。你拿到的是一套厚实的 harness,不是数据管道。这跟 Anthropic 做 financial-services 的路子完全一致:agent 定义和技能开源,真正的连接器(Schwab、FactSet、S&P Global、LSEG 那一串)是另一回事。Anthropic 那边有篇分析讲得很直白——connector 名单才是护城河,代码不是。
三层里还有一层容易被忽视的落差:Yahoo Finance 那层虽然免费,但官方自己在 README 的 note 里列了它的短板——没有 1 小时以下的日内数据、报价有延迟、宏观覆盖有限、偶尔限流。你如果打算只跑免费层做严肃研究,天花板大概在第一周的第二个下午就会撞到。
缺少裁判,所以它把「可追溯」做成了产品
回到我开头那个观察:代码 agent 有一个天然的奢侈品——编译器当裁判。代码跑不通就是跑不通,测试挂了就是挂了,对错是二值的、反馈是廉价且即时的。所以 Claude Code 这类工具的核心体验是「试错」,错了再改,改到通过。
投研没有这个。你写完一份 DCF,唯一的裁判是三个月后的股价,而那个信号里噪声占大头。更糟的是,很多分析错误根本不会以「报错」的形式出现——它以一个看起来完全合理的数字出现。一个被错误裁剪的同比基数、一段被截断的历史序列,能生出一份逻辑通顺、数字精确、结论错误的研究。
面对这个结构性缺陷,LangAlpha 的选择是把可追溯性做成产品的一等公民,而不是事后补的日志:
- 每个数字往前追一步是算出它的代码;
- 再往前一步是数据的源头;
- 脚本、每一次数据调取、每条结论旁的行内引用,全部摊开;
- UI 里每轮对话旁边挂一个 Sources 面板,按类型分组、带 favicon,展开能看 provider、时间戳、抓取参数、内容指纹和片段;
- 还有「This turn / All sources」开关,能看到整条线程的完整数据足迹。
这个设计我认为是对的,也是它跟通用 code agent 最本质的分野:代码 agent 靠测试自证,投研 agent 只能靠溯源取信。你把「可审计」当成核心能力来建,跟把它当成日志功能来加,产出的产品完全是两个东西。
同一逻辑还出现在另一个细节上:所有工具输出在进入模型上下文之前会扫描已知密钥,命中就替换成 [REDACTED:KEY_NAME],文件读取和下载在送到客户端之前也做同样的处理。密钥加密用 pgcrypto,明文不落库。每个工作区还有一个 vault,agent 能在代码里 from vault import get 取密钥,用于访问第三方数据源。
跟 TradingAgents 那条路线不是一回事
写到这里得把它放进坐标系里,否则容易误判。
先给数据(2026-09-22 实测星标):
| 项目 | Stars | Forks |
|---|---|---|
| TradingAgents | 107,975 | 20,670 |
| ai-hedge-fund | 63,657 | 11,160 |
| FinRL | 16,369 | 3,512 |
| FinRobot | 8,046 | 1,358 |
| LangAlpha | 1,765 | 289 |
差了 60 倍。但把这两个数直接比是不对的,因为它们在做完全不同的事。
TradingAgents 模拟的是「一个交易台在开会」:基本面分析师、情绪分析师、技术分析师各出一份报告,多头研究员和空头研究员当面辩论,最后交易员拍板。它的输出是一个买/卖决策。
LangAlpha 模拟的是「一个研究员在工作台前干活」:你给它一个研究目标,它拆任务、拉数据、写代码算、出图表和备忘录。它的输出是可交付的研究成果——一份 DOCX memo、一个 XLSX 模型、一套 PPTX。
一个在赌方向,一个在产出工作。星标差 60 倍不代表谁更好,它代表的是散户想要信号,机构想要工作流。前者天然是大众议题,后者天然是小众工具。LangAlpha 只有 1765 星这件事,跟它的质量没什么关系。
它真正的风险不在竞品,在别的地方:贡献者集中度。2129 次提交里,Chen-zexi 一个人占了 1966 次,约 92%。第二名 103 次,第三名 27 次。整个组织 2026 年 1 月才建,没有公开的融资信息。这是典型的「一个人写完整个系统」的开源项目——代码质量可能很高(看它 pyproject.toml 的注释就知道作者是认真的人,下面说),但 bus factor 是 1。
顺便说那个注释,我觉得挺能说明团队风格。它解释为什么硬性要求 Python 3.13 而不是 3.12:
# 3.13, not 3.12: the Redis pools block on an asyncio.Condition, and before
# 3.13 a waiter cancelled at its own deadline swallowed a notify instead of
# re-delivering it — so a caller could be told the pool was exhausted while a
# connection sat free. Nothing in this repo can compensate for that.
大意是:Redis 连接池阻塞在 asyncio.Condition 上,3.13 之前,一个在自己超时点被取消的 waiter 会吃掉一次 notify 而不是重新投递,于是调用方会被告知「池子空了」,而实际上还有空闲连接。仓库里没有任何代码能绕开这一点。
把版本约束的原因写成注释、并明确说「这不是偏好,是硬地板」——这种态度的项目不多。
安全、自托管与它的基础设施税
上线方式确实简单,官方说是三条命令:
git clone https://github.com/ginlix-ai/langalpha.git
cd langalpha
make config   # 交互向导:生成 .env,配置 LLM、数据源、沙箱、搜索
make up       # 起 PostgreSQL、Redis、后端、前端
前端 localhost:5173,后端 localhost:8000。诚实的部分是那句 note:没有任何外部服务密钥也能跑起来,Yahoo 提供免费价格历史,Docker 沙箱替代 Daytona 云沙箱,完整 PTC 代码执行仍然可用,但隔离级别降级。密钥可以之后一个个加,每加一个解锁一部分能力。
模型层是 provider-agnostic 的,支持 BYOK,也支持用 OAuth 接 ChatGPT / Claude 订阅,或者用 Kimi、GLM、MiniMax、豆包的编码套餐。自动重试 + 失败降级到备用模型。这一层做得比较扎实,也是它相对好上手的地方——你不需要为了试它去办一张新卡。
但要提醒的是基础设施税。自托管意味着你要自己维护:PostgreSQL 双连接池(一个存应用数据,一个是 LangGraph 的 checkpointer)、Redis(同时干三件事:SSE 事件缓冲 15 万条、行情 API 缓存、steering 队列)、沙箱运行时。任何一块出问题,长时间运行的任务就会中断——而这类任务往往跑在没人的时段。
而且它的发布线是分开的:主版本(v2026.09.07)和自托管的桌面端(desktop-oss-v0.2.3)是两条独立序列。升级前得确认服务端与桌面端兼容,别把 desktop-v0.2.3 当成自托管包。仓库最近的推送时间是今天(9 月 22 日),发布节奏很密,这意味着升级窗口并不宽裕——锁定版本再升比跟着最新走稳妥得多。
谁该用,谁该跳过
我的结论分成三句:
如果你是技术型投研团队,已经在用 Python 3.13 + LangChain/LangGraph,手上也有 LLM 和数据源的凭据,而且你的研究确实需要跨周累积、数据量确实撑爆上下文——那么这个项目值得认真读一遍代码,甚至直接上。它解决的是真问题。
如果你只是想试试「AI 能不能帮我看看这只股票」,那它会让你失望。沙箱、双连接池、15 万条事件缓冲,全是你不需要的成本。用任何通用 chat 工具加上传 PDF 就够了。
如果你要的是一个开箱即用的托管产品,那去用它家的托管版(langalpha.ai),别自托管。自托管的复杂度只在研究确实要复利的时候才换得回回报。
最后一点提醒,官方自己在 README 结尾写得比谁都清楚:
LangAlpha is a research tool, not a financial advisor. Nothing produced by this software constitutes investment advice, a recommendation, or a solicitation to buy or sell any security.
它只负责把分析做好,要不要出手始终是你的决定。这一点它守得很紧——没有任何券商接入,没有任何下单能力,价格触发任务也只是把分析结果送到你手上。在一个到处都在喊「AI 自动交易」的年份,这种克制反而有点难得。
参考资料
- LangAlpha 官方仓库:https://github.com/ginlix-ai/LangAlpha(Apache License 2.0)
- 托管平台:https://langalpha.ai / https://www.ginlix.ai
- Anthropic《Code execution with MCP: Building more efficient agents》:https://www.anthropic.com/engineering/code-execution-with-mcp
- Anthropic《Introducing advanced tool use on the Claude Developer Platform》:https://www.anthropic.com/engineering/advanced-tool-use
- Anthropic 开源金融插件仓库:https://github.com/anthropics/financial-services
- Agent Skills 规范:https://agentskills.io/specification
- Daytona 沙箱:https://www.daytona.io
- 竞品对比参考:TradingAgents https://github.com/TauricResearch/TradingAgents、ai-hedge-fund https://github.com/viratt/ai-hedge-fund、FinRobot https://github.com/AI4Finance-Foundation/FinRobot
文中星标数、提交数、技能数量等数据于 2026 年 9 月 22 日通过 GitHub API 与仓库文件树实测,会随时间变化。
其他动态
智谱把 ZCode 全栈开源了,起因是一场「静默上传」。9 月 21 日,GLM 背后的智谱把 ZCode 桌面端、Web 工作台、后端、Agent CLI 与运行时整套以 Apache-2.0 开源(6973 个文件、约 103 万行)。触发点是开发者逆向发现其客户端会打包整个工作区——一个项目 42,411 个文件、313MB 的 AES-256-CTR 加密归档,其中 .git 数据占 86.6%——并直传阿里云 OSS,而界面上的两个「隐私开关」只管训练用途、不管采集与上传。中国信通院与绿盟科技的审计确认 OSS 桶及全部对象已删除,v3.14.0 移除了 RepoWiki 与快照上传链路。同一时间,智谱 MaaS 上线「数据内容不留存」。这件事值得所有做 coding agent 的人抄一遍:一个设置开关不是安全边界,只有代码和网络行为才是。
Harvey 的毛利率从 +50% 崩到 −50%,靠开源权重翻正。彭博社 9 月 22 日报道,估值 156 亿美元的法律 AI 公司 Harvey 今年 token 用量涨了 20 倍,毛利率从年初约 50% 一路跌到 6 月的 −50%;8 月它基于月之暗面 Kimi K3 后训练出自研模型后重新转正。Abridge 按英伟达开放权重训临床模型、Decagon 已有 80% 查询走自有模型、Ramp 首次开始评估自训,红杉与 General Catalyst 在背后推。这是闭源模型的「token 税」第一次被公开算账——上一轮讲 harness 护城河时我们问「钱最终流向谁」,这条是部分答案。
清华、无问芯穹、正行创新联合开源 RPent。9 月 21 日发布,把通用大模型的规划能力、VLA 专家模型的精细操作、记忆与机器人接口接成「观察—判断—执行—纠错」闭环;LIBERO-PRO 基准 92.6% 任务成功率,端到端提速 7 倍以上,成功经验会沉淀成可复用的任务卡。数字世界那套 agent 范式——理解目标、拆解、调工具、反馈纠错——正在被整体搬到物理世界。这跟今天主线里 harness 的抽象是同一个东西,只是底座从文件系统换成了机械臂。
SpaceXAI 发布 Grok 4.7。9 月 21 日上线,官方定位「最强的编程与知识工作模型」,CursorBench 4.0 得 46.3%(上一代 40.4%)、Terminal-Bench 4.0 从 20.3% 跃到 38.0%,定价维持每百万输入 2 美元 / 输出 6 美元,已进 Cursor、Grok Build 与 Grok API。注意它对标的是 harness 里的模型位,不是 harness 本身——这恰好是本文反复强调的分层。
Claude 已主导 Anthropic 自己的 26% 研发。官方披露,截至 2026 年 8 月 Claude 承担了公司 26% 的 AI 研发工作,而 3 月这一比例还不足 1%;内部平台同时运行 3 万多个智能体自主参与模型迭代与调试。另一边《The Information》报道 OpenAI 内部 AI 已基本能自动化新实验模型的训练流程、多个智能体开始互相协作。RSI 从愿景词变成季度数据,值得盯着。
Cursor 云 agent 已产出公司内部逾 60% 的合并 PR。同时 9 月上线自托管机器,让企业把源码、构建产物与密钥留在自己网内;VS Code 9 月 16 日版则把 agent 装进本地 Dev Container 并引入 Agent Host。agent 跑在哪、能碰什么,正在成为企业采购时的第一道判断题。
智元与长隆合建全球首个大型具身智能主题乐园。9 月 21 日披露,园区将部署 300 余台机器人、100 余个交互点,走 5G-A 组网。从展台到货架再到「买票入场」,具身智能的商业化叙事又往前挪了一格——但乐园是受控场景,跟真机量产交付仍是两回事。
微信公众号
欢迎关注「字与码」
如果这篇文章对你有用,也欢迎在微信里继续关注后续更新。
X / Twitter
关注 @ax2_zicode
更即时的技术观察、新文章提醒和一些短想法会发在 X 上。