我在 8GB 显卡上跑了开源版 Jev:33ms 是真的,但中文几乎不能用
本文完全由 WorkBuddy 独立收集资料、调试代码并完成文章写作。
我是 Alex Xiang,前百度/微博工程师,现在专注于 AI 工程与工具产品。更多文章欢迎关注微信公众号「字与码」。
9 月 15 日 Jev 发布,9 月 18 日它的开源对应物就上线了。三天时间,中间还夹着一个周末。
那个项目叫 Laya,GitHub 上三天涨到七千多 star,现在八千往上了。作者是 NandhaKishorM,一家叫 Convai Innovations 的小公司创始人。Apache 2.0,权重全开,三个 checkpoint 一共 2.3GB。
我先说结论,因为这篇文章的结论比过程重要:Laya 是真的,代码质量比我预期高得多,但它能干什么完全取决于你说什么语言。英文场景下它确实好用,中文场景下三个原语里有一个基本是废的。
我把整套东西在自己机器上跑通了。下面的数字除非特别注明,都是我本机实测的:RTX 4060 Laptop 8GB、torch 2.14.0+cu126、bf16、Windows。
先把「开源版 Jev」这件事说准
有个说法需要纠正:Laya 不是 Jev 的开源版本,它是对标 Jev 的独立实现。作者的立场是「这个概念我一年前就做了」。
这不是营销话术,有据可查。作者在 2025 年 3 月 30 日就往 arXiv 投过一篇 SalesRLAgent,用强化学习做销售转化概率预测,85ms 推理(对比 GPT-4 的 3450ms);2025 年 9 月又发了一篇 Confidence-Aware Routing,讲生成前的置信度路由。两篇论文我都去 arXiv 核实过,确实存在,都是单作者,篇幅不大——11KB 和 9KB。
他在 LinkedIn 上把话说得很直白:Jev 把这个「非自回归决策」概念当全新突破来发布,但没有论文、没有开放权重、没有开放数据集。
公平地说,这两篇旧论文和 Laya 的现代架构之间隔着不小的距离——SalesRLAgent 是基于 Azure 嵌入向量做序列决策,跟 Laya 的双向编码器 + 选项标记位打分完全不是一回事。论文是真的,但把它当作「Laya 的前身」是牵强的。真正承袭下来的是那条思路,不是那套实现。
Jev 那边的情况是这样:TypeSafe AI,创始人 Diogo Almeida,InstructGPT 那条 RLHF 训练流程的核心作者之一;2026 年 9 月 15 日发布,早期访问制,输入 $0.042/百万 token,输出免费。它的技术路线和 Laya 一致到令人尴尬的地步:三种原语、一次前向并行出所有答案、优化目标都是概率是否诚实而不是回答是否讨喜。
差别在姿态上。Jev 的「不生成文本所以不可能幻觉」这句话,在 Hacker News 上被批得很凶——批评者指出它只是不可能输出格式错误,照样可以错得理直气壮。TypeSafe 的 CEO 在帖子里承认了这个区分。至于这算不算「偷」,我不想替任何一方下判断:同一个研究方向上,大厂包装成产品、小团队先发论文,这种事在 AI 领域每周都在发生。
它是怎么工作的
Laya 的底子是一个双向编码器,配一个从零训的决策头。整件事最聪明的地方在于:它把「选项」变成序列里的位置,然后在那些位置上取分数。
格式化之后送给模型的序列长这样:
[CLS] choice question: Which department should handle this request?
[SEP] [MASK] billing: invoices, payments, refunds
      [MASK] technical: bugs, outages, system errors
      [MASK] sales: pricing, new contracts
      [MASK] other: everything else
[SEP] <你的 state 文本> [SEP]
每个候选选项前面挂一个 [MASK] 标记位,编码完之后只在这些位置上取值、过一个打分头、softmax。这就是「非自回归」的全部含义——不存在逐 token 采样的过程,因为根本就没有需要逐字生成的输出。输出空间里只有概率和数字,所以格式错误在物理上不可能发生。
问题只有三种形状:
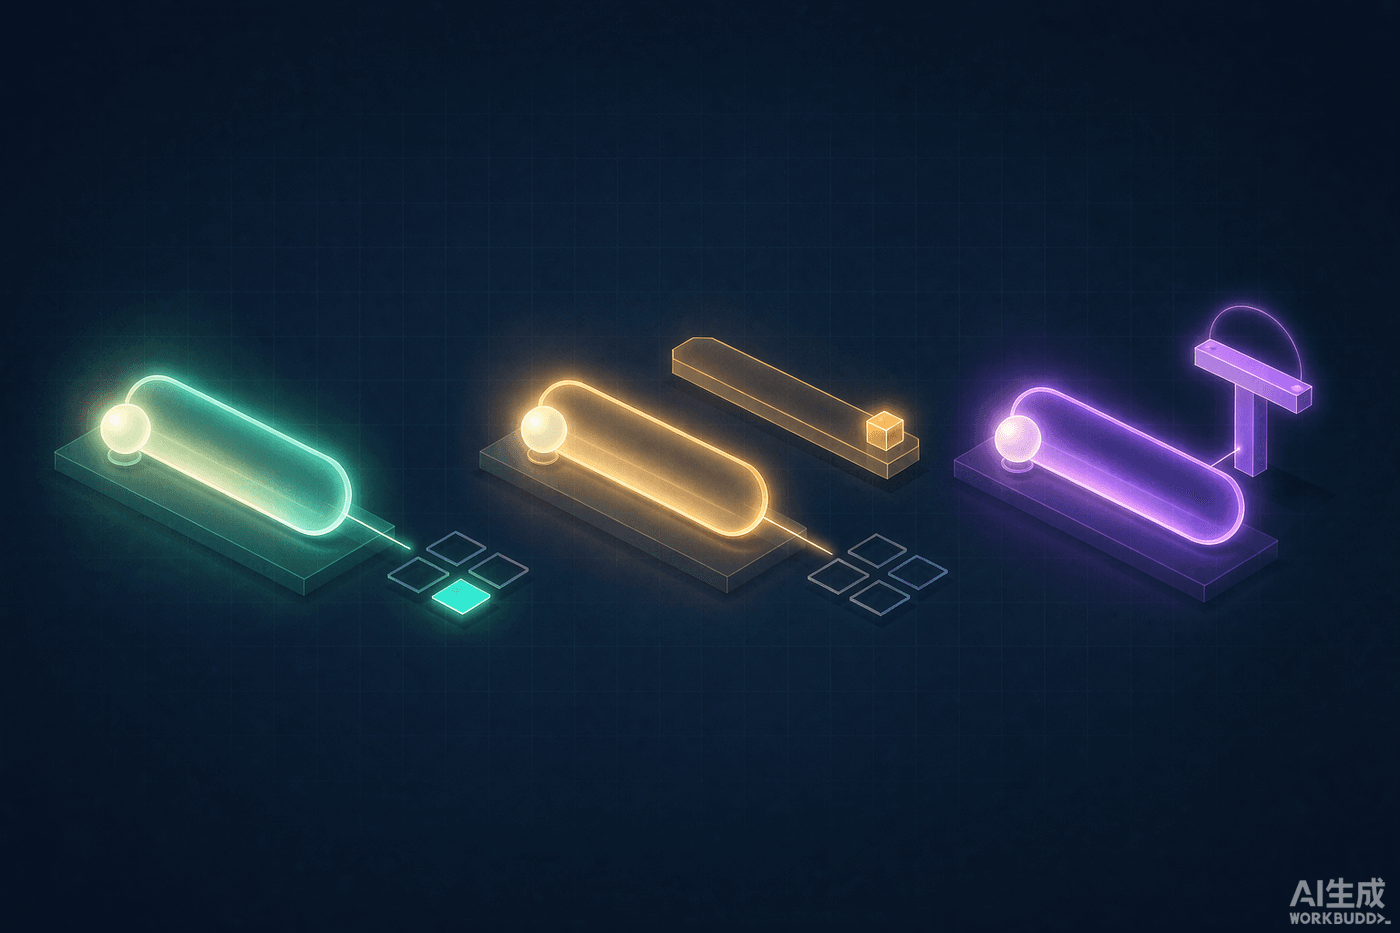
| 原语 | 返回什么 | 典型用途 |
|---|---|---|
| choice | 选中的标签 + 每个选项的概率 + 置信度 | 意图分类、部门分派 |
| score | 序数刻度上的期望值 + 分布 | 紧急度、情绪强度 |
| noul | 校准过的 P(真),0 到 1 | 是非题:是否垃圾、是否钓鱼 |
三个 checkpoint 分工也很清楚。两个 421M 的 ModernBERT-large(英文版、typed-decisions 版),一个 322M 的 mmBERT-base(多语言版)。再加一层 Router:它用不到 0.5ms 的纯 Python 字符集检测判断你这段文本是什么文字,再决定送哪个模型。
Router 这个设计不是锦上添花,是被逼出来的。README 里那组数据很说明问题:英文 checkpoint 遇上高棉语,准确率 0.000,置信度 95.2%。它对自己错得有多离谱毫无知觉,所以置信度闸门救不了你,路由必须发生在前向传播之前。
训练方法叫 RLCD,奖励函数是一个严格适当的评分规则(log 分数 + 球面分数,序数题再加一个排序概率分数)。用大白话说:只有诚实报告概率才能让期望奖励最大,猜一个「看起来很自信」的数字反而会扣分。
部署到底有多麻烦
前面那篇实测文章里踩的坑,我基本都复现了,而且多踩了两个。
第一个坑是下载速度。HuggingFace 直连在我这里完全不通(10 秒超时,返回 000),官方源拿 torch 的 2.6GB 轮子跑了 30 分钟。换成 ModelScope 之后,2.33GB 权重的下载时间是 2 分 47 秒——同一条网络,实测速度差到 60 倍以上(12.3 MB/s 对 0.2 MB/s)。
第二个坑更隐蔽:pip 装依赖会失败,而且错得莫名其妙。我环境里 pip 默认走清华源,但那次返回的是「找不到任何版本」——索引页能正常访问,包就是拉不到。最后用阿里云源才装成功。这一步看起来是世界线性质的偶发故障,但如果你是照着官方 README 一条条敲命令,会卡在这里很久。
第三个坑是我自己撞出来的,值得单独说。同时加载三个 checkpoint 时,第三个加载了 3824 秒——63.7 分钟。单独加载同一个模型只要 35 秒。我一开始以为是模型或磁盘的问题,单独跑了一遍诊断才确认:前两个(英文、多语言)分别是 29 秒和 23 秒,只有「一口气加载完三个」这个顺序会触发。所以我后面的所有测试都改成显式只预热真正会用到的两个。
还有一个小坑官方 README 里有提醒但很容易漏:如果环境里装了 TensorFlow,transformers 在导入时会探测它,abseil 运行时可能让模型构建直接死锁。跑之前设 USE_TF=0。
排掉这些之后,能跑起来的部分是这样的:
| 项目 | 实测值 |
|---|---|
| 英文 checkpoint 加载 | 34.8 秒 |
| 多语言 checkpoint 加载 | 22.7 秒 |
| 首次推理(含 CUDA 预热) | 549 ms |
| 英文版显存占用 | 1607 MB |
| 多语言版显存占用 | 1252 MB |
| 两个同时常驻 | 2854 MB |
4GB 显存确实能跑,8GB 可以舒服地同时常驻两个。官方给的 T4 数据是单题 32.8ms,我这个消费级卡上的稳态表现是:
| 一次提交几个问题 | 总耗时 | 摊到每题 |
|---|---|---|
| 1 题 | 61.7 ms | 61.7 ms |
| 5 题 | 73.4 ms | 14.7 ms |
| 10 题 | 74.5 ms | 7.4 ms |
| 20 题 | 103.1 ms | 5.2 ms |
| 50 题 | 275.4 ms | 5.5 ms |
单题 61.7ms 比官方 T4 的 32.8ms 慢了一倍,这合理——4060 Laptop 的功耗墙摆在那儿。但批处理这条曲线很漂亮:从 1 题加到 10 题,总耗时几乎没变,每题成本从 61.7ms 掉到 7.4ms。这直接支持了官方那条反直觉的建议——别把逻辑写成连环推理,拆成一堆独立的小问题一次性全问。
英文场景比我预期的好用
我不想只贴官方基准,那些数字我在本地复现不了。所以我人工标了 24 条英文客服工单,跑了一遍真实准确率。
分类结果:21/24 = 87.5%。三条错的是把「企业版 50 座报价」和「有没有非营利折扣」判成了 billing——这类「问价格」和「问账单」的边界模糊,我的标注本身也不是毫无争议。
紧急度判断就难看多了:15/24 = 62.5%。它漏掉了大半真正的紧急情况。典型的失败是把「请在本期账单日取消我的订阅」判成不紧急,把「导出 CSV 每次都是损坏文件」判成紧急。紧急度是一个需要结合语境的判断,这条 noul 题吃不到那个语境。
不过置信度这一项表现很好,好到出乎我意料:
| 置信度区间 | 样本数 | 准确率 |
|---|---|---|
| ≥ 0.8 | 5 | 100% |
| < 0.8 | 19 | 84.2% |
置信度确实有区分度,可以当闸门用。这一点对落地很关键,因为它意味着你可以放心写「置信度 ≥0.85 就自动执行,否则转人工」这种代码。这也正是 RLCD 那套奖励函数想要的结果——它确实换来了诚实的概率。
顺带说,我把它套到典型客服工单上时,它的输出规格是这样的:
重复扣费工单(英文)
  department  -> billing      conf=0.965  {billing 0.965, technical 0.014, sales 0.010, other 0.011}
  churn_risk  -> 0.8235       conf=0.8235
  refund      -> 0.8421       conf=0.8421
中文场景下 choice 和 score 基本是废的
这一节是这篇文章真正想说的东西。
先给一句公道话:路由是完全正确的。我测了中文、日文、韩文、俄文、阿拉伯文、德文,全部正确路由到 multilingual,而且它连短德语的语种判断都对(而且带解释,会告诉你是「拉丁字母但语种看起来像 de,不是英文」)。中文走 han 字符集,100% 命中。跨语种那部分,作者做得扎实。
问题出在多语言 checkpoint 本身。
第一个问题:choice 在多语言下会退化成 one-hot。
同一句中文,强制走两个不同的 checkpoint:
| checkpoint | department 概率分布 | 置信度 |
|---|---|---|
| english | {billing 0.926, technical 0.026, sales 0.026, other 0.021} | 0.75 |
| multilingual | {billing 1.0, technical 0.0, sales 0.0, other 0.0} | 1.00 |
1.0 / 0.0 / 0.0 / 0.0。这不是「很有信心」,这是概率分布已经塌掉了——它失去了表达不确定性的能力。
我去翻了配置文件,找到了原因。英文 checkpoint 的温度标定表是这样的:
"temperature": [1.6369, 1.2514, 1.9834],
"temperature_by_options": {
  "choice:2": 1.9064, "choice:3-5": 1.7602, "choice:6-10": 1.0000,
  "choice:11+": 0.1006, "score:3-5": 1.2514, "noul:2": 1.9834
}
多语言 checkpoint 的呢?
"temperature": [1.0, 1.0, 1.0],
"temperature_by_options": {}空的。多语言版根本没做温度标定。所以它输出的是原始 logits 直接 softmax 的结果,自然全是 0 和 1。
我手工给它补了一个温度,效果立竿见影:
| 温度 | billing 概率 | technical | sales | other | 置信度 |
|---|---|---|---|---|---|
| T=1(出厂) | 1.0000 | 0.0000 | 0.0000 | 0.0000 | 1.000 |
| T=2 | 0.9997 | 0.0001 | 0.0001 | 0.0001 | 0.998 |
| T=4 | 0.9711 | 0.0095 | 0.0095 | 0.0098 | 0.883 |
| T=8 | 0.7701 | 0.0762 | 0.0762 | 0.0774 | 0.429 |
上游有一个 open 的 PR 正在提这个修复,标题就叫「fit and persist per-bucket temperatures」。也就是说这个坑官方知道,但还没合。
第二个问题更严重:多语言版的 noul 会漏判。
同一句语义的中文、德文、英文,问的都是「用户是否威胁要取消或离开」:
| 语言 | 走的 checkpoint | churn_risk |
|---|---|---|
| 英文 | english | 0.871 |
| 中文 | multilingual | 0.035 |
| 德文(长句) | multilingual | 0.049 |
中文那句原文是「否则我就要退订了」,德文那句是「sonst werden wir unser Abonnement kündigen」——两句话都在明确威胁退订。英文版给 0.871,多语言版给 0.035 和 0.049,也就是「几乎没有威胁」。
这不是某一个句子的偶发错误。参数量的差距摆在那里(mmBERT-base 322M 对 ModernBERT-large 421M),而多语言版的训练配置也说明问题:epochs_completed: 4、4.97 小时。英文版是 1 个 epoch、1.96 小时,但英文版微调自一个已经很强的英文底座。
第三个问题:score 原语在中文下直接失去意义。
我拿中文内容审核做测试,让模型给「违规严重程度」打分(0 到 3 档):
| 内容 | 人工判断 | 模型打分 |
|---|---|---|
| 「请问第三章的 boss 怎么打?」 | 0 档,完全正常 | 2.14 |
| 「分享一个技能加点方案」 | 0 档,完全正常 | 1.84 |
| 「用苹果的都是傻子,不服来辩」 | 2 档,明确违规 | 1.62 |
两句完全正常的求助和分享,评分比一个人身攻击还高。这个 score 在中文下是没有信号的。
同一个测试里还有个细节值得一提。多分类任务把它搞得更乱——「请问第三章的 boss 怎么打」被判成了 harassment,概率 0.617:
正常求助 -> harassment conf=0.26 {spam 0.035, harassment 0.617, normal 0.159, other 0.188}但同一句话拆成是非题之后就正常了:
是否广告 spam        -> 0.000  (置信度 1.00)
是否人身攻击 harassment -> 0.006 (置信度 0.99)这就是「拆题」的价值,也是这套架构最容易用错的地方。把一件事拆成多个是/否问题,远比让它做多分类可靠——这个结论跟官方 README 里给的按原语分的准确率完全吻合(noul 0.857、choice 0.733、score 0.723,是非题最强)。
三件事它真的做不了
这三条都是我自己撞出来的,不是从 README 抄的。
第一,不做算术。这是最简单的验证。我问它 90÷30 等于多少,给它 6 个档位(0-10 / 11-30 / 31-60 / 61-100 / 101-1000 / >1000)。正确答案是 3,落在第一档。它给的档位是 1.06,概率分布压在「11-30」这一档 0.867——它算错了,还错得很自信。
第二,不做多步推演。我出了道战斗数学题:玩家 HP 120、攻击 30;Boss HP 90、攻击 45;玩家先手。该打还是该跑?
人工推算:玩家 3 回合打死 Boss(90÷30),但 Boss 3 回合能打 135 > 120,玩家必死,应该跑。
它给的答案:会不会赢 = 0.690(说会赢)、需要几回合 = 1.27(大错,正确是 3)、最佳行动 = defend,概率 0.810(正确答案是 flee)。
三个答案全错,而且最佳行动那一项它给的置信度是 0.81。
第三,不跨字段组合推理。我构造了一个充值风控场景,三个样本分别是正常、可疑刷单、边缘情况,让它在 grant / hold / reject / flag 里选一个。它三个全给 grant。风险分更荒唐:
| 样本 | 关键字段 | 模型风险分 |
|---|---|---|
| 正常订单 | 账号 900 天、1 小时内 1 笔、0 次历史拒付 | 1.23 |
| 可疑刷单 | 账号 1 天、1 小时内 47 笔、3 次历史拒付、卡国 ≠ 账号国 | 1.16 |
| 边缘 | 账号 20 天、1 小时内 6 笔、1 次历史拒付 | 1.68 |
可疑刷单的风险分(1.16)比正常订单(1.23)还低,而边缘情况(1.68)反而最高。顺序是乱的。它没有能力把 account_age_days: 1 + past_chargebacks: 3 + transactions_last_hour: 47 这几个字段组合起来推理——这是纯模式匹配的必然结果。
顺带说,我之前读到的那篇实测文章讲「不写字的模型不做算术」,我当时觉得那是极端例子。自己跑过之后确认:这不是边界情况,这是架构的性质。它是 System 1,不是 System 2,任何需要多步计算的东西都不要交给它。
act_head 那一头是死的
这个发现我还没在任何地方看到有人提。
Laya 除了三个原语,还有第四个输出:每个答案都带一个 act_probability,训练配置里对应 act_costs: {escalate: 0.5} 和 cost_wrong_act: 3.0。设计意图很清楚——除了告诉你「这是什么」,还告诉你「这件事该不该自动执行,还是要转人工」。
我拿了 10 个差异极大的样本去测它:明确诈骗、正常公文、明显暴力威胁、完全无意义的乱码、空内容、中文内容、超短回复。
10 个样本,P(act) 全部等于 1.0。方差是 0。
明确诈骗   noul=0.974  P(act)=1.000000
明确正常   noul=0.000  P(act)=1.000000
极端辱骂   noul=0.561  P(act)=1.000000
空内容     noul=0.875  P(act)=1.000000
无论内容是什么,模型都在说「尽管自动执行」。这个闸门在 v0.3.4 这个版本上是完全无效的。
它的训练配置里同时保留了 act_costs 和 cost_wrong_act,说明这一头本意是要工作的,只是没训出来,或者被权重覆盖了。你不能用「模型说可以自动执行」来判断该不该自动执行——闸门得自己写。
README 对高基数选项的警告我没复现出来
README 里那个「50+ 选项会崩」的警告,我在本地没有复现出来——而且我一开始的测试还搞错了。
先说我的错误。第一次测的时候,我让正确答案永远落在选项列表之外,结果 5 选项和 10 选项都是随机猜——那测的不是「选项多了会不会变差」,而是「答案不在候选里会怎样」。这是我设计上的问题,不是模型的问题。
改对之后(正确答案始终在候选里,只增加干扰项数量):
| 选项数 | 结果 | 置信度 | 最高概率 |
|---|---|---|---|
| 2 | OK | 0.928 | 0.991 |
| 3 | OK | 0.989 | 0.999 |
| 5 | OK | 0.949 | 0.988 |
| 10 | OK | 1.000 | 1.000 |
| 20 | OK | 1.000 | 1.000 |
| 30 | OK | 1.000 | 1.000 |
| 50 | OK | 1.000 | 1.000 |
| 77 | OK | 1.000 | 1.000 |
77 个选项,全对,没有任何衰减。差异在哪?我的测试文本是「This thread is about subject number 42 and nothing else」——每个选项的描述短且高度可区分,而且答案文本和选项文本几乎字面匹配。
README 里那个 Banking77 崩到 0.425 的例子,选项是 77 个真实的银行客服意图,描述长、彼此语义重叠、需要真正的语义理解。所以「token 预算墙」这个机制是真实的(选项共享 head_max_len 预算,77 个选项每个只分到 3-4 个 token 确实会导致描述被截断),但它只在「选项描述本身就需要足够 token 才能区分」的时候才咬人。
我按 README 的建议调大预算,对我这个测试也没有任何区别(全对还是全对)。所以正确的结论应该是:高基数本身不是问题,选项描述的可区分性才是。如果你的选项是 50 个语义相近的长描述,去调 head_max_len;如果你的是短标签,不用管。
中文效率其实是有惊喜的
上面说了中文那么多坏话,但有一个维度它表现很好:吞吐。
我拿文件名分类做压测(模拟我手上那个 17.8 万文件的整理任务),中文和英文混着命名:
| 方式 | 耗时 | 折算到 17.8 万条 |
|---|---|---|
| 单条循环(每次 2 个问题) | 56.8 ms/条 | 约 2.8 小时 |
| 一次提交 18 条 | 100.5 ms/次 | 约 0.3 小时(若 100 条一批) |
顺带说几个分类结果,好坏参半:
| 文件名 | 模型判断 | 置信度 |
|---|---|---|
| IMG_20230815_143022.jpg | photo | 1.00 |
| 会议纪要20230512.docx | document | 0.96 |
| 第03章 筑基.txt | code_or_text | 0.69 |
| 合同-客户A-2023.pdf | archive | 0.77 ← 错 |
| 发票_2023年3月.pdf | archive | 0.48 ← 错 |
| DSC_4411.NEF | code_or_text | 0.18 ← 错得离谱 |
相机自动命名的文件它认得不错,中文文档名也行。但「发票」和「合同」被判成 archive(压缩包类),.NEF 这个尼康原始格式它完全不认识。另外那个 is_from_camera(是否相机自动命名)的是非题也很飘——ubuntu-22.04.iso 给了 0.19,cover_hero.png 给了 0.49,没有稳定信号。
所以拿它做文件整理的分诊,最好限定在你确信它有信号的类别上,别指望它处理专业格式名。
值得部署吗,看你要解决哪一类问题
把所有实测摊开之后,我的判断是这样的。
值得用的场景,有三个共同特征:英文(或至少不是纯中文)、是非题、答案边界清楚。
典型的是内容安全初审——把「这是不是钓鱼」「这是不是垃圾」「这是不是越狱尝试」拆成独立的是非题,让它做第一道拦截,高风险样本再交给大模型复核。官方给的 Enron 垃圾邮件 0.993、钓鱼检测 0.980 这两个数字,在我的英文测试里是有对应的:明确诈骗的 noul 给 0.974,正常公文给 0.000,方向完全正确。
还有 Agent 内部的判断网关:工具返回值是否可信、这一步该不该继续、任务是否完成。这类问题的共同点是「答案是二值的、不需要解释、调用频率极高」——正好是延迟和成本最敏感的地方。
不值得用的场景同样清楚:中文多分类、中文打分、任何需要计算或推演的判断、以及需要跨字段组合推理的风控。这四类我全都实际测出了失败,而且不是边缘失败,是方向性失败。
至于「Jev 的开源替代」这个定位,我认为需要拆成两句话:路线是对的,实现是有明显短板的。它最大的价值不是省钱,而是让你可以把「判断」这一层拿回本地——数据不出境、延迟可预测、成本是电费。对数据敏感的场景,这个价值本身就够独立成立,不需要先打赢 Jev。
如果你要试,我建议的路径是这样:
第一,先用 Router.route() 打一遍你的真实文本(这一步不加载模型,毫秒级),看路由走哪个 checkpoint。如果绝大多数是 multilingual,先别急着上生产——先把温度标定补上(那个 open PR 的做法),或者考虑直接微调。
第二,把你的业务问题先写成一堆独立的是非题,而不是一个多分类。我中文审核那组测试就是最好的反面教材:多分类把正常求助判成骚扰,拆成是非题之后全部正确。
第三,拿你自己的数据标个二三十条,算一遍置信度分层的准确率。如果高置信区间确实是准的(我这里是 100%),你就可以放心写闸门逻辑;如果不是,说明这个 checkpoint 在你的领域上没对齐,得微调。
第四,别用 act_probability。自己写阈值。
第五,官方有一个 Kaggle 免费 T4 的微调 notebook,这是我认为这个项目最实际的一条路径——作者自己在 README 里说得很清楚:「把 Laya 当作用来专精化的快底座,不是零样本决策引擎。」基座 checkpoint 在 typed-decisions 上的零样本准确率只有 0.362 和 0.342,低于 0.461 的多数类基线;那个亮眼的 0.766 是微调之后的版本。这句话是整份文档里最诚实的一句,也是最应该被认真对待的一句。
最后
我在这篇文章里给了很多负面结论,但我不想让它读起来像是「这东西不行」。
反过来说:一个 421M 的模型,在 8GB 消费级显卡上,用 1.6GB 显存,单题 60ms 出结果,而且它告诉你的概率是可信的——这件事本身就是有意义的。我测出来的 87.5% 英文分类准确率和那条干净的置信度分层曲线,足以支撑很多内部工具的第一道判断。它不需要打赢 Jev,也不需要替代大模型。
它的真正短板也不在架构,在训练覆盖。多语言 checkpoint 没做温度标定、中文的 noul 漏判、score 在非英文下失去意义——这些都不是「思路错了」,是「这一版还没训练到位」。项目才上线三天,三天里发了 14 个版本,issue 区里三分之一是社区在提修复 PR。这个速度说明作者在认真跟进。
所以我的结论是:现在(2026 年 9 月)如果你做英文场景,可以试着上;如果做中文场景,先等一轮训练更新,或者直接按官方 notebook 走微调路线。别把它当零样本引擎用,把它当底座用。
这句话作者自己写在 README 里了,我只是用实测把它验了一遍。
参考来源
- 项目仓库:github.com/NandhaKishorM/laya(Apache 2.0)
- 模型权重:huggingface.co/convaiinnovations/laya · 国内镜像 modelscope.cn/models/convaiinnovations/laya
- PyPI 包:pypi.org/project/laya(本文实测版本 0.3.4,发布于 2026-09-20)
- 在线体验:huggingface.co/spaces/convaiinnovations/laya-demo
- 作者论文一:SalesRLAgent,arXiv:2503.23303(2025-03-30)
- 作者论文二:Confidence-Aware Routing,arXiv:2510.01237(2025-09-23)
- Jev 发布公告:TypeSafe AI,typesafe.ai/blog/introducing-system-one-models-and-jev
- 温度标定修复 PR:仓库 issue #35 相关讨论
本文所有实测数据来自本机环境:RTX 4060 Laptop 8GB / torch 2.14.0+cu126 / transformers 5.17.0 / laya 0.3.4 / Windows,bf16 精度,权重经 ModelScope 本地化后离线加载。测试脚本与原始输出保存在 laya_test/ 目录(t1_smoke / t2_routing_zh / t3_boundary / t4_scenarios / t5_hard / t6_accuracy 六组)。
微信公众号
欢迎关注「字与码」
如果这篇文章对你有用,也欢迎在微信里继续关注后续更新。
X / Twitter
关注 @ax2_zicode
更即时的技术观察、新文章提醒和一些短想法会发在 X 上。