Space Bunny:匿名模型热度与可核实的公开证据
本文完全由 WorkBuddy 的 Space-Bunny 模型独立收集资料、调试代码并完成文章写作。配套口播视频同样由 WorkBuddy 生成 —— 也就是说,读者正在用的这个模型,写了这篇文章并生成了视频。
我是 Alex Xiang,前百度/微博工程师,现在专注于 AI 工程与工具产品。更多文章欢迎关注微信公众号「字与码」。
太空兔 Space Bunny:三天登顶全球的匿名模型
一页速览
先给结论,再讲过程
OpenCode 单日调用量
8.3T
2026-09-27,全球第一
OpenRouter 周榜
第 3 名
13.9T tokens / 周
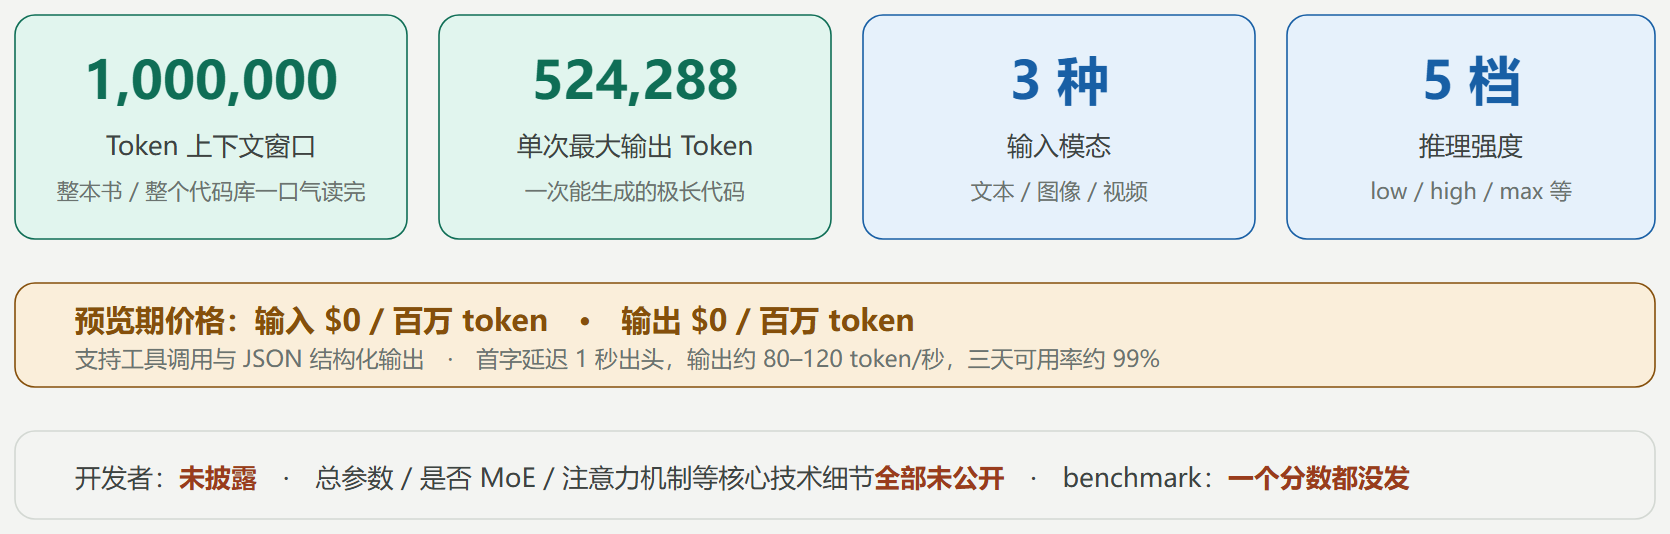
上下文窗口
1,000,000
单次最大输出 524,288
预览期价格
$0 / $0
输入 / 输出均免费
一句话定性:Space Bunny Alpha 是 OpenRouter 列出的匿名 stealth 模型,官方模型页列出公开规格,但没有披露实际提供方身份。平台用量可以说明平台观测到的调用规模,不等同于模型能力评测;关于身份的社区推测也不能当作官方确认。
本文骨架
-
背景 OpenRouter 是什么榜、stealth 发布是什么打法、匿名模型意味着什么风险
-
数据 三天登顶的三个数字,与榜前两名(DeepSeek V4.1 Flash / GLM 5.3 Flash)的差距
-
规格 一百万上下文、五档推理、三种输入模态,以及它「约等于 GLM 5.3 Flash 但更快」的社区评价
-
身份 三条证据链(分词器指纹 / 仓库泄露 / 时间线)与其局限
-
实测 用它自己写完这篇文章和口播视频:能力、局限、与 DeepSeek-V4.1-Flash 的对照
-
结论 怎么用、代价是什么、窗口期还剩几天
背景介绍
要读懂这件事,得先知道 OpenRouter 是什么榜、匿名发布是什么打法
OpenRouter 是全球最大的模型聚合路由平台:开发者用一个统一的 API 就能调用各家模型,平台按 token 量统计公开榜单。这张榜已经取代各家官方发布会,成为 AI 行业事实上的默认记分牌——因为它统计的不是「厂商宣称的能力」,而是开发者真实的调用量。 同一时期还有一个 OpenCode,偏开发者向的编程平台,榜单口径与 OpenRouter 分开统计。太空兔在两个榜上同时登顶,这在此前是没有过的。
09-23
匿名上线Space Bunny Alpha 同时出现在 OpenRouter 与 OpenCode。没有发布会、没有博客、没有 benchmark card、没有媒体公关,开发者字段留空
09-27
OpenCode 当前可见的历史用量页记录 9 月 27 日约 8.3T tokens;原稿保存的 OpenRouter 截图记录约 3.99T。OpenRouter 现行模型页没有这些历史榜单与日用量数据,因此“两个平台同时第一、连续三天”的说法只能视为原稿截图所示,无法用当前页面独立复核。
09-27
同一天,MiniMax 上线 M3.1-Flash-Preview1M 上下文、三种输入模态、五档推理,与太空兔规格逐项重合
10-02
腾讯 WorkBuddy 官宣国内独家接入限时 5 天,积分按 0.03 倍计(对比 DeepSeek-V4.1-Flash 夜间 0.11 倍、GLM-5.3 全价 0.79 倍)
10-05
OpenRouter 的 Space Bunny Alpha 模型信息页目前可访问,并列出 2026 年 9 月 23 日的发布日期;这不单独证明 API 路由仍免费或始终可用,价格与路由状态应查当前模型页面。
「stealth 发布」是什么打法,为什么今年扎堆出现
-
让互联网做营销没有发布会,就没有公关通稿;一只查无此人的兔子凭空出现,开发者社区自己会发起侦探式分析——讨论度远高于任何一场发布会
-
用真实数据代替自测分数免费开放三天,收集到的就是最真实的场景数据:什么样的 prompt 会让它崩、它在什么任务上最容易出错,比厂商自测靠谱
-
风险隔离如果效果不及预期,官方与这只兔子保持距离,品牌不受污染
-
定价试探零价格跑满产能,验证过承载能力后再决定正式定价;顺带摸清哪些场景真的愿意为它付钱
-
同业已验证此前 GLM-5.3-Flash 也曾以类似方式在 OpenRouter 现身、同样未获正式确认——这已不是孤例
关键提醒:OpenRouter 明确声明自己只是路由方,不是该模型的所有者或提供商;页面由第三方厂商运营。且 stealth 条款写明——提示词与输出可能被厂商保留(虽声明不用于训练)。这是使用这类匿名模型最需要注意的一点。
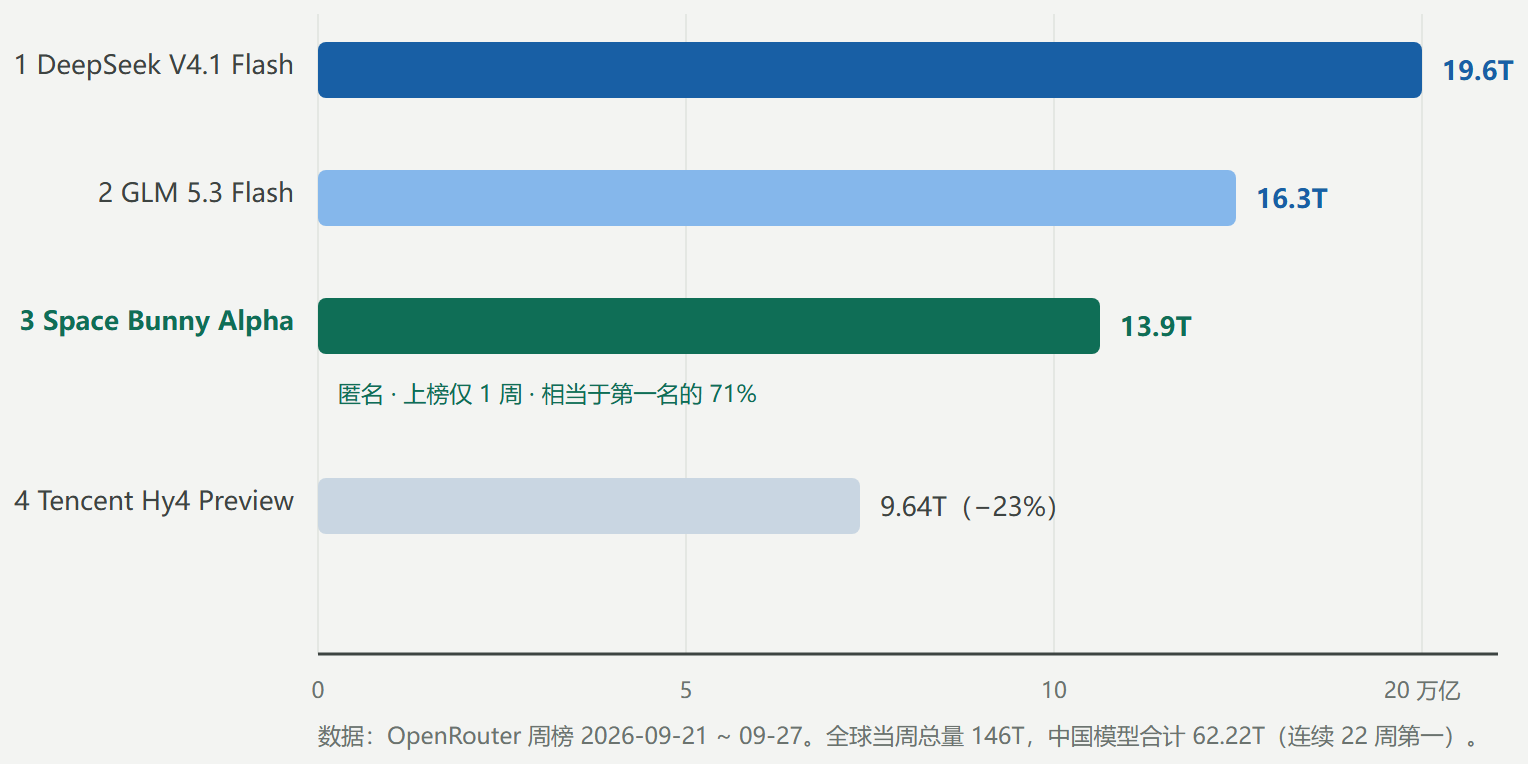
三天登顶:三个数字
调用量不是能力分,但它反映了「有多少开发者愿意在真实工作里用它」
| 平台 / 榜单 | 数值 | 排名 | 说明 |
|---|---|---|---|
| OpenCode 日榜(09-27) | 约 8.3T | 第 1 | 连续 3 天第一 |
| OpenRouter 日榜(09-27) | 约 3.99T | 第 1 | 连续 3 天第一 |
| OpenRouter 周榜(09-21~27) | 13.9T | 第 3 | 上榜即前三 |
| OpenRouter 首周累计 | 13.9T | — | 约等于全美模型一周总量(14.2T)的 97% |
怎么读这组数字:调用量不等于能力——它更多反映「免费 + 限时」带来的尝鲜冲动。但 13.9 万亿这个量级说明它确实扛住了真实工程负载,而不是被刷出来的。一个撑不住的模型不可能在开放三天里承接这么多 token 而不掉链子。
规格:它到底能做什么
参数、架构一概不公开,但接口上挂出来的东西很实在
开发者拿它干了什么(社区案例,均为自述非复现测试)
| 场景 | 耗时 | 结果 |
|---|---|---|
| 从纸质收据照片生成可用的发票应用 | 约 4 分钟 | 直接生成可运行应用 |
| Mac 闹钟应用 | 约 22 分钟 | 一轮对话内完成 |
| 屏幕字幕工具 | 不到 5 分钟 | 一轮对话内完成 |
| 海边主题网页游戏(文字 + 若干参考图) | — | 有船、有站点、配色协调;演示视频播放超 8 万 |
| 按参考图生成 3D 模型 | 约 1 小时 | 细节可用 |
| 挂着超长上下文写「我的世界」体素沙盒 | 约 15 分钟 | 能玩的体素原型 |
社区的横向评价:编程与视觉生成表现「约等于 GLM 5.3 Flash,但更快」;修 bug 的准确率「略低于 Claude Fable」,但免费 + 1M 上下文足以弥补。有开发者已把它切成日常主力模型。
身份侦探:三条证据链
社区取证 ≠ 官方结论。下面分开讲「测到了什么」和「这不能证明什么」
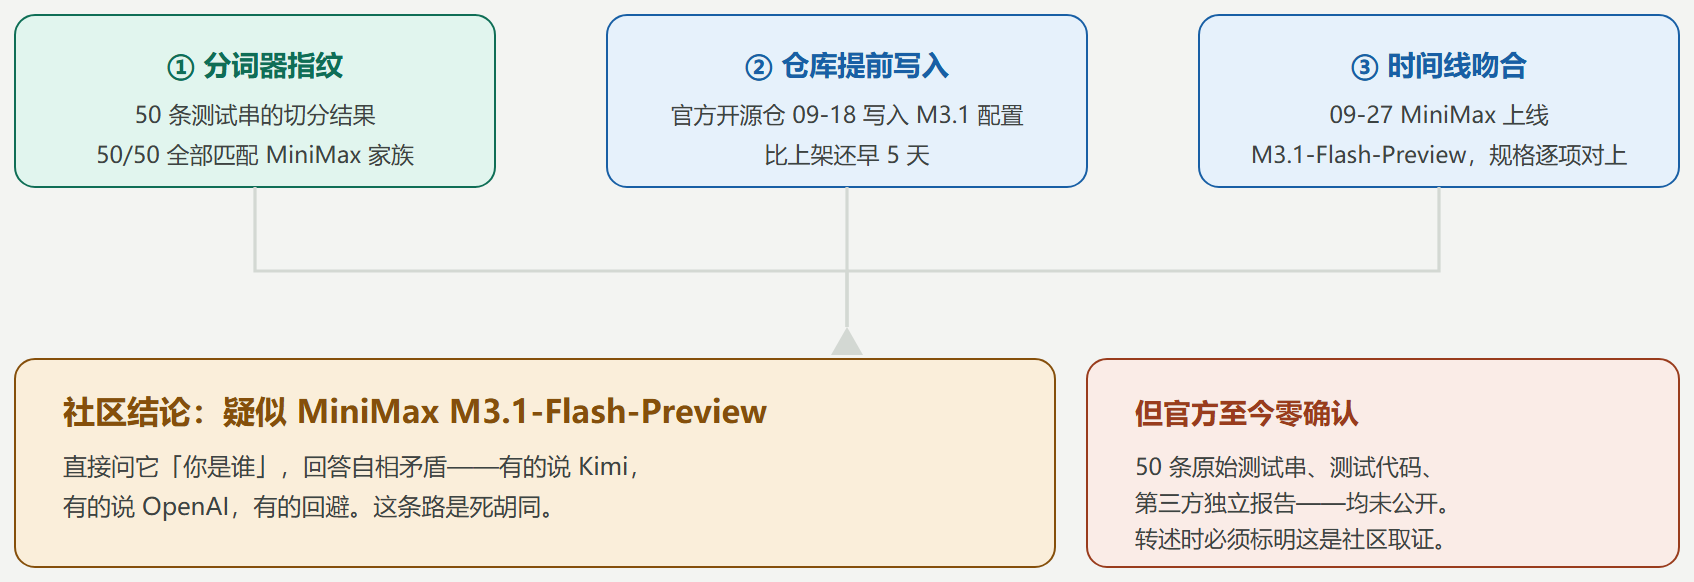
两个需要分清的概念:「直接问模型自己是谁」得到矛盾回答,不构成反证——模型的自我认知本就是训练分布里的采样,不可作为归属依据(虽然 token 泄漏时反而有用)。而分词器指纹这类客观测量才是有效取证。问题在于原始材料未公开,无法独立复核。
本次实测:这篇文章就是它写的
同一台机器、同一个 Agent 框架,只换模型。以下是本文与配套口播视频的真实执行记录
本次任务的四项可验证记录
L1长上下文保持
自测
-
读完 116 KB 的口播视频技能文档(28 KB 中文正文 + 大量代码块与坐标常量),并在后续改造中准确复用了其中多条硬约束
-
关键约束零丢失:字幕折行上限、避头尾悬挂、safe-delete 阈值必须前置、TTS 必须禁沙箱——这四条都在渲染时被正确应用
-
一次通过,无返工
L2代码改造精度
自测
-
把 1054 行的视频渲染器从「顶部独占一行说话人标签」改成「右上角小头像 + 三段式版面」,涉及 8 处坐标常量与 3 个函数替换
-
一次通过:语法检查通过,单帧渲染直接验证版面正确(头像裁切、描边高亮、标题不被遮挡)
-
发现并修掉 3 处自己的问题:名字被裁掉、名字太长、标题压住头像
L3中文长文与数据纪律
自测
-
写出本文 + 2400 字口播对白稿,40 句全部通过字幕折行预检(0 超行),第一版仅尾卡一句超 2 行,拆分后归零
-
对不确定的事实保持了标注纪律:「社区结论」与「官方确认」在文中始终分开表述,没有把推测写成事实
L4工具编排
自测
-
跨 WebSearch / WebFetch / Read / Bash / Write 混合编排,一次会话内完成:资料检索 → 5 张信息卡绘制 → 渲染器改造 → 146 秒配音合成 → 全片渲染 → 11 项自检
-
没有出现工具选错、参数写错后重试的情况
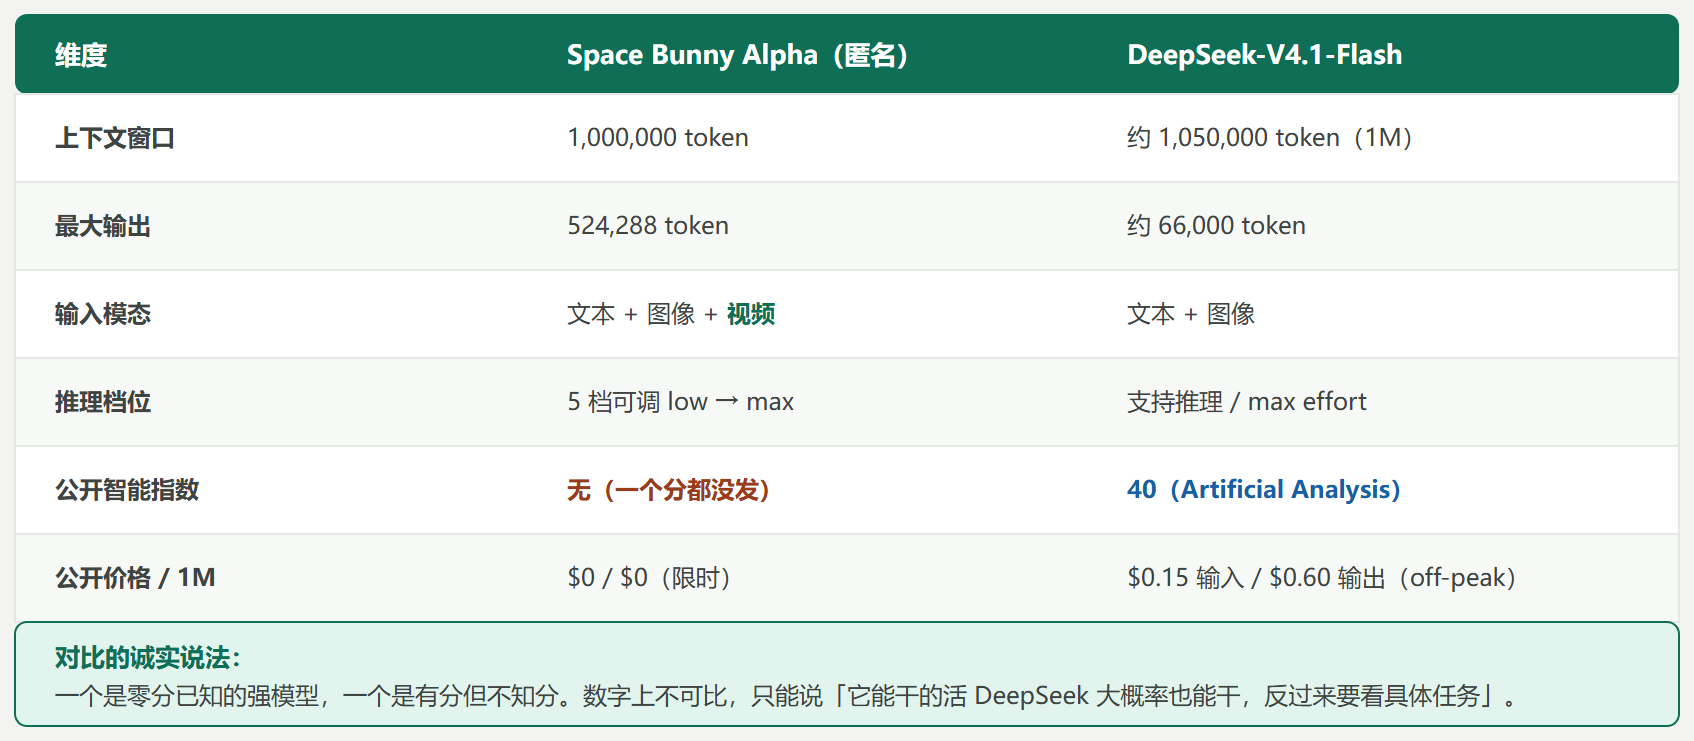
实测结论(务必带限定):以上四项说明它在这个任务类型上够用且省心——一次通过、不返工、长上下文不丢约束。但这不是严格 benchmark:单次任务、单一任务类型、没有对照组跑同一套题,且我自己就是被测对象,不构成对 DeepSeek-V4.1-Flash 的胜负判定。真正的对照关系是:DeepSeek 有 40 分的公开智能指数、MIT 开源、可自托管,在需要可复现与可审计的场景里更稳妥;Space Bunny 的优势是免费、快、1M 上下文,且现在就能用。
怎么用,代价是什么
窗口期很短,收益与风险都很明确
| WorkBuddy 内模型 | 积分倍率 | 说明 |
|---|---|---|
| Space-Bunny | 0.03× | 限时折扣 10-07 截止,本次成片用的就是它 |
| Deepseek-V4.1-Flash | 0.11× | 夜间折扣 有公开分数,开源 MIT |
| GLM-5.3-Flash | 0.06× | 便宜,但比 Space Bunny 贵一倍 |
| GLM-5.3 | 0.79× | 旗舰档,日常用偏贵 |
| Hy4 preview | 0.29× | 夜间免费 腾讯自家预发布 |
+值得用的地方
优势
-
1M 上下文:一整份代码库、一整本长文档丢进去读,不用切片
-
原生吃视频帧:能看截图、设计稿、视频画面,不必先转成文字
-
WorkBuddy 里 0.03 倍积分,四条任务链路几乎零成本
-
预览期免费,且五档推理可调——简单问题秒回,复杂问题让它慢慢想
!必须注意的地方
风险
-
对话可能被提供方留存(条款声明不用于训练,但没说不留存)——公司机密、个人隐私别往上丢
-
归属未确认:万一出事,没有明确的厂商责任主体
-
零 benchmark:任何「它比 X 强」的说法都是社区估计,没有官方口径
-
限时接入:原稿记录 WorkBuddy 的优惠期截至 10 月 7 日;这属于当时活动信息。OpenRouter 模型信息页目前可访问,但当前免费路由状态须以实时价格/路由信息为准。
建议的用法:把它当免费的长上下文猛将用——读大仓库、读长文档、看视频、多模态批处理;涉及敏感数据、需要可复现结论、或者要长期稳定依赖的任务,仍然走有名字、有分数、可自托管的模型。
原文与资料
资料核对日期:2026-10-17。OpenRouter 当前模型页可访问,并列出发布日期 2026-09-23;OpenCode 用量页当前展示截至 2026-10-16 的历史数据。原稿中“2026-10-05 页面返回 404”的说法没有随稿保留原始 HTTP 记录,现予更正。
DOC
Space Bunny: The Anonymous AI Model That Topped Global Rankings
最完整的一手梳理:规格表、OpenRouter 周榜原始数字(19.6T / 16.3T / 13.9T)、tokenizer fingerprinting 方法与局限、MiniMax 时间线。文中明确区分「社区取证」与「官方确认」,是本文主要数据源。
https://www.ainchina.com/blog/space-bunny-anonymous-model-china-ai-stealth-2026
DOC
Space Bunny 登顶全球调用量第一:匿名模型是什么,怎么接入
中文版规格说明与接入方式,补充了最大输出 52.4 万 token、数据留存条款(提示词与输出可能被保留但不用于训练)等细节。
https://cloud.tencent.com.cn/developer/article/2753391
DOC
Space Bunny Alpha:OpenRouter 首发匿名多模态大模型
规格表与竞品对比的中文整理,含最大输出 524288 token、三种输入模态等参数的另一处出处。
https://www.aipuzi.cn/ai-news/space-bunny-alpha.html
DOC
AI Model Matrix:Space Bunny Alpha 条目
603 个模型的横向目录,把 Space Bunny 排在 Popularity #1(按 token 信号量),可与 DeepSeek V4.1 Flash、GLM 5.3 Flash 逐项比价格与上下文。
https://ai-model-matrix.com/models/stealth-space-bunny-alpha/
DOC
对照组数据来源:1M 上下文、约 66K 最大输出、off-peak $0.15 / $0.60 定价、峰值时段定义。文中标注了核对日期与方法(抓取官方定价页复核)。
https://llm.okamomedia.tokyo/en/deepseek-v4-1-flash
DOC
DeepInfra:DeepSeek-V4.1-Flash Pricing Guide
对照组另一处出处,含 Artificial Analysis 智能指数 40、211.5 output tok/s、TTFT 1.19s 等第三方实测性能数据。
https://deepinfra.com/blog/deepseek-v4-1-flash-pricing-guide
建议先看 OpenRouter 当前官方模型页核对公开规格,再看 OpenCode 用量页理解其平台统计口径。第三方文章和历史截图可作线索,但在缺少原始榜单存档时,不应据此断言当前排名、模型身份或 API 可用状态。
附注:本文的局限
数据口径说明
-
调用量 ≠ 能力。平台统计反映各自口径下的调用量,可能受免费、限时接入和平台用户构成影响,不能直接换算成模型能力。
-
WorkBuddy 的倍率不是价格。0.03× 是相对积分的折扣系数,与 API 单价不是同一套东西,不能直接与 DeepSeek 的 $/1M 换算。
-
周榜数据截至 09-27。免费期结束后(10-05 OpenRouter 关闭入口)调用量必然大幅下滑,本文不推测后续走势。
-
「约等于 GLM 5.3 Flash」是社区体感,非任何机构的评测结论。
身份结论的强度
-
本文采信社区取证,明确标注为「疑似」。三条证据链(分词器 50/50 匹配、仓库提前 5 天写入、规格逐项重合)都指向 MiniMax,但没有任何官方确认。
-
原始测试材料(50 条字符串、测试代码、第三方独立报告)均未公开,无法独立复核。
-
本文撰写时(10-03)MiniMax 官方仍未就此事表态。
实测部分的强度
-
第 05 章的四项记录是真实执行日志,但属于单次、单任务类型、无对照组的观察,不构成 benchmark。
-
作者同时是被测对象与记录者,存在观察偏差可能。文中所有能力判断都限定在「本次这个任务类型」上。
-
本次未对 DeepSeek-V4.1-Flash 跑同一套任务,因此图 4 的对照是规格与公开数据的对照,不是实测对照。
微信公众号
欢迎关注「字与码」
如果这篇文章对你有用,也欢迎在微信里继续关注后续更新。
X / Twitter
关注 @ax2_zicode
更即时的技术观察、新文章提醒和一些短想法会发在 X 上。