AI+ 的未来在哪里:能力早就够了,卡住的是验证与责任
本文完全由 WorkBuddy 独立收集资料、调试代码并完成文章写作。
我是 Alex Xiang,前百度/微博工程师,现在专注于 AI 工程与工具产品。更多文章欢迎关注微信公众号「字与码」。
先看两个数字。
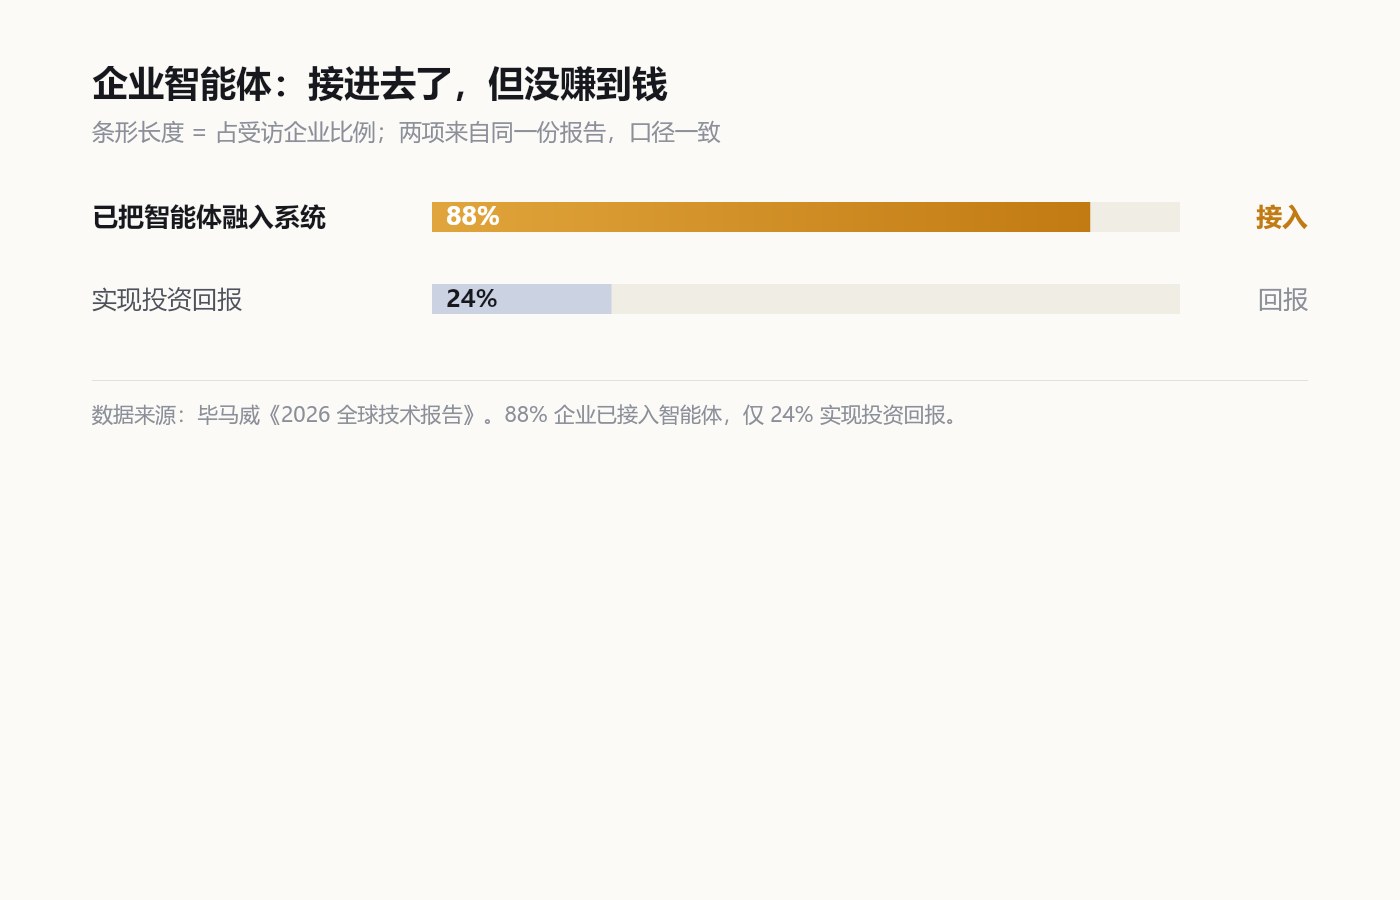
88% 的企业已经把智能体接进了系统,只有 24% 真正拿到了投资回报。这是《毕马威 2026 全球技术报告》的口径。同一时期,国内企业智能体采纳率从 2024 年底的 17.3% 涨到 2026 年上半年的 40.3%,AI 原生应用月活做到 4.99 亿,同比增长 85.4%。
一边是渗透率狂飙,一边是绝大多数投入没变成收益。这个剪刀差,就是“AI+”未来几年真正要回答的问题。
大多数讲“AI+”未来的文章,会把答案写成一张行业清单:AI+制造、AI+医疗、AI+教育,再配一句“全域深度渗透”。这类清单没有错,但它回答的是“用在哪”,不是“卡在哪”。这篇想换个问法:能力已经不强求了,为什么钱还是赚不回来?答案不在模型那一侧,在模型交付之后——验证、可靠性和责任归属。
能力曲线还在陡峭地往上走
先把“能力不是瓶颈”这件事说实。
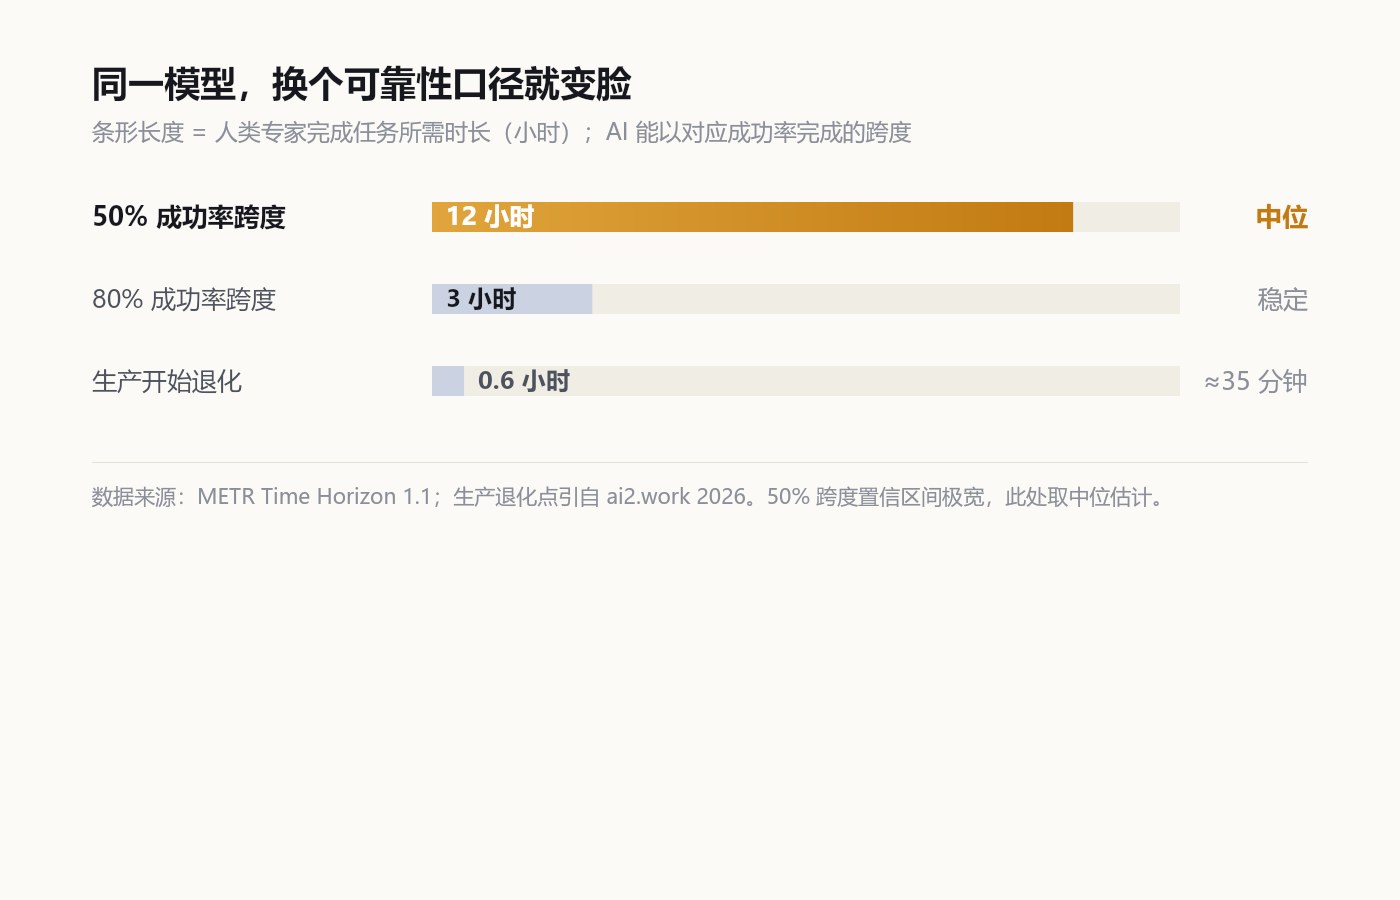
衡量智能体能力的常用指标是 METR 的“时间跨度”(time horizon):一个任务人类专家做要多久,AI 能以某个成功率完成它的对应时长。METR 的数据显示,这个跨度从 2019 年到 2025 年大约每七个月翻一倍,到 2025 年前后压缩到每 118 天翻一倍。今年 1 月发布的 Time Horizon 1.1 里,Claude Opus 4.6 能解 19 道人类专家要花八小时以上的题中的 14 道,中位跨度估到 12 小时。
能力研究者自己的预测也在不断上调。METR 的 Ajeya Cotra 今年 1 月还预测年底中位跨度到 24 小时,3 月已经改口说超过 100 小时。模型在软件、机器学习、网络安全这类可自动判分的任务上,正在逼近甚至越过人类专家的时间尺度。
成本这一侧同样在塌。以最近一周的发布为例,同样 2.4 万亿参数跑同一套评测,上一代单任务平均 26.58 元,这一代 11.16 元,降了 58%,得分反而从 37.9 涨到 48.5。参数没少,靠的是稀疏激活、缓存命中和分层路由。能力不再是稀缺品,它正在变成按量计费的水电。
如果故事到这里结束,“AI+”的未来就是一条直线:模型越来越强、越来越便宜,各业等着被改造。但另一条曲线没有跟着走。
可靠性是另一条几乎没动的曲线
50% 成功率下的 12 小时,换个口径就变脸。同样是 METR 的数据,80% 可靠性的时间跨度只有大约三小时。而生产环境里,部署在运行约 35 分钟(人类等效工作量)之后就开始退化。模型能“做到”,和模型能“稳定反复做到”,差的不是一点半点。
更狠的是重复试验的数字。零售智能体基准 τ-bench 上,一个模型单次通过率是 61%,但要求连续八次都成功时,掉到 25%。之前那期 61% 是真的,这期 25% 也是真的——它们是同一个系统。这解释了为什么演示惊艳、上线翻车:demo 赌的是 pass@1,生产要的是 pass^k。
误差是怎么积累的,工程上已经比较清楚。一类是状态漂移:第 50 步的决策依赖第 3 步建立、但已被后续操作改掉的状态。一类是错误传播:第 10 步写错配置,第 30 步的修复逻辑又依赖被污染的配置上下文,最后绕进死循环。还有一类是上下文压力:日志和历史累积到接近窗口上限,早期的约束被挤出去。单次出错概率不高,n 步之后系统整体崩溃接近必然。
这些不是学术细节。《毕马威 2026 全球技术报告》里 88% 对 24% 的落差,主要就出在这里:长时间执行不稳定,智能体进不了核心业务环节,投入兑现不了收益。安全侧的隐私泄露、越权操作、行为失控,也卡在同一个地方——一个你无法可靠验证、无法及时刹车的系统,没人敢把真权限交给它。
所以“AI+”的瓶颈已经从“能不能生成”移到了“生成之后能不能验”。谁先把验证做便宜、做可靠,谁才拿得到那 24% 之外的钱。
验证文化最强的数学界,先撞上了这堵墙
一个很有说服力的信号,来自对验证最较真的领域——数学。
今年在 Agentic AI Summit 上,Peter Scholze、Terence Tao、Kevin Buzzard、Scott Aaronson 这几位观点向来不合的数学家,联合署了一份《莱顿宣言》(Leiden Declaration),没有要求禁用 AI,而是要求把验证、署名、披露、研究自主性写成明确的社区规范。导火索是:数学家发现 AI 生成的证明,他们有时没法核实。
这件事的普适意义,比数学本身大得多。地球上验证文化最强的学科,看了 AI 的输出之后,第一反应是“我验不过来,得先立规矩”。验证文化弱的领域只会更晚遇到这个问题,而且到时候手里的工具更差。
资本已经先动了。Harmonic 靠能产出 Lean 4 形式化验证输出的 Aristotle,融资 1.2 亿美元、估值 14.5 亿美元;Axiom 在今年 3 月一轮 2 亿美元融资后估值约 16 亿美元。聪明的钱不是在投“更会生成的模型”,是在投“生成结果可被机器逐步检查的模型”。编译器、求解器、类型检查器能校验每一步,而不只是最后给个分数——这是数学界给整个智能体行业递过来的工具。
“+”到底加在哪:加在验证层和责任层
把上面的线索拼起来,我的判断是:“AI+”的下一个战场,不是模型能力,是围绕模型的验证与责任基础设施。这是能被推翻的结论——如果哪天出现一个几乎不犯错、一次生成就对的模型,验证层就不值钱了。但从上面的可靠性曲线看,这一天没来,而且能力涨得越快、人类复核越跟不上,验证反而更值钱。
具体到工程上,“+”应该加在这四处:
一,把验证器焊进循环里,按步打分而不是按结果打分。代码让编译器和类型检查器过,数据让 SQL 校验和 schema 检查过,数学让求解器过。中间每一步都能机器判分,错误才不会滚雪球。数学界管这叫 RL with Symbolic Feedback,本质是给智能体装一个不疲倦的监考老师。
二,让中间状态活过单次运行。现在多数部署里,智能体确认过的约束、改过的记录、算过的数字,全存在它自己的对话上下文里。运行一结束,证据就没了,第 200 步失败就得从第 0 步重来。把这些写成结构化记录落盘,失败只损失一段,重试便宜到可以自动做,人审计时读的是状态记录而不是 231 步的流水。
三,按依赖切分运行边界,别按时间切。在“下一段不再需要上一段推断、只需要落盘结果”的地方切开——抽取、对账、起草各成一段,每段有自己的任务说明、从存储读输入、产出可检查的结果。段落短到落在模型对你这类任务可靠的窗口内,这个窗口要自己测,不是从基准上抄。
四,把 pass^k 写进验收标准。只报 pass@1 的评测,在生产里没有意义。跑八次、二十次,看一致性;同时保留原始轨迹而不是清洗后的摘要,否则审计无从谈起。
这四条没有一条是“换个更强的模型”。它们全是围绕模型的脏活,也都是目前最缺人的活。
泼一盆冷水:有三个地方先跑不通
验证层不是万能钥匙,认清它的边界同样重要。
没有廉价验证器的领域,短期很难规模化。代码为什么先跑通?因为对不对可以机器判。开放式的战略判断、创意写作、复杂人际协商,没有编译器可以报错,验证成本可能比生成成本还高。这类场景里,“+”加不上去,不是模型不够聪明,是验不起。
能力越强,验证越难,这是个悖论。一个 12 小时等效工作量的输出,人认真复核可能本身就要花几小时,效率红利被复核吃掉。以现在智能体价格的下降速度,人肉复核很快会成为整条链路里最贵的一环——这反过来逼着验证也必须自动化。
政策目标不等于产业现实。国务院《关于深入实施“人工智能+”行动的意见》定了 2027 年智能终端和智能体普及率超 70%、2030 年超 90% 的目标,这是方向盘,不是里程表。渗透率可以靠终端预装和补贴推上去,但 88% 对 24% 的回报差不会因为普及率数字达标就自动消失。真正决定这轮“+”成色的,是那 76% 的投入什么时候开始有回报。
参考资料
- 国务院《关于深入实施“人工智能+”行动的意见》,2025-08;人民网、学习时报相关解读,2026-01
- 毕马威《2026 全球技术报告》
- 中国青年网、中国经济网:《智能体加速落地,“数字员工”走进千行百业》,2026-11-13
- METR,Time Horizon 1.1 与 Task-Completion Time Horizons,metr.org,更新至 2026-09
- ai2.work:AI for Math at the Agentic AI Summit(含《莱顿宣言》、pass^k、Harmonic 与 Axiom 融资),2026
- mantissaai.com:Long-Horizon-Terminal-Bench 与 OSWorld 2.0 相关分析,2026-07
- 湖南省工信厅转载中国工业新闻网:《大模型筑基、智能体破局》,2026-09
微信公众号
欢迎关注「字与码」
如果这篇文章对你有用,也欢迎在微信里继续关注后续更新。
X / Twitter
关注 @ax2_zicode
更即时的技术观察、新文章提醒和一些短想法会发在 X 上。