程序里集成翻译功能,调 API、用模型还是自建一层
本文完全由 WorkBuddy 独立收集资料、调试代码并完成文章写作。
我是 Alex Xiang,前百度/微博工程师,现在专注于 AI 工程与工具产品。更多文章欢迎关注微信公众号「字与码」。
给一个已经有 i18n 目录的项目加翻译,最省事的写法是申请一个 key,遍历 JSON,把英文换成中文。我在自己机器上这么干了一遍:从一份典型的 SaaS 界面文案里取了 27 条,跑完 14 条能用,13 条不能用。
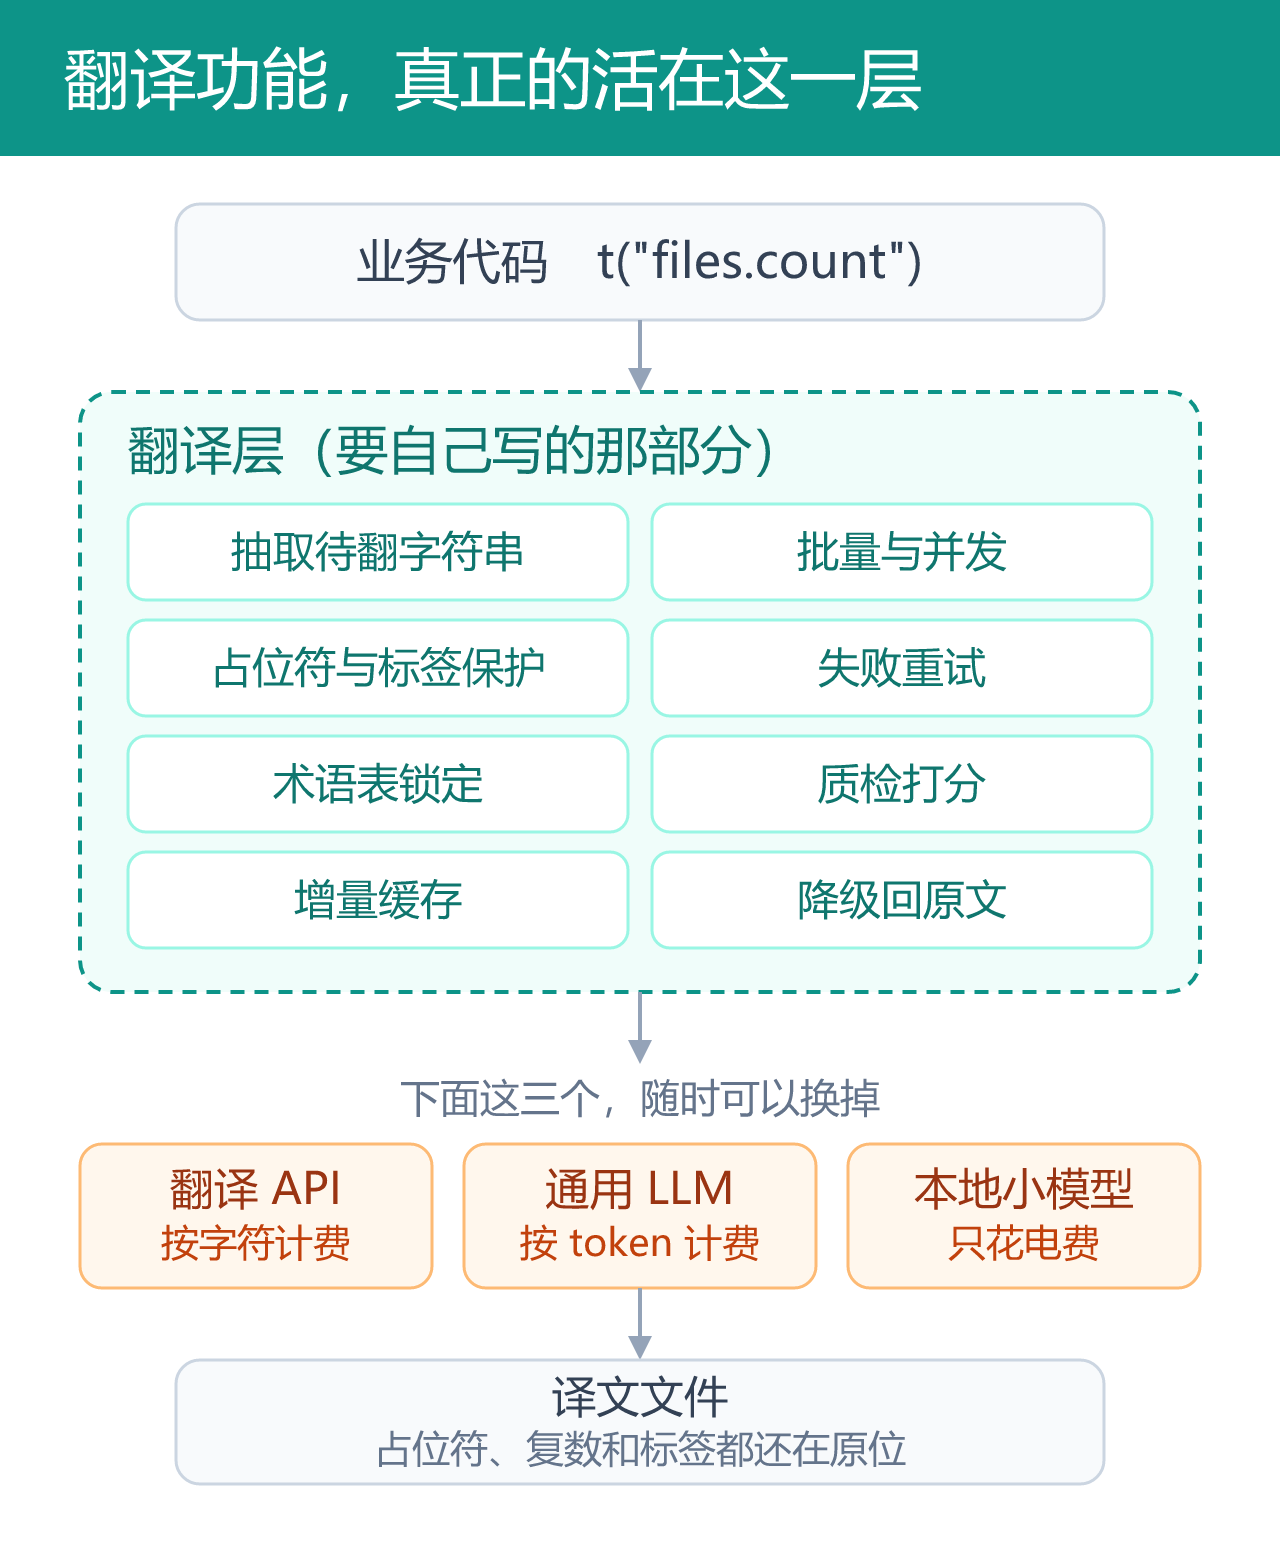
不是模型翻得不好,是它把占位符吃掉了。{name}、%s、HTML 标签这些片段一旦在译文里变形,前端渲染出来就是一个报错、一段空白,或者一个带尖括号的怪物。而这类失败在人工抽查里很容易漏掉——你只看几条,恰好都没问题。所以重点不在「哪家 API 翻得准」。三条路线的取舍我都过了一遍,真正决定能不能上线的,是夹在业务代码和引擎中间的那一层。
三条路线卖的不是同一样东西
主流三类:专用翻译 API(DeepL、Google、Azure、百度、阿里)、通用大模型(GPT-5.1、DeepSeek、Gemini)、本地模型(opus-mt、NLLB、小尺寸 Qwen)。另外还有浏览器和手机系统自带的翻译能力,免费、快,但不归你控制。
按字符计费的几家,2026 年 11 月的公开单价:Azure 每百万字符 10 美元,Amazon 15 美元,Google 20 美元,DeepL 25 美元另加月费;国内百度 49 元、阿里 50 元,认证后每月各有一两百万字符免费额度。大模型要换算:一百万字符约等于 25 万输入 token 加 25 万输出 token,按 GPT-5.1 的 1.25/10 美元算约 2.8 美元,比 DeepL 便宜将近九成。但这些数字都不是选型的决定因素,真正的差别在三件事上。
坏了怎么坏。专用 API 的失败通常是「翻得不自然」,句子还在,占位符也在。大模型的失败是「翻得很有想法」——补一句解释、把三段合成一段、把 {count} 翻成「计数」。本地小模型更粗暴,直接原样吐回英文,或者复读。
术语听不听话,以及同样输入会不会给同样输出。专用 API 有 glossary 接口,锁死的词不会变;大模型只能靠 prompt 约束加事后校验,而且 temperature 设成 0 也不保证逐字一致——这对需要 diff 审校的流程是麻烦,每次重翻,审核记录全废。
实测范围:本地模型和整条管线是我自己跑的;翻译 API 和大模型只测了成本和调用姿态(用真实 tokenizer 计数),没有比译文质量——这台机器上没有可用的 key。质量判断来自公开文档与第三方评测,未做独立复现。
先把本地模型跑一遍,看它坏在哪
环境是一台普通的 Windows 笔记本,AMD Ryzen 7 H 255,31GB 内存,没有独立显卡,纯 CPU。模型用 Helsinki-NLP 的 opus-mt-en-zh,中英方向的小模型,权重几百兆。加载 22.5 秒,推理峰值内存 366MB,27 条文案跑了 262 秒,平均每条接近 10 秒,吞吐 9.5 字符/秒。
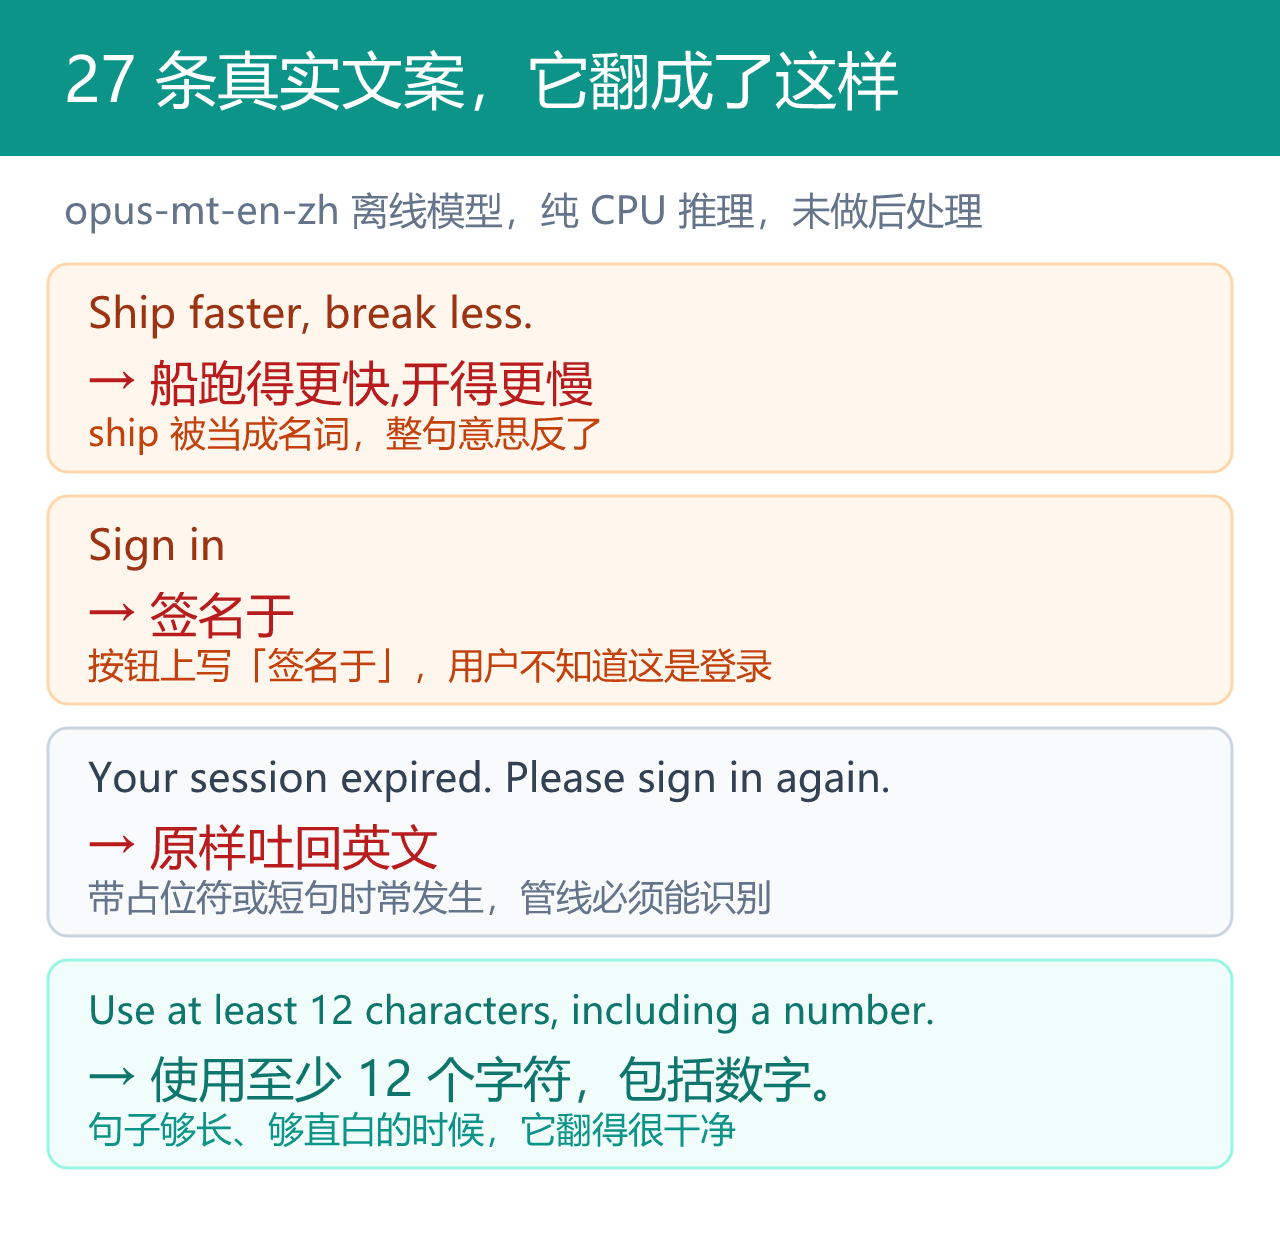
差得很有代表性。「Ship faster, break less」被翻成「船跑得更快,开得更慢」——ship 当成了名词,这是产品的 slogan。「Sign in」被翻成「签名于」,这是一个按钮,用户看到不会知道是登录。而「Use at least 12 characters, including a number」这种句子,它翻得干干净净:「使用至少 12 个字符,包括数字。」
规律很清楚:句子够长、够直白、没有变量,小模型是可用的;短标签、缩写、双关语,它必错。而 UI 文案恰恰以后者为主。
那为什么还要看它?因为有些场景没得选:合同、病历、内部工单不能出境,也不值得为它养一条 API 通道,「慢但不出门」就是唯一可选项。八核笔记本 CPU 就能把它跑到可用,边缘机器、内网容器都够;代价是速度,三千条文案按这个吞吐要跑九个小时。离线方案从来不是「省钱的选择」,是「合规约束下的选择」。
第一轮 13 条失败,11 条死在占位符
13 条失败里 11 条是占位符丢失,1 条术语未命中,1 条复读。现场是这样的。原文 You are using {used} of {total} ({percent}%),我在送翻之前把三个变量换成了私用区字符加编号,模型返回 您正在使用 @% 1 @ @% 1 @ (% 2 @ ) 中的% 0 @ 。
私用区字符(Unicode 里留给程序自用的那一小段编码)被 sentencepiece 分词器拆成了 @% 和数字。另一条 Current plan: {plan} 更糟,模型在那里复读了上百个 %。恰恰是这层保护机制必须存在、又必须被验证的原因:你把占位符换成什么形态,会直接决定某个具体引擎破不破坏它。第二轮改成 [[0]] 这样的 ASCII 标记,同一批文案、同一个模型,失败数从 13 条降到 11 条。
降得不多,但副作用更有意思:这一轮只用了 36 秒,上一轮用了 262 秒。原因不在标记本身快,在于上一轮那些复读成上百个 % 的坏输出,每一次都要一直生成到长度上限才停。坏输出不只是质量问题,它同时是延迟问题和账单问题。留下来的 11 条仍是结构问题:strong 和 a 标签、%s、[[0]],有的是整块消失,有的是被吃掉一层方括号变成 [0]——看起来「差不多对」,但前端拿到的是一个字面量方括号。
引擎不可靠的时候,代码要能兜住
换引擎、调 prompt 都能改善质量,但没有哪种引擎能保证不出坏数据。所以管线里必须有一步:拿到输出之后逐条打分,不合格就不收。我做了个故障注入实验。1000 条合成文案,人为往 146 条里埋坏输出——丢一个占位符、开头加一句「以下是翻译:」、把译文截断一半。然后比较两种写法:拿到就存,和校验、重试、实在不行降级回原文。
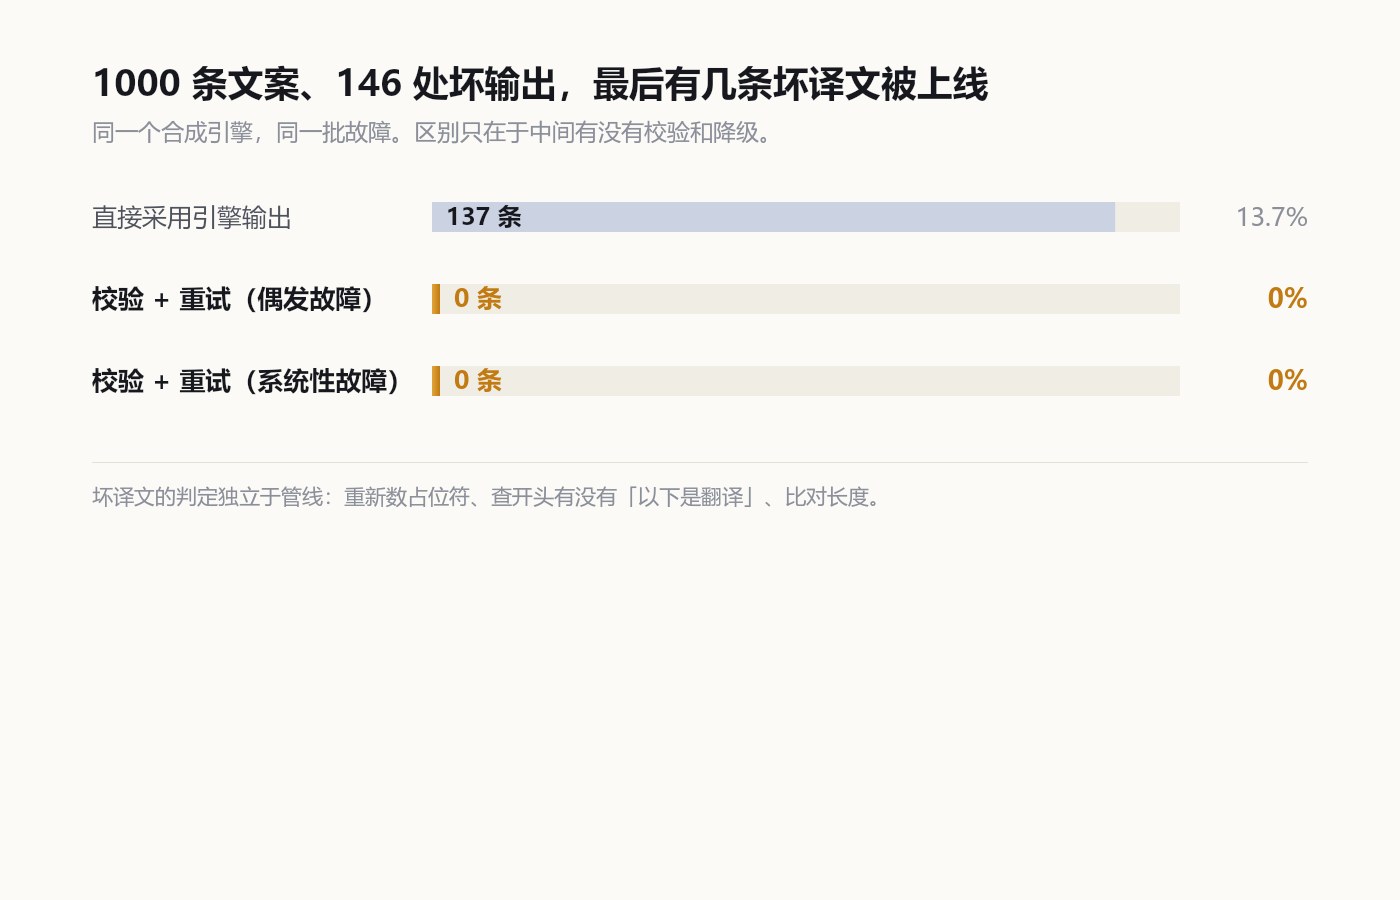
直接采用引擎输出的那一组,137 条坏译文进了最终产物,占 13.7%,用户界面上这些位置会显示成残缺的句子,或者干脆空着。加了校验的那一组,坏译文上线 0 条。
但反直觉的是:重试能救的只有「偶发」故障。故障是一次性的(下次调用就好了),重试 137 次全部修好,没有一条需要降级。故障是系统性的(这个模型就是处理不好这类句子),重试 468 次一条也没救回来——最后全靠降级回原文兜住,137 条显示英文。重试解决抖动,降级解决残缺,两个都要有。
校验查什么?六条能自动判定的:占位符数量与原文一致、译文里真的有目标语言、长度比在合理区间(英到中约 0.3–0.8)、没有整句英文残留、开头没有「以下是翻译」这类前言、术语表里的词命中。跑一遍是毫秒级。它们拦不住「翻得不准」,但拦得住「结构坏掉」——后者才是把页面弄崩的那一类。
还有一类要单独处理:ICU 复数。{count, plural, =0 {No files} one {# file} other {# files}} 这样的字符串整条丢给引擎,它会去翻译 plural、one、other 这些关键字——它们看起来就是普通英文单词,翻完的结构一定是坏的。正确做法是把每个分支拆开单独翻,# 这个代表数字的符号也保护起来,回来再拼回 ICU。拆开后一条消息变成好几段,怎么保证顺序?我用换行符连接、按行切回,并且校验行数,对不上就判失败走降级。
真正省钱的地方是缓存,不是单价
一个中型项目,三千条界面文案,平均每条 42 字符,加起来十二万多字符。全量翻一次的钱少得可怜:
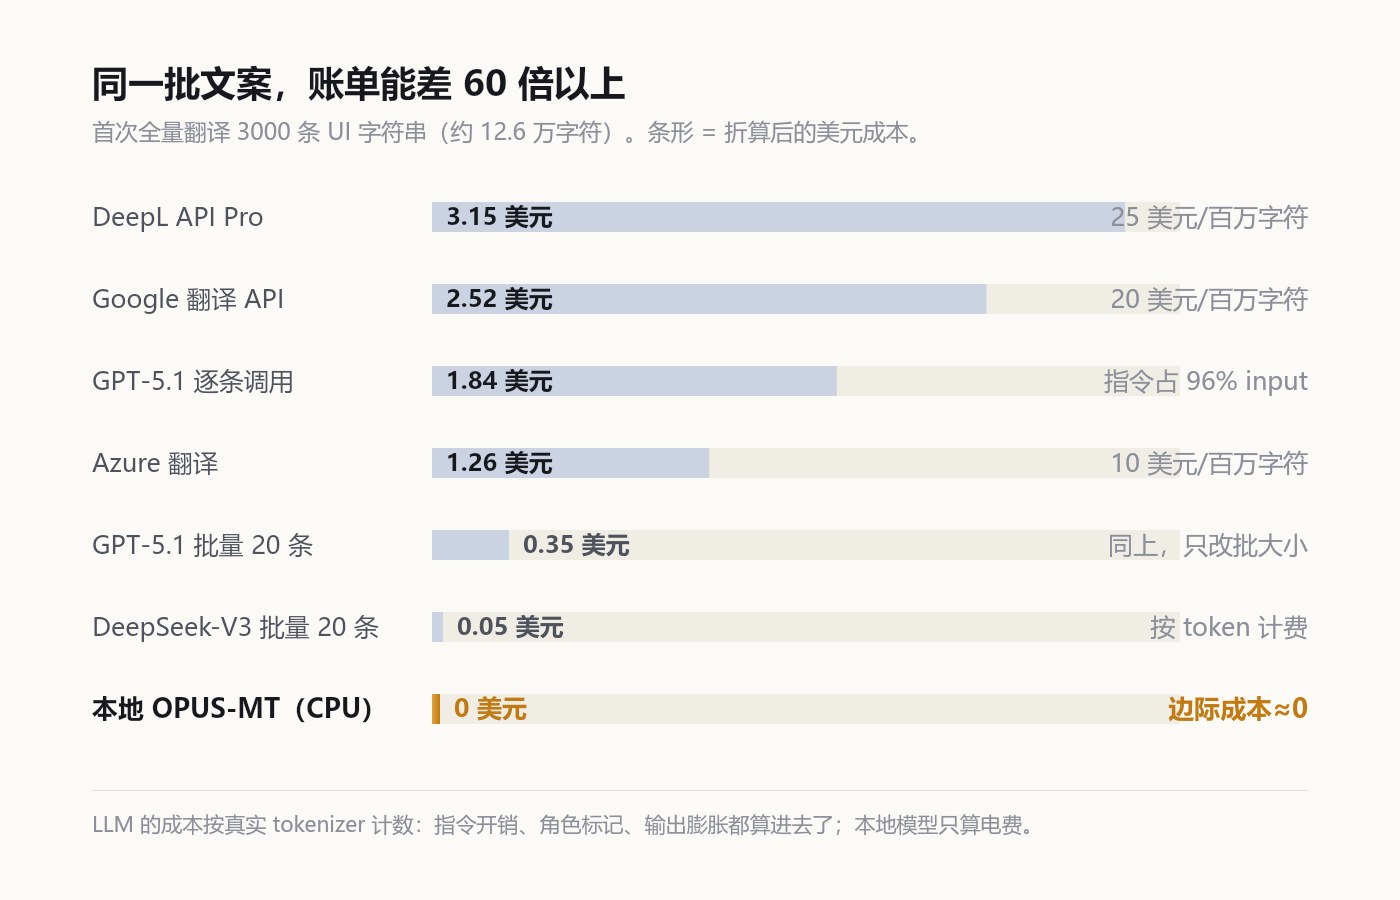
最贵的 DeepL 是 3.15 美元,DeepSeek 批量调用 5 美分,本地模型只花电费。所以「翻译 API 贵不贵」对小项目根本不成立。一个月发二十次版、每次全量重翻,DeepL 一年也就七百多美元。
钱在别的地方:每次发布都全量重翻,意味着每次发布都有一批新译文要人看。三千条文案全量重翻,审校的人会直接把工单关掉。我测了增量缓存:1000 条文案,第一次全量调用 1000 次接口;改动 50 条之后重跑,只发起 50 次调用,其余 950 条直接命中缓存;一行不改再跑,0 次调用。
缓存 key 要包含:原文、源语言、目标语言、引擎名、模型名、术语表指纹、prompt 版本号。少一个,就会出现「改了术语表但旧译文还在用」这种查半天的问题。我自己踩过一次:改完占位符保护逻辑重跑,发现译文没变——因为 key 里没有保护逻辑的版本号,旧结果全部命中了。顺带一个账单细节:同为 GPT-5.1,逐条调用和每 20 条一批,成本差 5 倍以上。因为每条消息都要带一遍翻译指令和术语表,三千条就是三千份指令,指令开销占掉了 96% 的输入 token。这不是模型贵,是调用姿势贵。
那到底怎么选
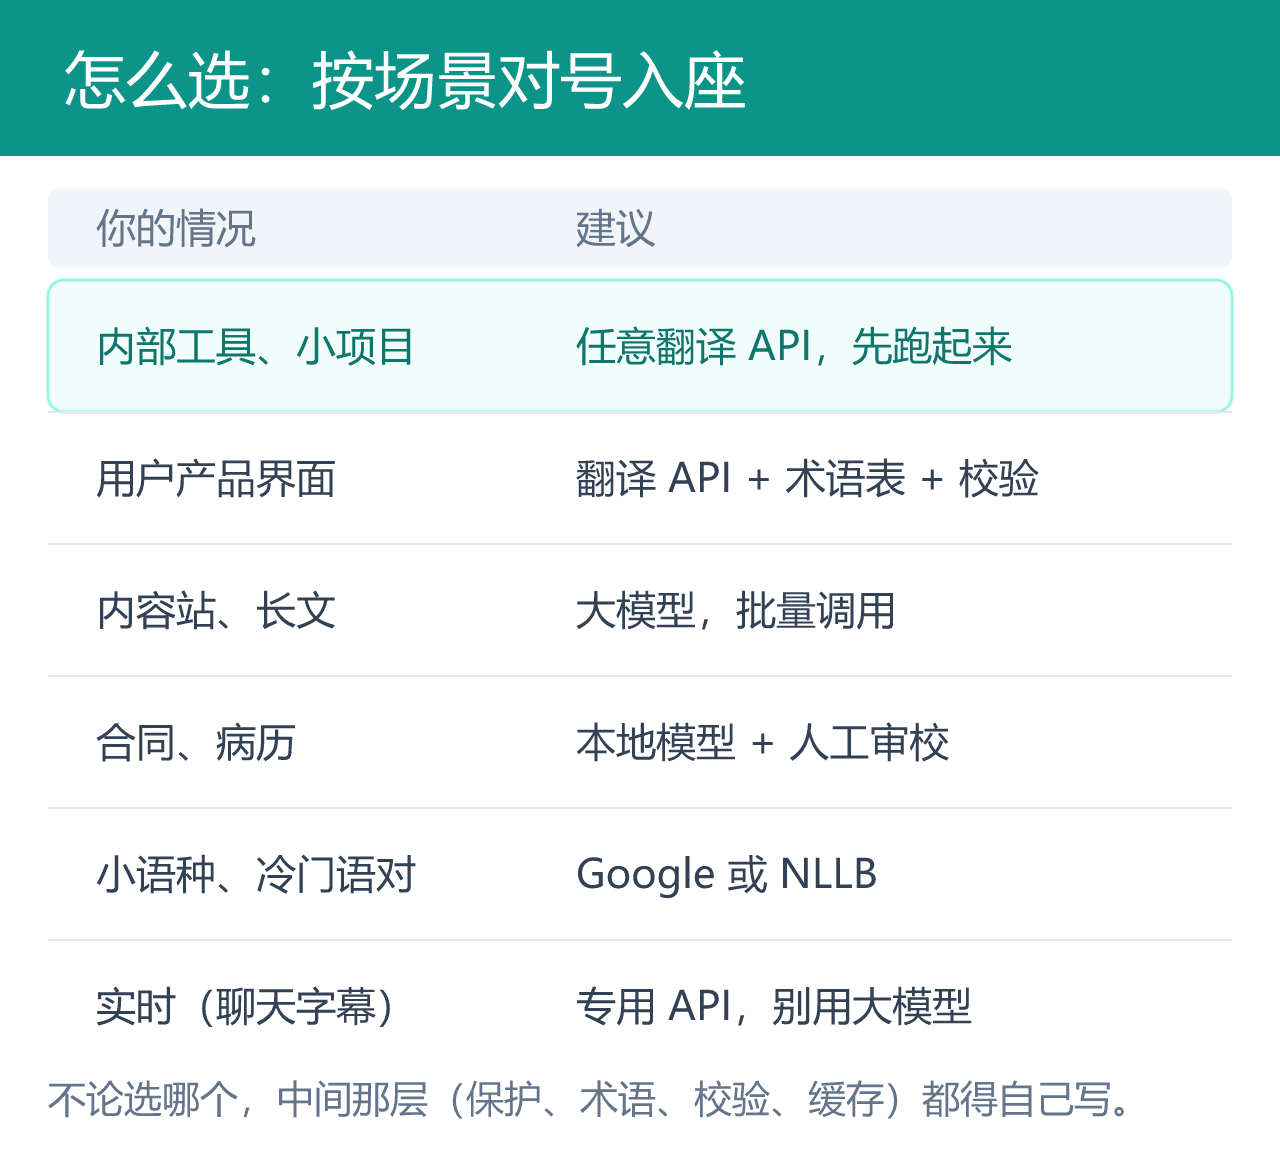
如果让我给默认答案:先用一家翻译 API 起步,把中间那层写对,把引擎接口抽象成一个 translate_batch。等量上来了、或者合规要求变了,换引擎只是换一个实现类,业务代码一行不用动。反过来最糟的顺序是先纠结选型、写三个月对比报告,上线发现占位符全丢了。
落地清单
- 把待翻字符串从代码里抽出来,用标准 i18n 文件格式,别在代码里调翻译
- 写一个
translate_batch(texts, src, tgt)接口,先实现一家 API,其余留空 - 保护层:占位符、HTML 标签、代码片段、URL、产品名,全部替换成标记
- 每个引擎单独验证占位符形态——同一个标记,A 引擎能保留,B 引擎可能拆碎
- 术语表单独维护,翻译时作约束传入,翻完校验命中率
- ICU 复数按分支拆开翻,回填时校验分支数
- 输出逐条校验,不合格重试两次,还不行降级回原文并记日志
- 缓存 key 带上引擎、模型、术语指纹、prompt 版本、保护逻辑版本
这八条里,只有第 2 条和「选哪家」有关。其余七条,换任何引擎都要写一遍。
参考资料:DeepL(deepl.com/pro-api)、Google Cloud Translation 定价页、Azure AI Translator 定价页、百度翻译开放平台、阿里云机器翻译文档、Helsinki-NLP/opus-mt-en-zh 模型卡、OpenAI 定价页。
微信公众号
欢迎关注「字与码」
如果这篇文章对你有用,也欢迎在微信里继续关注后续更新。
X / Twitter
关注 @ax2_zicode
更即时的技术观察、新文章提醒和一些短想法会发在 X 上。