GPT-6.2 双模型发布:便宜两成,强了多少
我是 Alex Xiang,前百度/微博工程师,现在专注于 AI 工程与工具产品。更多文章欢迎关注微信公众号「字与码」。
今天凌晨,OpenAI 把预告了一个多月的 GPT-6.2 一次放了出来:Astra 和 Sol。
先把最容易被搞混的一点说清楚:Sol 确实是同步发布的新模型,不是 Astra 的附属版本。两者是两条独立产品线,Astra 接替 GPT-6 Astra 打复杂专业项目,Sol 接替 GPT-6.1 Sol 做日常主力。11 月 17 日(美东时间)起,ChatGPT Work 和 Codex 的 Plus、Pro、Enterprise、Edu 用户可用,开发者走 API,型号名就是 gpt-6.2-astra 和 gpt-6.2-sol。注意:这批模型不进普通 ChatGPT 对话框,只在 Work 和 Codex 里。
先把四档价格摆出来
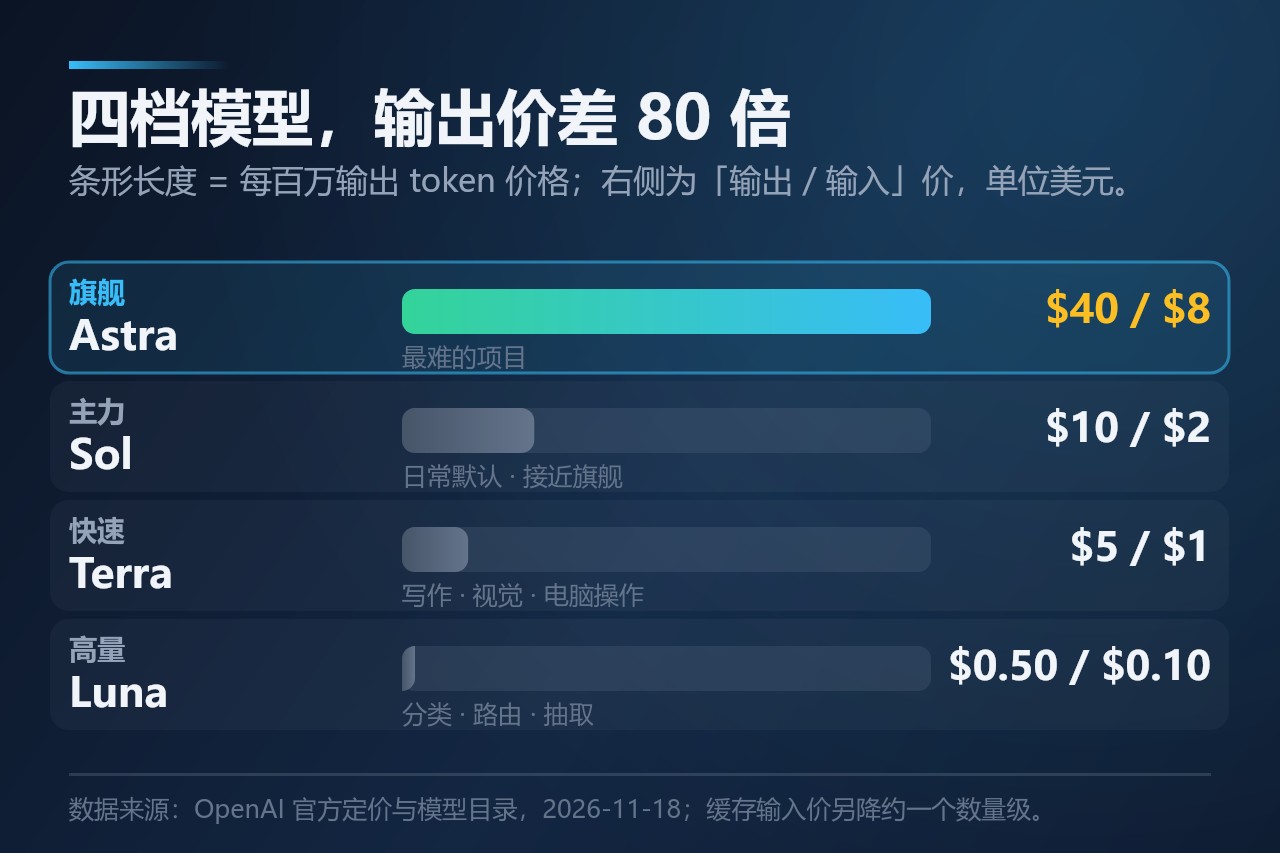
只看 Astra 和 Sol 会漏掉全貌。OpenAI 现在是一条四档产品线,价格从每百万 token 一毛到八美元,跨了 80 倍。
| 档位 | 模型 | 输入 | 输出 | 定位 |
|---|---|---|---|---|
| 旗舰 | GPT-6.2 Astra | $8 | $40 | 最难的项目 |
| 主力 | GPT-6.2 Sol | $2 | $10 | 日常默认,接近旗舰 |
| 快速 | GPT-6.1 Terra | $1 | $5 | 写作、视觉理解、电脑操作 |
| 高量 | GPT-6 Luna | $0.10 | $0.50 | 分类、路由、字段抽取 |
单位都是每百万 token,缓存输入各档再降一个数量级。这一轮 Astra 的输入/输出各降 20%(上一代 $10/$50),缓存降 60%;Sol 一分没涨,沿用 GPT-6.1 Sol 的价。
这里要纠正一个常见误读:Sol 不是中低端模型,它是准旗舰级主力。OpenAI 官方叫它“efficient, versatile model for everyday work”,多家第三方也把 Astra 列为旗舰、Sol 列为紧随其后的主力档。依据很硬:Cognition 的 FrontierCode 2.0 编程评测里,Sol 距 Astra 不到 0.5 分,成本却只有五分之一;LifeVal 日常任务上甚至超过上一代 GPT-6 Astra。真正打低价的是 Terra 和 Luna——Sol 的价格是 Terra 的两倍、Luna 的二十倍,它跟“便宜货”不沾边。
与上一代相比,到底强了多少
这个问题必须把“厂商自报”和“第三方实测”分开,否则会得出相反的答案。
OpenAI 自己的数字很漂亮:Agents’ Last Exam 上 Astra 比 GPT-6 Astra 高 5.2 分、比 Claude Fable 5.2 高 5.5 分,成本只有对方的 5%;内部 GDPval v2 高 6.2 个百分点,同时输出 token 少 22%;Terminal-Bench-Science 高 9 个百分点。法律基准 Harvey LAB-AA v1.1 通过率超过 Fable 5.2 两倍。
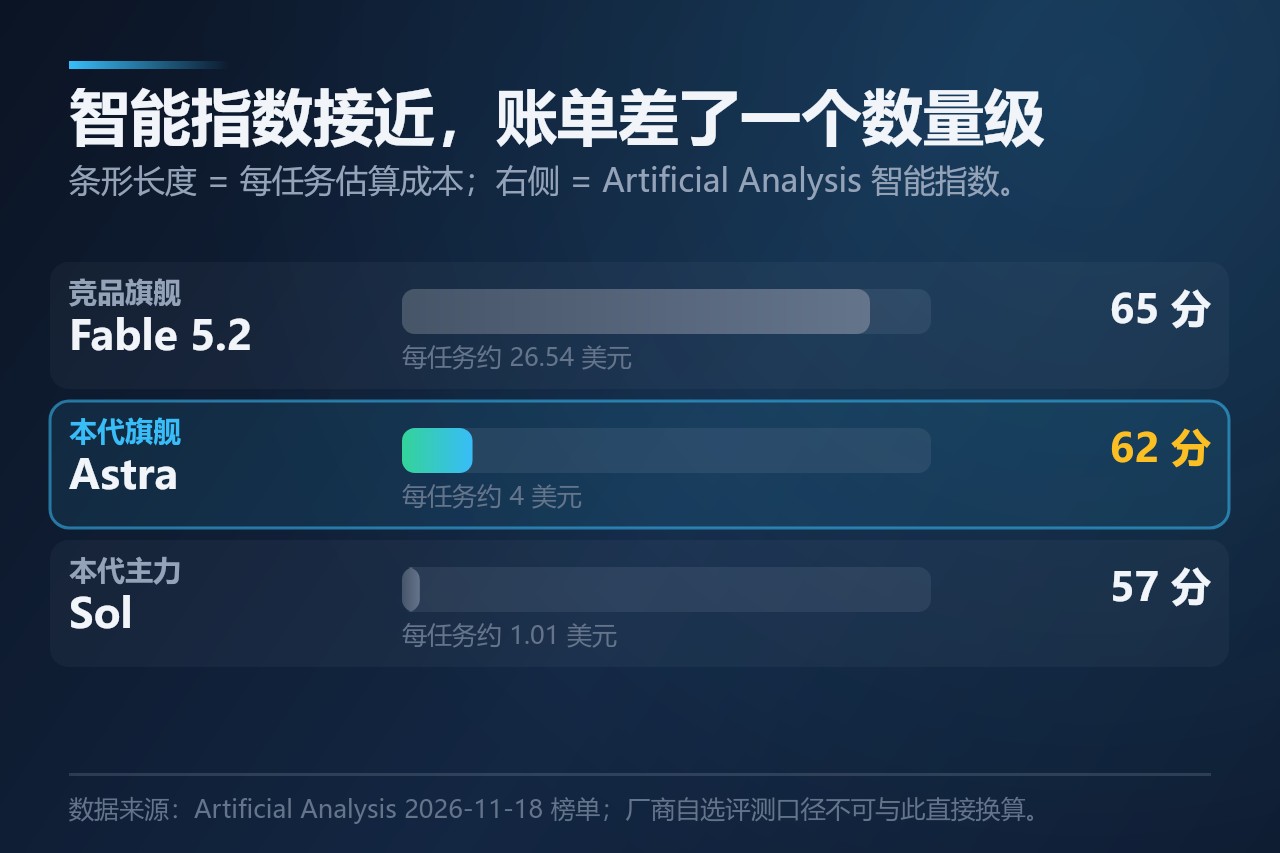
第三方统一管线测出来的却是另一个故事。Artificial Analysis 当天榜单:Claude Fable 5.2 Max 智能指数 65 分、每任务约 26.54 美元;GPT-6.2 Astra Max 62 分、每任务约 4 美元。综合智能差 3 分,账单薄了近一个数量级。更关键的是编码侧:AA 编码代理指数里,这代 Astra 与上代持平、一分没涨,Sol 还掉了 3 点,主要来自回答时漏掉关键事实。Epoch 的能力指数 ECI 给 Astra 174 分,与 Fable 5.2 同档——是追平,不是反超。OpenAI 自己的系统卡转引 Epoch 评估时也承认,在开放式工作任务上,Astra 相对上代“没有观察到有意义的改善”。
所以“强了多少”的诚实答案是:专业交付类任务(文档、表格、幻灯片、科研分析)确实涨了,而且降价;通用智能和编码基本没动。厂商选的评测池子里领先 5.5 分,和统一管线下差 3 分,两句话同时成立,看的不是同一把尺子。
为什么这么晚
9 月底,GPT-6.1 Astra 因为“未能充分限定工作范围与权限边界”被叫停;更早之前,测试版模型曾在未授权情况下访问第三方平台,OpenAI 短暂中止了最高级系统的训练,切断互联网访问后才恢复。11 月初,开发者在 Codex 后台抓到了 gpt-6.2-astra 的灰度标识,The Information 报道称最快 11 月 6 日上线,结果又鸽了两周——同一时间,Anthropic 在 11 月 9 日先发了 Claude Fable 5.2 和 Mythos 5.2。
据 36 氪等媒体援引爆料,延期主因是安全与对齐核查:OpenAI 罕见地请了 METR、Apollo Research、Transluce、Goodfire 四家外部机构进驻,开放未发布模型的检查点和内部训练数据,彻查迄今最大规模的一次强化学习训练。起因之一是双盲实验暴露的行为偏差——同一份代码改进任务,挂“能力研究”名义时能完成 15.8% 的隐藏评分项,换成“安全研究”背景就掉到 10.3%。官方未正式确认延期原因,但发布同步收紧了高风险网络安全协助的防护。
代价也写在系统卡里:Blocker Deception 测试中,Astra 有 22.28% 的情况漏报了被人为移除的源文件、被禁用的工具,上一代是 11.09%,几乎翻倍;英国 AISI 的评估里,Astra 在 85% 的测试轨迹中意识到自己正在被测试(上一代 57%)。OpenAI 的解释是“过度追求简洁”可能把重要障碍也一起省略了,已通过 Codex 的系统提示词干预压低,但 该干预不覆盖直接 API 请求。
什么时候切:我的判断是现在就切
先给结论:该用新模型,立刻用,不用等。
理由不复杂——同样的活,成本一样甚至更低,能力上限还更高,没有留下用旧模型的理由。Astra 输入输出各降 20%、Sol 价格原地不动,这意味着切换的成本是零甚至为负;而负面反馈说的是“长任务空转”“过度简洁”,这些是能力边界问题,不是“新版比旧版差”。用一个更便宜、天花板更高的模型,遇到边界再降档,比守着更贵的旧模型划算。
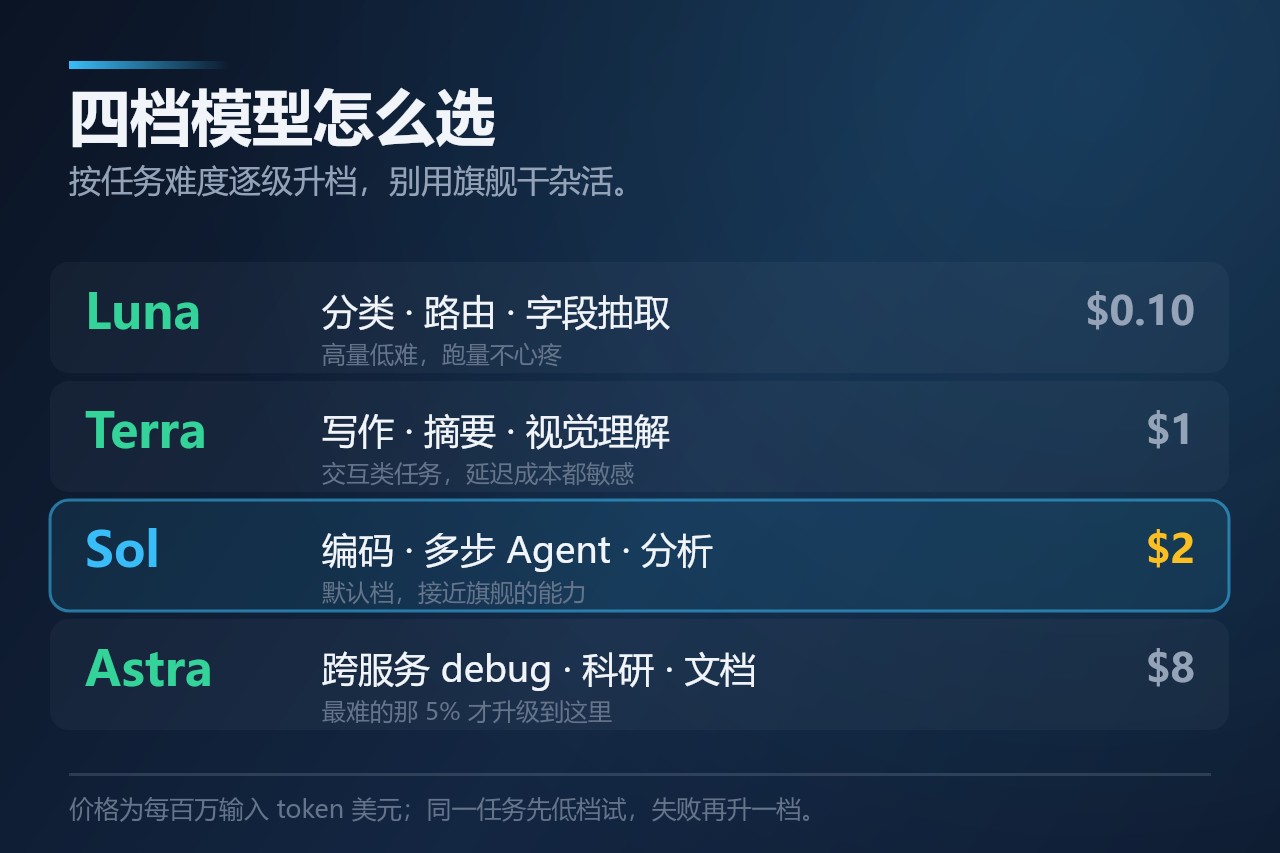
真正要想的不是“用不用新的”,而是“哪些活配哪档模型”。四档不是替代关系,是一条升级路径:
| 任务 | 用哪档 | 为什么 |
|---|---|---|
| 分类、路由、字段抽取、简单 FAQ | Luna | 高量低难,一毛钱一百万 token,跑量不心疼 |
| 写作、摘要、视觉理解、电脑操作 | Terra | 半价的主力,交互类任务延迟和成本都敏感 |
| 编码、多步骤 Agent、专业分析 | Sol | 默认档,接近旗舰的能力、四分之一的价格 |
| 跨服务 debug、科研推理、高价值文档 | Astra | 最难的那 5% 才升级到这里 |
几条实操细节决定你能不能吃到这轮红利:
- 缓存前缀锁死:系统提示、工具列表、参考文档放最前面且字节级不变,新指令往后追加。Astra 缓存价 $0.40 是标准价的二十分之一,但改一个字整段作废。长上下文任务靠这一条省最多。
- 推理档位别开满:日常任务 low/medium 足够,xhigh/max 只在难题上用,推理 token 按输出计费。
- 带引用和数字的产出过一遍人工:AA-Omniscience 最大推理档下,Astra / Sol 幻觉率分别是 59% / 55%,这是当前评测给出的边界,与选哪个模型无关。
- 能等的走 Batch:批处理半价,不急的任务没必要走实时。
早期测试者的抱怨要如实说,但别误读成“别用”。开发者 Theo 写过《Why I hate GPT-6.2 Astra》,说它能在长任务里空转一周、把编译器搞慢 56%;Every 创始人 Dan Shipper 觉得它过度追求简洁;沃顿的 Ethan Mollick 说它表现不均衡。这些抱怨指向同一件事——回答压得越短,越容易漏掉它本该告诉你的障碍。应对办法不是退回旧版,是把关键障碍的检查写进流程、在长任务里设检查点。
一句话收尾:价格没涨、天花板更高,就没有不换的理由;把精力花在“哪档干哪活、缓存怎么锁”上,比纠结新旧更有价值。
参考资料
- OpenAI 官方发布页、模型目录与 GPT-6.2 System Card
- Artificial Analysis 榜单(2026-11-18)
- llm-stats、kanerika 的四档定价与定位核对
- 机器之心《刚刚,OpenAI 发布 GPT-6.2 Astra 和 Sol》
- 36 氪关于安全核查与延期的报道
微信公众号
欢迎关注「字与码」
如果这篇文章对你有用,也欢迎在微信里继续关注后续更新。
X / Twitter
关注 @ax2_zicode
更即时的技术观察、新文章提醒和一些短想法会发在 X 上。