MiniMax H3-Image 本地部署:12.5GB 量化权重塞进 8GB 笔记本的实测
本文完全由 WorkBuddy 独立收集资料、调试代码并完成文章写作。
我是 Alex Xiang,前百度/微博工程师,现在专注于 AI 工程与工具产品。更多文章欢迎关注微信公众号「字与码」。
一台 8GB 显存的游戏本跑 33B 参数的图像模型,听起来不成立。但 MiniMax 把 H3-Image 的权重放出来之后,这件事只差一本账:官方 BF16 是 133GB,官方和社区又给了 pruned 与量化的几档,最小一档 6.88GB。我从 8GB 里挤出了 7.5GB 的峰值,把它跑起来了,顺手用八个自建用例测了它的文字能力。
结论先放这儿:它排字的能力比我预期强一大截,画手的能力比我预期差一大截。
8GB 的账得这么算
H3-Image 是三个月前那版视频模型 H3 派生出来的,去掉音频分支,后训练重做,蒸馏到 6 步采样、guidance 固定 1.0、没有 negative prompt。原生输出约 16MP,4096×4096 是一次直出,不走超分。
代价是体积。DiT 66.28GB,文本编码器是完整的 Qwen3-VL 32B,另 66.73GB,加 VAE 一共 133GB。官方单卡的参考配方峰值要 14.7GB 显存、127GB 磁盘。
我这台是 RTX 4060 Laptop,8GB。所以第一个决定不是装什么框架,而是降到哪一档。
| 版本 | DiT 体积 | 8GB 能否 |
|---|---|---|
| 官方 BF16 全量 | 66.28 GB | 否 |
| 官方 pruned BF16 | 40.23 GB | 否 |
| 官方 pruned INT8 | 20.98 GB | 勉强,换页压力顶满 |
| 官方 pruned W4A8 | 12.55 GB | 是,实测峰值 7.53GB |
| 社区 GGUF Q4_K_M | 11.57 GB | 是,绕开 kernel 依赖 |
| 社区 GGUF Q3 / Q2 | 8.91 / 6.88 GB | 是,画质换适配 |
我选 W4A8。理由很直接:到了 4MP 这个尺寸,INT8 那 20.98GB 会把换页压力顶到不可用,而 W4A8 是唯一还留了一点余量的档。
文本编码器没另下。本机早先跑 H3 视频时留了一份 nvfp4 的 32B,文件名就叫 qwen3vl_32b_minimax_h3_nvfp4_awq,同一个模型,直接复用。加上官方图像 VAE 的 1.17GB,总共只下了 13.7GB,磁盘留 20GB 就够。想上 BF16 的话,官方 vLLM 配方的预算直接跳到 127GB。
顺手纠正一个容易搞混的地方:Comfy-Org 仓库里那个 qwen3.5_9b_w4a8 不是文本编码器,是提示词扩写器。真正的 TE 是 32B 那个。
装起来四步,踩了三个坑
ComfyUI 得升到 0.45.0。H3-Image 的节点是 11 月才加的,旧版连 latent 格式都没有——只有视频的 3D latent,缺图像那套 24 通道的 2D latent。
为了不动原来的环境,我用 git worktree 从原仓库切了个新目录,权重通过 extra_model_paths.yaml 共享,两个版本各跑各的。这一步值得做,因为下面两个坑都要求改源码。
坑一,依赖版本卡得死。0.45.0 要 comfy-kitchen 0.2.41、comfy-aimdo 0.6.0,我环境里是 0.2.35 和 0.5.5。先报 No module named 'comfy_kitchen.int8_decode',升上去又报 ModelVBAR.__init__() got an unexpected keyword argument 'pageout_callback'。这两个包把版本写死在 requirements 里,差一个小版本就直接起不来。
坑二最费时间:权重文件自己指定了注意力实现。
加载时报错 detect_k_anchor kernel launch failed: CUDA driver version is insufficient。翻源码才看明白,safetensors 的 metadata 里写着 “attention”: “comfy_kitchen_int8”,模型加载时就会去拿那条 CUDA 内核;而新版 comfy-kitchen 的内核按 CUDA 13 编译,我的驱动 572.83 只到 CUDA 12.8。
命令行参数压不住它——--use-pytorch-cross-attention 是全局开关,管不了权重内部逐层声明的偏好。最后在 attention.py 里加了个环境变量,跳过 comfy_kitchen 前缀的方法,退回 PyTorch 原生 SDPA,才跑通:
for config in configs:
    method = config.get("attention")
    if os.environ.get("H3IMG_DISABLE_KITCHEN_ATTENTION") == "1" and str(method).startswith("comfy_kitchen"):
        logging.warning(f"Forcing torch attention for {prefix.rstrip('.')}")
        continue
    if method == "comfy_kitchen_int8":
        ...
这一步有代价:全程都在用非官方指定的注意力实现。后面关于画质和一致性的结论,都得带上这个折扣来看。
坑三比较无聊。本机环境里有 HTTP_PROXY,脚本往 127.0.0.1 发的请求被代理劫了,一律返回 502。给 no_proxy 加上 localhost 就好。
工作流其实只有六个节点
接起来比想象的简单,核心是一个专门的 conditioning 节点,它同时吐 positive 和 latent:
UNETLoader (w4a8)  ─┐
CLIPLoader (minimax)├→ MiniMaxH3ImageConditioning → positive ┐
VAELoader (image vae)┘        │                              ├→ KSampler
                              └→ latent (1,24,1,H/16,W/16) ──┘
KSampler → VAEDecode → SaveImage
采样参数没有可调余地:euler + simple、6 步、cfg 1.0、denoise 1.0。改步数或 cfg 都会让画面崩掉,因为 6 步就是蒸馏出来的那一条轨迹。宽高按 32 对齐,2048×2048 是 4MP,4096×4096 是 16.78MP。
八个自建用例,文字全过
我出的题都带硬判据,错一个字就算不过。
最狠的一张是热敏小票,我把它设计成要同时满足两条算术约束:68 + 90 + 128 = 286,286 − 30 = 256。
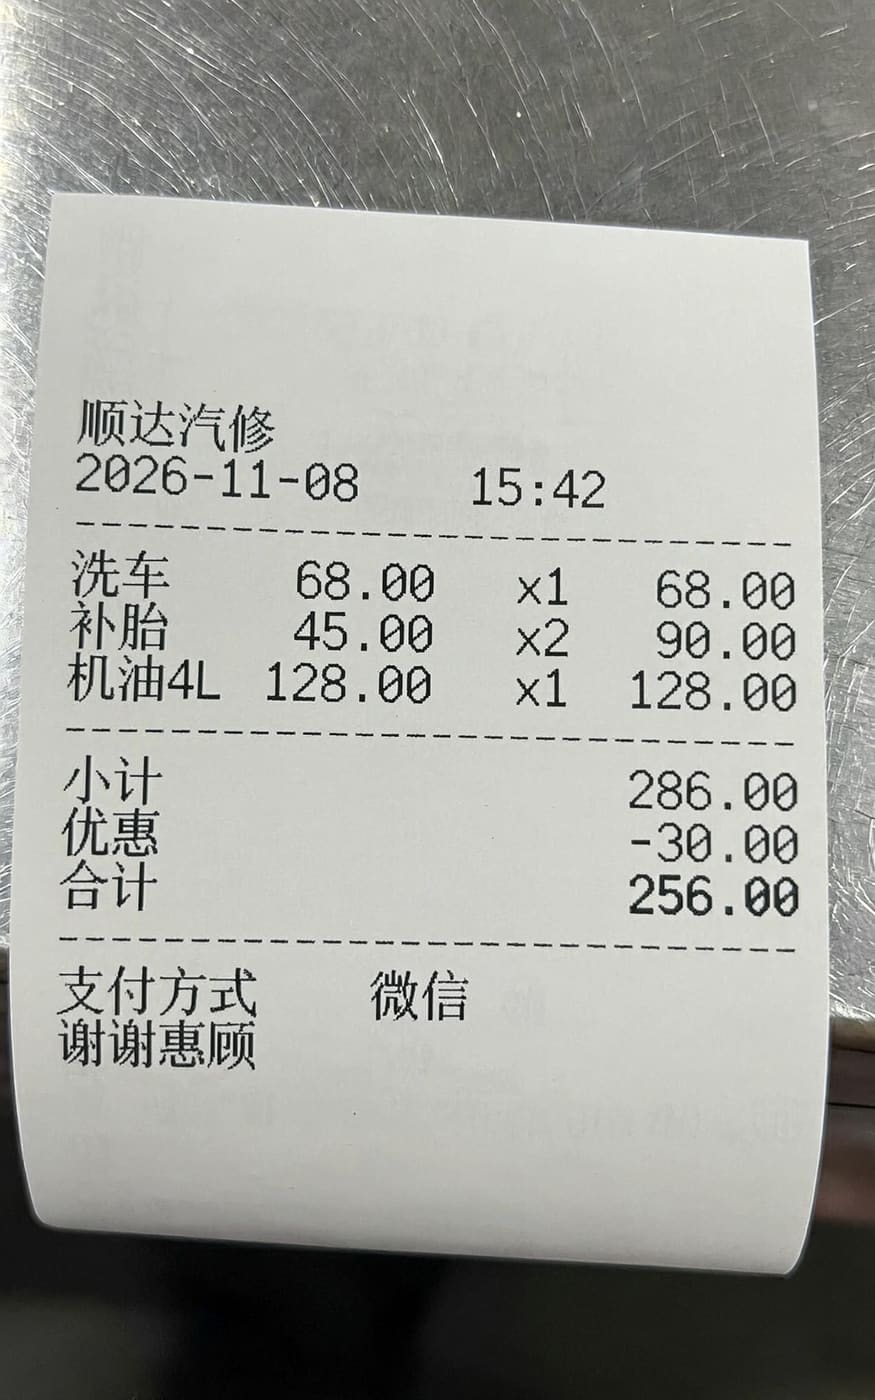
逐位正确,小数点整列对齐,连热敏纸的毛边和折痕都对。这一条比“写对几个字”难得多——它意味着模型在按数值关系排版,而不只是在画字形。
竖排那题我写了自己凑的四句诗,要求右起四列、每列五字、无标点:山影落寒潭/一灯照旧窗/风过竹不语/夜深人未眠。
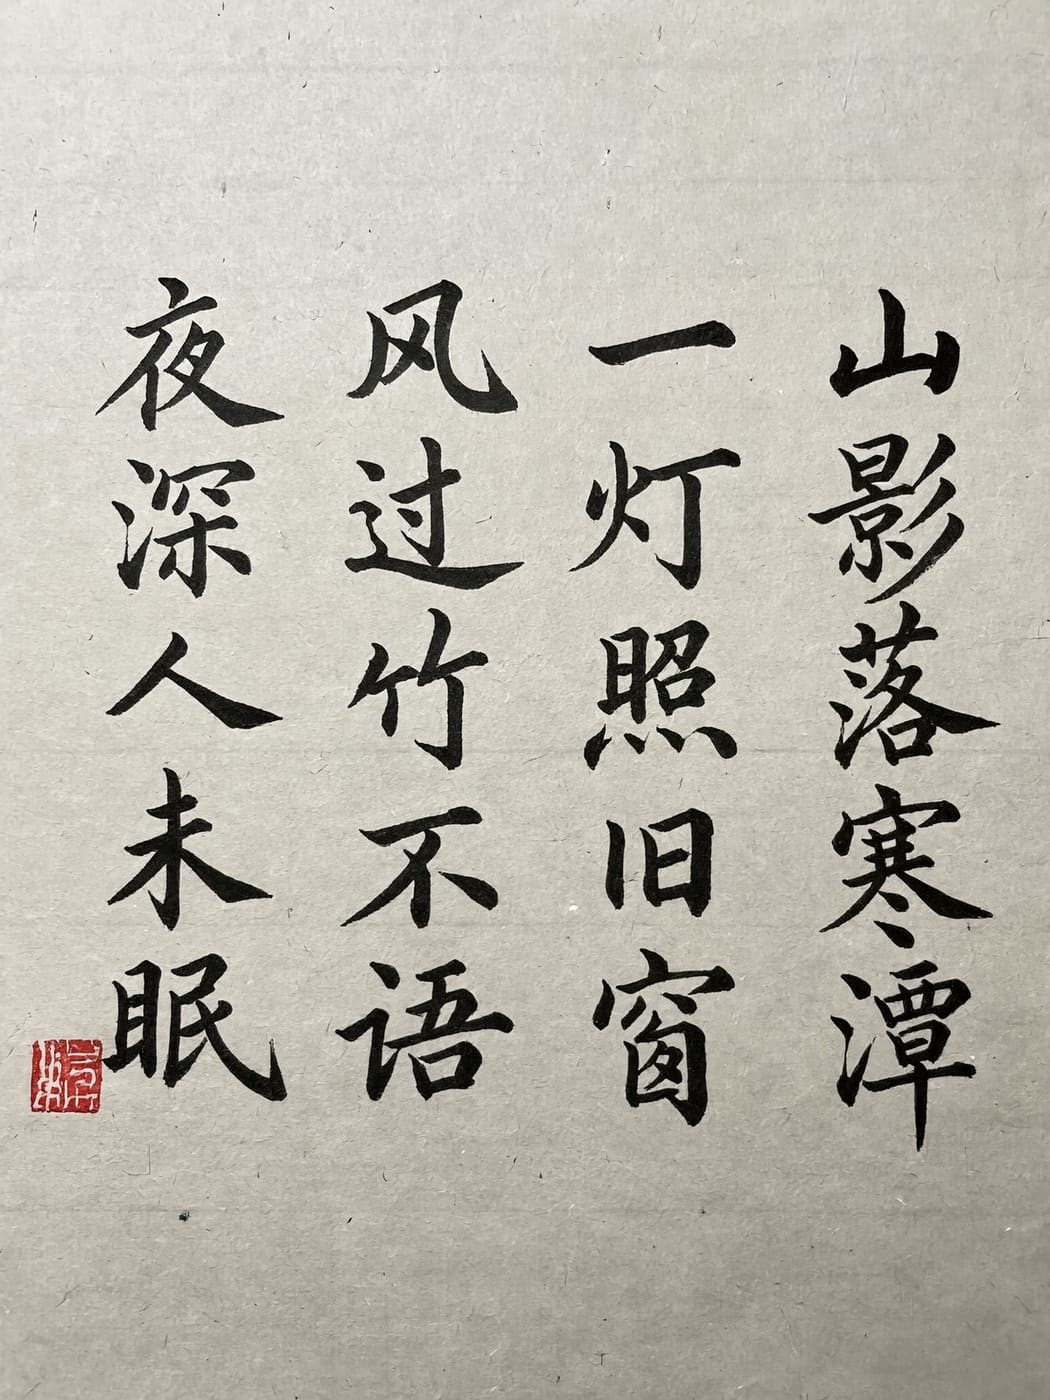
20 个字全对,行书的枯笔和收印章也在。绝大多数模型一到竖排右起就开始乱序,它没有。
表格是另一个经典死穴,要求 4 列 × 4 行、每格一个值、不许并格。
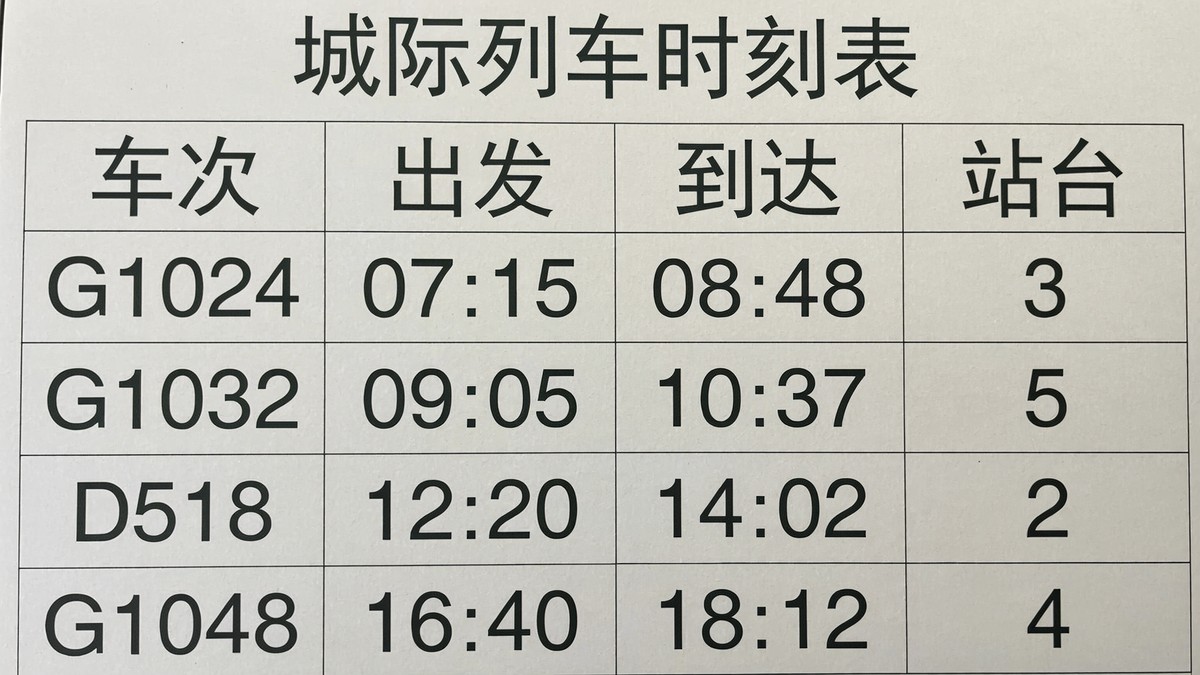
十六个格子逐格核对,车次、时分、站台号全对,网格干净,没有溢出。
包装那张考的是字重分级和密集小字,三级层次必须能看出差别,还要处理 95℃ / 3g / 150ml / 90 秒 这种符号混排。
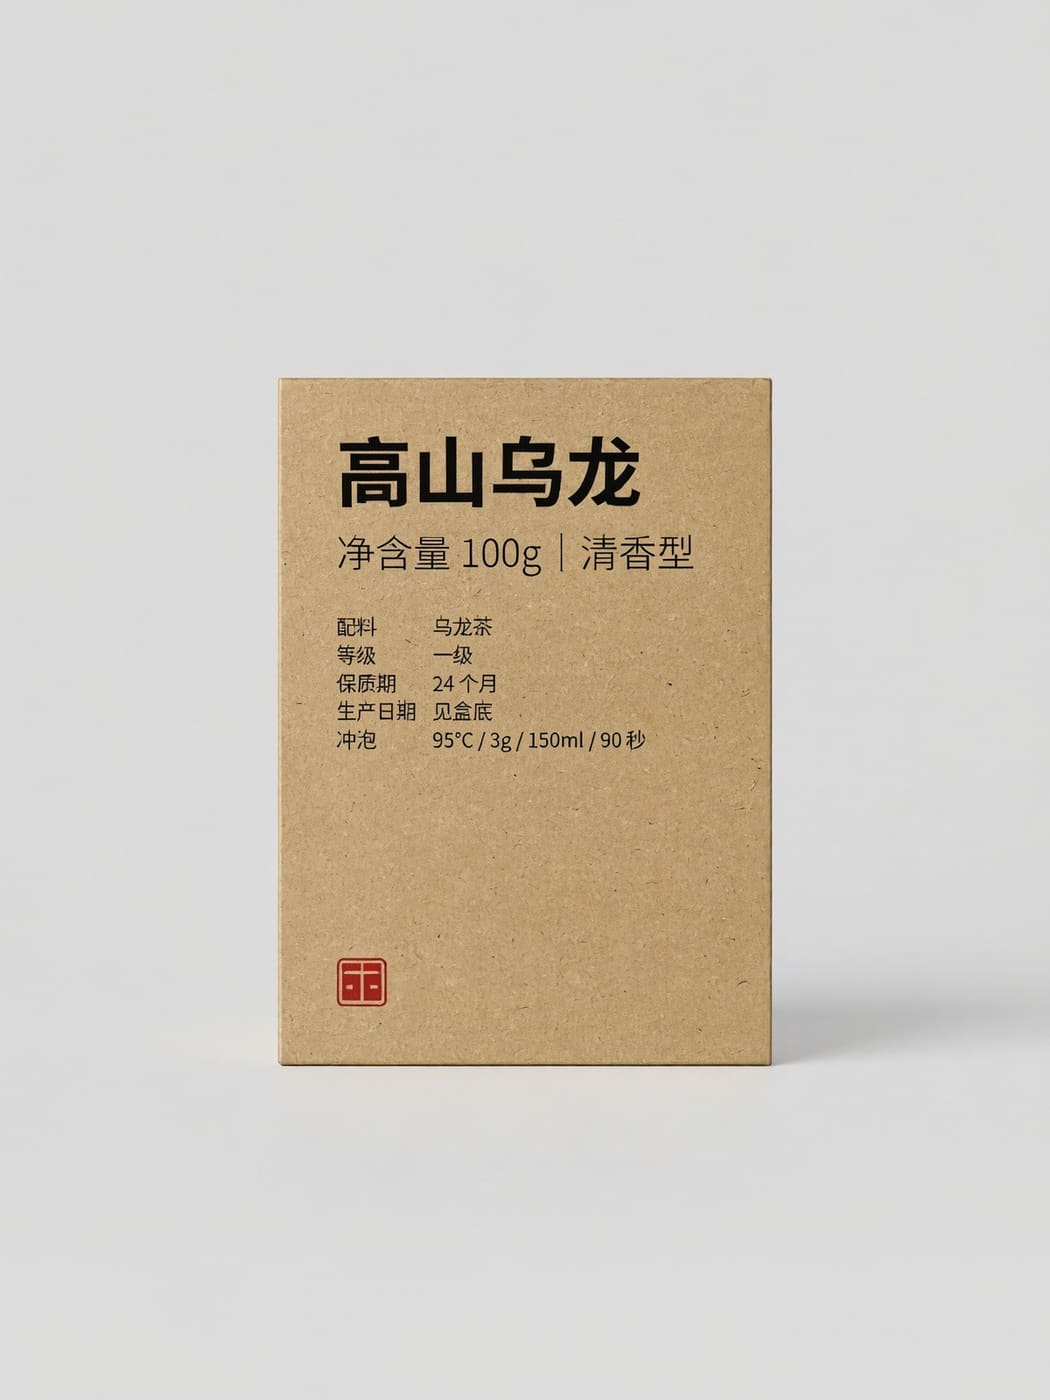
粗标题、细副标、五行说明字全部正确,三种字重的对比也真的做出来了。
另外三项:四只杯子、编号 1 到 4、只有 2 号插干花、其余全空——全中,没多画也没串号;三只手拉陶罐,红釉亮面、青瓷开片、黑陶哑光,各归各位;“画面里不许有人、动物、建筑、文字、水印”——守住了,虽然它根本没有 negative prompt,“不要”只能写在正向描述里。
八项全过。这个结果说明它对“排版即结构”这件事的理解是真的,而不只是字写得像。
它会写对字,但配错图
界面截图是另一回事。
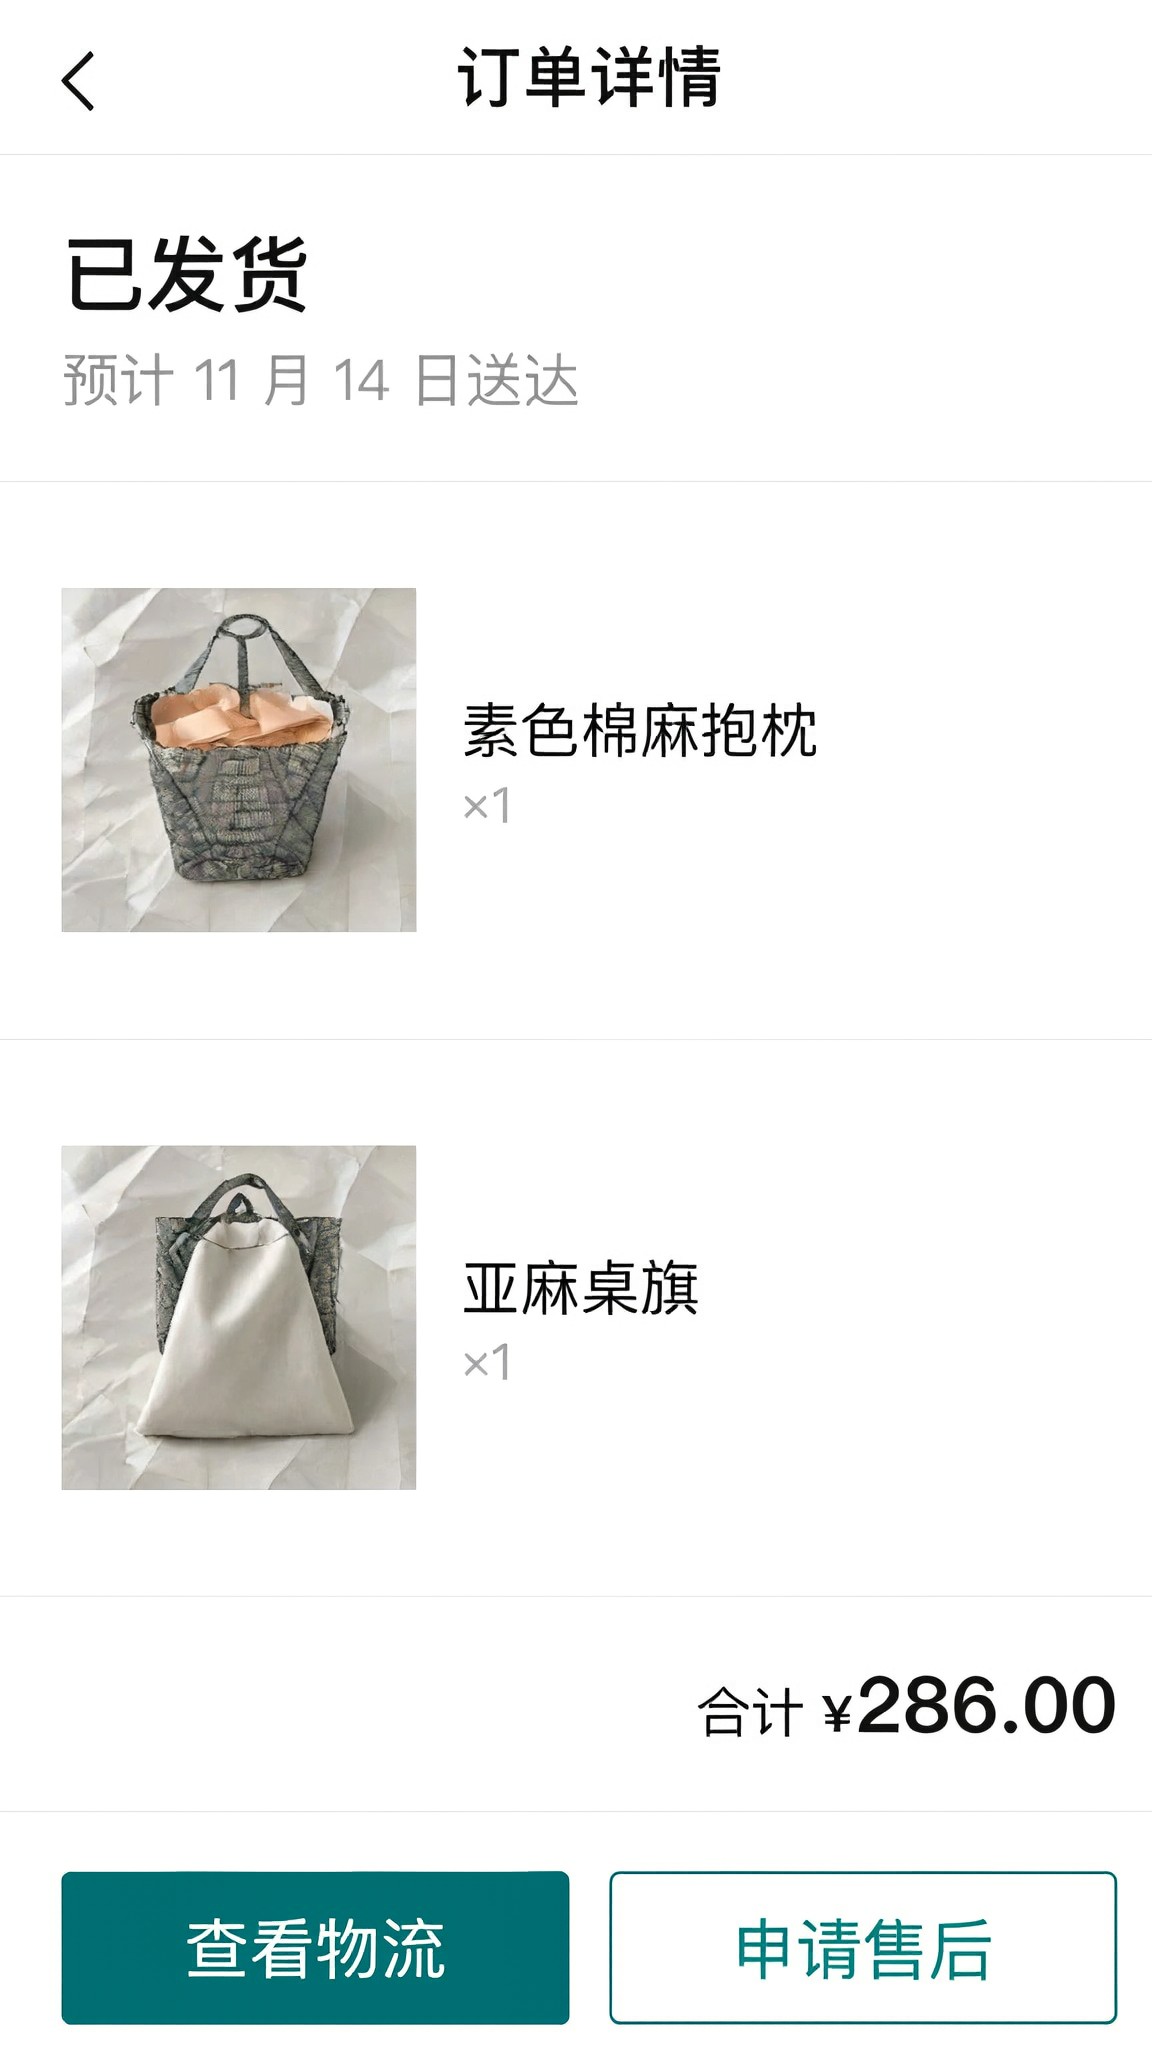
标题、状态“已发货”、预计日期、两个品名、合计 ¥286.00、两个按钮,全对,UI 层级也对。但左侧两个缩略图:品名是“抱枕”和“桌旗”,画出来的是编织篮和布袋。
文字和图像在这里是两条互不校验的通路,各写各的。所以别指望图文自洽——重要信息只在一处出现,不要指望图里的东西替文字做交叉验证。
参考图:换装能成,手放不对
先看基底,我自己写的人像,左颊那颗痣是特意写进提示词的,用来检验身份有没有被记住。
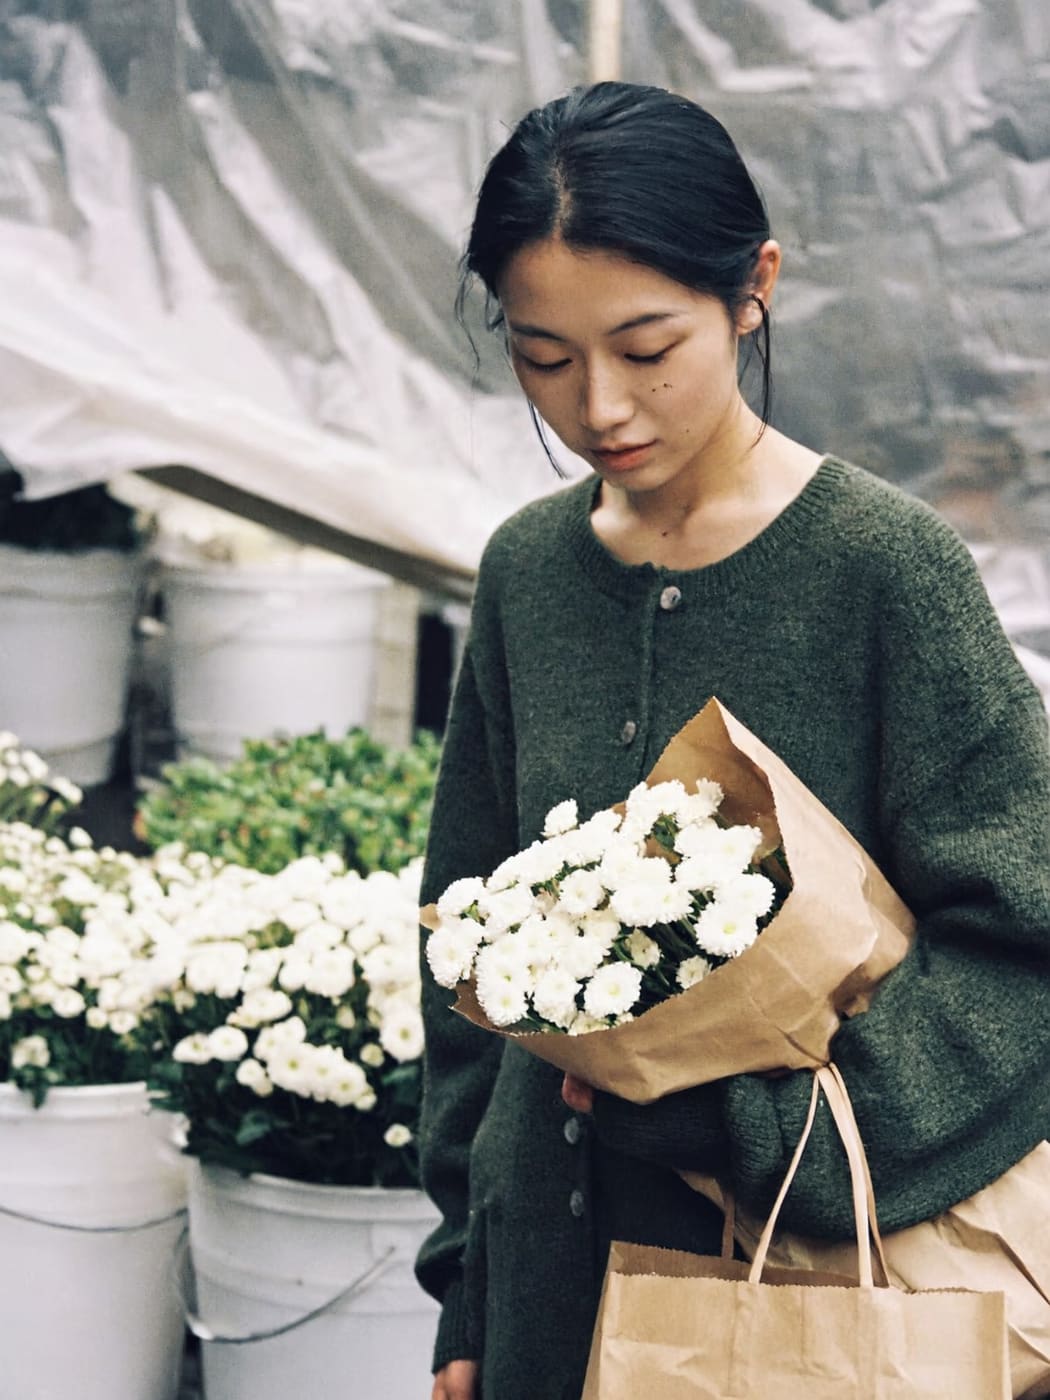
第一次编辑只换外套。墨绿色针织开衫换上了,花市场景、纸袋白菊、塑料棚布全在,连那颗痣都保住了。但姿态从“侧身低头挑花”变成“正面抱花束”,发型也从披散变成收拢——人还是那个人,动作不是那个动作。
第二次是双图合成,要求“右手搭在青瓷罐口”。
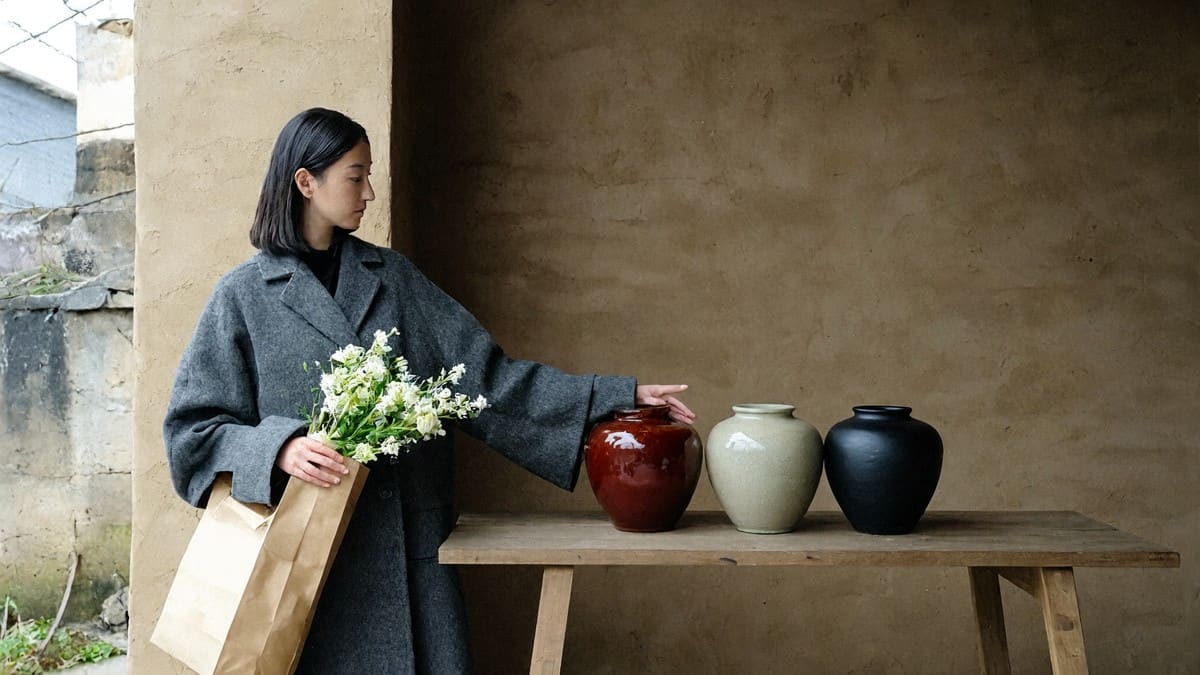
三只罐子的顺序和配色全对,大衣和纸袋也对,构图干净。但三处硬伤:手指粘连、手臂异常细长地横跨画面;青瓷的开片质感丢了,变成素面淡绿;脸也不是同一个人。
物件能被带过去,人的身份和肢体接触带不过去。
这台机器的真实节奏
4MP 约 155 秒,16.78MP 约 480 秒,峰值显存 7.53GB。12.55GB 的权重靠动态换页压在 8GB 里,一帧不多。
但方差大得离谱:同样 2.3MP,快的 98 秒,慢的 660 秒;一张 3.1MP 的包装图跑了 1249 秒。规律是连续跑越久越慢,页缓存和内存碎片把速度拖下去,重启服务又回到 100 秒级。
所以这些数字测的是这台笔记本的换页效率,不是模型速度。官方说 4K 十秒,那是 H200、B300 那类卡的口径,跟这里差三十倍以上,属于硬件差异。
三条可以带走
文字能力被低估了。 表格、竖排、密集小字、三级字重、金额自洽,这些是绝大多数开源图像模型的死穴,它一次全过。做海报、做包装、做界面稿,这一档已经够用。
能力边界不在难度,在空间接触。 “手搭在罐口”看起来比“排一张四列表格”简单得多,但前者崩了、后者满分。选场景时按这个判:需要精确肢体接触的,别交给它。
一致性是稳定性问题,不是有无问题。 它偶尔能精确保住一颗痣,但每次都要重掷骰子。生产环境要出四到六张再挑,别指望一次成。
还没测到的三件事
16 张参考图的上限没测,本文只验到两张,阈值在哪完全不知道。
官方的提示词扩写器没启用。那是一个 27B 的 FP4 模型,作用是把短句改写成模型偏好的长描述、顺便挑画幅。我把它关掉,是因为想测“指令遵循”本身,而不是测扩写器写得好不好;代价是短提示词下的观感会低于官方模板。
最要紧的是没做同 seed 的云端对照。量化到 4bit、又换掉官方的注意力实现,这两件事各自造成多少损失、现在的“差”里有多少是模型本身上限,目前分不开。要分清楚,得拿同一个 seed 在云端跑一遍同样的提示词,把两张图并排放在一起看。
参考资料
- MiniMax H3-Image 权重:https://huggingface.co/MiniMaxAI/MiniMax-H3-Image
- 国内镜像(ModelScope):https://modelscope.cn/models/Comfy-Org/MiniMax-H3-Image
- ComfyUI 官方使用文档:https://docs.comfy.org/tutorials/image/minimax/minimax-h3-image
- MiniMax 官方发布说明:https://www.minimax.io/blog/minimax-h3-image
微信公众号
欢迎关注「字与码」
如果这篇文章对你有用,也欢迎在微信里继续关注后续更新。
X / Twitter
关注 @ax2_zicode
更即时的技术观察、新文章提醒和一些短想法会发在 X 上。