8G 显存的笔记本能做什么:六类本地任务的实测边界
我是 Alex Xiang,前百度/微博工程师,现在专注于 AI 工程与工具产品。更多文章欢迎关注微信公众号「字与码」。
这台机器是 i9-14900HX、RTX 4060 Laptop 8GB、64GB 内存。过去三个月,我在这里把文本、代码、图像、视频、语音、检索几类模型挨个跑了一遍,有跑通的,也有跑到一半放弃的。
这篇不堆参数,只回答一个问题:一块 8G 显存的笔记本显卡,今天到底能接下哪些活,哪些活别接。所有数字都来自这一台机器,是单机冒烟测试,不是跨设备排行榜。
先把 8G 算成一笔账
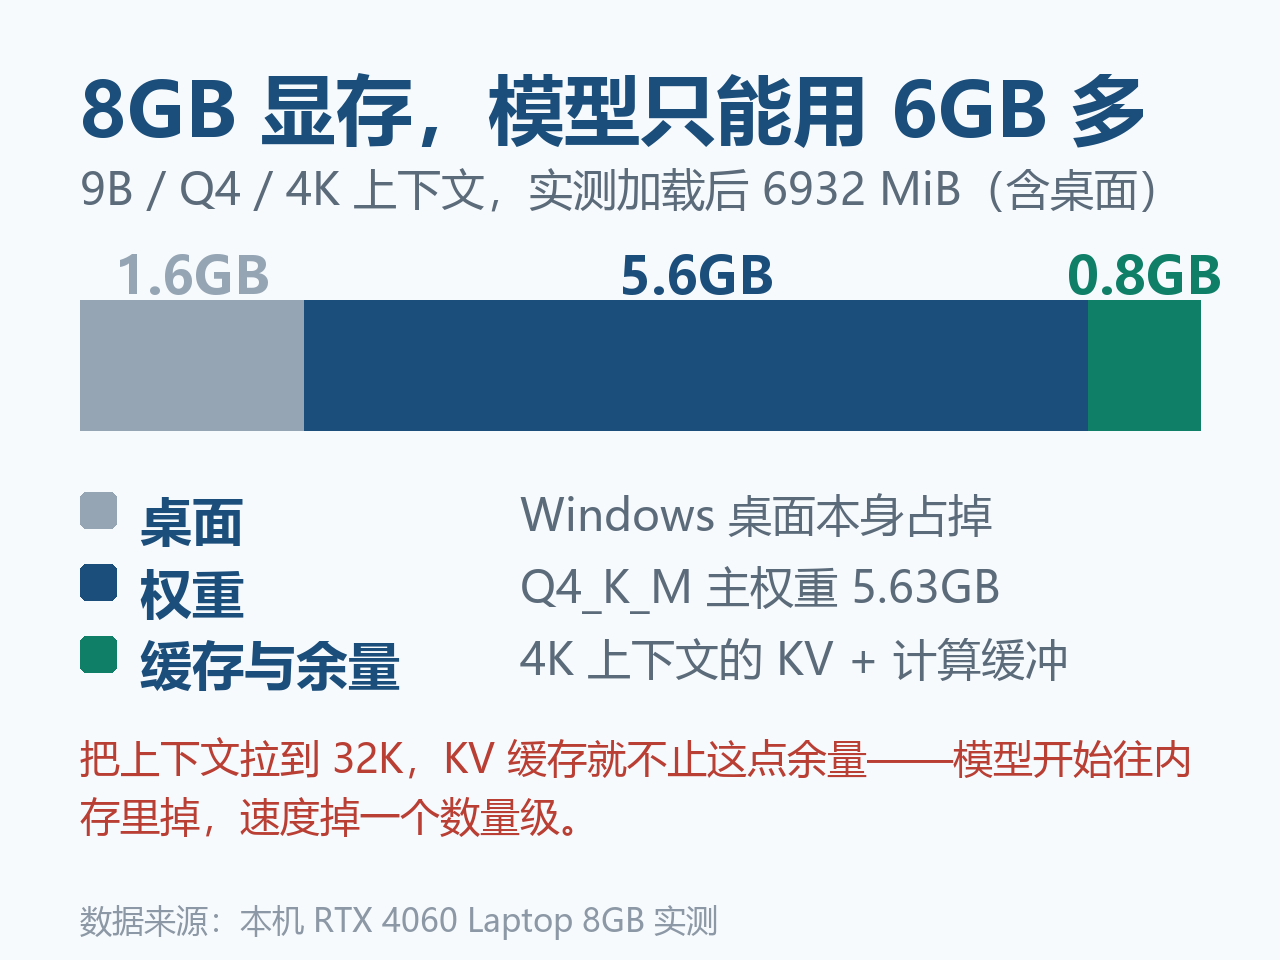
nvidia-smi 报的是 8188 MiB,约 8G。但 Windows 桌面本身要占掉 1.6GB 左右,真正能留给模型的只有 6.3–6.5GB。
这里有个流传很广的坑:用 WMI 读 Win32_VideoController.AdapterRAM,这块卡会显示 4GB。那是 32 位整型溢出,超过 4GB 的卡一律报错值。按 4GB 去做选型,会把一堆其实跑得动的模型提前排除。
剩下的 6G 多还要分三份:权重、KV 缓存、计算缓冲。所以 8G 的真实含义不是「能跑 9B」,而是「能跑 9B 的 4bit 量化,加上 4K 到 8K 上下文」。把上下文拉到 32K,模型就开始往内存里掉,速度不是变慢一点,是掉一个数量级。
文本:9B 的 Q4 是甜点,长上下文不是
本机跑的是 Qwen3.5-9B 的社区蒸馏版,Q4_K_M,文件 5.63GB,32 层全部 offload 到显卡,上下文设 4096。加载后显存占用 6932 MiB,第一轮九道题平均 31.2 tok/s,最快 34.2,最慢 26.7。
31 tok/s 是什么手感?比人阅读快,比云端慢,写草稿、改文档、做结构化抽取都够用。但它的边界很整齐:所有「收敛到一个确定答案」的题都能做,开放式长输出容易收不住尾。
当前 8G 档的共识选择就是这颗 9B 的 Q4——下载约 6.6GB,另加 0.92GB 的视觉投影文件才能看图。想要多语言和看图更稳,Gemma 4 E4B 是另一条路,体积更小、留的余量更多。
最佳实践只有两条。第一,上下文显式设成 4K 或 8K,不要用默认值赌运气——Ollama 在 24GiB 以下默认只给 4K,很多人以为自己在跑 32K。第二,模型卡上的 262K 是实验室数字,8G 上开满等于把一半层赶回 CPU。
这里有一条本地结论已经过时。三个月前我这台机器的 Ollama 还是 0.6.6,内置 llama.cpp 太老,不认识 Qwen3.5 的混合注意力架构,只能换 llama.cpp 的预编译包手动加载。今天 Ollama 和 LM Studio 都已原生支持 qwen3.5:9b,入门不需要再折腾编译;只有要做 MoE 专家落内存(--n-cpu-moe)这类精细控制,才值得回到 llama.cpp。
代码:能补全,别当 Agent 主机
7B 到 9B 的代码模型是 8G 的甜点位:补全、单文件改写、给一个函数写测试,都能用。但「读一遍仓库再改五个文件」这种活,卡的不是智力,是上下文——8G 给不出足够长的窗口,模型会反复忘记前面看过什么。
今年 10 月有个反例值得记:Flint 39.8B 总参数、每 token 只激活 2.5B,4bit 量化后约 23GB,官方写的本地门槛是 48GB 统一内存或 48GB 显存。有人用 12GB 的 3060 跑出 46 tok/s,但那是靠专家层放在内存里换来的。8G 连门槛的边都摸不到。
所以本地的定位是「补全器 + 离线小改」,长链路的 Agent 交给云端。真要在本地跑 Agent,就把工具返回的结果截断到几百字,别把整个文件塞回去。
图像:8G 的第一梯队今年换人了
11 月 13 日我做过一次极限测试:把 MiniMax H3-Image 的 12.55GB W4A8 权重塞进 8G,峰值显存 7.53GB,4MP 出图约 155 秒。它确实跑起来了,但方差大得离谱——同样 2.3MP,快的 98 秒,慢的 660 秒;一张 3.1MP 的包装图跑了 1249 秒。连续跑越久越慢,重启服务又回到 100 秒级。这些数字测的是这台笔记本的换页效率,不是模型速度。
这条路线今天不该是首选。8G 现在有 4 步蒸馏的小模型:Z-Image-Turbo 是 Apache 2.0,FLUX.2 klein 4B 的 4bit 版本占用约 5.3GB、在 40 系卡上是秒级,Qwen-Image 1.0 的 GGUF 版中文排版最稳。它们牺牲的是一点点极限画质,换来的是「点一下就有」。
许可比速度更容易踩坑。Qwen-Image 1.0 是 Apache 2.0,Qwen-Image 2.1 改成了仅限研究评估;FLUX.1 dev 不允许拿生成结果做付费工作,FLUX.2 klein 4B 可以。要商用,先看许可再看画质。
还有一个小技巧:FP8 只有在 RTX 40/50 系上才有硬件加速,同一张图能快约四成。40 系笔记本优先找 FP8 版本,别默认下 GGUF。
视频:能验证,不能出片
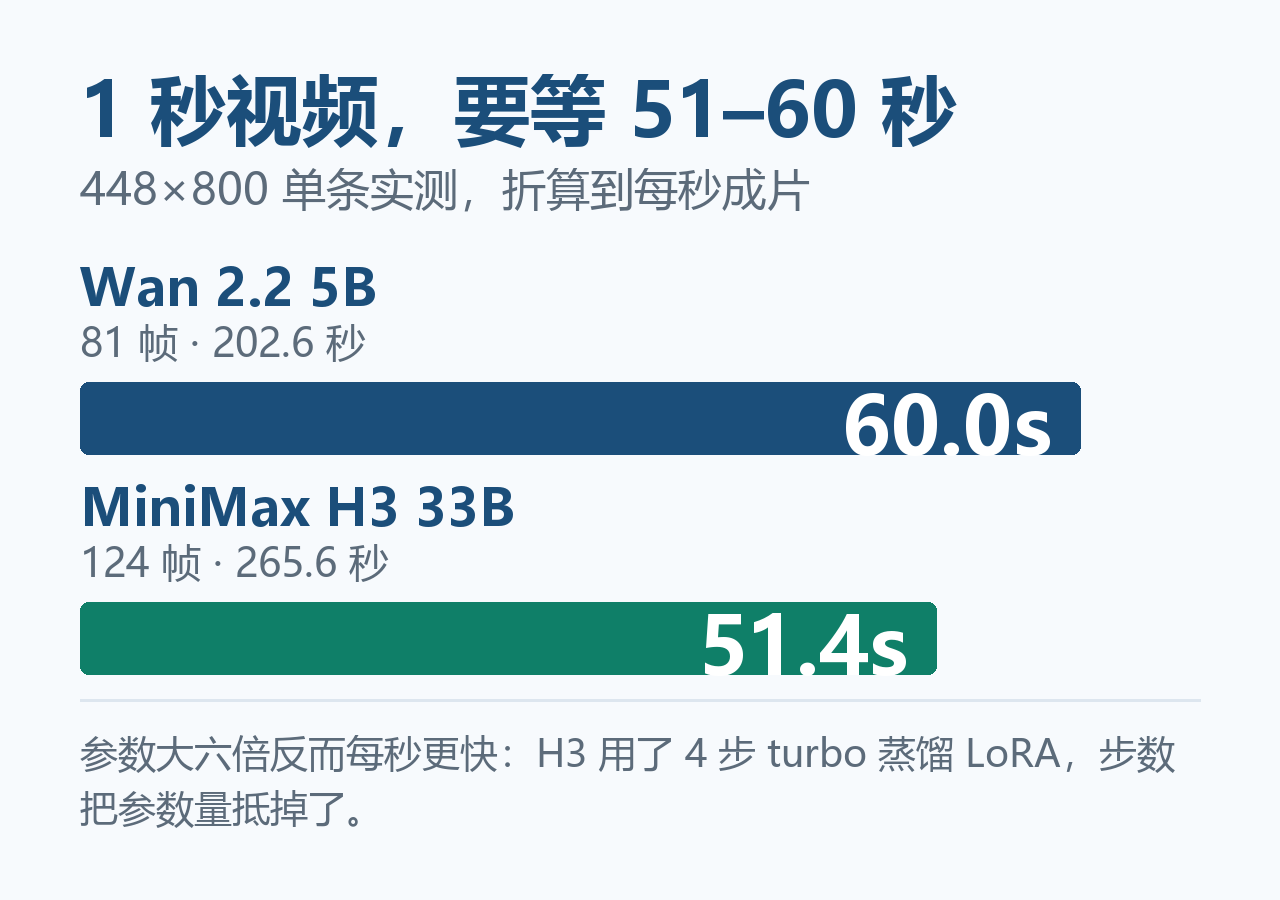
视频是 8G 最吃力的地方,但也不是不能碰。Wan 2.2 的 TI2V-5B 是稳妥选择:448×800、81 帧,单条 202.6 秒,折算下来 60 秒换 1 秒视频。
有意思的是 33B 的 MiniMax H3 折算后更快:124 帧用了 265.6 秒,折合 51.4 秒每秒视频,比 Wan 快 14%。原因不是参数,是它用了 4 步的 turbo 蒸馏 LoRA——参数决定单步成本,步数决定要跑几步,两个要一起算。
最佳实践是一套固定动作:480p 起步、33 到 81 帧、4 步加速 LoRA、文本编码器放 CPU、启动加 --lowvram、batch 设 1。先用 3 秒的片子验证链路通不通,再谈加长。想直接上 720p,基本是在跟显存对赌。
9 月我写这条时只有 Wan 和 H3 两条路,现在多了 LTX-2.5 的蒸馏档(8–12GB 可跑)和 Kandinsky 6 Lite(3B)。选择变多了,但 8G 的结论没变:这是「能验证创意」的档位,不是「能批量出片」的档位。
语音:TTS 真能用了,ASR 别默认 Whisper
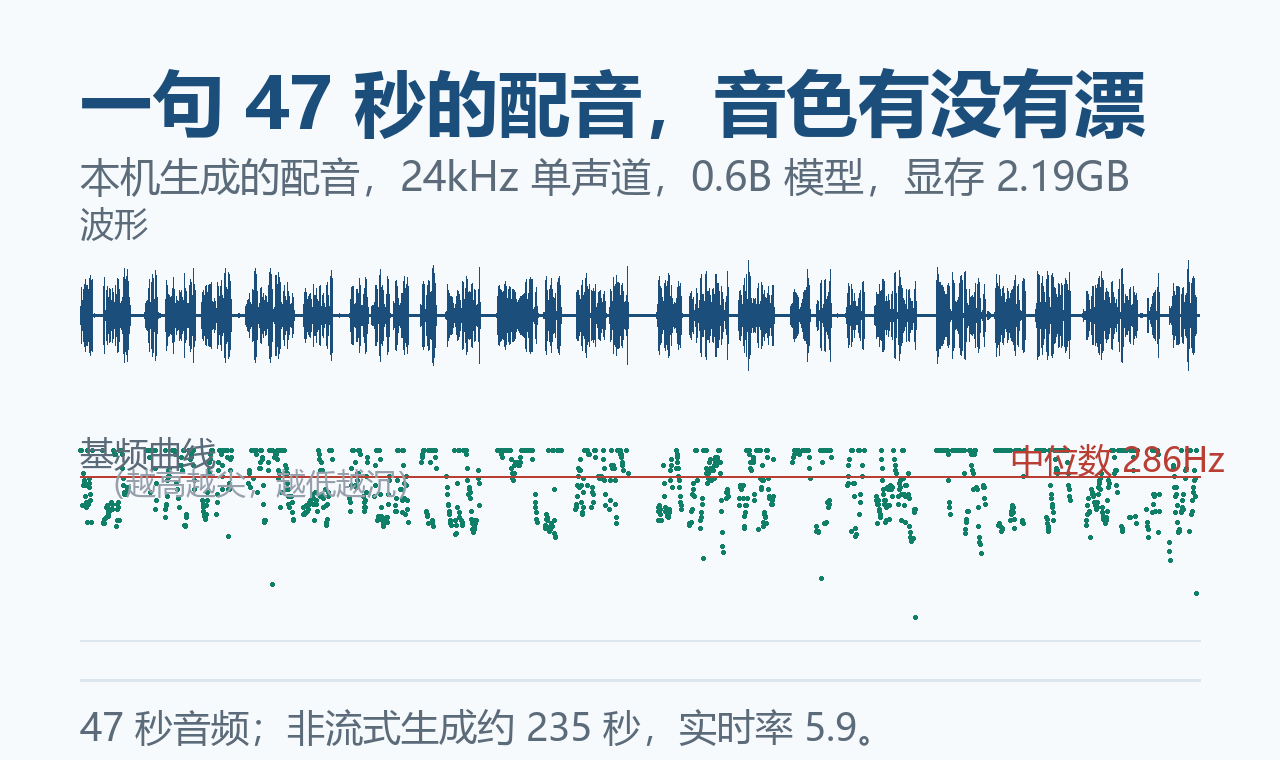
语音是这半年进步最明显的一类。Qwen3-TTS 的 0.6B 版本,权重 1.8GB,显存 2.19–2.55GB,17 条中文陷阱测下来 12 条完全正确,错的集中在专有名词——「Kimi」被念成「Timmy」,句子的其余部分全对。
代价是时间。非流式模式下实时率中位数 6.4,40 秒音频要等 235 秒,做有声书配角、短视频配音可以接受;官方标称流式首包 97ms,那是另一套调用方式。
对比之下,微软的 VibeVoice 0.5B 在中文上是抽奖:16 条只对 3 条,长句直接退化成拼音,同一句话跑四次能给四种结果。它的显存只占 2.6GB,RTF 4.3,账面更好看,但正确率不能用。
ASR 这边有个观念要更新。Whisper 生态最全,但 2026 年的 Open ASR 榜上,Parakeet-TDT-0.6B-v3 的 WER 是 6.32%,已经优于 large-v3 的 7.44%。新项目不必默认 Whisper。中文会议、长音频用 SenseVoice-Small,234MB,CPU 上约 17 倍实时;要多语种和方言,再看 Qwen3-ASR-0.6B。
不管选哪个,前面都该加一个 VAD。Silero 的模型只有 2MB,却决定了你什么时候把音频送进 ASR——没有它,长静音会喂出一堆幻觉文本,很多人会误判成模型不行。
检索和「小模型」:最容易被忽略的一档
做本地知识库的人常常把显存全留给对话模型,其实检索这一层几乎不占地方。Qwen3-Embedding-0.6B 的 Ollama 包是 639MB,bge-m3 是 1.2GB,可以和 9B 同时常驻。加一个 reranker 通常比换更大的 embedder 更划算。
还有一类被低估的模型:几百 M 的分类器或路由器。本机跑过一个 421M 的文本分类模型,显存 1607MB,单题 61.7 毫秒;十条一批送进去,总耗时几乎不变,每题成本掉到 7.4 毫秒。它的价值不是替代大模型,而是决定「这句话要不要惊动大模型」——省下的是延迟和电。
这类模型最适合放在流水线最前面:先分类、先路由、先做置信度判断,把真正难的问题留给 9B。
一张表:能接什么,别接什么
| 任务 | 8G 能不能 | 依据 |
|---|---|---|
| 离线问答、草稿、摘要 | ✅ 可以 | 9B Q4,31 tok/s,4K 上下文 |
| 结构化抽取、固定格式输出 | ✅ 强项 | 严格 JSON、格式遵循稳定 |
| 1024 级别出图 | ✅ 可以 | 4 步蒸馏小模型,秒级 |
| 5 秒 480p 视频验证 | ⚠️ 能跑 | 60 秒换 1 秒,适合验证不适合出片 |
| 配音、有声书 | ✅ 可以 | 0.6B TTS,16–39 秒一条 |
| 转写、会议纪要 | ✅ 可以 | SenseVoice / Parakeet,CPU 也能跑 |
| 本地知识库检索 | ✅ 可以 | embedding 不到 1GB,与大模型共存 |
| 长上下文整卷推理 | ❌ 不行 | 上下文一开大就掉到 CPU |
| 4K 图像批量生成 | ❌ 不行 | 换页方差大,单张可到 20 分钟 |
| 1080p 长视频 | ❌ 不行 | 显存与时长同时爆 |
| 代码 Agent 主机 | ❌ 不行 | 窗口不够,读不完一个仓库 |
| 直接对外提供服务 | ❌ 不行 | 没有并发余量,也没有安全对齐 |
五条通用最佳实践
先降量化,再换小模型。 Q4 的 9B 通常好过 Q2 的 14B——量化到 2bit 的困惑度要差 15% 左右,而 Q4 只差不到 1%。
上下文是第二块显存。 先定 4K 还是 8K,再谈模型选型。同一个模型,8K 和 32K 是两种体验。
offload 是拿内存换时间。 64GB 内存能让 33B「跑起来」,但那是能验证不能出片;把这条记在选型表里,就不会对速度有不切实际的期待。
别在 8G 上追 SOTA。 要追的不是「最强的模型能不能跑」,而是「这一步能不能在本地闭环」。闭环比参数重要。
记录口径。 显存峰值、tok/s、每秒视频耗时、实时率——这四个数不带口径就没法比较。同一张卡,冷启动和热启动能差一倍。
把上面这些合起来,它其实是一个不联网的写作与整理台、一个随手出图的草图机、一个验证分镜的预览器、一个配音和转写工作站、一个本地知识库的检索层。它做不了的是:替代云端旗舰做长链推理,以及批量生产成品视频。
这个边界不算宽,但足够把很多日常活儿留在本地。
参考资料
- Qwen3.5-9B 模型卡与量化档位:https://huggingface.co/Qwen/Qwen3.5-9B
- llama.cpp 预编译发布页:https://github.com/ggml-org/llama.cpp/releases
- 8G 显存档位选型与上下文建议:https://pcserverandparts.com/news/best-local-ai-models-2026/
- 本地量化档位与常见误区:https://aitoolradar.io/guides/llm-quantization-explained
- 图像模型显存与许可对照(2026-10):https://www.bestfreewebresources.com/?p=23370
- ComfyUI 显存需求与启动参数:https://www.earngenix.com/tutorials/comfyui-system-requirements
- ComfyUI 图生视频模型对照(Wan 2.2 / H3 / LTX-2.5):https://freakyjolly.com/comfyui-image-to-video
- Open ASR Leaderboard:https://huggingface.co/spaces/hf-audio/open_asr_leaderboard
- Qwen3-TTS 模型卡:https://huggingface.co/Qwen/Qwen3-TTS-12Hz-0.6B-Base
- Qwen3-Embedding 模型卡:https://huggingface.co/Qwen/Qwen3-Embedding-0.6B
- Silero VAD:https://github.com/snakers4/silero-vad
- Wan 2.2 与 MiniMax H3 的 8G 实测记录:https://zicode.com/blog/local-video-models-wan-vs-h3/
- 更多本地实测归档:https://zicode.com/blog/
微信公众号
欢迎关注「字与码」
如果这篇文章对你有用,也欢迎在微信里继续关注后续更新。
X / Twitter
关注 @ax2_zicode
更即时的技术观察、新文章提醒和一些短想法会发在 X 上。